Wichtigste Erkenntnisse
- Q4_K_M Quantisierung: Llama 3.3 70B benötigt etwa 40 GB RAM; Qwen3 72B benötigt etwa 43 GB RAM.
- Günstigste neue Hardware: Apple Mac mini M5 Pro (64 GB, 1.699 $, ab 22. Sept. 2026) ist die günstigste neue Apple-Silicon-Option mit vollständiger GPU für 70B. Der Basis-Mac mini M6 (899 $) hat maximal 32 GB und kann kein 70B Modell ausführen.
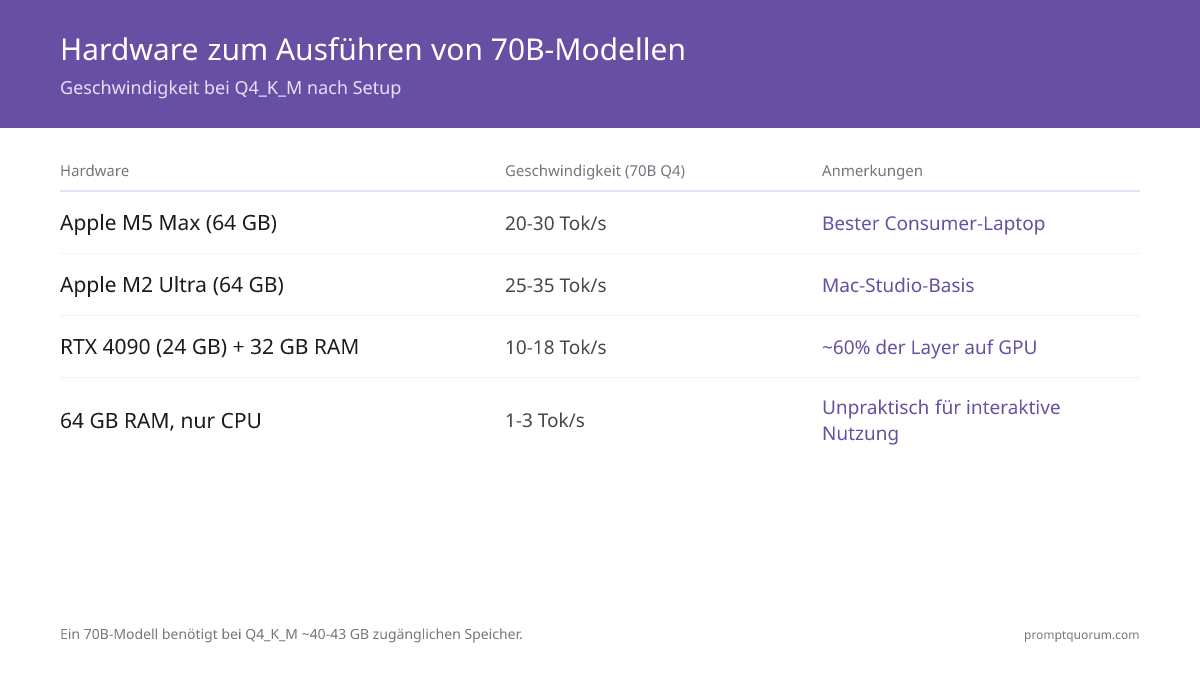
- Einfachste Consumer Hardware: Apple Mac Studio M2 Ultra (64 GB unified) oder M5 Max MacBook Pro (64 GB) -- vollständige GPU Beschleunigung, kein Layer Offloading erforderlich.
- NVIDIA Option: RTX 4090 (24 GB VRAM) + 32 GB System RAM mit Layer Offloading in Ollama bewältigt die meisten 70B Modelle, obwohl 20-30% der Layers auf der CPU laufen.
- CPU-only 70B: möglich auf 64 GB RAM, erzeugt aber 1-3 tok/sec -- marginal nutzbar für Batch-Aufgaben, nicht für interaktiven Chat.
- Stand August 2026 entspricht ein lokal ausgeführtes 70B Modell weiterhin der GPT-4 (2023) Qualität und ist der einzige verbraucherzugängliche Weg zu dieser Qualitätsstufe ohne Cloud-Kosten.
📍 In einem Satz
Ein 70B-Parameter-Modell lokal auszuführen benötigt 40-48 GB RAM bei Q4_K_M-Quantisierung -- erreichbar auf Apple-Silicon-Macs mit 64 GB unified memory, Workstations mit 64 GB DDR5, oder einer 24 GB NVIDIA-GPU kombiniert mit 32 GB System-RAM per Layer Offloading.
💬 In einfachen Worten
Ein 70B-Modell gehört zu den größten Größen, die man realistisch zu Hause ausführen kann, und braucht viel Speicher -- etwa 40-48 GB. Der einfachste Weg ist ein Mac mit ausreichend unified memory, da dieser RAM zwischen CPU und GPU teilt. Bei einem PC braucht man meist eine große Grafikkarte plus zusätzlichen System-RAM, um die Teile auszulagern, die nicht auf die Karte passen.
Welche Hardware kann ein 70B Local LLM tatsächlich ausführen?
Ein 70B Modell bei Q4_K_M Quantisierung benötigt etwa 40-43 GB Speicher, der für die Inferenz-Engine zugänglich ist. Dies kann von GPU VRAM, unified System Memory (Apple Silicon), System RAM oder einer Kombination über Layer Offloading stammen.
Hardware | Kann 70B ausführen? | Speed (70B Q4) | Notizen |
|---|---|---|---|
| Apple M5 Max MacBook Pro (64 GB) | Ja -- vollständig GPU | 20-30 tok/sec | Beste Consumer Laptop Option |
| Apple Mac Studio M5 Max (64 GB) | Ja -- vollständig GPU | 22-32 tok/sec | Neu August 2026, 2.499 $ |
| Apple Mac mini M5 Pro (64 GB) | Ja -- vollständig GPU | Noch keine Benchmarks | Neu, ab 22. Sept. 2026, 1.699 $ -- günstigste Neuoption |
| Apple Mac mini M6 (max. 32 GB) | Nein -- max. 32 GB | Nicht möglich | Neu, ab 22. Sept. 2026, 899 $ -- zu wenig Speicher für 70B |
| Apple M2 Ultra (64 GB unified) | Ja -- vollständig GPU | 25-35 tok/sec | Mac Studio Basis-Config, gebraucht/refurbished |
| Apple Mac Studio M5 Ultra (256GB+) | Ja -- vollständig GPU | 35-50 tok/sec | Neu August 2026, ab 5.499 $. Läuft Q8_0/FP16 mit Platz übrig. |
| NVIDIA DGX Spark (128 GB unified) | Ja -- vollständig GPU | 18-28 tok/sec | Q8_0 passt (70 GB). Am besten für CUDA-Workflows. |
| NVIDIA RTX 4090 (24 GB) + 32 GB RAM | Ja -- mit Offload | 10-18 tok/sec | etwa 60% Layers auf GPU, etwa 40% auf CPU |
| NVIDIA RTX 4080 (16 GB) + 32 GB RAM | Partielles Offload nur | 5-10 tok/sec | Nur etwa 35% Layers auf GPU |
| 64 GB RAM, nur CPU | Ja -- nur CPU | 1-3 tok/sec | Unpraktisch für interaktive Verwendung |

Wie viel RAM benötigt ein 70B Modell bei jedem Quantisierungs-Level?
Quantisierung | RAM erforderlich | Qualität | Praktisch? |
|---|---|---|---|
| FP16 (vollständige Präzision) | etwa 140 GB | Referenz-Qualität | Nein -- nur Server |
| Q8_0 | etwa 70 GB | Nahezu verlustfrei | Nur Mac Ultra 192 GB |
| Q5_K_M | etwa 50 GB | Minimaler Verlust | Mac Ultra 64 GB, eng |
| Q4_K_M | etwa 40-43 GB | Niedriger Verlust -- empfohlen | Ja -- praktischste Option |
| Q3_K_S | etwa 30 GB | Moderater Verlust | Ja -- 32 GB Maschinen möglich |
| Q2_K | etwa 22 GB | Hoher Verlust | Nicht empfohlen |

Warum ist Apple Silicon die beste Consumer Option für 70B Modelle?
Apple Silicon nutzt unified memory -- die CPU und GPU teilen denselben physikalischen Speicherpool. Ein M5 Max MacBook Pro mit 64 GB unified memory kann ein 70B Modell bei Q4_K_M vollständig auf der GPU ausführen, erreicht 20-30 tok/sec ohne Layer Offloading Overhead.
Bei NVIDIA Hardware sind GPU und System RAM getrennt. Eine 24 GB VRAM GPU kann nur etwa 60% eines Q4_K_M 70B Modells halten; die verbleibenden Layers laufen auf der CPU, schaffen einen Memory Bandwidth Engpass, der die Geschwindigkeit auf 10-18 tok/sec reduziert.
Stand August 2026 ist ein gebrauchter Mac Studio M2 Ultra (64 GB, etwa 2.000 € gebraucht) weiterhin der kostengünstigste gebrauchte Weg zu 70B lokaler Inferenz mit praktischer Geschwindigkeit. Apple hat im August 2026 eine neue Mac-Studio-Reihe mit M5-Max- und M5-Ultra-Chips vorgestellt: der neue Mac Studio M5 Max (64 GB, 2.499 $) ist eine neue Option mit vollständiger GPU, und der Mac Studio M5 Ultra (256 GB oder 512 GB, ab 5.499 $) verdoppelt die Speicherbandbreite auf 1,2 TB/s und führt 70B-Modelle komfortabel in Q8_0 oder FP16 ohne Qualitätseinbußen aus.
Apple hat den Mac mini am 25. August 2026 aufgefrischt, verfügbar ab 22. September 2026, und das ändert erneut die günstigste Neuoption. Der Mac mini M5 Pro (ab 1.699 $) hat maximal 64 GB unified memory mit 307 GB/s Bandbreite und Thunderbolt 5 -- genug, um ein 70B Modell bei Q4_K_M vollständig auf der GPU auszuführen, und 800 $ günstiger als der Mac Studio M5 Max. Der Basis-Mac mini M6 (ab 899 $) ist eine andere Maschine: Er hat maximal 32 GB unified memory und 170 GB/s Bandbreite, deutlich weniger als die 40+ GB, die ein 70B Modell benötigt, weshalb er auf keiner Quantisierungsstufe ein 70B Modell ausführen kann. Für keinen der beiden Chips liegen bisher unabhängige Benchmarks vor -- beide sind ab dem 22. September 2026 verfügbar.
NVIDIA DGX Spark: 128GB Unified Memory für 70B Modelle
Der NVIDIA DGX Spark (4.699 $) ist ein kompakter Desktop-KI-Computer, der im Oktober 2025 auf den Markt kam und auf dem GB10 Grace Blackwell Superchip mit 128 GB unified LPDDR5x-Speicher basiert. Die Unified-Memory-Architektur bedeutet, dass sich GPU und CPU denselben 128-GB-Pool teilen -- ähnlich wie bei Apple Silicon, aber mit CUDA-Beschleunigung.
Mit 128 GB unified memory führt der DGX Spark Llama 3.3 70B und Qwen3 72B bei Q8_0 aus (70 GB -- nahezu verlustfreie Qualität). Die Inferenzgeschwindigkeit für 70B bei Q8_0 liegt bei etwa 18-28 tok/sec.
NVIDIA hat den Preis des DGX Spark Founders Edition im Februar 2026 wegen Engpässen bei der Speicherversorgung von 3.999 $ auf 4.699 $ angehoben -- derselbe DRAM-Mangel, der auch die Preise der RTX-50er-GPUs deutlich über die UVP getrieben hat.
Spec | Wert |
|---|---|
| Speicher | 128 GB unified LPDDR5x |
| 70B bei Q8_0 | Ja -- nahezu verlustfreie Qualität |
| 70B Inferenzgeschwindigkeit | 18-28 tok/sec |
| Maximale Modellgröße | etwa 200B Parameter bei FP4 |
| Preis | 4.699 $ (NVIDIA direkt / Amazon) |
| Ollama-Befehl | ollama run llama3.3:70b |
Wie funktioniert NVIDIA GPU + Layer Offloading für 70B Modelle?
Ollama und llama.cpp unterstützen das Aufteilen eines Modells über GPU VRAM und System RAM. Layers geladen in VRAM laufen mit GPU-Geschwindigkeit; Layers in System RAM laufen mit CPU-Geschwindigkeit:
# Ollama verlagert automatisch so viele Layers wie möglich in VRAM
# Um Layers explizit zu kontrollieren:
ollama run llama3.3:70b

# Überprüfe wie viele Layers auf GPU sind:
ollama ps
# Ausgabe zeigt: llama3.3:70b  ...  23/80 GPU layers

# Für llama.cpp direkt:
./llama-cli -m llama-3.3-70b-q4_k_m.gguf \
  -ngl 40   # Anzahl der zu GPU zu verlagernden Layers
  --ctx-size 4096
Ist CPU-Only 70B Inferenz praktisch?
Ein 70B Modell bei Q4_K_M auf einer hochkern-CPU (AMD Threadripper, Intel Xeon) mit 64 GB RAM erzeugt 1-3 tokens/sec. Bei 2 tok/sec dauert eine 200-Wort-Antwort etwa 75 Sekunden.
Dies ist unpraktisch für interaktiven Chat, aber brauchbar für Batch-Verarbeitung -- Zusammenfassung von Dokumenten, Generierung von Berichten oder Verarbeitung von Dateien über Nacht. Für interaktive Verwendung ist die Minimum praktische Hardware eine Maschine, die 8+ tok/sec erreichen kann, was entweder Apple Silicon oder NVIDIA GPU Offloading benötigt.
Welches 70B Modell solltest du lokal ausführen?
Modell | MMLU | HumanEval | Beste für |
|---|---|---|---|
| Llama 3.3 70B | 82% | 88% | Allgemeine Englisch Aufgaben, Anweisung-Befolgung |
| Qwen3 72B | 84% | 87% | Coding, Mehrsprachigkeit (29 Sprachen) |
| Mistral Large 123B | 84% | 80% | Benötigt 80+ GB -- nur Workstation |
70B Modelle lokal ausführen: Regionaler Kontext
EU / DSGVO: Ein lokales 70B Modell stellt die praktische Obergrenze privat betreibbarer KI-Qualität dar. Für EU-Unternehmen, die sensible Daten verarbeiten -- Rechtsdokumente, medizinische Unterlagen, Finanzanalysen -- liefert ein vor Ort betriebenes 70B Modell GPT-4-2023-Qualität bei vollständiger DSGVO-Konformität. Kein Prompt-Inhalt, Kontext oder Output verlässt die Infrastruktur der Organisation.
Für BSI-Grundschutz und Compliance im deutschen Mittelstand: Mac Studio M2 Ultra (Apple, USA) und NVIDIA DGX Spark (NVIDIA, USA) stammen beide von Nicht-EU-Anbietern. Für Organisationen, die Hardware aus EU-Lieferketten benötigen, produzieren NVIDIA-OEM-Partner (Dell, HP, Lenovo) DGX-Spark-kompatible GB10-Systeme mit EU-Support.
Modellauswahl für EU-Compliance: Mistral Large 123B (Mistral AI, Frankreich, Apache 2.0) ist das einzige 70B+-Modell eines EU-Entwicklers. Es benötigt über 80 GB RAM (nur Workstation), bietet aber die stärkste EU-IP- und Compliance-Erzählung.
Was sind die häufigen Fehler beim Ausführen von 70B Modellen auf Consumer Hardware?
- Unterschätzung des VRAM-Bedarfs: Eine GPU mit weniger als 24 GB VRAM ist zu klein. Eine RTX 4070 Ti (12 GB VRAM) kann nur etwa 30% eines Q4_K_M 70B Modells in VRAM halten. Der Rest lauft auf der CPU, was zu 3-5 tok/sec führt -- kaum schneller als reine CPU-Inferenz.
- Layer Offloading nicht aktiviert: Standardmäßig fällt Ollama zur reinen CPU-Inferenz zurück, wenn ein 70B Modell nicht vollständig in VRAM passt. Setze GPU Layers explizit mit `OLLAMA_GPU_LAYERS=999` -- Ollama verlagert dann so viele Layers wie möglich zu GPU, was erheblich schneller ist.
- Falsche Quantisierungs-Auswahl: Bei Maschinen mit 32-40 GB RAM kann Q4_K_M für ein 70B Modell zu eng sein (zu wenig Headroom für das OS). Q3_K_S reduziert RAM auf etwa 30 GB mit moderatem Qualitätsverlust. Führe `ollama ps` aus -- wenn Du Swap-Nutzung siehst, wechsle zu Q3_K_S.
- Basis-Mac mini M6 kaufen und ein 70B Modell erwarten: Der Mac mini M6 (899 $) hat maximal 32 GB unified memory -- deutlich weniger als die 40+ GB, die ein 70B Modell bei Q4_K_M benötigt. Für 70B auf einem Mac mini ist der Mac mini M5 Pro (1.699 $, 64 GB unified memory) die erforderliche Stufe -- prüfe vor dem Kauf "M5 Pro" und 64 GB, nicht den Basis-M6.
Häufig gestellte Fragen zu 70B Modellen auf Consumer Hardware
Was ist die billigste Hardware, auf der ein 70B Modell praktisch brauchbar ist?
Der Mac mini M5 Pro (1.699 $, 64 GB unified memory, ab 22. September 2026 verfügbar) wird voraussichtlich die günstigste neue Hardware sein, die ein 70B Modell ausführen kann -- 800 $ günstiger als die bisherige günstigste Neuoption, der Mac Studio M5 Max (64 GB, 2.499 $). Ein gebrauchter Mac Studio M2 Ultra (64 GB unified memory) für etwa 2.000 € bleibt der günstigste gebrauchte Weg mit bewährten 25+ tok/sec. Für den Mac mini M5 Pro liegen noch keine unabhängigen Benchmarks vor. Ein NVIDIA RTX 4090 Desktop-Setup (24 GB VRAM + 32 GB RAM) kostet etwa 3.000-4.000 € insgesamt, erzeugt aber wegen Layer Offloading langsamere Inferenz. Verwechsle den Mac mini M5 Pro nicht mit dem Basis-Mac mini M6 (899 $) -- der M6 hat maximal 32 GB unified memory und kann kein 70B Modell ausführen.
Kann der Mac mini M6 ein 70B Modell ausführen?
Nein. Der Mac mini M6 (ab 899 $) hat maximal 32 GB unified memory und 170 GB/s Bandbreite -- deutlich weniger als die 40+ GB, die ein 70B Modell bei Q4_K_M benötigt. Für 70B auf einem Mac mini bestelle den Mac mini M5 Pro (ab 1.699 $, 64 GB unified memory, 307 GB/s Bandbreite, Thunderbolt 5). Beide sind ab dem 22. September 2026 verfügbar, und für keinen der beiden Chips liegen bisher unabhängige Benchmarks vor.
Kann ich ein 70B Modell auf zwei GPUs ausführen?
Ja -- llama.cpp und Ollama unterstützen Multi-GPU Inferenz auf NVIDIA Hardware. Zwei RTX 4090s (48 GB insgesamt VRAM) passen ein Q4_K_M 70B Modell vollständig in VRAM. Ollama verwaltet Multi-GPU automatisch, wenn mehrere GPUs vorhanden sind. Tensor Parallelism in llama.cpp (`--tensor-split`) kontrolliert, wie Layers verteilt werden.
Wie vergleicht sich 70B lokale Qualität mit GPT-5.5?
Bei MMLU und HumanEval Benchmarks entspricht Llama 3.3 70B (82%, 88%) und Qwen3 72B (84%, 87%) oder übertrifft leicht GPT-4 (2023) Scores. GPT-5.5 (2024) schneidet höher bei reasoning-intensiven Aufgaben ab. Für allgemeine Anweisung-Befolgung, Zusammenfassung und Code-Generierung sind 70B lokale Modelle bei den meisten Aufgaben konkurrenzfähig mit GPT-5.5.
Unterstützt Ollama die automatische Ausführung von 70B Modellen?
Ja. Das Ausführen von `ollama run llama3.3:70b` lädt das Modell herunter und führt es mit automatischem GPU Layer Offloading aus. Ollama erkennt verfügbare VRAM und System RAM, verlagert so viele Layers wie möglich zur GPU und führt die Reste auf der CPU aus. Keine manuelle Konfiguration erforderlich für grundlegende Nutzung.
Wie viel Strom verbraucht die Ausführung eines 70B Modells?
Ein Mac Studio M2 Ultra, der 70B Inferenz ausführt, verbraucht etwa 30-50 W. Ein NVIDIA RTX 4090 Desktop unter Last verbraucht 350-450 W. Bei 0,15 € pro kWh kostet kontinuierliche 70B Inferenz auf einem RTX 4090 etwa 0,05-0,07 € pro Stunde. Apple Silicon ist 7-10× energieeffizienter für diesen Workload.
Lohnen sich 70B Modelle im Vergleich zu 13B Modellen für alltägliche Aufgaben?
Bei komplexem Reasoning, Analyse längerer Dokumente und nuanciertem Schreiben ja -- der Qualitätsunterschied ist spürbar. Bei einfacher Zusammenfassung, Fragen beantworten und Klassifizierung erzeugt ein 13B oder sogar 7B Modell fast identische Ausgaben. Führe beide auf deinen spezifischen Use-Case mit PromptQuorum durch, um den Qualitätsunterschied zu quantifizieren, bevor du in 70B Hardware investierst.
Ist die Q4_K_M Quantisierung für 70B Modelle ausreichend?
Ja, Q4_K_M ist die Standard-Empfehlung für 70B Modelle bei Verbraucher-Hardware. Der Qualitätsverlust beträgt 1-3% bei MMLU Benchmarks im Vergleich zu FP16 und ist bei praktischen Aufgaben imperceptible. Q5_K_M und Q8_0 bieten bessere Qualität, benötigen aber erheblich mehr RAM und sind auf Consumer Hardware nicht praktisch.
Sollte ich 70B oder 34B Modelle auf meinem System laufen lassen?
Wenn du mindestens 48 GB RAM hast (dediziert für das Modell), wähle 70B -- der Qualitätssprung ist erheblich und rechtfertigt die zusätzliche Hardware-Anforderung. Mit 32-48 GB RAM ist ein 34B Modell eine praktischere Option mit noch respektabler Qualität (ähnlich GPT-4o mini). Teste beide mit PromptQuorum auf deinen speziellen Aufgaben.
DSGVO: Muss ich bei der Verwendung von lokalen 70B Modellen die DSGVO beachten?
Bei lokaler Inferenz werden keine Daten an externe Server übertragen, was lokale LLMs unter der DSGVO vorteilhaft macht. Sie sind jedoch kein automatischer DSGVO-Compliance-Garant. Unter Artikel 28 (Datenverarbeitervertrag) musst du dokumentieren, wie Eingaben verarbeitet werden und wie lange Sie verwahrt werden. Beachte die BSI-Grundschutz-Kataloge für Klassifikation sensibler Daten (Kundeninfo, Finanzakten, Patientenakten). Lokale Systeme können für Verarbeitung vertraulicher Unternehmensdaten vorteilhaft sein, benötigen aber für regulierte Sektoren (Finanzwesen, Gesundheitswesen, Recht) explizite Compliance-Dokumentation mit Datenschutz- und Sicherheitsauditoren.
Ist ein 70B Modell für den deutschen Mittelstand geeignet?
Für KMU und Mittelstand-Unternehmen (50-500 Mitarbeiter) können lokale 70B Modelle strategisch sinnvoll sein. Sie ermöglichen Datenbeschaffenheit: keine Übertragung sensibler Geschäftsdaten an US-Cloud-Provider (Compliance mit BSI-Grundschutz). Typische Anwendungsfälle: Analyse von Kundenanfragen, Automatisierung von Dokumentation, interne Wissensdatenbank-Abfrage. Hardware-Kosten (Mac Studio oder RTX 4090 Workstation) von 2.000-4.000 € einmaliges Kapital amortisiert sich schnell bei größeren Teams. Empfehlung: Konsultiere mit Datenschutz- und IT-Sicherheitsberatern für Umsetzung unter DSGVO und BSI-Standard.
Quellen
- llama.cpp GPU Offloading Dokumentation -- github.com/ggerganov/llama.cpp/blob/master/docs/backend/CUDA.md
- Ollama Modellbibliothek -- ollama.com/library/llama3.3
- Apple M5 Max Inferenz Benchmarks -- github.com/ggerganov/llama.cpp/discussions (Community Benchmarks Thread)
- Meta Llama 3.3 Modell-Karte -- huggingface.co/meta-llama/Llama-3.3-70B-Instruct