Welche AMD-GPUs lohnen sich für lokale LLMs?
- RX 7900 XTX (24 GB GDDR6, 960 GB/s, RDNA 3): die AMD-Consumer-Karte mit dem meisten VRAM und der höchsten Bandbreite. Ein 32B-Modell in Q4_K_M ist etwa 20 GB groß und passt daher mit Reserve für den Kontext. Steht in AMDs ROCm-7.2.1-Matrix und auf Ollamas ROCm-Liste für Linux und Windows. Gebraucht: ca. 900–1.250 $.
- RX 9070 XT (16 GB GDDR6, 640 GB/s, RDNA 4): die neuere 16-GB-Option, in AMDs ROCm-7.2.1-Matrix und auf Ollamas Linux-ROCm-Liste. Betreibt 14B-Modelle in Q4–Q6 bequem. Neu: ca. 820–930 $.
- Radeon AI PRO R9700 (32 GB GDDR6, 640 GB/s, RDNA 4): eine Workstation-Karte mit dem meisten VRAM, den AMD in dieser Klasse verkauft. Sie verarbeitet 32B-Modelle in Q4–Q6; zwei Karten (64 GB) fassen ein 70B-Modell in Q4. AMD-Listenpreis: 1.299 $; gemeldete Straßenpreise sind höher.
- RX 7900 XT (20 GB GDDR6, 800 GB/s, RDNA 3): fasst Modelle bis etwa 24–27B in Q4. Kaufen Sie sie nur, wenn sie deutlich günstiger ist als eine gebrauchte 7900 XTX; ihr Preis wurde für dieses Update nicht neu geprüft.
- RX 6800 XT (16 GB GDDR6, 512 GB/s, RDNA 2): die Budget-Wahl für ca. 380–410 $ gebraucht. Weniger Bandbreite bedeutet langsamere Generierung, und AMDs aktuelle Radeon-ROCm-Matrix führt sie nicht mehr auf; rechnen Sie also mit Ollamas Linux-ROCm-Weg oder Vulkan.
- Mini-PCs mit Ryzen AI Max+ 395 (bis 128 GB einheitlicher Speicher, 256 GB/s): keine Grafikkarte, aber ein günstigerer Weg, sehr große Mixture-of-Experts-Modelle auf AMD zu betreiben. 128-GB-Systeme wurden Ende September 2026 für etwa 3.300–4.350 $ gelistet (Preis-Tracker). Siehe Beste AMD-Mini-PCs für lokale LLMs.
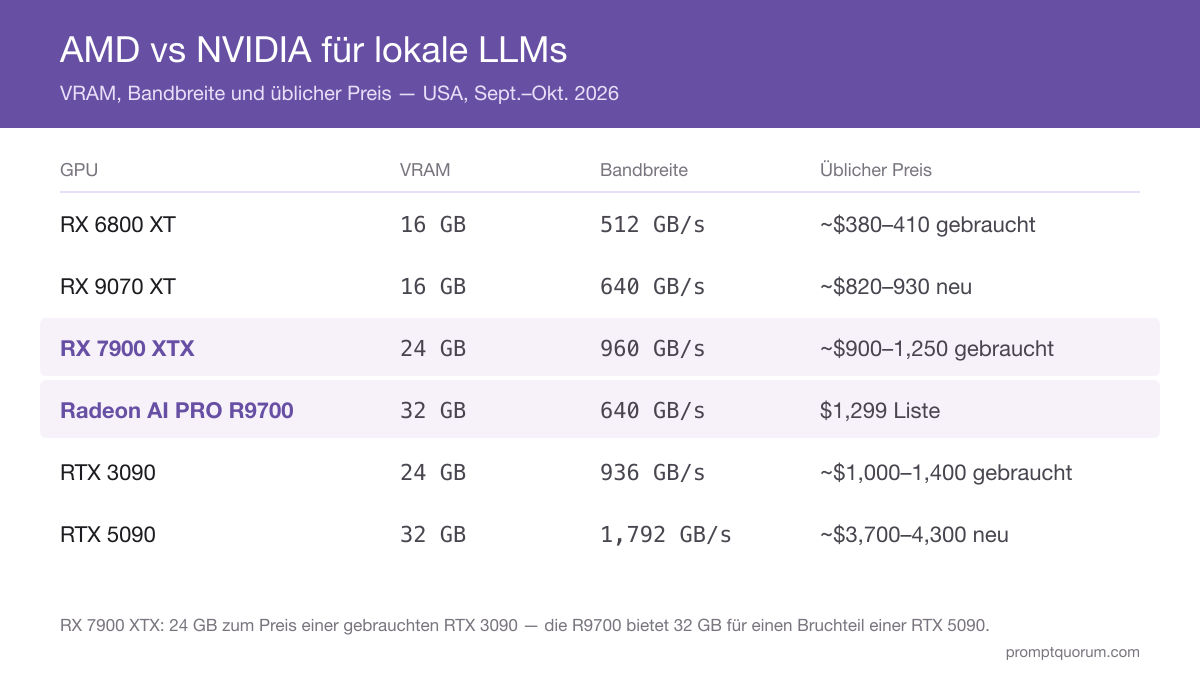
Wie schneiden AMD-GPUs bei VRAM und Preis gegen NVIDIA ab?
GPU | VRAM | Speicherbandbreite | Üblicher Preis | Haupt-Backend |
|---|---|---|---|---|
| RX 6800 XT | 16 GB | 512 GB/s | ca. 380–410 $ gebraucht | ROCm (Linux), Vulkan |
| RX 9070 XT | 16 GB | 640 GB/s | ca. 820–930 $ neu | ROCm (Linux), Vulkan |
| RX 7900 XT | 20 GB | 800 GB/s | Nicht neu geprüft | ROCm, Vulkan |
| RX 7900 XTX | 24 GB | 960 GB/s | ca. 900–1.250 $ gebraucht | ROCm, Vulkan |
| Radeon AI PRO R9700 | 32 GB | 640 GB/s | 1.299 $ Liste; ca. 1.400–1.900 $ Straße | ROCm (Linux), Vulkan |
| RTX 3090 | 24 GB | 936 GB/s | ca. 1.000–1.400 $ gebraucht | CUDA, Vulkan |
| RTX 4090 | 24 GB | 1.008 GB/s | ca. 2.250 $ gebraucht | CUDA, Vulkan |
| RTX 5090 | 32 GB | 1.792 GB/s | ca. 3.700–4.300 $ neu | CUDA, Vulkan |
VRAM und Speicherbandbreite sind Herstellerangaben (AMD RX 7900 XTX, RX 9070 XT, Radeon AI PRO R9700). Die Preise sind Momentaufnahmen von US-Angebotspreisen aus öffentlichen Preis-Trackern und Tests (Sept.–Okt. 2026), keine Messungen von PromptQuorum; in Deutschland weichen sie ab. Prüfen Sie vor dem Kauf tatsächliche Verkaufspreise, etwa bei Geizhals.

Wie schnell sind AMD-GPUs im Vergleich zu NVIDIA bei der LLM-Inferenz?
Die Token-Generierung hängt stärker von der Speicherbandbreite ab als von den TFLOPS, und AMDs Top-Karten liegen dabei nahe an NVIDIAs älteren Flaggschiffen. Die RX 7900 XTX (960 GB/s) liegt nahe an der RTX 3090 (936 GB/s) und unter der RTX 4090 (1.008 GB/s) und der RTX 5090 (1.792 GB/s).
Bei der Prompt-Verarbeitung (Prefill) liegt NVIDIA deutlicher vorn. In einem Community-Vergleich mit llama.cpp (llama.cpp-Diskussion Nr. 19890, von Tests Dritter wiedergegeben) war die RTX 5090 beim Prefill etwa 2,6–3,4-mal und bei der Generierung desselben Modells etwa 1,5-mal schneller als die Radeon AI PRO R9700. Das sind von Entwicklern gemeldete Daten, keine Messung von PromptQuorum.
Die Backend-Wahl verändert die Ergebnisse: Vulkan und ROCm (HIP) wechseln sich je nach Modell, Karte und Treiberversion an der Spitze ab. llama.cpp lässt sich mit beiden bauen – testen Sie beide auf Ihrer eigenen Karte, bevor Sie sich festlegen.
In der Praxis ist AMD bei der Generierungsgeschwindigkeit pro GB/s Bandbreite konkurrenzfähig, bei langen Prompts langsamer und bei der Software weniger ausgereift.
Wie aufwendig ist die ROCm-Einrichtung 2026?
Vulkan braucht nur einen Grafiktreiber; ROCm braucht eine unterstützte GPU, Linux-Distribution und einen passenden Kernel. Prüfen Sie das vor dem Kauf:
1. Gleichen Sie Ihre Karte mit AMDs Matrix ab. Die Radeon-Matrix für ROCm 7.2.1 führt die RX 9070 XT, RX 9060 XT, RX 7900 XTX, RX 7900 XT, RX 7900 GRE, RX 7800 XT und die Radeon AI PRO R9700 unter Ubuntu 24.04.4, Ubuntu 22.04.5 und RHEL 10.1 auf.
2. Prüfen Sie auch Ollamas Liste. Die Ollama-Dokumentation ergänzt für Linux-ROCm die RX 6800 XT, 6900 XT und weitere RX-6000-Karten und nennt die Ryzen AI Max+ 395. Nicht gelistete Karten können unter Linux `HSA_OVERRIDE_GFX_VERSION` versuchen; unter Windows wird es nicht unterstützt.
3. Installieren Sie den ROCm-v7-Stack mit AMDs Dienstprogramm `amdgpu-install` (Linux). Ollama verlangt unter Linux ROCm v7.
4. Prüfen Sie die Erkennung mit `rocminfo`: Ihre GPU sollte als Agent erscheinen (zum Beispiel gfx1100 für die RX 7900 XTX, gfx1201 für die RX 9070 XT).
5. Unter Windows nennt Ollamas ROCm-Liste RX-7000-Karten. Andere Karten, darunter die RX-9070-Serie, stehen nicht auf dieser Liste – nutzen Sie dort das Vulkan-Backend.
Die neueste ROCm-Version ist 7.14.0 (16. Juli 2026), die ROCm auf das modulare Build-System TheRock umgestellt hat. AMDs Radeon-Kompatibilitätsseite deckte bei der Prüfung Versionen bis 7.2.1 ab; gleichen Sie Ihre Karte daher mit der Matrix der Version ab, die Sie installieren.
Welche lokalen LLM-Tools laufen auf AMD-GPUs?
Ollama: ROCm v7 unter Linux für die oben genannten Karten; unter Windows RX-7000-Karten über ROCm. Vulkan ist standardmäßig aktiv, sobald das Backend installiert ist, und lässt sich mit `OLLAMA_VULKAN=0` abschalten. Aktuell ist v0.40.10 (23. Oktober 2026) mit einem Linux-ROCm-Build.
llama.cpp: baut für AMD mit HIP (ROCm) oder Vulkan (`-DGGML_VULKAN=1`). Beide Backends lassen sich zusammen kompilieren und pro Gerät mit `--device` auswählen. Die meisten Oberflächen basieren darauf.
LM Studio: unterstützt AMD-GPUs über llama.cpp-Runtimes – Vulkan und ROCm. Vulkan ist die übliche Ausweichlösung, wenn die ROCm-Runtime eine Karte nicht erkennt. (Eine frühere Version dieser Seite nannte LM Studio NVIDIA-only; das war falsch.)
vLLM: liefert ROCm-Builds (das Release ROCm 7.14.0 führt vLLM 0.23.0 auf). Es zielt auf Serving und Batching; prüfen Sie die vLLM-Dokumentation für Ihr GPU-Target, bevor Sie sich darauf verlassen.
Faustregel: Ollama oder LM Studio für Komfort, llama.cpp für Kontrolle, vLLM für Mehrbenutzer-Serving.

Wie führt man quantisierte LLM-Inferenz auf einer AMD-GPU aus?
- 1Wählen Sie die Modellgröße passend zum VRAM. Eine Q4_K_M-Datei braucht grob 0,6 GB pro Milliarde Parameter (etwa 9 GB für 14B, 20 GB für 32B; Schätzwerte). Lassen Sie 2–4 GB für den Kontext-Cache frei.
- 2Wählen Sie ein Backend. Vulkan ist der schnellste Einstieg (nur der Grafiktreiber). ROCm (HIP) ist auf unterstützten Linux-Systemen der bessere Weg.
- 3Installieren Sie eine Runtime. Installieren Sie unter Linux für den ROCm-Weg zuerst ROCm v7 mit `amdgpu-install`, danach Ollama (`curl -fsSL https://ollama.com/install.sh | sh`) oder LM Studio.
- 4Starten Sie ein quantisiertes Modell. Zum Beispiel `ollama run qwen3:14b`, oder mit llama.cpp `llama-server -m model.gguf -ngl 99`, um alle Schichten auf die GPU auszulagern.
- 5Prüfen Sie, ob die GPU genutzt wird. `ollama ps` sollte 100% GPU zeigen; `rocm-smi` zeigt den belegten VRAM. Meldet es CPU, prüfen Sie die ROCm-Installation oder wechseln Sie zu Vulkan.
Wann sollten Sie für lokale LLMs AMD statt NVIDIA kaufen?
Kaufen Sie AMD, wenn:
- Sie 32 GB auf einer Karte für weniger Geld wollen: Die Radeon AI PRO R9700 kostet etwa ein Drittel bis die Hälfte einer RTX 5090.
- Sie bereits eine unterstützte Radeon besitzen oder eine Karte wollen, die auch bei Spielen gut ist.
- Sie Linux nutzen oder mit Vulkan zufrieden sind und Ihre Tools (Ollama, llama.cpp, LM Studio) AMD bereits unterstützen.
Kaufen Sie NVIDIA, wenn:
- Sie reine CUDA-Tools, Training oder Fine-Tuning-Stacks oder die schnellste Prompt-Verarbeitung brauchen.
- Sie gebrauchte 24-GB-Karten vergleichen: Eine gebrauchte RTX 3090 kostet etwa so viel wie eine gebrauchte RX 7900 XTX, daher kann die CUDA-Unterstützung entscheiden.
- Sie möglichst wenig Zeit für die Einrichtung aufwenden wollen.
📍 In einem Satz
Kaufen Sie AMD, wenn Sie 24–32 GB VRAM günstiger als bei NVIDIAs neuesten Karten wollen; verzichten Sie darauf, wenn Sie auf reine CUDA-Tools angewiesen sind oder keinen Einrichtungsaufwand wollen.
💬 In einfachen Worten
AMD ist ein gutes Angebot, wenn Ihnen VRAM fehlt und der Software-Weg (ROCm unter Linux oder Vulkan) zu Ihnen passt. Wenn Sie neu bei lokalen LLMs sind und es einfach laufen soll, beginnen Sie mit NVIDIA.
AMD Instinct oder NVIDIA-Rechenzentrums-GPUs: Was ist besser für LLMs?
AMD Instinct (MI300X, MI350X) konkurriert mit NVIDIAs Rechenzentrums-GPUs und wird für Server gekauft, nicht für den Schreibtisch. Ollamas ROCm-Liste enthält Instinct-Karten, und ROCm wurde um sie herum gebaut; die Unterstützung ist daher breiter als bei Radeon-Consumer-Karten.
Die MI300X trägt 192 GB HBM3-Speicher pro Beschleuniger (AMD-Spezifikation), was für sehr große Modelle in einem Gehäuse passt. Für einen Einzelplatz-Rechner sind Radeon RX oder Radeon AI PRO die relevanten AMD-Optionen.
Für Server- und Cloud-Entscheidungen siehe den Kaufratgeber für Enterprise-GPU-Server und den Vergleich von Cloud-GPU-Mieten.
Was sind die häufigsten Fehler beim Einstieg mit AMD?
- Annehmen, 24 GB reichten für 70B-Modelle: Ein 70B-Modell braucht in Q4 etwa 40 GB oder mehr, eine einzelne 24-GB-Karte endet daher bei rund 30–35B. Planen Sie für 70B zwei Karten oder ein Paar R9700 mit 32 GB.
- Eine Karte kaufen, die ROCm nicht unterstützt: Prüfen Sie vorher AMDs Matrix und Ollamas Liste. RX-6000-Karten stehen nicht in AMDs aktueller Radeon-Matrix.
- Vulkan überspringen: Erkennt ROCm Ihre Karte nicht, probieren Sie das Vulkan-Backend, bevor Sie schließen, dass sich die GPU nicht nutzen lässt.
- Angebotspreisen vertrauen: GPU- und Speicherpreise haben sich 2026 spürbar bewegt. Vergleichen Sie tatsächliche Verkaufspreise, nicht Angebotspreise.
Nächste Schritte
- Beste Budget-GPUs für lokale LLMs — Knappes Budget? Die GPUs mit dem besten Preis-Leistungs-Verhältnis für LLM-Inferenz →
- GPU vs CPU vs Apple Silicon — AMD, Apple oder CPU – welche Plattform passt zu Ihrem Workflow? →
- Wie viel VRAM brauche ich? — Passen Sie den GPU-VRAM an die Modellgröße an →
Wie wirken sich regionale Datenschutzgesetze auf die Entscheidung AMD vs NVIDIA aus?
Der GPU-Hersteller ändert Ihre Datenschutzpflichten nicht; die lokale Inferenz tut es. Inferenz auf dem eigenen Gerät hält Prompts und Dokumente auf Ihrer Hardware, was das Risiko grenzüberschreitender Übermittlungen nach DSGVO, Japans APPI sowie Chinas PIPL und Datensicherheitsgesetz verringern kann. Compliance verlangt weiterhin eine Rechtsgrundlage, Aufbewahrungsregeln und Verfahren bei Datenpannen; in Deutschland und der DACH-Region sind zudem die IT-Sicherheitsstandards des BSI (IT-Grundschutz) zu beachten. Lassen Sie regulierte Daten formal prüfen.
Exportkontrollregeln können Hochleistungsbeschleuniger von AMD und NVIDIA in einzelnen Märkten einschränken. Prüfen Sie die aktuellen Regeln für Ihr Land, bevor Sie importieren oder kaufen.
Häufig gestellte Fragen
Sind AMD-GPUs gut für den Betrieb lokaler LLMs?
Ja, mit Einschränkungen. AMD-Karten wie die RX 7900 XTX (24 GB) und die Radeon AI PRO R9700 (32 GB) betreiben quantisierte LLMs über ROCm oder Vulkan in Ollama, LM Studio und llama.cpp. NVIDIA CUDA hat weiterhin die breitere Software-Unterstützung und die schnellere Prompt-Verarbeitung; AMD passt daher am besten, wenn VRAM pro Dollar zählt.
Was ist die beste AMD-Karte für KI und lokale LLMs?
Die RX 7900 XTX ist die beste AMD-Allroundkarte für lokale LLMs: 24 GB VRAM, 960 GB/s Speicherbandbreite und Unterstützung in AMDs ROCm-7.2.1-Matrix und in Ollama. Für mehr VRAM pro Karte bietet die Radeon AI PRO R9700 32 GB; für Modelle mit 7B–14B genügt die RX 9070 XT (16 GB).
AMD vs NVIDIA für lokale LLMs: Was sollte ich kaufen?
Kaufen Sie NVIDIA, wenn Sie CUDA-Kompatibilität und möglichst wenig Einrichtung wollen. Kaufen Sie AMD, wenn Sie mehr VRAM pro Dollar wollen, vor allem die R9700 mit 32 GB gegenüber der RTX 5090. Eine gebrauchte RX 7900 XTX kostet etwa so viel wie eine gebrauchte RTX 3090; dort entscheidet die Software.
Funktioniert Ollama mit AMD-GPUs?
Ja. Ollama verlangt unter Linux den ROCm-v7-Treiber und führt die RX 9070 XT, RX 7900 XTX, RX 6800 XT, Radeon AI PRO R9700 und weitere auf. Unter Windows deckt die ROCm-Liste RX-7000-Karten ab, und Vulkan ist standardmäßig aktiv, sobald das Backend installiert ist.
Unterstützt LM Studio AMD-GPUs?
Ja. LM Studio betreibt AMD-GPUs über llama.cpp-Runtimes, entweder Vulkan oder ROCm. Erkennt die ROCm-Runtime Ihre Karte nicht, stellen Sie die Runtime auf Vulkan um. Frühere Versionen dieser Seite nannten LM Studio fälschlich NVIDIA-only.
Wie führe ich quantisierte LLM-Inferenz auf AMD-GPU-Hardware aus?
Wählen Sie ein quantisiertes Modell, das in Ihren VRAM passt (Q4_K_M sind grob 0,6 GB pro Milliarde Parameter), installieren Sie Ollama oder LM Studio und nutzen Sie Vulkan oder ROCm. Installieren Sie unter Linux ROCm v7 mit amdgpu-install, starten Sie das Modell und prüfen Sie die GPU-Nutzung mit ollama ps oder rocm-smi.
RX 9070 XT oder RX 7900 XTX für lokale LLMs?
Für lokale LLMs ist die RX 7900 XTX die bessere Wahl, denn 24 GB fassen Modelle bis etwa 30–35B in Q4, während die 16 GB der RX 9070 XT bei etwa 14B–24B enden. Die RX 9070 XT ist neuer und günstiger; wählen Sie sie, wenn 16 GB genügen.
Was ist die beste AMD-GPU unter 500 $?
Die RX 6800 XT (16 GB) für ca. 380–410 $ gebraucht ist die beste AMD-Karte unter 500 $. Sie betreibt Modelle mit 7B–14B in Q4–Q8, steht aber nicht in AMDs aktueller Radeon-ROCm-Matrix; rechnen Sie also mit Ollamas Linux-ROCm-Weg oder Vulkan.
Lohnt sich die Radeon AI PRO R9700 für lokale KI?
Ja, wenn Sie 32 GB auf einer Karte brauchen. Ihr Listenpreis liegt bei 1.299 $, gegenüber etwa 3.700–4.300 $ für eine RTX 5090; gemeldete Straßenpreise sind jedoch höher, und die Prompt-Verarbeitung ist langsamer. Zwei R9700 ergeben 64 GB für 70B-Modelle in Q4.
Brauche ich Linux für AMD ROCm, oder funktioniert Windows?
Linux ist der besser unterstützte ROCm-Weg: AMDs Matrix führt Ubuntu 24.04.4, Ubuntu 22.04.5 und RHEL 10.1 auf. Unter Windows deckt Ollamas ROCm-Liste RX-7000-Karten ab, andere Karten nutzen das Vulkan-Backend.
Was ist für LLMs besser, AMD Instinct oder NVIDIA-GPUs?
Instinct (MI300X, MI350X) konkurriert mit NVIDIAs Rechenzentrums-GPUs und wird für Server gekauft; die MI300X hat 192 GB HBM3. Für einen einzelnen Desktop sind Radeon oder Radeon AI PRO die relevanten AMD-Optionen, und NVIDIAs CUDA-Ökosystem ist weiterhin breiter.
Was ist die beste AMD-GPU für Deep Learning und Machine Learning?
Für Inferenz sind die RX 7900 XTX (24 GB) und die Radeon AI PRO R9700 (32 GB) die besten AMD-Optionen. ROCm liefert PyTorch-Builds (das Release ROCm 7.14.0 führt PyTorch 2.12.0 auf). Für Training und Forschungscode, der CUDA voraussetzt, hat NVIDIA weiterhin das breitere Ökosystem; prüfen Sie die AMD-Unterstützung Ihres Frameworks vor dem Kauf.
Ist ein Mini-PC mit Ryzen AI Max+ 395 besser als eine dedizierte AMD-GPU?
Das hängt von der Modellgröße ab. Ryzen-AI-Max+-395-Systeme bieten bis zu 128 GB einheitlichen Speicher, aber nur 256 GB/s Bandbreite; sie eignen sich für große Mixture-of-Experts-Modelle, während eine dedizierte Karte bei Modellen, die in ihren VRAM passen, Token schneller generiert.
Quellen
- Ollama-GPU-Dokumentation: AMD-ROCm-v7-Anforderung, unterstützte Radeon-, Radeon-AI-PRO-, Radeon-PRO-, Ryzen-AI- und Instinct-Karten, Vulkan-Backend
- Ollama-Releases: v0.40.10, 23. Oktober 2026
- AMD ROCm auf Radeon und Ryzen – Linux-Kompatibilität: von ROCm 7.2.1 unterstützte Radeon-GPUs und Distributionen
- ROCm-Releases: ROCm 7.14.0, 16. Juli 2026, Framework-Versionen
- llama.cpp-Build-Dokumentation: HIP- und Vulkan-Backends
- AMD-Produktspezifikationen: RX 7900 XTX, RX 9070 XT, Radeon AI PRO R9700
- Preis-Momentaufnahmen (USA, Sept.–Okt. 2026): öffentliche GPU-Preis-Tracker und Tests Dritter; es sind Angebotspreise, die sich schnell ändern
- AMD-GPUs liefern hohe Token-pro-Sekunde-Werte, aber Geschwindigkeit allein bestimmt nicht die Antwortqualität. Was Sie das Modell fragen, zählt ebenso wie die Antwortgeschwindigkeit: Kontextfenster erklärt zeigt, wie Sie längere Anfragen innerhalb der GPU-Speichergrenzen strukturieren.