VRAM-Berechnungsformel für lokale LLMs
VRAM erforderlich = Modellparameter in Milliarden × Byte pro Parameter + (KV-Cache + Laufzeit-Overhead)
Byte pro Parameter (Q4 stimmt mit echten GGUF-Dateien überein, die übrigen Werte sind berechnet): ~1,05 (Q8), ~0,7 (Q5), ~0,6 (Q4).
Beispiel: Llama-3 7B Q4 = 7 × 0,6 + 1,5 GB Overhead = 4,2 + 1,5 ≈ 5,7 GB (echtes Llama-2-7B Q4_K_M GGUF = 4,08 GB Gewichte)
Beispiel: Llama-3.3 70B Q4 = 70 × 0,6 = 42 GB Gewichte (echtes Llama-3.3-70B Q4_K_M GGUF = 42,52 GB)
Q4: real ~0,6 Byte/Parameter (nicht die theoretischen 0,5 Byte -- reale Formate wie Q4_K_M haben etwas Overhead).
Q8: real ~1,05 Byte/Parameter.
FP32: Keine Kompression, vollständige Präzision, 4 Byte/Parameter, VRAM-intensiv.
KV-Cache: Proportional zur Sequenzlänge -- 128-Token-Ausgabe +1-2 GB, 2048-Token +5 GB.
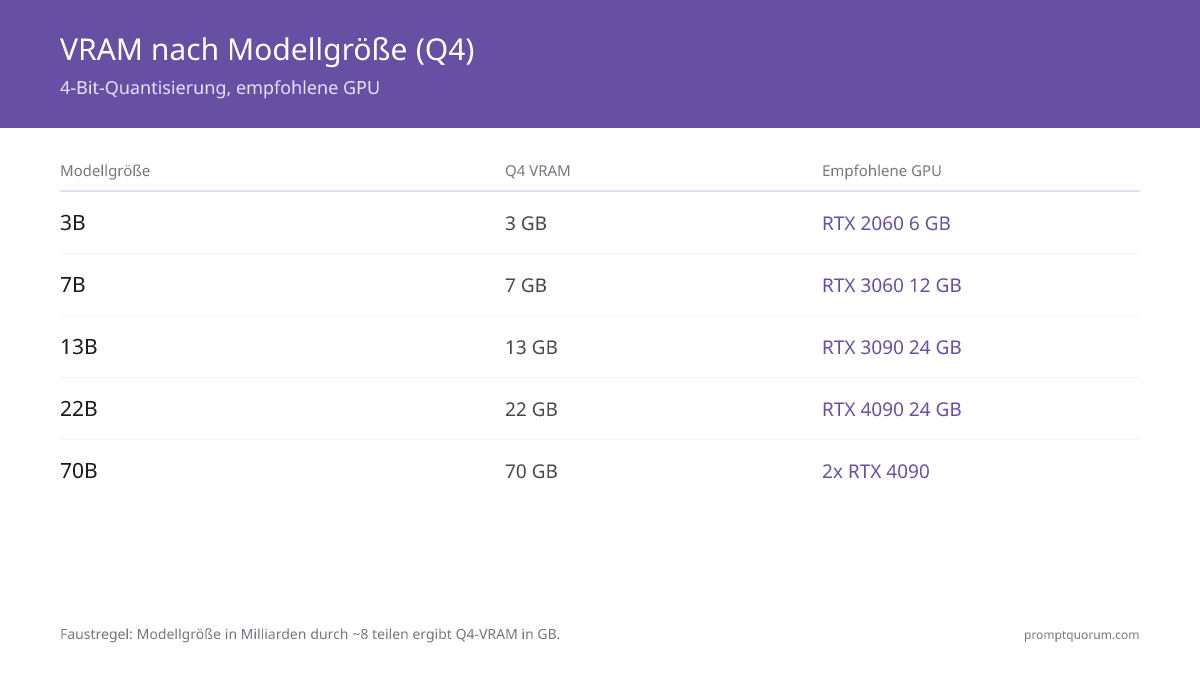
VRAM nach Modellgröße
Modellgröße | FP32 | Q8 | Q5 | Q4 | Empfohlene GPU |
|---|---|---|---|---|---|
| 3B | 12 GB | 3 GB | 2 GB | 2 GB | RTX 3050 4GB oder RTX 2060 6GB |
| 7B | 28 GB | 7 GB | 5 GB | 4 GB | RTX 4060 (8GB), RTX 3060 (12GB) |
| 13B | 52 GB | 14 GB | 9 GB | 8 GB | RTX 3060 (12GB), RTX 4070 (12GB) |
| 70B | 280 GB | 74 GB | 50 GB | 42 GB | Zwei RTX 4090 (24GB×2) oder A100 (80GB) |
| Qwen 3.6 35B-A3B (3B aktiv / 35B gesamt, MoE)* | ~140 GB | ~37 GB | ~25 GB | ~21 GB | RTX 5090 32GB oder RTX 4090/3090 24GB (knapp; Q4) |
| DeepSeek-V4.1-Flash-1017 (763B gesamt, MoE)* | ~3,1 TB | ~800 GB | ~530 GB | ~460 GB | Multi-GPU-Server oder 512 GB Unified Memory (nur Q4) |
| Llama 4 Scout (17B aktiv / 109B gesamt, MoE)† | 436 GB | 114 GB | 76 GB | 55 GB | Zwei RTX 4090 (48 GB) — passt in 24 GB nur bei 1,78-Bit (Richtwert, nicht von PromptQuorum gemessen) |
| gpt-oss:20b (3,6B aktiv / 21B gesamt, MoE)* | 84 GB | 21 GB | 13 GB | 12 GB | RTX 5070 12GB oder jede 16-GB-GPU |
| Kimi K2.6 (32B aktiv / 1T gesamt, MoE)* | ~4 TB | ~1 TB | ~700 GB | ~600 GB | Multi-GPU-Server (~600 GB bei Q4) |
| Kontext (KV-Cache) | +40 GB @ 2048 Token | +10 GB @ 2048 Token | +6 GB @ 2048 Token | +3-5 GB @ 2048 Token | Durch Ollama-Kontextlänge und top_k verwaltet |
Zahlen sind reine Gewichtsgrößen; die übrigen Quantisierungsstufen und die MoE-Zeilen sind berechnete Schätzwerte, die Q4-Werte stimmen dagegen mit drei echten GGUF-Dateigrößen auf Hugging Face überein (z. B. Llama-2-7B Q4_K_M = 4,08 GB, Mistral-Small-24B Q4_K_M = 14,33 GB, Llama-3.3-70B Q4_K_M = 42,52 GB) -- rechnen Sie 1-2 GB Puffer für Kontext/KV-Cache dazu. * MoE-Zeilen: aus den Gesamtparametern berechnet (etwa 0,6 GB je Milliarde bei Q4): alle Experten bleiben im Speicher, aktive Parameter beeinflussen nur die Geschwindigkeit. Werte sind ungefähr. † Llama 4 Scout hält alle 109B Parameter resident, daher benötigt es ~55 GB bei Q4 trotz nur 17B aktiver Parameter pro Token. Quellen: Llama-2-7B GGUF, Mistral-Small-24B GGUF, Llama-3.3-70B GGUF.

Wie reduziert Quantisierung VRAM-Anforderungen?
Quantisierung komprimiert Modellgewichte zu niedriger Präzision. Die Umwandlung von FP32 (32-Bit) auf Q4 (4-Bit) reduziert Werte um 87%.
Q4 (4-Bit): Standard für Consumer-GPUs. VRAM: 3,5× Reduktion. Qualität: meist geringer Verlust, je nach Modell und Aufgabe. Für die meisten Aufgaben empfohlen.
Q5 (5-Bit): Ähnlich wie Q4, aber meist etwas bessere Genauigkeit. VRAM: 25% mehr, minimale Qualitätsverbesserung. Nur für fortgeschrittene Anwendungsfälle.
Q8 (8-Bit): Nahezu vollständige Präzision (meist kaum messbarer Verlust). VRAM-Reduktion: 4×. RTX 4080+ empfohlen.
FP32 (Vollständige Präzision): Alle Gewichte werden mit 32 Bit gespeichert. Auf Consumer-GPUs nicht praktikabel -- 70B FP32 benötigt 280 GB VRAM.
VRAM bestimmt die Modellgröße, aber das Prompt-Design bestimmt die Ausgabequalität. Techniken wie Chain-of-Thought und Few-Shot-Prompting können die Qualitätslücke zwischen kleineren und größeren Modellen schließen. Entdecken Sie das vollständige Prompt-Engineering-Toolkit, um mehr aus den Modellen herauszuholen, die Ihre Hardware unterstützt. Wenn Sie 12–16 GB VRAM haben und einen konkreten Coding-Workload zum Testen dieses Toolkits suchen, beschreibt GitHub Copilot durch ein lokales LLM ersetzen den Continue.dev + Ollama + Qwen3-Coder-Stack passend zu genau diesen VRAM-Stufen.

Batch-Größe und Multi-User-Inferenz
Batch-Größe ist die Anzahl der Text-Eingaben, die in einer Ausführung verarbeitet werden.
Single-User-Inferenz (batch=1): Eine Eingabeaufforderung auf einer GPU. VRAM: Nur Modellgröße + KV-Cache.
Beispiel: Llama3 7B Q4 = 3,5 GB (Modell) + 1,5 GB (KV-Cache) = 5 GB.
Batch-Verarbeitung (batch=4, 8, 16): Mehrere Eingaben gleichzeitig verarbeiten. VRAM: Die Gewichte werden geteilt; zusätzlich wächst vor allem der KV-Cache (einer pro Anfrage).
batch=4: Gewichte nur einmal, dazu vier KV-Caches — bei 7B Q4 und moderatem Kontext typischerweise wenige GB zusätzlich, nicht ×4 VRAM. Der Durchsatz steigt oft deutlich (je nach Setup).
Batch-Inferenz ist wichtig für Multi-User-Server (3-5 Personen, gleichzeitige Anfragen). Für Single-User/Entwicklung nicht erforderlich.
KV-Cache (abhängig von Sequenzlänge):
VRAM-Overhead: Mehr als nur Modellgröße
Die Parametergröße des Modells ist nicht das gesamte VRAM-Anforderungs-Bild. Zusätzlicher Speicher ist erforderlich:
KV-Cache (Key-Value Cache): Das Modell muss vorherige Token „merken". Nebenprodukt des Transformer-Aufmerksamkeitsmechanismus.
- Proportional zur Eingabe-Ausgabe-Länge.
- 7B-Modell, 2048-Token-Kontext, batch=1: +2-4 GB.
Aktivierungen: Zwischenrechenergebnisse während der Inferenz.
- Typischerweise 10-15% der Modellgröße.
- 7B: +0,7-1,5 GB.
Laufzeit-Overhead: CUDA-Speicherpool, Framebuffer, OS-Reservierungen.
- Typischerweise 0,5-1,5 GB.
Häufige Fehler
Missverständnis 1: „VRAM erforderlich = Modellgröße"
VRAM ist immer größer als die Modellgröße. Ein 4 GB-Modell (7B Q4) benötigt real eher 5-6 GB mit Puffer. RTX 4060 8 GB ist sicher, aber RTX 3060 6 GB kann eng werden.
Missverständnis 2: „Apple Silicon (M3) Speicher ist nicht das gleiche wie GPU VRAM"
Apple Silicon verwendet Unified Memory -- CPU und GPU teilen einen Speicherpool. Unified Memory ist nur teilweise als GPU-Speicher nutzbar; macOS reserviert einen Teil. Ein 13B-Modell in Q4 (~7 GB) kann auf M3 16 GB ausgeführt werden.
Missverständnis 3: „Quantisierung verlangsamt die Inferenz"
Tatsächlich: Q4 ist schneller als Q5/Q8. Niedrigere Speicherbandbreite, effizienterer Cache. Ollama: Q4 ist einige Prozentpunkte schneller.
Regionales Umfeld
EU und Deutschland (DSGVO + BSI)
Lokale LLM-Inferenz kann helfen, Datenabflüsse an Cloud-Anbieter zu vermeiden, und damit die DSGVO-Fragen für diesen Verarbeitungsschritt vereinfachen. Ob ein Einsatz DSGVO-konform ist, hängt jedoch von Ihrer gesamten Verarbeitung ab (Rechtsgrundlage, technische und organisatorische Maßnahmen, Auftragsverarbeitung, ggf. Datenschutz-Folgenabschätzung) und nicht allein vom Ort der Inferenz. Das BSI (Bundesamt für Sicherheit in der Informationstechnik) veröffentlicht IT-Sicherheitsempfehlungen; klären Sie mit Ihrer oder Ihrem Datenschutzbeauftragten, was für Ihren Fall gilt. Dies ist eine allgemeine Information, keine Rechtsberatung.
Orientierungswerte für den deutschen Mittelstand (Richtwerte, keine Vorgaben):
- 1-50 Nutzer: RTX 4070 Ti (12 GB) mit einem 13B-Modell in Q4 (7-8 GB). Skalierbar mit Ollama im single-GPU-Modus.
- 50-500 Nutzer: RTX A6000 (48 GB) oder Dual RTX 4080 (32 GB) für parallele Anfragen und Batch-Verarbeitung. Erfordert vLLM oder Text Generation WebUI.
- 500+ Nutzer: A100 (80 GB) oder H100 (80 GB). Enterprise-Setup mit Load-Balancing über mehrere Server.
Mögliche Sicherheitsmaßnahmen (an BSI-Empfehlungen orientieren):
- ECC-GPUs (A6000, A100) können Speicherfehler erkennen.
- GPU-Speicher-Dumps durch physische Sicherheit oder verschlüsselten Speicher (sofern verfügbar) erschweren.
- Modellabhängigkeiten und die Herkunft der Trainingsdaten im Rahmen Ihrer DSGVO-Dokumentation prüfen.
VRAM-Rechner
Wählen Sie Ihre Modellgröße und Quantisierung aus, um die VRAM-Anforderungen zu schätzen.
Beliebte Modelle
Basismodell
6.50 GB
Kontext-Overhead
1.50 GB
Batch-Overhead
0.00 GB
System-Overhead
1.00 GB
Mindest-VRAM
9.00 GB
Empfohlen (mit 25 % Sicherheitspuffer)
11.25 GB
👉 GPU mit mindestens 11.25 GB VRAM
Kompatible GPUs
RTX 3060 (12 GB)
0.8 GB Puffer
RTX 4060 Ti (16 GB)
4.8 GB Puffer
RTX 4070 Ti Super (16 GB)
4.8 GB Puffer
RTX 4080 Super (16 GB)
4.8 GB Puffer
RTX 4090 (24 GB)
12.8 GB Puffer
RTX 5090 (32 GB)
20.8 GB Puffer
Mac Mini M6 (32 GB) (−8 GB macOS = 24 GB)
12.8 GB Puffer
Mac Mini M5 Pro (64 GB) (−8 GB macOS = 56 GB)
44.8 GB Puffer
Mac Studio M5 Max (128 GB) (−8 GB macOS = 120 GB)
108.8 GB Puffer
Mac Studio M5 Ultra (96 GB+) (−8 GB macOS = 88 GB)
76.8 GB Puffer
💡 Praxis-Tipps:
- Kaufen Sie immer anhand des Werts „mit Sicherheitspuffer"
- Q4 liefert 90–95 % Qualität bei 25 % weniger Größe. Q5 ist besser, wenn VRAM vorhanden
- Kontext-Overhead wächst mit der Konversationslänge. Planen Sie 1–3 GB für typische Nutzung ein
- Batch-Größe ist wichtig für Multi-User-APIs. Einzelnutzer-Chat kann Batch-Overhead ignorieren
📋 Diese Konfiguration teilen:
Kann ein 3B-Modell auf meiner GPU laufen?
Ja. Q4-Quantisierung benötigt für ein 3B-Modell nur 1,5-2 GB VRAM; es läuft auf nahezu jeder GPU mit 4 GB (z. B. RTX 3050 4 GB) und notfalls auf der CPU. Ollama, Llama.cpp, LM Studio unterstützen alle.
Ist RTX 4060 ausreichend für 7B Q4?
Knapp. RTX 4060 (8 GB) sollte 5 GB theoretisch verwalten, aber OS/Laufzeit-Overhead (0,5-1,5 GB) wird eng. RTX 4070 (12 GB) empfohlen.
Sind 12 GB für ein 13B-Modell ausreichend?
Ja, deutlich. Ein 13B-Modell braucht bei Q4 nur etwa 8 GB, 12 GB lässt also echten Puffer. Bei Q5 (~9 GB) ist es noch komfortabel; bei Q8 (~14 GB) wird es eng.
Benötige ich 24 GB für ein 70B-Modell?
Nein, aber Sie brauchen fast so viel. Ein 70B-Modell benötigt etwa 42 GB bei Q4 allein für die Gewichte. Bei Q5+ sind es 50 GB+. 24 GB reichen für ein 70B-Modell bei Q4 oder höher nicht aus; Quantisierungen unter 4 Bit passen mit Qualitätsverlust.
Reduziert höhere Batch-Größe VRAM für einzelne Inferenz?
Nein. Einzelne Inferenz verwendet immer batch=1. Batch-Größe hilft nur Durchsatz (Multi-User-Szenarios).
Was ist die präziseste Quantisierung?
Q8 verliert meist kaum Qualität; Q5 und Q4 etwas mehr, je nach Modell und Aufgabe. Für die meisten Fälle Q4 beste Balance.
Kann ich Teil des VRAM auf CPU-RAM auslagern?
Ja, über teilweises Auslagern von Layern ins System-RAM. Llama.cpp und Ollama unterstützen es. Die Leistung kann deutlich sinken (oft um 30-50% oder mehr, je nach Anzahl der ausgelagerten Layer).
Was ist die minimale VRAM für lokale LLM-Ausführung?
4 GB VRAM mit 3B Q4-Modell -- Modell ~1,8 GB, KV-Cache hat Platz. Praktisches Minimum 8 GB VRAM + 7B Q4. Unter 6 GB OOM für die meisten 7B-Modelle.
Ist Apple Silicon VRAM dasselbe wie GPU VRAM?
Apple Silicon verwendet Unified Memory zwischen CPU/GPU gemeinsam -- Unified Memory ist nur teilweise als GPU-Speicher nutzbar; macOS reserviert einen Teil. Ein MacBook Pro M3 mit 18 GB kann ein 13B-Modell in Q4 (~7 GB) + Overhead ausführen.
Wie viel VRAM benötigt 7B bei verschiedenen Quantisierungen?
7B FP32: ~28 GB -- unpraktisch auf Consumer-GPUs. 7B Q8: ~7 GB -- passt auf RTX 4070 Ti 12 GB mit Puffer. 7B Q5: ~5 GB -- passt auf 8 GB GPU. 7B Q4: ~4 GB Gewichte + ~1-2 GB Overhead = ~5-6 GB -- passt auf 6 GB GPU eng, 8 GB komfortabel.
Welche VRAM-Anforderungen hat lokale Inferenz in Unternehmen mit Datenschutzanforderungen?
Minimum RTX 4070 Ti (12 GB) für bis zu 50 Nutzer mit einem 13B-Modell in Q4. Für 50-500 Nutzer RTX A6000 (48 GB) oder Dual RTX 4080 (32 GB). ECC-GPU kann zur Speicherfehler-Erkennung sinnvoll sein; GPU-Speicher-Dumps sollten durch Firmware- und physische Sicherheit erschwert werden. Ob der Einsatz datenschutzkonform ist, hängt von Ihrer gesamten Verarbeitung ab; keine Rechtsberatung.
Welche GPU empfiehlt sich für einen Team-Server im deutschen Mittelstand?
RTX 4070 Ti (12 GB) für 1-50 Mitarbeiter. RTX A6000 (48 GB) oder Dual RTX 4080 (32 GB) für 50-500 Mitarbeiter. RTX 4070 Ti kann ein 13B-Modell in Q4 + vLLM mit 3-5 gleichzeitigen Anfragen verwalten. Größere Teams benötigen A100 (80 GB) oder H100 und Enterprise-Clustering.
Quellen
- NVIDIA CUDA-Dokumentation: GPU-Speicherverwaltung, Tensor Cores, Compute Capability
- Ollama-Dokumentation: VRAM-Anforderungen, Quantisierungsschemata, GPU-Kompatibilitätsmatrix
- Llama.cpp GitHub: GGUF-Format, Q4/Q5/Q8-Implementierung, Speicher-Profilierung