Warum lokale Coding-Modelle aufgeholt haben
In den ersten Jahren der LLM-Ära lagen Cloud-Modelle beim Coding klar vor lokalen Modellen. Diese Lücke ist 2025–2026 kleiner geworden, als Open-Weight-Modelle im Bereich 24–30B Parameter mit auf Code ausgerichtetem Training erschienen.
Qwen3.6 27B, veröffentlicht im April 2026, gibt 77,2 auf SWE-bench Verified an, einem Benchmark mit echten GitHub-Issues aus Open-Source-Python-Projekten. In derselben Tabelle auf der Model Card nennt Qwen 75,0 für Qwen3.5-27B und 80,9 für Claude 4.5 Opus; das offene Modell liegt in diesem vom Hersteller veröffentlichten Test also nahe an einem führenden Cloud-Modell. Das sind Qwens eigene Ergebnisse mit einem internen Agenten-Aufbau, keine unabhängige Überprüfung.
Häufig genannte Gründe für die Annäherung sind (1) Trainingsdaten mit Fokus auf Code in großem Umfang, (2) Nachtraining auf echten Software-Engineering-Aufgaben statt allgemeinem Befolgen von Anweisungen und (3) bessere GGUF-Quantisierung, die die Coding-Fähigkeit bei Q4-Präzision erhält.
📍 In einem Satz
Qwen3.6 27B gibt 77,2 % auf SWE-bench Verified an und läuft lokal mit einem Download von 18–19 GB.
💬 In einfachen Worten
SWE-bench Verified prüft, ob eine KI echte GitHub-Issues in Open-Source-Projekten wie Django, Flask und scikit-learn lösen kann. 77,2 % bedeutet: Das Modell löste etwa 77 von 100 Testaufgaben, gemessen mit dem eigenen Agenten-Aufbau des Herstellers.
Benchmark-Tabelle
Alle Zahlen sind Herstellerangaben aus Model Cards und Ollama-Einträgen. Die Testaufbauten unterscheiden sich zwischen den Herstellern, daher sind SWE-bench-Werte Richtwerte und kein kontrollierter Direktvergleich. PromptQuorum hat diese Benchmarks nicht erneut ausgeführt.
Benchmark | Qwen3.6 27B | DeepSeek V4 Flash | Devstral Small 2 | Codestral 22B |
|---|---|---|---|---|
| SWE-bench Verified (Herstellerangabe) | 77,2 % | 78,6 % (High) / 79,0 % (Max) | 65,8 % | Nicht veröffentlicht |
| Parameter (gesamt / aktiv) | 27B dicht | 284B / 13B aktiv | 24B dicht | 22B dicht |
| Kontextfenster | 256K | 1M | 384K | 32K |
📌Hinweis: Qwens 77,2 stammt aus Qwens internem Agenten-Aufbau. DeepSeek gibt 73,7 (ohne Denkmodus), 78,6 (High) und 79,0 (Max) an. Die 65,8 von Devstral Small 2 stammen aus dem Ollama-Eintrag. Die Aufbauten unterscheiden sich, die Zahlen sind daher nicht direkt vergleichbar.
💡Tipp: Die Modellnamen der DeepSeek-API ändern sich. Prüfen Sie vor dem Einsatz api-docs.deepseek.com/quick_start/pricing (aktuelle Namen: deepseek-flash und deepseek-v4-pro).
Kosten pro Token
Die Wirtschaftlichkeit von Coding-LLMs hängt von Nutzungsvolumen, Aufgabensensibilität und Hardware ab. Die Rechnung unten gilt für einen Entwickler und beruht auf den genannten Annahmen; sie ist Arithmetik, keine Messung. Strom ist mit 0,35 €/kWh angesetzt, einem typischen deutschen Preis; prüfen Sie Ihren eigenen Tarif.
Bei 5 Mio. Token pro Tag (intensive Sitzung mit Autovervollständigung, Testgenerierung und Code-Review) und einem Input-zu-Output-Verhältnis von 1:2 kostet die DeepSeek-API (deepseek-flash, außerhalb der Spitzenzeiten 0,15 $ Input und 0,60 $ Output pro 1 Mio. Token) etwa 2,25 $ pro Tag, also rund 560 $ über 250 Arbeitstage. Zu Spitzenzeittarifen (0,30 $ Input, 1,20 $ Output) kostet dieselbe Nutzung etwa 4,50 $ pro Tag, rund 1.125 $ pro Jahr.
Ein lokales Setup tauscht das gegen Hardware und Strom. Eine RTX 4090 zu angenommenen 2.300 $, die an 250 Tagen je 8 Stunden 350 W zieht, verbraucht 700 kWh, etwa 245 € pro Jahr. Ohne Wechselkurse amortisiert sich die Hardware gegenüber den API-Tarifen außerhalb der Spitzenzeiten in etwa 7 Jahren und gegenüber den Spitzenzeittarifen in etwa 2,6 Jahren. Bei sensiblem Code geht es nicht nur um Kosten: Eine Cloud-API sendet Ihren Code an Dritte.
# Cost calculator: per-token math for coding LLMs (every input is an assumption)
# DeepSeek API, deepseek-flash, off-peak rates in USD per 1M tokens (api-docs.deepseek.com)
input_rate, output_rate = 0.15, 0.60
daily_tokens = 5_000_000              # per developer
blended = (input_rate * 1 + output_rate * 2) / 3   # 1:2 input:output split = $0.45/1M
daily_cost = daily_tokens / 1_000_000 * blended     # $2.25/day
annual_api = daily_cost * 250                       # ~$562/year (peak rates: ~$1,125/year)

# Local Qwen3.6 27B on an RTX 4090 (price is an assumption)
hardware_cost = 2300                  # USD
power_kwh     = 0.350 * 8 * 250       # 350 W, 8 h/day, 250 days = 700 kWh
annual_power  = power_kwh * 0.35      # EUR 0.35/kWh = ~245 per year
# Break-even vs off-peak API: hardware_cost / (annual_api - annual_power) = ~7.3 years
# Break-even vs peak API:     hardware_cost / (1125 - annual_power)       = ~2.6 years
Latenz in der Praxis
Latenz ist beim interaktiven Coding entscheidend: Autovervollständigung wirkt ab etwa 500 ms kaputt, Code-Review ist bis 3 s akzeptabel, Batch-Jobs sind latenzunempfindlich. PromptQuorum hat diese Modelle nicht gemessen. Die Tabelle zeigt einen Drittanbieter-Test mit Ollama auf einer RTX 4090 (24 GB, Ollama 0.34.4, September 2026), den einzigen veröffentlichten Lauf, den wir für diese Modelle gefunden haben; Ihre Werte weichen je nach Quantisierung, Kontextlänge und Treibern ab.
Setup | Dauerhaft (Tok/s) | Hinweis |
|---|---|---|
| Qwen3.6 27B, RTX 4090 (Draft-Decoding an) | 115,4 | Mittel aus fünf Prompts, 256 Token Ausgabe |
| Qwen3.6 27B, RTX 4090 (Draft-Decoding aus) | 48,9 | Einzelner Prompt, gleicher Aufbau |
| Qwen3-Coder 30B, RTX 4090 | 224,7 | MoE mit 3,3B aktiven Parametern |
| Devstral Small 2 | Nicht gemessen | Kein veröffentlichter Lauf gefunden |
| DeepSeek-API (deepseek-flash) | Nicht gemessen | Abhängig von Netzwerk und Spitzenzeiten |
Quelle: Ollama Models Cheat Sheet (Test eines Drittanbieters, nicht von PromptQuorum). Laut dem Artikel machte spekulatives Decoding (Draft-Token) Qwen3.6 27B in diesem Test etwa 2,4-mal schneller, ohne die Ausgabequalität zu ändern. Apple veröffentlicht keine Token-Geschwindigkeiten für lokale LLMs. Messen Sie mit ollama run --verbose auf Ihrer eigenen Hardware. Bei Autovervollständigung entfällt lokal der Netzwerk-Roundtrip.
⚠️Warnung: Das Standard-Kontextfenster von Ollama (abhängig vom verfügbaren VRAM) erhöht den scheinbaren Durchsatz, weil weniger Token verarbeitet werden, kürzt aber den Kontext. Setzen Sie num_ctx 32768 für aussagekräftige Latenzmessungen beim Coding.
Hardware-Anforderungen
- Qwen3.6 27B Q4_K_M (Ollama `qwen3.6:27b`, Download 18–19 GB): eine 24-GB-GPU (RTX 3090, RTX 4090) oder Apple Silicon mit 36–48 GB oder mehr Unified Memory. Eine 16-GB-Karte fasst die Gewichte nicht.
- Devstral Small 2 24B (Ollama `devstral-small-2`, Download 15 GB): RTX 4070 Ti Super (16 GB, mit Kontext knapp), RTX 3090 oder RTX 4090 (24 GB) oder Apple Silicon mit 32 GB oder mehr Unified Memory.
- Codestral 22B Q4_K_M (Download 13 GB): RTX 4070 Ti (12 GB grenzwertig, 16 GB empfohlen).
- Zwei Modelle gleichzeitig: Qwen3.6 27B (18–19 GB) plus Devstral Small 2 (15 GB) sind vor dem Kontext etwa 34 GB; nötig sind zwei 24-GB-GPUs oder Apple Silicon mit 64 GB oder mehr Unified Memory, etwa ein Mac Studio mit M5 Max (bis 128 GB).
- Apple Silicon: Apple hat die Mac-mini- und Mac-Studio-Reihe am 25. August 2026 erneuert (verfügbar ab 22. September 2026) und ersetzt damit die M4-Pro-/M4-Max-Konfigurationen. Laut Apple startet der Mac mini mit M5 Pro bei 1.699 $ (bis 64 GB Unified Memory, 307 GB/s), das Mac Studio mit M5 Max bei 2.499 $ (bis 128 GB) und das Mac Studio mit M5 Ultra bei 5.499 $ (bis 512 GB; die 512-GB-Konfiguration folgt Ende Oktober). Eine Konfiguration mit 36–48 GB nimmt Qwen3.6 27B auf; ab 64 GB passen Qwen3.6 27B und Devstral Small 2 zusammen. Apple veröffentlicht keine Token-pro-Sekunde-Werte für lokale LLMs, und PromptQuorum hat diese Chips nicht gemessen; messen Sie mit ollama run --verbose. Preise in US-Dollar, lokale Preise können abweichen.
- Günstige Apple-Silicon-Option: Der Einstiegs-Mac-mini mit M6 startet bei 899 $ (bis 32 GB Unified Memory, laut Apple bis 170 GB/s) und fasst Devstral Small 2 (15 GB) und Codestral 22B (13 GB) bequem. Qwen3.6 27B (18–19 GB) passt nur in die 32-GB-Konfiguration und lässt wenig Platz für Kontext. Die Speicherbandbreite liegt unter der des M5 Pro (170 gegenüber 307 GB/s), die Generierung ist also langsamer; PromptQuorum hat den M6 nicht gemessen.
# Ollama config for Qwen3.6 27B with num_ctx and GPU layers
cat > Modelfile-qwen36 <<'EOF'
FROM qwen3.6:27b
PARAMETER num_ctx 32768
PARAMETER num_gpu 1
PARAMETER num_thread 8
PARAMETER temperature 0.2
SYSTEM "You are an expert software engineer. Respond with clean, well-structured code."
EOF

ollama create qwen36-local -f Modelfile-qwen36
ollama run qwen36-local
Multi-Modell-Dispatch-Strategie
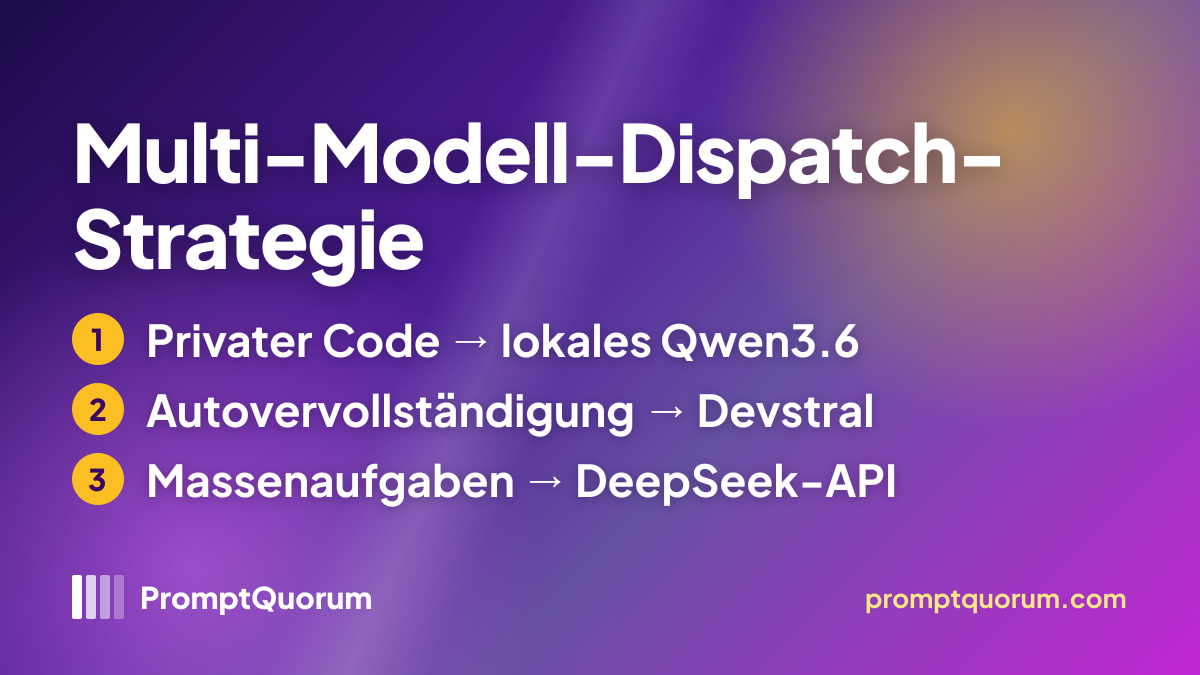
Kein Coding-Modell gewinnt jede Aufgabe. Qwen3.6 27B hat hier den stärksten lokalen SWE-bench-Wert. Devstral Small 2 ist ein leichteres Agenten-Modell. Eine DeepSeek-API ist bei nicht sensiblem Code im großen Maßstab pro Token am günstigsten. Eine Dispatch-Schicht, die Aufgaben nach Typ verteilt, nutzt die Vorteile aller drei.
Eine empfohlene Dispatch-Matrix für ein Entwicklungsteam:
Aufgabentyp | Empfohlenes Modell | Warum |
|---|---|---|
| Privater Code (Kundendaten) | Qwen3.6 27B (lokal) | Der Code bleibt auf Ihrer Hardware |
| Autovervollständigung (interaktiv) | Devstral Small 2 (lokal) | Leichteres Modell, kein Netzwerk-Roundtrip |
| Code-Review (nicht sensibel) | DeepSeek-API | 0,15 $/1M Input außerhalb der Spitzenzeiten, hoher Durchsatz |
| Komplexes Refactoring (mehrere Dateien) | Qwen3.6 27B (lokal) + PromptQuorum-Konsens | Stärkster lokaler SWE-bench-Wert, Code bleibt lokal |
| Batch-Testgenerierung | DeepSeek-API | Kostenoptimiert für nicht sensibles Volumen |
PromptQuorum-Integration
PromptQuorum verteilt Coding-Aufgaben anhand von Ihnen definierter Klassifizierungsregeln auf lokales Qwen, lokales Devstral und Cloud-APIs. Das ersetzt manuelles Modellwechseln und setzt die Dispatch-Matrix oben automatisch um.
📍 In einem Satz
PromptQuorum leitet Coding-Aufgaben für sensiblen Code an lokales Qwen3.6 und für nicht sensible Massengenerierung an eine DeepSeek-API.
# PromptQuorum routing config for coding workloads
# Set in your PromptQuorum settings or .env file

# Local models (via Ollama)
LOCAL_OLLAMA_URL=http://localhost:11434/v1
LOCAL_CODING_MODEL=qwen36-local   # Qwen3.6 27B with num_ctx 32768
LOCAL_AUTOCOMPLETE_MODEL=devstral-small-2     # Devstral Small 2 24B

# Cloud fallback
DEEPSEEK_API_KEY=your_key_here
DEEPSEEK_MODEL=deepseek-flash

# Routing rules (PromptQuorum dispatch)
# route: task_contains("private") OR task_contains("customer") → qwen36-local (local)
# route: task_type == "autocomplete" → devstral-small-2 (local)
# route: token_count > 50000 → deepseek-flash (cloud, non-sensitive only)
# default → qwen36-local (local)Häufig gestellte Fragen
Ist Qwen3.6 27B besser als DeepSeek für lokales Coding?
Qwen3.6 27B gibt 77,2 % auf SWE-bench Verified an und läuft vollständig auf Ihrer eigenen Hardware mit 18–19 GB Download; planen Sie eine 24-GB-GPU ein. DeepSeek V4 Flash gibt 78,6 % (High-Modus) an, ist aber ein Modell mit 284B Parametern und wird meist über die Cloud-API für 0,15 $ pro 1 Mio. Input-Token (außerhalb der Spitzenzeiten) genutzt. Die bessere Wahl hängt von Datensensibilität und Budget ab, nicht von einem einzelnen Gewinner. Beide Werte sind Herstellerangaben mit unterschiedlichen Testaufbauten.
Was ist Devstral Small 2 und warum wird es hier erwähnt?
Devstral Small 2 ist ein 24B-Modell von Mistral AI. Die Devstral-Reihe zielt auf agentische Softwareentwicklung wie Multi-Datei-Änderungen und Tool-Einsatz. Der Ollama-Eintrag zeigt 15 GB Download, 384K Kontextfenster, Apache-2.0-Lizenz und 65,8 % auf SWE-bench Verified. Es ist hier die leichtere lokale Option; Qwen3.6 27B gibt den höheren SWE-bench-Wert an.
Kann ich Qwen3.6 27B und Devstral Small 2 gleichzeitig ausführen?
Nicht auf einer einzelnen 24-GB-GPU. Qwen3.6 27B hat 18–19 GB Download, Devstral Small 2 15 GB, zusammen etwa 34 GB vor dem Kontext. Nötig wären zwei 24-GB-GPUs oder Apple Silicon mit 64 GB oder mehr Unified Memory. Auf einer GPU führen Sie jeweils ein Modell aus und wechseln über Ollama.
Ist eine DeepSeek-API sicher für EU-Unternehmenscode?
Die DeepSeek-API verarbeitet Daten auf Servern von DeepSeek, einem in China eingetragenen Unternehmen, und die EU-Kommission hat für China keinen Angemessenheitsbeschluss erlassen. Werden personenbezogene EU-Daten oder Quellcode mit personenbezogenen Informationen dorthin gesendet, ist eine rechtliche Prüfung nach DSGVO Kapitel V (Art. 44 ff.) nötig. Für proprietären Code ohne personenbezogene Daten konsultieren Sie Ihr Rechtsteam. Ein lokales Modell wie Qwen3.6 27B hält den Code auf Ihrer eigenen Hardware und vermeidet so eine Übermittlung an Dritte; es macht ein Projekt aber nicht automatisch DSGVO-konform. Dies ist eine allgemeine Information, keine Rechtsberatung.
Was ist SWE-bench Verified und warum liegt der Fokus darauf?
SWE-bench Verified testet anhand einer von Menschen geprüften Aufgabenauswahl, ob ein Modell echte GitHub-Issues in Open-Source-Python-Projekten wie Django, Flask und scikit-learn lösen kann. Es misst praktische Softwareentwicklung stärker als isolierte Funktionstests wie HumanEval. Die Werte hängen stark vom Agenten-Aufbau ab; vergleichen Sie Herstellerzahlen daher mit Vorsicht.