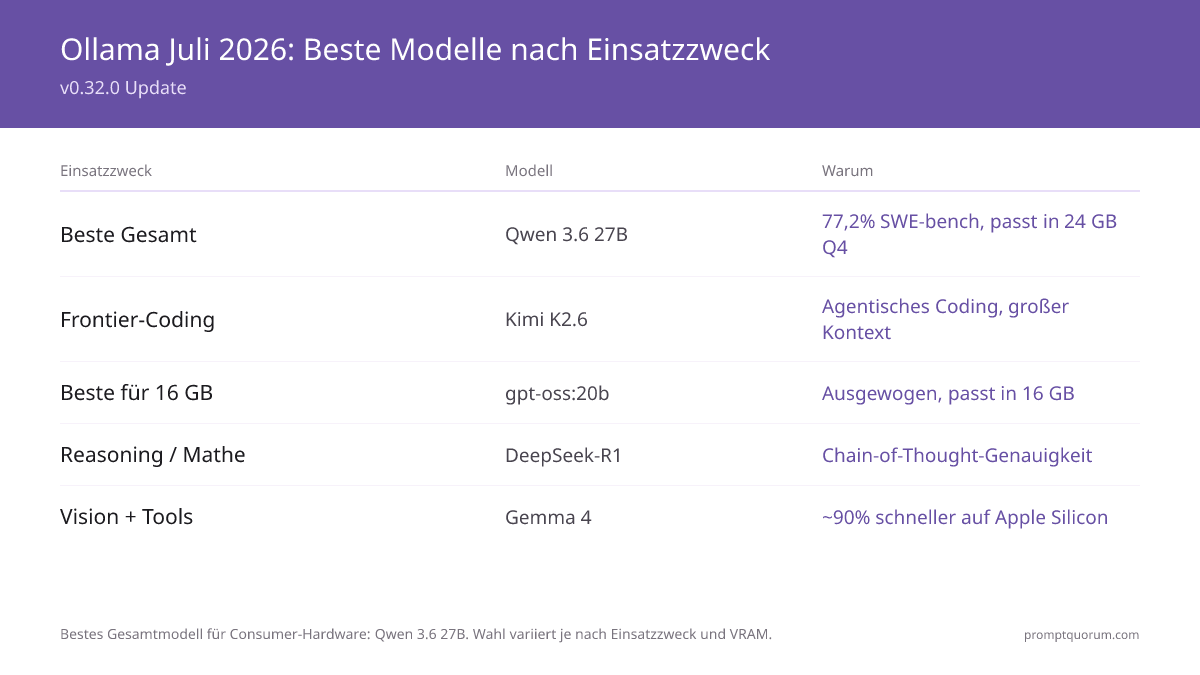
Was ist die aktuelle Ollama-Version und was hat sich geändert?
Aktuelle Ollama-Version: v0.40.5 (veröffentlicht am 14. Oktober 2026). Das ist die neueste stabile Version, erhältlich über ollama.com/download. Am 16. Oktober erschien eine Vorabversion v0.40.6, die noch nicht als stabil markiert ist. Aktualisieren Sie mit `curl https://ollama.ai/install.sh | sh` (macOS: `brew upgrade ollama`) und bestätigen Sie mit `ollama --version`.
Was sich in der v0.33–v0.40-Reihe geändert hat (August–Oktober 2026): v0.33.0 (21. August) aktivierte Claude Desktop als Drittanbieter-Gateway und machte die Wiederherstellungspunkte des KV-Cache-Prefills zuverlässiger. v0.34.0 (5. September) erlaubte die Nutzung von Ollama-Modellen in ChatGPT Desktop und beschleunigte strukturierte Ausgaben auf Apple Silicon; v0.34.1 (14. September) stufte `ollama create` mit MLX-Safetensors nicht mehr als experimentell ein. v0.40.0 (25. September) führt unterstützte Architekturen wie qwen3.8, gemma4 und qwen3.6 auf Apple Silicon standardmäßig mit MLX aus. v0.35.0 (28. September) brachte Entscheidungsmodelle über `/v1/systemone` — Modelle, die statt Text Auswahlen, Wahrscheinlichkeiten und Scores liefern, zunächst Nimble und Tev1 — und v0.35.1 (29. September) die multimodalen Clef-Modelle. v0.40.2 (8. Oktober) behält beim Hintergrund-Upgrade älterer Modelle Sicherungen, v0.40.4 (12. Oktober) ergänzte `ollama run <Entscheidungsmodell> --ask`, und v0.40.5 (14. Oktober) fügte Unterstützung für NVIDIA Nemotron 3.5 Super sowie Cloud-Zugriff auf die Clef-Entscheidungsmodelle hinzu. Vollständige Notizen: github.com/ollama/ollama/releases.
Neueste Modelle in der Bibliothek (2026):
- Laguna XS 2.1 (Poolside, 2. Juli 2026) — 33B gesamt / 3B aktiv MoE für agentisches Coding und langfristige lokale Arbeit: planen, Code schreiben, Tests ausführen, iterieren. 256K Kontext, OpenMDW-1.1-Lizenz. SWE-bench Verified 70,9%, SWE-bench Multilingual 63,1%. Pull: `ollama pull laguna-xs-2.1`
- Kimi K2.7 Code (Moonshot AI, Juni 2026) — Coding-fokussiertes agentisches Modell, aufbauend auf Kimi K2.6, speziell für langfristige Coding-Sitzungen. Pull: `ollama pull kimi-k2.7-code:cloud` (cloud tag; local GGUF builds need 300+ GB)
- DeepSeek V4 Pro (DeepSeek, 23. April 2026) — Spezialist für algorithmisches Coding, 93.5% LiveCodeBench, MIT-Lizenz. Budget-Variante DeepSeek V4 Flash für leichtere Hardware. Pull: `ollama pull deepseek-v4-pro`
- Kimi K2.6 (Moonshot AI, 20. April 2026) — Frontier-Coding-Modell, SWE-Bench Pro 58.6, SWE-bench Verified 80.2%. MoE-Architektur (32B aktiv / 1T gesamt). Modified MIT-Lizenz.
- Qwen3.8-27B (Alibaba, 16. April 2026) — Bestes Modell fuer Consumer-Hardware, 61,7 SWE-bench Pro, Apache 2.0, passt in 24 GB bei Q4. Auch Qwen3.6-35B-A3B (MoE, 73,4 SWE-bench).
- GLM-5.3 (Z.ai) — 744B / 40B aktiv MoE, MIT-Lizenz. Führender Structured Code Generator.
- gpt-oss (OpenAI, 2026) — Open-Weight MoE: gpt-oss:20b (21B gesamt / 3,6B aktiv, läuft in 16 GB, ~o3-mini-Niveau, einstellbares Reasoning) und gpt-oss:120b (80 GB).
- Gemma 4 (Google, 2. April 2026) — Multimodale Größen E2B / E4B / E12B (26B MoE) / E27B (31B dicht), alle mit Vision und Tool Calling. Jetzt ~90% schneller auf Apple Silicon (MLX-Update Juli 2026). E4B läuft in ~6 GB VRAM.
# Ollama auf die neueste Version aktualisieren (v0.40.5)
curl https://ollama.ai/install.sh | sh

# Oder auf Mac: brew upgrade ollama

# Aktuelle Version prüfen
ollama --version  # Ausgabe: ollama version 0.40.5

# Die neuesten 2026-Modelle pullen
ollama pull laguna-xs-2.1
ollama pull kimi-k2.7-code:cloud
ollama pull nemotron-3.5-lightning
ollama pull kimi-k2.6:cloud
Wie sieht die Versionshistorie von Ollama aus?
Ollama veröffentlichte seine erste Version v0.0.1 am 8. Juli 2023 und erreichte v0.40.5 am 14. Oktober 2026. Die Tabelle nennt die Versionen, die verändert haben, was sich mit Ollama tun lässt; alle Tags samt Release Notes stehen unter github.com/ollama/ollama/releases. Die Nummerierung sprang Ende September 2026 von v0.35 auf v0.40, deshalb steht v0.40.0 (25. September) auf GitHub neben den v0.35-Versionen (28.–29. September).
Version | Datum | Kernänderung |
|---|---|---|
| v0.40.5 | 14.10.2026 | Nemotron 3.5 Super; Cloud-Entscheidungsmodelle |
| v0.40.0 | 25.09.2026 | MLX standardmäßig auf Apple Silicon |
| v0.35.0 | 28.09.2026 | Entscheidungsmodelle über /v1/systemone |
| v0.34.0 | 05.09.2026 | Ollama-Modelle in ChatGPT Desktop |
| v0.33.0 | 21.08.2026 | Claude-Desktop-Gateway; KV-Cache |
| v0.32.0 | 11.07.2026 | Agent-Erlebnis „Chat, Code & Work“ |
| v0.0.1 | 08.07.2023 | Erste öffentliche Version |
Die beliebtesten Modelle auf Ollama
Ollama verfügt über eine vollständig öffentlich zugängliche Download-Statistik. Nach Daten aus Juli 2026:
Llama 3.2 3B ist immer noch das am häufigsten heruntergeladene Modell insgesamt, großteils aufgrund seiner Verwendung als Standard-Testmodell beim ersten Install. Llama 4 Scout ist jedoch seit März 2026 schnell in den Rankings aufgestiegen und ist jetzt die bevorzugte Wahl für Qualität.
Qwen3 und Qwen3.8 sind die am schnellsten wachsende Modellfamilie in der Ollama-Bibliothek, mit Qwen3 und dem neuen Qwen3.8 dicht Variante schnell Qwen3 verdrängt. DeepSeek-R1 sah große Spitzen nach der Veröffentlichung und bleibt für Reasoning-Aufgaben stark heruntergeladen. Dolphin 3.0 (Cognitive Computations, aufbauend auf Llama 3.1) bleibt das meistgepullte unzensierte Allzweck-Modell für Nutzer, die einen ungefilterten lokalen Assistenten wollen.
Llama 4 Scout wurde von Meta im April 2026 mit Scout (17B aktiv, 109B gesamt, MoE) und Maverick (17B aktiv, 400B gesamt) Varianten veröffentlicht. Llama 4 Scout ist jetzt stabil in der Ollama-Bibliothek (`ollama pull llama4:scout`). Die Llama 4 Familie nutzt Mixture-of-Experts (MoE) Architektur – nur 17B Parameter sind pro Token aktiv, aber mit 109B Gesamtparametern benötigt Scout ~55 GB VRAM bei Q4 (passt in 24 GB nur bei 1,78-Bit, ~20 tok/s). Scouts Stärken sind das 10M-Token-Kontextfenster und multimodale Eingabe, nicht die Consumer-Hardware-Tauglichkeit. Für leichte Setups (8 GB RAM) bleibt Llama 3.2 3B das einfachste Einstiegsmodell. Kimi K2.6 (Moonshot AI, Modified MIT-Lizenz, 32B aktiv / 1T gesamt MoE) erreichte SWE-Bench Pro 58.6 und liegt damit gleichauf mit GPT-5.5. Laguna XS 2.1 (Poolside) ist der neueste Herausforderer im agentischen Coding, speziell für langfristige lokale Coding-Sitzungen gebaut. Qwen3.8-27B erzielte 61,7 SWE-bench Pro als das beste Modell fuer Consumer-Hardware (passt in 24 GB bei Q4). OpenAIs Open-Weight gpt-oss:20b (21B gesamt / 3,6B aktiv MoE) läuft in 16 GB auf ~o3-mini-Niveau mit einstellbarem Reasoning. Die aktuelle Ollama-Version v0.40.5 (14. Oktober 2026) ergänzt Unterstützung für NVIDIA Nemotron 3.5 Super.Die Ollama-Bibliothek umfasst mehrere hundert Modelle, wobei Laguna XS 2.1 und Kimi K2.7 Code die neuesten Ergänzungen sind.
Versionshinweis: Qwen3.6 und Qwen3.8 sind neuere Qwen-Generationen auf Ollama (qwen3.6:35b, ca. 24 GB; qwen3.8:27b, 18 GB); qwen3:30b und qwen3-coder:30b (je 19 GB) sind Optionen der Vorgängergeneration, die weiterhin funktionieren. Mistrals aktuelles Small-Modell ist Mistral Small 4, die Ollama-Bibliothek führte es bei der Prüfung jedoch nicht; mistral-small3.1 und mistral-small:24b (Mistral Small 3) bleiben dort die ladbaren Small-Modelle.
Top-Modelle nach Kategorie
Die Qualität der Modellausgabe hängt stark davon ab, wie Sie prompten. Für strukturierte Techniken, die mit allen lokalen Modellen funktionieren — darunter Chain-of-Thought, Few-Shot-Beispiele und Output-Formatierung — siehe den Prompt-Engineering-Guide. Für Reasoning-Aufgaben verbessert Chain-of-Thought-Prompting erheblich DeepSeek-R1 und Qwen3 Output-Qualität. Für Quantisierungskompromisse dieser Modelle siehe den Quantisierungsleitfaden →. Um zu ermitteln, wie viel VRAM jedes Modell benötigt, siehe den VRAM-Anforderungsleitfaden →. Für Agent-Workflows mit Gemma 4 siehe Tree-of-Thought und ReAct. Sobald ein Tool-Calling-Modell aus dieser Liste in einer mehrstufigen Schleife mit Datei- und Datenbankzugriff läuft, siehe Lokale KI-Agenten mit MCP für das Open-Source-Orchestrierungsmuster.
- Allgemeines Chat (Anfänger): `ollama run llama3.2:3b` -- die meiste Dokumentation, am besten unterstütztes Einstiegsmodell.
- Allgemeines Chat (beste Wahl): `ollama run qwen3.8:27b` -- 61,7 SWE-bench Pro, bestes Modell fuer Consumer-Hardware, passt in 24 GB bei Q4. Ausgewogen: `ollama run qwen3:30b`. Für 8 GB Maschinen `ollama run llama3.2:3b` verwenden.
- Long-Context / multimodal: `ollama run llama4:scout` -- 10M-Token-Kontext + multimodal, MoE (17B aktiv/109B gesamt). Benötigt ~55 GB VRAM bei Q4 (passt in 24 GB nur bei 1,78-Bit, ~20 tok/s).
- Bestes kleines / 16 GB: `ollama run gpt-oss:20b` -- 21B gesamt / 3,6B aktiv MoE, ~o3-mini-Niveau, einstellbares Reasoning. Größer: `ollama run gpt-oss:120b` (80 GB).
- Codierung (7B): `ollama run qwen3:8b` -- mehrsprachig, solide Coding-Option für 8-GB-Rechner.
- Codierung (bestes Agentic, 24B): `ollama run devstral-small-2` -- Bestes Agentic Coding-Modell (Multi-Datei-Edits, Debugging). 16 GB RAM. Von Mistral AI.
- Codierung (bestes Dicht, 27B): `ollama run qwen3.8:27b` -- 61,7 SWE-bench Pro. Bestes dichtes Coding-Modell. 18 GB VRAM.
- Codierung (Frontier MoE): `ollama run kimi-k2.6:cloud` -- SWE-Bench Pro 58.6 (gleichauf mit GPT-5.5), Top-Tier. MoE (32B aktiv/1T gesamt). Modified MIT-Lizenz. Benötigt Quantisierung für Consumer-Hardware.
- Codierung (agentisch, langfristig): `ollama run laguna-xs-2.1` -- Poolsides 33B/3B-aktiv MoE, SWE-bench Verified 70,9%, 256K Kontext. Gebaut für mehrstufige Plan → Code → Test → Iterations-Schleifen. OpenMDW-1.1-Lizenz.
- Agent-Aufgaben und Tool-Calling: `ollama run gemma4:e4b` -- Veröffentlicht 2. April 2026. Built-in Tool-Calling + Vision-Unterstützung. Empfohlen für lokale Agenten, Function-Calling und strukturierte Ausgabe. 6 GB RAM.
- Reasoning und Mathematik: `ollama run deepseek-r1:7b` -- Chain-of-Thought-Modell, beste lokale Mathe-Leistung bei 7B.
- Mehrsprachig: `ollama run qwen3:8b` -- 29+ native Sprachen, mehrsprachige Allzweck-Option.
- Russischsprachige Aufgaben: `ollama run qwen3:8b` oder `ollama run mistral-small3.1` -- beide enthalten Russisch im nativen mehrsprachigen Training. Diese Seite reiht die beiden für Russisch nicht; testen Sie beide mit Ihren eigenen Prompts. Keines der beiden Modelle hat russischen Ursprung.
- Unzensiert / Allzweck: `ollama run dolphin3` -- Dolphin 3.0 (Cognitive Computations, aufbauend auf Llama 3.1), keine eingebaute Inhaltsfilterung, für allgemeinen Chat, Codierung und agentische Aufgaben.
- Bildverarbeitung: `ollama run gemma4:e4b` -- Vision + Tool Calling, jetzt ~90% schneller auf Apple Silicon. Oder `ollama run llama3.2-vision:11b` für dedizierte Vision.
- Schnell und leichtgewichtig: `ollama run gemma2:2b` -- schnellste CPU-Inferenz, 1,7 GB RAM.
- Hohe Qualität (16 GB RAM): `ollama run mistral-small3.1` -- gute Qualität bei 14 GB RAM.
- Heimautomatisierung / Wake-Word-KI: `ollama run phi4-mini` — Phi-4 Mini (3.8B, ~3 GB VRAM) kann Home-Assistant-Sprachbefehle auf einem Mini-PC ohne dedizierte GPU verarbeiten; die Geschwindigkeit hängt von Ihrer Hardware ab. Siehe Home Assistant + Ollama Integrationsguide →.

Welche Modelle wurden zuletzt zu Ollama hinzugefügt?
Dies sind die neuesten Modelle der Ollama-Bibliothek, das neueste zuerst. Prüfe die Verfügbarkeit mit `ollama pull <modell>`, bevor du Workflows darauf aufbaust — neue Modelle erscheinen innerhalb weniger Tage nach Veröffentlichung auf ollama.com/library.
Modell | Veröffentlicht | Ideal für | Ollama-Befehl |
|---|---|---|---|
| nemotron-3.5-super | 14. Oktober 2026 | NVIDIA — 120B Vision-Language, Coding, Reasoning, Tool-Nutzung, bis 1M Kontext | ollama run nemotron-3.5-super |
| nemotron-3.5-bolt | 14. Oktober 2026 | NVIDIA — MoE 74B gesamt / 9B aktiv, lokales Coding und Tools, 25 GB | ollama run nemotron-3.5-bolt |
| nemotron-3.5-lightning | 2026 | NVIDIA — 30B-MoE, 3B aktiv, dauerhaft laufende Agenten, 1M Kontext | ollama run nemotron-3.5-lightning |
| glm-5.3 | 2026 | Z.ai — Flaggschiff mit offenen Gewichten für Coding und langfristige Agenten | ollama run glm-5.3 |
| granite4.2 | 2026 | IBM — Apache 2.0, 3B / 8B / 30B, 128K Kontext | ollama run granite4.2 |
| qwen3.8:27b | August 2026 | Bestes Gesamtmodell auf Consumer-Hardware, 61,7 SWE-bench Pro (laut Qwen), 18 GB | ollama run qwen3.8:27b |
| laguna-xs-2.1 | 2. Juli 2026 | Poolside — agentisches Coding, MoE 33B/3B aktiv, 20 GB, 256K Kontext | ollama run laguna-xs-2.1 |
| kimi-k2.7-code | 2026 | Moonshot AI — Coding-fokussiert, bei Ollama nur Cloud-Tag | ollama run kimi-k2.7-code:cloud |
| kimi-k2.6 | 20. April 2026 | Frontier-Coding (SWE-Bench Pro 58,6), bei Ollama nur Cloud-Tag | ollama run kimi-k2.6:cloud |
| gpt-oss:20b | 2026 | Bestes kleines Modell / 16 GB, ~o3-mini, einstellbares Reasoning | ollama run gpt-oss:20b |
| gemma4:e4b | 2. April 2026 | Vision + Tool-Aufrufe (E2B/E4B/12B/26B/31B) | ollama run gemma4:e4b |
| qwen3:30b | 2026 | Ausgewogen; qwen3-coder:30b für Code-Vervollständigung | ollama run qwen3:30b |
DeepSeek-R1: Reasoning-Durchbruch
DeepSeek-R1 wurde im Januar 2025 veröffentlicht und verkörpert einen signifikanten Fortschritt im Reasoning auf lokalen Größen. Das Modell führt explizite Chain-of-Thought (CoT) Reasoning durch: Sie sehen die internen Gedankenketten des Modells, bevor die endgültige Antwort gegeben wird. Versionshinweis: DeepSeek-R1 ist ein Modell der Vorgängergeneration. DeepSeeks aktuelle Open-Weight-Familie ist DeepSeek-V4, die die Ollama-Bibliothek bei der Prüfung nicht führte; die deepseek-r1-Distillate (1,5B bis 70B) bleiben dort die ladbare Reasoning-Option. Das gehostete R1-API-Modell hat DeepSeek durch DeepSeek-V4 ersetzt.
- Größen verfügbar: Destillate von 1,5B bis 70B.
- Leistung: verbesserte Logik und mehrschrittige Problemlösung.
- RAM-Anforderungen: 1,5B: 2 GB, 7B: 6 GB, 70B: 44 GB (Q4-Quantisierung).
- Lizenz: Die DeepSeek-R1-Modelle stehen unter der MIT-Lizenz; die Destillate erben zusätzlich die Bedingungen ihrer Qwen- oder Llama-Basismodelle. Prüfen Sie die jeweilige Modellkarte vor dem Einsatz.
- Datenhandhabung: Läuft das Modell lokal auf eigenen Servern oder Geräten, verlassen Prompts und Antworten Ihr System nicht. Ob Ihre Verarbeitung die DSGVO erfüllt, hängt von Ihrer Gesamtkonfiguration ab (keine Rechtsberatung).
ollama run deepseek-r1:7b
# Beispielprompt: "Wenn zwei Züge sich einer Station mit 100 km/h nähern, wann treffen sie sich?"
# DeepSeek-R1:7b antwortet mit sichtbaren Gedankenketten:
# <Gedanken>
# ...Pfade erkunden, Annahmen überprüfen...
# </Gedanken>
# Antwort: Sie treffen sich ...
Vision-Modelle auf Ollama
Juli 2026: Diese Modelle auf Ollama unterstützen Bildeingabe (multimodal). Gemma 4 unterstützt sowohl Vision ALS AUCH Tool Calling – einzigartig unter Vision-Modellen auf Ollama – und läuft nach dem Juli-MLX-Update jetzt fast 90% schneller auf Apple Silicon.
Modell | RAM | Bildunterstützung | Ollama Befehl |
|---|---|---|---|
| llama3.2-vision:11b | ~8 GB | Ja | ollama run llama3.2-vision:11b |
| llama3.2-vision:90b | ~55 GB | Ja | ollama run llama3.2-vision:90b |
| gemma3:9b (vision) | ~6 GB | Ja | ollama run gemma3:9b |
| minicpm-v:8b | ~5,5 GB | Ja | ollama run minicpm-v |
| gemma4:e4b | ~6 GB | Ja ✓ | ollama run gemma4:e4b |

Vollständiger Top-10-Vergleich
Download-Zählungen bevorzugen immer noch Llama 3.x aufgrund der Häufigkeit von Tutorials. Für neue Projekte im Juli 2026 sind Qwen3.8-27B (bestes Modell fuer Consumer-Hardware), Kimi K2.6 oder Laguna XS 2.1 (Codierung), gpt-oss:20b und qwen3:30b zu bevorzugen.
# | Modell | Beste für | RAM | HumanEval |
|---|---|---|---|---|
| 1 | Qwen3.8-27B | Bestes Modell fuer Consumer-Hardware | 24 GB (Q4) | 61,7 SWE-bench Pro |
| 2 | Kimi K2.6 | Frontier-Coding, MoE (32B/1T), Modified MIT | Quantisiert | 58,6 SWE-Bench Pro |
| 3 | gpt-oss:20b | Bestes kleines / 16 GB, einstellbares Reasoning | 16 GB | ~o3-mini |
| 4 | qwen3:30b | Ausgewogen; qwen3-coder:30b für Code | ~18 GB | stark |
| 5 | Laguna XS 2.1 | Agentische Codierung, langfristig (planen/coden/testen/iterieren) | Quantisiert | 70,9% SWE-bench Verified |
| 6 | Devstral Small 2 24B | Agentic Codierung (Multi-Datei) | 15 GB | 68.0% (SWE-bench Verified) |
| 7 | deepseek-r1:7b | Reasoning, Mathe | 5 GB | — |
| 8 | gemma4:e4b | Vision + Tool Calling (multimodal) | ~6 GB | — |
| 9 | Llama 4 Scout | Long-Context 10M + multimodal, MoE | ~55 GB (Q4) | — |
| 10 | Llama 3.2 3B | Einstiegsmodell, allgemeiner Chat | 2,5 GB | — |

Wie durchsuchen Sie die Ollama-Bibliothek?
Es gibt zwei Möglichkeiten, mit Ollama-Modellen zu arbeiten. Installierte Modelle wechseln: In der Ollama Mac-App klicken Sie auf den Modell-Dropdown-Button am unteren Rand des Chat-Eingabefeldes (zeigt den aktuellen Modellnamen, z. B. "llama4:scout"), um zwischen lokal installierten Modellen zu wechseln. Neue Modelle finden und herunterladen: Besuchen Sie ollama.com/library, um mehrere hundert Modelle nach Kategorie zu durchsuchen, und nutzen Sie dann die CLI-Befehle unten zum Herunterladen.
- Öffnen Sie ollama.com/library in einem Webbrowser für die vollständige durchsuchbare Bibliothek mit mehreren hundert Modellen.
- Neue Modelle erscheinen in der Regel innerhalb weniger Tage nach ihrer Veröffentlichung in der Bibliothek.
ollama list
# Zeigt alle installierten Modelle an

ollama pull llama4:scout
# Lädt Llama 4 Scout herunter (beste Qualität, MoE)

ollama pull qwen3.8:27b
# Lädt Qwen3.8-27B herunter (Best Coding Model, 61,7 SWE-bench Pro)

ollama run llama4:scout
# Startet eine interaktive Chat-Sitzung

ollama run -m deepseek-r1:7b "Lösen Sie 2^10"
# Löst Reasoning-Aufgaben mit CoT aus
Wie beeinflussen regionale Datenschutzregeln deine Ollama-Modellwahl?
EU / DSGVO + Lizenz-Compliance. Für EU-Organisationen, die Ollama-Modelle produktiv einsetzen, zählt die Lizenz so viel wie die Leistung. Apache 2.0 (vollständig offen, kommerzielle Nutzung erlaubt): Mistral Small 3, Mistral Small 3.1, Qwen3 8B, Qwen3.8-27B, Devstral Small 2, Granite 4.2. Meta Llama Community Licence (kommerzielle Nutzung ab 700 Mio. monatlich aktiven Nutzern eingeschränkt): Llama 3.1 8B, Llama 3.2 3B, Llama 3.2 Vision 11B. Llama 3.2 Vision ist eine Ausnahme: Seine Acceptable Use Policy gewährt die Lizenzrechte nicht an Personen oder Unternehmen mit Sitz in der EU (Endnutzer von darauf aufbauenden Produkten sind nicht betroffen); prüfen Sie dies vor einem Einsatz in der EU. MIT (kommerzielle Nutzung erlaubt): DeepSeek-R1 7B und 14B. Modifizierte MIT (kommerzielle Nutzung mit Namensnennungsklausel erlaubt): Kimi K2.6. OpenMDW-1.1 (permissiv, kommerzielle Nutzung erlaubt): Laguna XS 2.1. Prüfe die Lizenzbedingungen vor dem kommerziellen Einsatz immer. Für EU-Unternehmen in regulierten Branchen sind Mistral-Modelle (Frankreich, Apache 2.0) wie Devstral Small 2 ein sinnvoller Standard -- EU-Herkunft und permissive Lizenz. Läuft ein Modell vollständig on-premises über Ollama, werden Prompts nicht an externe Server gesendet; das unterstützt die DSGVO-Pflichten, erfüllt sie aber nicht allein (ein `:cloud`-Tag sendet Daten an den gehosteten Dienst von Ollama).
Japan (METI). Für japanische Unternehmens-Deployments mit Ollama ist Qwen3 / Qwen3.8 eine empfehlenswerte Modellfamilie -- sie verarbeitet japanischen Text nativ, was Inferenzzeit und KV-Cache zugutekommt. Für japanische Coding-Workflows: Qwen3.8-27B (61,7 SWE-bench Pro laut Qwen) verarbeitet japanische Code-Kommentare nativ. Die exakte Modellversion zu dokumentieren, ist gute Praxis für Compliance-Unterlagen. Mit `ollama show <modell>` erhältst du die vollständige Spezifikation (Parameterzahl, Quantisierung, Kontextlänge) für Compliance-Aufzeichnungen.
China. Die CAC-Maßnahmen für generative KI (2023) in China können Anbietern generativer KI-Dienste für die Öffentlichkeit in China Melde- oder Sicherheitsbewertungspflichten auferlegen; ob sie im Einzelfall gelten, ist mit einer Rechtsberatung zu klären. Qwen3 / Qwen3.8 (Alibaba, Apache 2.0) ist eine naheliegende Wahl für chinesische Unternehmens-Deployments mit Ollama -- chinesische Herkunft, Apache-2.0-Lizenz, starke Leistung auf Chinesisch. Kimi K2.6 (Moonshot AI, modifizierte MIT) stammt ebenfalls aus China, wird bei Ollama aber nur als Cloud-Tag geführt, und lokale Läufe brauchen Server-Hardware. Befehle: `ollama run qwen3.8:27b` für beste Qualität, `ollama run qwen3:8b` für Geschwindigkeit. DeepSeek-R1 (MIT-Lizenz) eignet sich für Reasoning. Inferenz, die lokal über Ollama läuft, sendet für sich genommen keine Daten ins Ausland und klammert damit die Frage der grenzüberschreitenden Übermittlung für diesen Schritt aus; ob die PIPL oder andere Pflichten für die jeweilige Datenverarbeitung gelten, ist mit einer Rechtsberatung zu klären. Dieser Abschnitt ist eine allgemeine Information, keine Rechtsberatung.
Häufige Fehler bei der Auswahl von Ollama-Modellen
Ich habe einen großen Modell-Tag gepullt, aber mein RAM ist voll. Was ist passiert?
Zu schnell gepullt, ohne den RAM zu überprüfen. Verwenden Sie `ollama show [model-name]` BEVOR Sie pullen. Beispiel: `ollama show llama3.1:70b` zeigt RAM-Anforderungen an (~42-48 GB mit Q4-Quantisierung). Für Anfänger: Bleiben Sie bei 7B-13B-Modellen (unter 16 GB RAM). Löschen Sie mit `ollama rm [model-name]`.
Ich verwende ein Allzweck-Modell wie Llama 3.3, aber die Codierung ist langsam. Warum?
Llama 3.1 8B ist Allzweck-freundlich, aber Qwen3 oder Mistral Small sind für technische Aufgaben spezialisiert. Für Codierung: Probieren Sie Qwen3 8B statt Llama 3.1 8B und vergleichen Sie die Ergebnisse an Ihren eigenen Aufgaben. Beide laufen unter 8 GB RAM.
Ich habe ein Modell gepullt, sehe es aber nicht in der Liste. Wie überprüfe ich die Installation?
Führen Sie `ollama list` aus. Ollama speichert Modelle unter `~/.ollama/models/` (Mac) oder `%USERPROFILE%.ollamamodels` (Windows). Wenn sich das Modell dort befindet, aber nicht in der Liste angezeigt wird, neustarten Sie den Ollama-Daemon: Beenden Sie Ollama und öffnen Sie es erneut.
Nächste Schritte
- Beste lokale LLMs für Coding — Das beste Ollama-Modell speziell für Code-Aufgaben →
- Beste LLMs ohne GPU (CPU-only) — Kein Grafikprozessor? Hier starten →
- Hardware-Guide für lokale LLMs — Unsicher, ob dein PC diese Modelle ausführen kann? →
Häufig gestellte Fragen
Was ist die neueste Ollama-Version?
Die neueste stabile Ollama-Version ist v0.40.5, veröffentlicht am 14. Oktober 2026. Am 16. Oktober folgte eine Vorabversion v0.40.6, die noch nicht als stabil markiert ist. Laden Sie sie von ollama.com/download herunter oder aktualisieren Sie mit `curl https://ollama.ai/install.sh | sh` unter Linux und `brew upgrade ollama` unter macOS.
Wo finde ich das Ollama-Changelog und die Release Notes?
Die Release Notes aller Versionen stehen unter github.com/ollama/ollama/releases, mit Datum und Changelog je Tag. Die neuesten stabilen Einträge sind v0.40.5 (14. Oktober 2026 -- Unterstützung für NVIDIA Nemotron 3.5 Super, Cloud-Zugriff auf Entscheidungsmodelle), v0.40.4 (12. Oktober -- Entscheidungsmodelle über `ollama run --ask`, schnelleres Laden) und v0.40.0 (25. September -- MLX standardmäßig auf Apple Silicon).
Wie prüfe ich, welche Ollama-Version installiert ist?
Führen Sie `ollama --version` im Terminal aus. Die Ausgabe lautet etwa `ollama version 0.40.5`. Liegt die Nummer unter der aktuellen Version, aktualisieren Sie mit `curl https://ollama.ai/install.sh | sh` (Linux) oder `brew upgrade ollama` (macOS) und prüfen Sie danach erneut mit `ollama --version`.
Wann wurde Ollama erstmals veröffentlicht?
Die erste Ollama-Version v0.0.1 wurde am 8. Juli 2023 auf GitHub veröffentlicht, kurz nach der Anlage des Repositorys am 26. Juni 2023. Im Oktober 2026 war das Projekt bei v0.40.5 angekommen. Die vollständige Liste steht unter github.com/ollama/ollama/releases.
Wie viel RAM brauche ich für ein lokales Modell?
7B-Modelle benötigen 6,5-8 GB RAM. 13B-Modelle: 11-14 GB. 70B-Modelle: 42-48 GB mit Quantisierung (Q4_K_M). Kleiner (3B): 2-3 GB. Überprüfen Sie mit `ollama show [model-name]` vor dem Herunterladen.
Kann ich Ollama-Modelle offline ausführen?
Ja. Nach dem initialen Download läuft jede Inferenz lokal, ohne Internetverbindung. Ollama überprüft gelegentlich Updates (aber nicht automatisch angewendet).
Wie lautet der offizielle Name des Unternehmens hinter Ollama?
Das Unternehmen hinter Ollama ist Ollama Inc. „Ollama“ bezeichnet sowohl das Unternehmen als auch das quelloffene CLI-Tool und die Modell-Laufzeitumgebung, die es veröffentlicht; die erste öffentliche Version des Projekts, v0.0.1, erschien am 8. Juli 2023 auf GitHub.
Welches Modell hat die beste deutsche Sprachunterstützung?
Mehrsprachige Modelle wie Qwen3 / Qwen3.8 und Mistral Small 3.1 unterstützen Deutsch; diese Seite reiht sie nicht nach deutscher Sprachqualität, testen Sie sie daher mit Ihren eigenen Texten.
Welche Ollama-Modelle eignen sich am besten für russischsprachige Aufgaben?
Qwen3 / Qwen3.8 und Mistral Small 3.1 enthalten beide Russisch im nativen mehrsprachigen Training. Diese Seite reiht die beiden für Russisch nicht; testen Sie beide mit Ihren eigenen Prompts. Keines der beiden Modelle hat russischen Ursprung.
Welches Dolphin-Modell sollte ich mit Ollama verwenden?
Verwenden Sie Dolphin 3.0 (`ollama pull dolphin3`), nicht das veraltete `dolphin-mistral` (zuletzt 2024 aktualisiert, basierend auf Mistral 0.2). Dolphin 3.0, gepflegt von Cognitive Computations, basiert auf Llama 3.1, hat keine eingebaute Inhaltsfilterung und ist als Allzweck-Modell für Coding, Mathematik, agentische Aufgaben und Chat ohne eingebaute Inhaltsbeschränkungen konzipiert. Da es ohne eingebaute Sicherheitsfilterung ausgeliefert wird, tragen Sie die Verantwortung für die Verwendung seiner Ausgaben; es gelten die Lizenzbedingungen von Llama 3.1.
Sind Ollama-Modelle wirklich kostenlos?
Das Herunterladen und lokale Ausführen verursacht keine Abonnement- oder API-Gebühren, aber nicht alle Modelle sind Open Source im Sinne der OSI: Llama 3.x/4.x nutzen die Meta Llama Community Licence (nicht OSI-zertifiziert, kommerzielle Nutzung ab 700 Mio. monatlich aktiven Nutzern eingeschränkt), Mistral Small 3.1, Qwen3 und Gemma 4 stehen unter Apache 2.0, Gemma 2 und Gemma 3 unter den Gemma-Nutzungsbedingungen von Google. Prüfen Sie die Lizenz vor dem kommerziellen Einsatz.
Wie schnell ist DeepSeek-R1 wirklich?
Die Geschwindigkeit hängt von Hardware, Quantisierung und Prompt ab; diese Seite gibt keine Messwerte an. Da DeepSeek-R1 vor der Antwort Gedankenketten ausgibt, erzeugt es pro Antwort mehr Token als Standard-Chatmodelle und braucht entsprechend länger; für Echtzeit-Interaktion eignet sich ein Standard-Chatmodell besser.
Warum sollte ich Ollama verwenden und nicht einfach ChatGPT Plus?
Datenschutz: Bei lokaler Ausführung verlassen Ihre Prompts das Gerät nicht (ausgenommen `:cloud`-Tags). Kosten: Keine Abonnement- oder API-Gebühren für die Modelle selbst, dafür fallen Hardware- und Stromkosten an. Offline: Nach dem Download läuft die Inferenz ohne Internetverbindung. Anpassbar: Systemprompte und Modellparameter liegen bei Ihnen.
Können Ollama-Modelle Bilder verarbeiten?
Ja. Llama 3.2 Vision, Qwen2.5-VL und Gemma 3 sind alle Multi-Modal. Laden Sie Bilder als lokale Dateien hoch; bei lokaler Ausführung erfolgt keine Cloud-Übertragung. Unterstützung: JPEG, PNG, GIF.
Wie aktualisiere ich auf neuere Ollama-Modellversionen?
Führen Sie `ollama pull [model-name]` erneut aus. Ollama lädt nur die Unterschiede herunter (Deduplizierung). Alte Versionen können gelöscht werden mit `ollama rm [model-name]:tag`.
Muss ich bei der Verwendung lokaler LLMs via Ollama die DSGVO beachten?
Ja. DSGVO Artikel 32 erfordert angemessene Sicherheitsmaßnahmen für personenbezogene Daten. Lokale Inferenz auf privaten Geräten oder Servern kann helfen, Datenschutz-durch-Design-Anforderungen zu erfüllen. Ohne Cloud-Übertragung verlassen die Daten Ihr System nicht, was Datensouveränität und die Umsetzung von Schutzmaßnahmen erleichtert; ob z. B. BSI-Grundschutz-Anforderungen erfüllt sind, hängt von Ihrer Gesamtkonfiguration ab (keine Rechtsberatung). Vorsicht: Wenn Sie ein Cloud-Modell verwenden, prüfen Sie zunächst die Datenverarbeitungsverträge.
Ist Ollama mit Open-Source-Modellen für den deutschen Mittelstand geeignet?
Ja, in vielen Fällen. Kleine und mittlere Unternehmen (KMU) in Deutschland können profitieren von: Datensouveränität (kein Cloud-Vendor Lock-in), Unterstützung bei der Umsetzung von IT-Sicherheitsstandards wie dem BSI IT-Grundschutz (die Erfüllung hängt von Ihrer Gesamtkonfiguration ab; keine Rechtsberatung), Skalierbarkeit auf Standard-Hardware und Einsparungen durch entfallende API-Gebühren. Qwen3 8B läuft auf einer typischen Office-GPU; Llama 3.1 8B kommt häufig für interne Tools, Customer-Service-Automation und Dokumentenverarbeitung zum Einsatz.
Verwandte Lektüre
- Ollama-Vision-Modelle (2026) -- ein dedizierter, praktischer Leitfaden zum Ausführen bildfähiger Modelle über Ollama, mit echter CLI-/API-Syntax.
- Lokale LLMs mit VS Code und Cursor installieren -- VS Code und Cursor erkennen jetzt Ollama automatisch.
- So wählen Sie ein lokales Modell: Llama vs. Qwen vs. Mistral -- Vollständiger Vergleich für Anfänger.
- Ollama vs. LM Studio: Welches ist schneller? -- GPU-Benchmarks und Durchsatzvergleiche.
- Wie installieren Sie Ollama auf Windows/Mac -- Schritt-für-Schritt-Installations- und Umgebungskonfiguration.
- Hardware für lokale LLMs: GPU-Anforderungen -- Welche GPU, RAM und Speicher für Ihr Modell erforderlich ist.
- Troubleshooting: Ollama-Fehler und Lösungen -- CUDA, MPS, CPU-Fallback und häufige Fehler.
- Lokale LLM-Modell-Updates 2026 -- vollständige Zeitleiste aller wichtigen Open-Weight-Releases mit Ollama-Verfügbarkeitsdaten.
Quellen
- Ollama-Modellbibliothek -- Mehrere hundert Modelle mit Live-Download-Statistiken.
- DeepSeek-R1 Whitepaper -- "DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning" (Januar 2025).
- Gemma 3 Announcement -- Google Developers Blog: Gemma 3 multimodal, 128K Kontext, März 2025.