Bestes lokales LLM für Coding mit 12 GB VRAM?
Von Hans Kuepper · Gründer von PromptQuorum · Entdeckungsplattform für Open-Weight- und Open-Source-KI
Wichtigste Erkenntnisse
- ✓Gemma 4 12B (Google, Apache 2.0): 7,7–8,0 GB Download, 256K Kontext, 72,0 % LiveCodeBench v6 (Herstellerangabe) — die beste Coding-Wahl für jede 12-GB-GPU
- ✓Qwen2.5-Coder 14B Q4_K_M (~9 GB) bleibt eine solide, auf Code spezialisierte Option, stammt aber aus 2024; neuere Qwen-Coder wie Qwen3.8 27B (18 GB) brauchen mehr als 12 GB
- ✓Devstral Small 2 (24B, 15 GB) und Qwen3.8 27B (18 GB) laufen auf 12 GB nur mit CPU-Offload, was die Generierung stark verlangsamt
- ✓Erhöhen Sie das Kontextfenster fürs Coding auf mindestens 8192 — das Standardfenster kürzt echte Quelldateien — und prüfen Sie mit ollama ps, dass das Modell vollständig auf der GPU liegt
Schnelle Antwort
Gemma 4 12B ist das beste Coding-Modell für eine GPU mit 12 GB VRAM: Der Ollama-Download umfasst 7,7–8,0 GB, und Google nennt 72,0 % auf LiveCodeBench v6 für das 12B-Modell. Qwen2.5-Coder 14B (~9 GB) ist die auf Code spezialisierte Alternative. Qwen3.8 27B (18 GB) und Devstral Small 2 (15 GB) passen nicht in 12 GB.
- ▸Gemma 4 12B: 7,7–8,0 GB Download, 256K Kontext, Apache 2.0
- ▸Qwen2.5-Coder 14B Q4_K_M: ~9 GB, auf Code spezialisiert, unterstützt Fill-in-the-Middle
- ▸Ornith 9B: 5,6 GB, MIT-Lizenz, für agentisches Coding entwickelt
Die Coding-Wahl für 12 GB
Gemma 4 12B ist das beste Coding-Modell für eine GPU mit 12 GB VRAM: Der Ollama-Download umfasst 7,7–8,0 GB, was etwa 4 GB für den KV-Cache lässt, und Google nennt 72,0 % auf LiveCodeBench v6 sowie ein Codeforces-Elo von 1659 für das 12B-Modell. Es steht unter Apache 2.0, unterstützt ein Kontextfenster von 256K und nimmt Bilder entgegen, sodass Sie einen Screenshot eines Fehlers oder UI-Problems einfügen können. Die Benchmark-Werte stammen vom Hersteller; wir haben keine eigenen Messungen durchgeführt.
Qwen2.5-Coder 14B Q4_K_M (~9 GB) passt weiterhin und bleibt die auf Code spezialisierte Wahl mit Fill-in-the-Middle-Unterstützung, ist aber ein Modell von 2024. Ornith 9B (5,6 GB, MIT-Lizenz) zielt auf agentisches Coding und lässt am meisten Platz für langen Kontext. Devstral Small 2 (24B, 15 GB) und Qwen3.8 27B (18 GB) überschreiten 12 GB und laufen nur mit CPU-Offload.
Wenn Sie stattdessen eine 8-GB-Karte haben, finden Sie im Beitrag zu den besten LLMs für AMD 5700X + RTX 3070 Ti Kompromisslösungen für 8 GB.
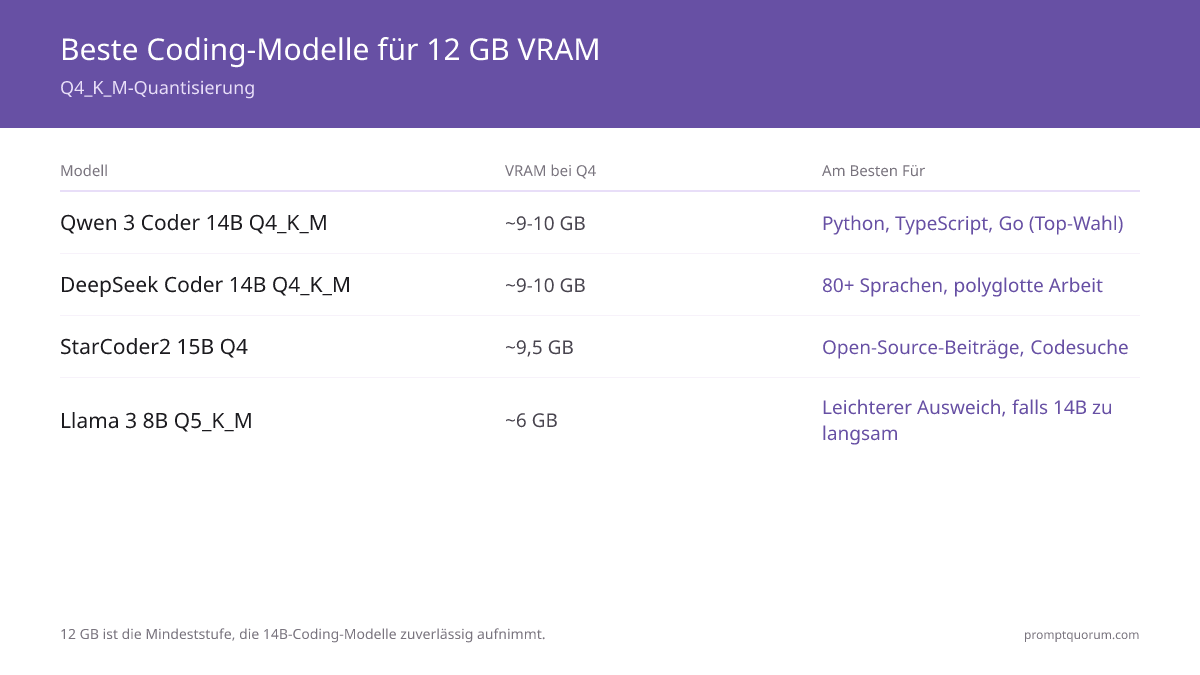
| Modell | Download-Größe | Am besten für |
|---|---|---|
| Gemma 4 12B | 7,7–8,0 GB | Beste Wahl: Coding, Bilder, 256K Kontext |
| Qwen2.5-Coder 14B Q4_K_M | ~9 GB | Code-spezialisiert, Fill-in-the-Middle |
| Ornith 9B | 5,6 GB | Agentisches Coding, Platz für langen Kontext |
| Devstral Small 2 24B | 15 GB | Passt nicht; braucht CPU-Offload |
| Qwen3.8 27B | 18 GB | Passt nicht; braucht 18 GB+ Speicher |
Einstellungen, die beim Coding zählen
Stellen Sie das Kontextfenster fürs Coding auf mindestens 8k — ein kurzes Standardfenster kürzt Quelldateien mit einigen hundert Zeilen. Die ~8 GB Gewichte von Gemma 4 12B lassen auf einer 12-GB-Karte etwa 4 GB für KV-Cache und Laufzeit; Qwen2.5-Coder 14B mit ~9 GB lässt weniger, halten Sie dort den Kontext moderat. Setzen Sie ihn mit OLLAMA_CONTEXT_LENGTH=8192 vor dem Start des Servers oder mit /set parameter num_ctx 8192 in ollama run und prüfen Sie mit ollama ps, dass das Modell auf der GPU liegt und nicht mit der CPU geteilt wird.
Aktivieren Sie Flash Attention (OLLAMA_FLASH_ATTENTION=1) und setzen Sie bei Bedarf OLLAMA_KV_CACHE_TYPE=q8_0; das halbiert den KV-Cache-Speicher gegenüber dem Standard-f16-Cache ungefähr, bei geringem Qualitätsverlust. Die Umgebungsvariablen lassen sich in einem Start kombinieren.
Das vollständige Ranking über 12 GB hinaus finden Sie im Leitfaden zu den besten lokalen LLMs fürs Coding.
ollama pull gemma4:12b
ollama run gemma4:12b

# code-specialised alternative
ollama pull qwen2.5-coder:14b-instruct-q4_K_MVerwandte Leitfäden
- ▸Beste lokale LLMs fürs Coding -- vollständiges Ranking über 12 GB hinaus
- ▸Best MoE Models for Local Coding -- MoE-Coding-Modelle
- ▸Continue.dev von Cursor übernommen: Einstellung und Alternativen -- Vergleich von Coding-Tools
Schnelle Antworten zu Coding-LLMs für 12 GB VRAM
Was ist das beste Coding-Modell für 12 GB VRAM?▾
Was ist das beste lokale LLM für 12 GB VRAM allgemein?▾
Passen Qwen3.8 27B und Devstral Small 2 in 12 GB VRAM?▾
Sollte ich auf 12 GB Q4_K_M oder eine höhere Quantisierung nutzen?▾
Kann ich Fill-in-the-Middle (FIM) für Autovervollständigung mit diesen Modellen in Ollama nutzen?▾
suffix von /api/generate entgegen, sofern das Template des Modells es unterstützt. Prüfen Sie die Ollama-Seite jedes Modells auf Insert-Unterstützung, bevor Sie es in einen Editor einbinden; für Autovervollständigung ist Qwen2.5-Coder die sicherere Wahl.