Was KI-Code-Review tatsächlich leistet
📍 In One Sentence
KI-Code-Review ist ein Filter für die erste Prüfung, der Logikfehler, Sicherheitsprobleme und Verstöße gegen Standards in dem Moment sichtbar macht, in dem ein Pull Request geöffnet wird, sodass menschliche Reviewer ihre Zeit auf Logik und Architektur statt auf Variablennamen verwenden.
💬 In Plain Terms
Stellen Sie es sich wie eine Rechtschreibprüfung für Code vor. Sie fängt die offensichtlichen Probleme ab, bevor eine Kollegin oder ein Kollege Ihren Pull Request überhaupt ansieht, sodass das menschliche Review die Frage klären kann, ob der Ansatz stimmt, statt ob Sie eine Null-Prüfung vergessen haben.
KI-Code-Review-Tools analysieren Pull Requests, erkennen Logikfehler, markieren Sicherheitslücken, setzen Coding-Standards durch und erzeugen umsetzbare Korrekturvorschläge — in Sekunden statt in den Stunden, die ein manuelles Peer-Review braucht.
Das klassische Peer-Code-Review ist die zeitaufwendigste Einzelaufgabe in Software-Entwicklungs-Workflows: Senior-Entwickler müssen zwischen ihrer eigenen Arbeit und der Bewertung fremden Codes hin- und herwechseln. KI-Code-Review-Tools integrieren sich direkt in CI/CD-Pipelines und Pull-Request-Workflows — GitHub, GitLab, Bitbucket und Azure DevOps — und beginnen mit der Analyse, sobald ein PR geöffnet wird, ohne darauf zu warten, dass ein menschlicher Reviewer verfügbar ist.
KI-Code-Review-Tools: Welches Sie einsetzen sollten
In einem von Greptile im Juli 2025 durchgeführten Benchmark mit 50 eingebauten Bugs fand Greptile 82%, Cursor Bugbot 58%, GitHub Copilot 54% und CodeRabbit 44% (Standardeinstellungen, gehostete Tarife). Greptile verkauft eines der getesteten Tools, und unabhängige Ergebnisse können abweichen; lesen Sie die Zahlen daher als Richtwert, nicht als Urteil.
CodeRabbit bietet kostenlose Reviews für öffentliche Repositories; private Repositories benötigen Essentials ($24 pro Nutzer und Monat bei jährlicher Abrechnung, $30 monatlich), Team ($48 jährlich, $60 monatlich) oder Advanced ($72), Enterprise auf Anfrage. Self-Hosting gibt es nur im Enterprise-Tarif, und laut der Self-Hosting-Dokumentation wird es Kunden mit 500+ Sitzplätzen angeboten.
Greptile Starter ist für einen aktiven Entwickler kostenlos (50 Credits pro Monat). Pro hat keine Sitzplatzgebühren: Credits kosten je $1, ein Base-Review verbraucht 1 Credit, ein Plus-Review 3 und ein Apex-Review 10. Qodo Pro Team nennt $30 mit gemeinsam genutzten Credits für bis zu 30 Nutzer und hat keinen dauerhaft kostenlosen Tarif. GitHub Copilot Code Review ist für Copilot Pro, Pro+, Max, Business und Enterprise allgemein verfügbar (nicht für Copilot Free) und verbraucht KI-Credits — GitHub dokumentiert durchschnittlich etwa $0,25 (Lite), $1,50 (Balanced) und $10 (Max) pro Review.
Tool | Erkennungsrate (Herstellertest) | Git-Plattformen | Self-Hosting | Listenpreis |
|---|---|---|---|---|
| Greptile | 82% | GitHub, GitLab; Bitbucket DC (Ent.) | Enterprise | Starter kostenlos; Pro $1 pro Credit |
| Cursor Bugbot | 58% | GitHub, GitLab, Bitbucket, Azure DevOps | Selbst gehostetes Git unterstützt | Nutzungsbasierte Abrechnung |
| GitHub Copilot | 54% | GitHub | Nein | In kostenpflichtigen Tarifen; Abrechnung in KI-Credits |
| CodeRabbit | 44% | GitHub, GitLab | Enterprise (500+ Sitzplätze) | $24 pro Nutzer und Monat (jährlich) |
| Qodo | Nicht getestet | GitHub, GitLab, Bitbucket, Azure | Enterprise (On-Prem) | Pro Team ab $30 (gemeinsam genutzt) |
| Snyk Code | Nicht getestet | Über SCM-Integrationen | Keine Angabe | Kostenlos; Team ab $25 (10 Entwickler) |
| Klassisches SAST | Nicht getestet | Unterschiedlich | Unterschiedlich | Unterschiedlich |
🔍 Herkunft der Daten
Erkennungsraten: von Greptile durchgeführter Benchmark, Juli 2025, nicht von PromptQuorum gemessen. Listenpreise von den Preisseiten der Hersteller; Tarife ändern sich häufig, bestätigen Sie sie daher vor dem Kauf.
CodeRabbit vs Greptile: Preise, Plattformen und Erkennung im Vergleich
CodeRabbit rechnet pro Sitzplatz ab und prüft öffentliche Repositories kostenlos; Greptile Pro rechnet pro Review über vorausbezahlte Credits ab, ohne Sitzplatzgebühren. In Greptiles eigenem Benchmark vom Juli 2025 fand Greptile 82% der eingebauten Bugs und CodeRabbit 44%.
Dieser Abstand stammt aus einem vom Hersteller durchgeführten Test mit Standardeinstellungen und sagt daher keine Ergebnisse für Ihren Code voraus. Das Kostenmodell ist ebenso wichtig: Ein Team mit wenigen Pull Requests pro Entwickler zahlt mit Credits meist weniger, ein Team mit vielen Pull Requests zahlt mit Sitzplätzen meist weniger.
Qodo liegt dazwischen: Pro Team nennt $30 mit gemeinsam genutzten Credits für Teams mit bis zu 30 Nutzern (die Preisseite sagt nicht, ob das pro Sitzplatz gilt), eine 14-tägige Testphase und keinen dauerhaft kostenlosen Tarif. Auf der Preisseite sind die Logos von GitHub, GitLab, Bitbucket und Azure zu sehen.
Faktor | CodeRabbit | Greptile |
|---|---|---|
| Erkennungsrate (Greptile-Test) | 44% | 82% |
| Kostenloser Tarif | Öffentliche Repos, kostenlos | Starter: 1 Entwickler, 50 Credits/Monat |
| Einstiegspreis (kostenpflichtig) | $24/Nutzer/Monat (jährlich) | $1 pro Credit, keine Sitzplatzgebühren |
| Testphase | 14 Tage (kostenpflichtige Tarife) | 14 Tage (Pro) |
| Git-Plattformen | GitHub, GitLab | GitHub, GitLab; Bitbucket DC (Ent.) |
| Self-Hosting | Enterprise (500+ Sitzplätze) | Enterprise |
| Eigener LLM-Anbieter | Dokumentiert (selbst gehostet) | Keine Angabe |
Greptile-Alternativen: CodeRabbit, Qodo, Cursor Bugbot, Copilot und Graphite
Die engsten Alternativen zu Greptile sind CodeRabbit, Qodo, Cursor Bugbot, GitHub Copilot Code Review und Graphite Agent. Wählen Sie nach Git-Plattform, nach Preismodell (Sitzplätze, Credits oder Nutzung) und nach Bereitstellung (Cloud oder selbst gehostet), nicht anhand eines einzelnen Benchmarks.
- CodeRabbit — Preis pro Sitzplatz, kostenlos für öffentliche Repositories, Self-Hosting im Enterprise-Tarif. Fand 44% in Greptiles Test.
- Qodo — Pro Team ab $30 mit gemeinsam genutzten Credits, 14-tägige Testphase; GitHub, GitLab, Bitbucket und Azure; Enterprise ergänzt Single-Tenant sowie On-Prem- oder Air-Gapped-Bereitstellung. Nicht in Greptiles Test.
- Cursor Bugbot — nutzungsbasierte Abrechnung; GitHub, GitLab, Bitbucket und Azure DevOps Services, einschließlich selbst gehostetem GitHub, GitLab und Bitbucket Data Center. Fand 58% in Greptiles Test.
- GitHub Copilot Code Review — in Copilot Pro, Pro+, Max, Business und Enterprise enthalten, Abrechnung in KI-Credits (je nach Aufwandsstufe etwa $0,25 bis $10 pro Review). Fand 54% in Greptiles Test.
- Graphite Agent — der KI-Reviewer von Graphite (der Name Diamond ist veraltet). Cursor kündigte die Übernahme von Graphite am 19. Dezember 2025 an.
Snyk und SonarQube scannen auf Schwachstellen; KI-Reviewer lesen den Pull Request
Snyk Code ist ein Sicherheits-Scanner, kein allgemeiner Pull-Request-Reviewer: Es markiert Schwachstellen wie Injection und hartkodierte Zugangsdaten in der IDE, in Pull Requests und in CI, während CodeRabbit, Greptile oder Qodo Logik, Randfälle und Design im Diff kommentieren. Die meisten Teams setzen jeweils eines von beiden ein.
Snyk-Code-Tarife (snyk.io/plans): Free umfasst 100 Snyk-Code-Tests pro Monat; Team beginnt bei $25 pro Monat für bis zu 10 Entwickler (1.000 Tests pro Monat, Pauschalpreis); Enterprise ist Credit-basiert mit 1 Credit pro aktivem Mitwirkenden und Tag. Die Tarifseite nennt KI-Pull-Request-Zusammenfassungen oder KI-Code-Review nicht unter den Tarifmerkmalen.
SonarQube ist in erster Linie regelbasierte statische Analyse: Es wendet feste Qualitäts- und Sicherheitsregeln an und erzwingt Quality Gates, was deterministisch und wiederholbar ist. Ein LLM-Reviewer ergänzt kontextbezogene Kommentare, aber seine Ausgabe kann zwischen Durchläufen variieren; nutzen Sie daher die Regel-Engine als Merge-Gate und den KI-Reviewer als zusätzlichen Leser.
Self-Hosting, On-Prem und Bring-Your-Own-LLM
Self-Hosting ist bei den drei Anbietern, die es dokumentieren — CodeRabbit, Greptile und Qodo —, ein Enterprise-Feature, und keiner nennt es für einen Self-Serve-Tarif. Für Code, der Ihre Infrastruktur nie verlassen darf, betreiben Sie ein Open-Weight-Modell lokal — siehe Beste lokale LLMs für Code-Review.
- CodeRabbit — nur Enterprise; laut Dokumentation wird es Kunden mit 500+ Sitzplätzen angeboten und läuft als Container-Image gegen GitHub Enterprise Server, GitLab self-managed, Azure DevOps oder Bitbucket Data Center. Selbst gehostetes CodeRabbit sendet Review-Prompts und Quellcode weiterhin an den von Ihnen konfigurierten LLM-Anbieter, und laut Dokumentation können Sie Ihren eigenen LLM-Anbieter oder Ihr eigenes Konto anbinden.
- Greptile — nur Enterprise („self-host in your own infrastructure“); GitHub Enterprise, GitLab Self-Managed, Bitbucket Data Center, Gitea und Perforce.
- Qodo — Enterprise ergänzt Single-Tenant-SaaS sowie On-Prem- oder Air-Gapped-Bereitstellung.
- CodeRabbit CLI — prüft nicht committete lokale Änderungen, bevor ein Pull Request existiert. Es authentifiziert sich gegenüber dem Backend von CodeRabbit, und die von uns geprüfte Dokumentationsseite gibt nicht an, ob analysierter Code auf Ihrem Rechner bleibt; es ist daher kein Ersatz für ein vollständig lokales Review.
Warum ist das Signal-Rausch-Verhältnis beim KI-Code-Review ein Problem?
KI-Code-Review-Tools kommentieren Stilprobleme weit zuverlässiger, als sie kritische Laufzeitfehler finden (44–82% im oben genannten, vom Hersteller durchgeführten Test) — das erzeugt ein Problem der Kommentarmenge, das zum Einbruch der Akzeptanz bei Entwicklern führen kann.
Branchenleitfäden berichten häufig, dass KI-Reviewer im Verhältnis zu Logik- und Sicherheitsbefunden viele Kommentare zu Stil, Duplikation und Testabdeckung erzeugen. Eine öffentliche Datenbasis, die dieses Verhältnis beziffert, konnten wir nicht verifizieren; messen Sie es daher selbst: Der Anteil der KI-Kommentare, die Ihre Entwickler umsetzen, ist die Zahl, auf die es ankommt. Tools, deren Kommentare meist ignoriert werden, bringen Ingenieure dazu, jedes Feedback zu ignorieren, auch kritische Befunde.
Eine wahrscheinliche Ursache sind die Trainingsdaten: Die Modelle sehen in den Codebasen, aus denen sie lernen, weit mehr Stilvarianten als Logikfehler und zeigen daher an, was häufig ist, nicht was am wichtigsten ist.
Prompt Engineering, das das Modell anweist, Logik und Sicherheit vor Stil zu priorisieren, ist der wichtigste Hebel, um die Mischung zu verschieben; passen Sie den Prompt an und messen Sie die Aktionsrate danach erneut.
In einem Satz: KI-Code-Review-Tools können überwiegend Stilkommentare erzeugen — eng gefasste Prompts und eine erfasste Aktionsrate halten Logik- und Sicherheitsbefunde sichtbar.
⚠️ Warnung
Teams, die KI-Code-Review ohne eng gefasste Prompts einführen, riskieren einen Einbruch der Akzeptanz bei Entwicklern. Ingenieure beginnen, ALLE Kommentare zu ignorieren — auch kritische Sicherheitsbefunde —, wenn die meisten Kommentare Rauschen sind. Konfigurieren Sie vor dem Rollout im Team immer explizite Review-Prioritäten.
Wie schreibt man Prompts für KI-Code-Review?
Eng gefasste, kontextreiche Prompts — mit Angabe von Sprache, Framework, Review-Prioritäten und Ausgabeformat — verringern Falsch-Positive und verbessern die Signalqualität; vage Prompts wie „Überprüfe diesen Code“ erzeugen allgemeine Ausgaben mit viel Rauschen.
Prompt Engineering ist die Praxis, KI-Anweisungen so zu strukturieren, dass die Modellausgabe eingegrenzt und gelenkt wird. Beim Code-Review ist der wirksamste Hebel ein expliziter Umfang: Wenn Sie dem Modell genau sagen, welche Problemklassen es priorisieren soll, erzeugt es weniger Stilkommentare und mehr Logik- und Sicherheitsbefunde.
Was ist das Code-Review-Prompt-Framework?
Verwenden Sie diese Struktur für jede KI-Code-Review-Anfrage:
In einfachen Worten: Das Framework ist eine fünfteilige Vorlage (Rolle, Umfang, Kontext, Ausgabeformat, Rausch-Anweisung), die vage Code-Review-Anfragen in strukturierte Prompts verwandelt, die fokussiertere Ergebnisse liefern, weil sie ausdrücklich eingrenzen, worauf sich die KI konzentrieren soll.
- Rolle — „Sie sind ein Senior Software Engineer mit Expertise in der Sicherheit von Sprache/Framework.“
- Umfang — „Prüfen Sie nur auf: (1) Logikfehler, (2) fehlende Randfälle, (3) Sicherheitslücken, (4) Performance-Regressionen. Kommentieren Sie NICHT Stil, Benennung oder Formatierung.“
- Kontext — „Sprache: TypeScript. Framework: Next.js 14. Dieser Endpunkt verarbeitet Daten authentifizierter Nutzer — behandeln Sie alle Eingaben als nicht vertrauenswürdig.“
- Ausgabeformat — „Nennen Sie für jedes Problem den Schweregrad (Critical / High / Medium), zitieren Sie die betreffende Zeile, erklären Sie das Risiko und liefern Sie einen korrigierten Code-Ausschnitt.“
- Rausch-Anweisung — „Wenn Sie in einer Kategorie nichts finden, geben Sie „Keine gefunden“ an — fügen Sie keine Füllkommentare hinzu.“
🔍 Profi-Tipp
Die wirksamste einzelne Zeile, die Sie jedem KI-Code-Review-Prompt hinzufügen können, lautet: „Kommentieren Sie NICHT Stil, Benennung oder Formatierung.“ Diese eine Einschränkung verringert das Kommentar-Rauschen und zwingt das Modell, sich auf Logikfehler und Sicherheitsprobleme zu konzentrieren — die Befunde, die Produktionsvorfälle tatsächlich verhindern.
Was unterscheidet einen schlechten von einem guten Code-Review-Prompt?
Schlechter Prompt
Überprüfe diesen Code.
Wie sieht ein guter Code-Review-Prompt aus?
Guter Prompt
Sie sind ein Senior-TypeScript-Engineer mit Schwerpunkt Sicherheit. Prüfen Sie die folgende Next.js-API-Route auf: (1) Risiken für eine Umgehung der Authentifizierung, (2) SQL-Injection- oder NoSQL-Injection-Vektoren, (3) fehlende Eingabevalidierung, (4) unbehandelte Promise-Rejections. Kommentieren Sie weder Stil noch Variablenbenennung. Nennen Sie für jedes gefundene Problem den Schweregrad (Critical / High / Medium), zitieren Sie die Zeile, erklären Sie, warum es ausnutzbar ist, und liefern Sie eine korrigierte Version. Wenn in einer Kategorie keine Probleme vorliegen, schreiben Sie „Keine gefunden.“
Der strukturierte Prompt liefert einen Sicherheitsbericht, der sich direkt priorisieren lässt. Der offene Prompt kann zum Beispiel ein Dutzend Kommentare zu Variablennamen und einen vergrabenen Sicherheitsbefund, den der Entwickler nie liest.
Wie verbessert Chain-of-Thought die Prüfung komplexer Logik?
Chain-of-Thought-Prompting (CoT) — das Modell wird aufgefordert, den Datenfluss durch jede Funktion nachzuvollziehen, bevor es Befunde liefert — deckt Logikfehler auf, die ein einstufiges Review übersieht, weil das Modell den Ausführungspfad explizit nachbilden muss, statt Muster gängiger Fehlersignaturen abzugleichen.
Nutzen Sie diese Erweiterung für jede Funktion mit komplexer bedingter Logik: „Bevor Sie Bugs benennen: Verfolgen Sie die Eingabedaten Schritt für Schritt durch jeden Zweig dieser Funktion. Identifizieren Sie jeden Pfad, auf dem ein Null-Wert, ein leerer String oder ein unerwarteter Typ weitergegeben werden könnte. Listen Sie dann jeden Pfad auf, der in einem unbehandelten Zustand endet.“
Wie führt man ein sicherheitsorientiertes KI-Code-Review durch?
KI-gestützte SAST-Tools (Static Application Security Testing), die auf realen Schwachstellen-Datensätzen trainiert wurden, erreichten bei KI-generiertem Code in einem Drittanbieter-Vergleich von 2025 Werte von 84–92 von 100 (nicht von PromptQuorum gemessen).
Regelbasierte statische Analyse wendet feste Muster an, während KI-gestützte Tools zusätzlich bewerten, wie Codepfade zusammenwirken. Beide ergänzen einander, weshalb viele Teams eine Regel-Engine als Merge-Gate und daneben einen KI-Reviewer oder Scanner einsetzen.
Drei sicherheitsorientierte Tools, bewertet in einem Drittanbieter-Vergleich von 2025 an KI-generiertem Code (sanj.dev; nicht von PromptQuorum gemessen):
Tool | Bewertung (Drittanbieter) | Falsch-Positive | Geeignet für |
|---|---|---|---|
| Snyk Code + DeepCode AI | 92/100 | Geringstes Volumen | Teams mit täglichen Releases und IDE-Integration |
| Semgrep Enterprise | 87/100 | Niedrig | Policy-as-Code; eigene YAML-Regelpakete |
| GitHub Advanced Security (CodeQL) | 84/100 | Mittel | GitHub-zentrierte Organisationen; tiefe semantische Abdeckung |
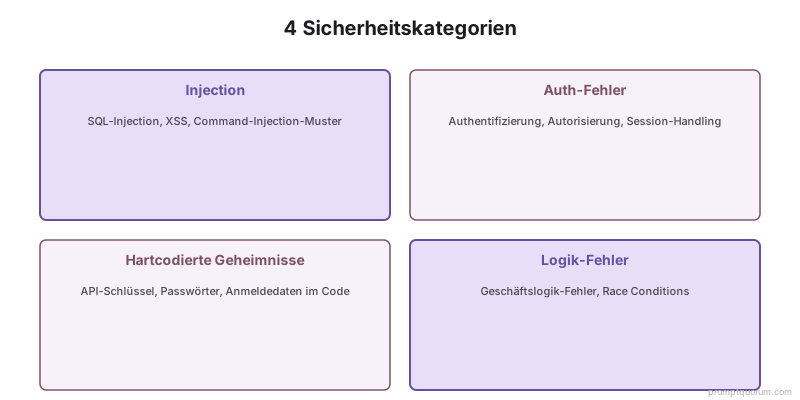
Snyk Code erkennt SQL-Injection, Cross-Site-Scripting (XSS), schwache kryptografische Voreinstellungen und hartkodierte Zugangsdaten in Echtzeit, während Entwickler Code schreiben — noch bevor ein PR geöffnet wird. CodeQL führt eine semantische Analyse auf Basis eines Abstract Syntax Tree (AST) durch und kann damit komplexe, mehrstufige Schwachstellenketten erkennen, die Mustererkennungs-Tools entgehen.
Was ist KI-Bug-Triaging?
KI-gestütztes Bug-Triaging klassifiziert Bugs nach Schweregrad, sagt die Auswirkung auf die Produktion vorher und leitet Probleme an die richtige Ingenieurin oder den richtigen Ingenieur weiter, sodass weniger Zeit für Prioritätsdiskussionen draufgeht.
KI-Bug-Triaging ist der nachgelagerte Schritt nach der Erkennung. In einer Arbeit von Khaleefulla, Sudeep und Savithri (IJERT) berichten die Autoren bei ihrem System von über 85% Genauigkeit bei der Bug-Klassifizierung, 82% Präzision bei der Prioritätsvorhersage und einer um 65% verkürzten durchschnittlichen Triage-Zeit. Das sind die eigenen Ergebnisse der Autoren, nicht von PromptQuorum gemessen.
Der Gewinn stammt hauptsächlich aus schnellerer Klassifizierung und Weiterleitung, nicht aus schnellerem Beheben. Konventionen zum Schweregrad unterscheiden sich zwischen Projekten, sodass die für ein System berichtete Genauigkeit nicht auf Ihres übertragbar sein muss; testen Sie mit Ihrem eigenen Backlog in einem Pilot, bevor Sie sich darauf verlassen.
🔍 Wussten Sie schon
Die Zeitersparnis beim KI-Triaging stammt nicht aus schnellerem Beheben, sondern aus schnellerer Klassifizierung und Weiterleitung. Ingenieure verbringen weniger Zeit mit Prioritätsdiskussionen und mehr Zeit mit der Lösung der Probleme, auf die es ankommt.
Warum bestimmt die Größe des Kontextfensters die Codebase-Abdeckung?
Das Kontextfenster eines Modells bestimmt, wie viel Ihrer Codebase es gleichzeitig analysieren kann — der Unterschied zwischen der Prüfung einer einzelnen Datei, eines vollständigen PR-Diffs und eines gesamten Repositories entscheidet darüber, welche Bugs erkennbar sind.
Cloud-Frontier-Modelle bieten inzwischen Kontextfenster von rund 1M Tokens, und Open-Weight-Modelle wie Llama 4 Scout erreichen lokal 10M Tokens, ohne dass Code Ihre Infrastruktur verlässt. Die Angaben zu Codezeilen sind Schätzungen bei etwa 10–13 Tokens pro Zeile; prüfen Sie die aktuelle Grenze in der Dokumentation des jeweiligen Anbieters.
Modellklasse | Kontextfenster | Codezeilen (Schätzung) | Anwendungsfall |
|---|---|---|---|
| Cloud-Frontier-Modelle | Rund 1M Tokens | ~75.000–100.000 Zeilen | PR-Review über das gesamte Projekt |
| Llama 4 Scout (lokal, Meta) | 10M Tokens | ~750.000–1.000.000 Zeilen | Größter Kontext, vollständig privat |
Wie wirken sich regionale Vorschriften auf KI-Code-Review aus?
Europäische Unternehmen, die Quellcode an externe KI-APIs senden, benötigen vor dem Einsatz möglicherweise eine Datenschutz-Folgenabschätzung (DPIA) nach Artikel 35 DSGVO, insbesondere wenn der Code oder die Daten, die er berührt, die Verarbeitung personenbezogener Daten betreffen. DSGVO und EU-KI-Verordnung (EU AI Act) können beim KI-gestützten Code-Review gleichzeitig gelten, wenn personenbezogene Daten verarbeitet werden; binden Sie daher vor dem Rollout Ihre Datenschutzbeauftragte oder Ihren Datenschutzbeauftragten ein. Dies ist eine allgemeine Information, keine Rechtsberatung; klären Sie die Anforderungen mit Ihrer Datenschutzbeauftragten, Ihrem Datenschutzbeauftragten oder Ihrer Rechtsberatung.
Für EU-Teams bietet CodeRabbit im Enterprise-Tarif eine selbst gehostete Bereitstellung an (500+ Sitzplätze laut Dokumentation), wobei der selbst gehostete Agent Prompts und Code weiterhin an den von Ihnen konfigurierten LLM-Anbieter sendet. Open-Weight-Modelle, darunter Modelle von Mistral AI (Frankreich), lassen sich für Teams, die Code aus Clouds von Drittanbietern heraushalten müssen, lokal über Ollama betreiben.
Teams in China können Open-Weight-Modelle wie Qwen3 (Alibaba) und DeepSeek als lokal bereitstellbare Code-Review-Modelle nutzen; beide unterstützen chinesischsprachige Code-Kommentare und Dokumentation, was für gemischtsprachige Codebasen wichtig ist. Teams in Japan, die unter den Daten-Governance-Richtlinien des METI arbeiten, können Review-Workflows auf Basis von Llama 4 Scout oder Llama 3.3 lokal über Ollama betreiben — Llama 4 Scout benötigt für die Inferenz etwa 55 GB VRAM —, sodass Code keine externen APIs erreicht.
Weiterführende Lektüre
- Besseren Code mit KI schreiben — wie Sie Prompts für Code-Generierung strukturieren, die prüfbare Ergebnisse liefert
- Was ist Prompt Engineering? — grundlegende Techniken zum Schreiben strukturierter KI-Anweisungen
- KI-Grenzen — was LLMs nicht können — der architektonische Grund, warum KI-Code-Review Falsch-Positive erzeugt und kontextabhängige Bugs übersieht
- Chain-of-Thought-Prompting — die Reasoning-Technik, mit der Ausführungspfade für die Erkennung komplexer Logikfehler nachvollzogen werden
- Prompt Injection und Sicherheit — Sicherheitslücken in KI-gestützten Entwicklungs-Workflows, einschließlich Manipulation von Code-Reviews
- RAG erklärt — wie Tools mit Indexierung der gesamten Codebase wie Greptile per Retrieval den Kontext über Modellgrenzen hinaus erweitern
- Beste lokale LLMs für Code-Review — lokale Modellalternativen für privates Code-Review
- Beste lokale LLMs für Coding — Kimi K2.6, Qwen 3.6, Devstral im Ranking für Coding-Aufgaben
- Constrained Prompting — die Technik hinter der Anweisung „Kommentieren Sie NICHT Stil“
So nutzen Sie KI für Code-Review
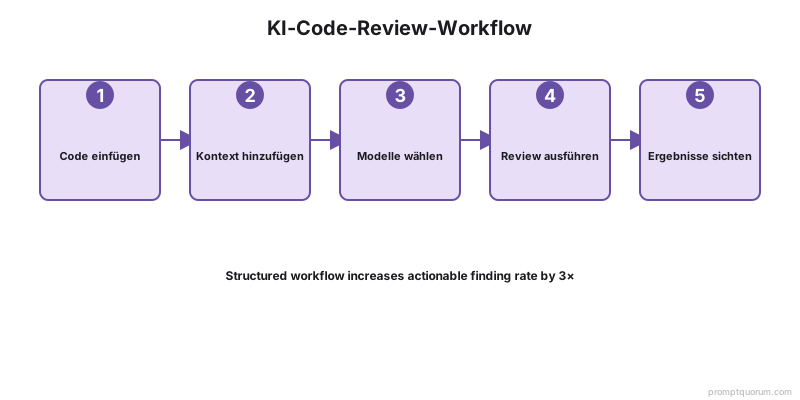
- 1Briefen Sie die KI über Ihre Codebase-Architektur, Namenskonventionen und Rahmenbedingungen, bevor Sie sie Code prüfen lassen. Geben Sie ein kurzes Kontextdokument mit: „Dies ist eine Next.js-App. Wir nutzen den strikten TypeScript-Modus, keine `any`-Typen, alle Komponenten müssen JSDoc haben, alle API-Endpunkte müssen ein Rate Limiting haben.“ Ohne diesen Kontext liefert die KI allgemeine Kommentare, die projektspezifische Probleme verfehlen.
- 2Lassen Sie die KI auf bestimmte Bug-Kategorien prüfen: Sicherheit, Performance, Logik, Konsistenz. Fragen Sie statt „Überprüfe diesen Code“ lieber: „Prüfe auf Sicherheitslücken (Eingaben, Authentifizierung, Datenpreisgabe) und kontrolliere dann, ob dieses Muster zu unserer etablierten Fehlerbehandlung passt.“ Spezifische Fragen liefern fokussierteres, nützlicheres Feedback.
- 3Nutzen Sie Chain-of-Thought-Prompting (CoT): Lassen Sie das Modell die Ausführung nachvollziehen, bevor es Feedback gibt. Bitten Sie bei komplexen Funktionen: „Verfolge die Ausführung für Eingabe X und benenne dann alle Logikfehler.“ Das macht die Argumentation der KI nachvollziehbar und findet subtile Bugs, die Menschen entgehen könnten.
- 4Nutzen Sie bei risikoreichen Änderungen (Authentifizierung, Zahlungen, Infrastruktur) ein Multi-Modell-Code-Review. Lassen Sie denselben Code von drei Modellen verschiedener Anbieter prüfen. Wenn alle drei dasselbe Problem melden, ist das ein starkes Signal. Wenn nur ein Modell etwas findet, untersuchen Sie es sorgfältig.
- 5Behandeln Sie die KI als Filter für die erste Prüfung, nicht als letzte Instanz. KI ist hervorragend darin, offensichtliche Bugs zu finden (fehlende Returns, Typkonflikte, SQL-Injection-Muster), kann aber kontextspezifische Probleme übersehen (Performance-Folgen, Skalierungsprobleme, Team-Konventionen). Lassen Sie KI-basiertes Feedback immer von einem Menschen prüfen.
Häufige Fehler beim KI-Code-Review
❌ KI-Review mit Standardeinstellungen und ohne angepasste Prompts einführen.
Why it hurts: Standard-KI-Review kann überwiegend Stilkommentare erzeugen. Entwickler beginnen, alle Kommentare zu ignorieren. Kritische Sicherheitsbefunde gehen unter.
Fix: Nutzen Sie das 5-teilige Prompt-Framework. Schließen Sie Stil und Benennung ausdrücklich aus. Beschränken Sie den Umfang auf Logik, Sicherheit und Performance.
❌ KI-Code-Review als einzige Review-Ebene verwenden.
Why it hurts: KI-Reviewer fanden in Greptiles Benchmark vom Juli 2025 44–82% der eingebauten Bugs — nicht 100%. Kontextspezifische Probleme (Skalierungsfolgen, Team-Konventionen, Fehler in der Geschäftslogik) erfordern menschliches Urteilsvermögen.
Fix: KI ist der Filter für die erste Prüfung. Menschliche Reviewer konzentrieren sich auf Architektur, Geschäftslogik und die Bugs, die der KI entgehen.
❌ Nur PR-Diffs ohne Codebase-Kontext prüfen.
Why it hurts: Bugs, die durch Wechselwirkungen zwischen Dateien entstehen, sind für Tools unsichtbar, die nur geänderte Zeilen sehen. Eine Funktionsänderung, die einen Aufrufer in einer anderen Datei bricht, wird nicht erkannt.
Fix: Prüfen Sie in der Dokumentation jedes Anbieters, wie viel Repository-Kontext er nutzt. Bevorzugen Sie bei risikoreichen Änderungen Tools, die das gesamte Repository indexieren, und reservieren Sie diff-fokussiertes Review für risikoarme PRs.
❌ Die Aktionsrate der Entwickler bei KI-Kommentaren nicht messen.
Why it hurts: Ohne Erfassung, welcher Anteil der KI-Kommentare von Entwicklern umgesetzt wird, lässt sich nicht erkennen, ob das Tool Nutzen oder Rauschen erzeugt. Teams gehen davon aus, dass KI-Review funktioniert, obwohl die Akzeptanz möglicherweise längst eingebrochen ist.
Fix: Erfassen Sie die Aktionsrate monatlich. Liegt sie unter 40%, grenzen Sie den Prompt-Umfang enger ein. Liegt sie unter 20%, erzeugt das Tool reines Rauschen — konfigurieren Sie es neu oder ersetzen Sie es.
KI-Code-Review FAQ
Welches ist das genaueste KI-Code-Review-Tool im Jahr 2026?
Kein Tool ist in jedem Test das genaueste. In einem Benchmark, den Greptile im Juli 2025 mit 50 Bugs aus fünf Open-Source-Repositories durchgeführt hat, fand Greptile 82%, Cursor Bugbot 58%, GitHub Copilot 54% und CodeRabbit 44% (Standardeinstellungen, gehostete Tarife). Da Greptile eines der getesteten Tools verkauft und unabhängige Ergebnisse abweichen können, nutzen Sie die Zahlen als Ausgangspunkt und führen Sie eine zweiwöchige Testphase mit Ihren eigenen Pull Requests durch. Für Sicherheits-Scans ist Snyk Code eine eigene Kategorie: ein Scanner, der einen Pull-Request-Reviewer ergänzt.
CodeRabbit vs Greptile: Was sollte ich wählen, und lohnt sich CodeRabbit?
Wählen Sie Greptile, wenn die höchste Erkennungsrate bei eingebauten Bugs am wichtigsten ist und Sie pro Review budgetieren können: Es fand 82% gegenüber 44% bei CodeRabbit in Greptiles eigenem Test vom Juli 2025, und Pro hat keine Sitzplatzgebühren (vorausbezahlte Credits zu je $1; ein Base-Review verbraucht 1 Credit). Wählen Sie CodeRabbit, wenn Sie einen Preis pro Sitzplatz ($24 pro Nutzer und Monat bei Essentials mit jährlicher Abrechnung, $30 monatlich) und kostenlose Reviews für öffentliche Repositories wünschen. Beide bieten eine 14-tägige Testphase und reservieren Self-Hosting für Enterprise. Ob sich CodeRabbit lohnt, hängt vom Volumen ab: Ein pauschaler Sitzplatzpreis lässt sich bei Teams mit vielen Pull Requests leichter kalkulieren, während Teams mit geringem Volumen pro Review womöglich weniger zahlen.
Sind CodeRabbit und Greptile kostenlos?
Teilweise. CodeRabbit bietet kostenlose Reviews für öffentliche Repositories; private Repositories benötigen einen kostenpflichtigen Tarif (Essentials ab $24 pro Nutzer und Monat bei jährlicher Abrechnung) mit 14-tägiger Testphase. Greptile Starter ist für einen aktiven Entwickler mit 50 Credits pro Monat kostenlos; Pro nutzt vorausbezahlte Credits zu je $1 mit 14-tägiger Testphase, und qualifizierte nicht-kommerzielle Open-Source-Projekte können kostenlosen Zugang beantragen.
Unterstützt Greptile Bitbucket?
Die Preisseite von Greptile nennt Bitbucket Data Center unter den Plattformen für selbst gehostete Enterprise-Bereitstellungen, neben GitHub Enterprise, GitLab Self-Managed und Gitea. Bitbucket Cloud wird nicht ausdrücklich genannt, und Drittquellen widersprechen sich; bestätigen Sie die Unterstützung für Bitbucket Cloud daher bei Greptile, bevor Sie sich festlegen. Qodo (Logos von GitHub, GitLab, Bitbucket und Azure auf der Preisseite) und Cursor Bugbot (GitHub, GitLab, Bitbucket und Azure DevOps Services laut Cursor-Dokumentation) nennen Bitbucket-Unterstützung.
Was sind die besten Greptile-Alternativen?
Die engsten Alternativen sind CodeRabbit, Qodo, Cursor Bugbot, GitHub Copilot Code Review und Graphite Agent (Cursor kündigte die Übernahme von Graphite am 19. Dezember 2025 an). In Greptiles Test vom Juli 2025 fand Bugbot 58%, Copilot 54% und CodeRabbit 44%; Qodo wurde nicht getestet. Wählen Sie nach Git-Plattform (Bitbucket: Qodo oder Bugbot), nach Preismodell (Sitzplätze, Credits oder Nutzung) und nach Bereitstellung (Self-Hosting ist bei CodeRabbit, Greptile und Qodo ein Enterprise-Feature).
Welche KI-Code-Review-Tools bieten Self-Hosting oder On-Prem-Deployment, und kann ich einen eigenen LLM-Key verwenden?
CodeRabbit (Enterprise-Tarif; laut Dokumentation wird er Kunden mit 500+ Sitzplätzen angeboten und unterstützt GitHub Enterprise Server, GitLab self-managed, Azure DevOps und Bitbucket Data Center), Greptile (Enterprise) und Qodo (Enterprise: Single-Tenant-SaaS, On-Prem und Air-Gapped) dokumentieren Self-Hosting. Selbst gehostetes CodeRabbit sendet Prompts und Quellcode weiterhin an den von Ihnen konfigurierten LLM-Anbieter, und laut Dokumentation können Sie Ihren eigenen LLM-Anbieter oder Ihr eigenes Konto anbinden. Die CLI von CodeRabbit prüft lokale Änderungen vor einem Pull Request, authentifiziert sich aber gegenüber dem Backend von CodeRabbit. Für Code, der Ihre Infrastruktur nie verlassen darf, betreiben Sie ein Open-Weight-Modell lokal.
Ist Snyk ein KI-Code-Review-Tool?
Snyk Code ist ein Sicherheits-Scanner mit KI-Unterstützung, der Code in der IDE, in Pull Requests und in CI prüft. Die Tarifseite von Snyk nennt Echtzeit-Scans und Integrationen mit Source-Code-Managern, aber keine KI-Pull-Request-Zusammenfassungen und kein allgemeines Code-Review. Der Free-Tarif umfasst 100 Snyk-Code-Tests pro Monat, Team beginnt bei $25 pro Monat für bis zu 10 Entwickler, und Enterprise ist Credit-basiert. Kombinieren Sie es mit einem Pull-Request-Reviewer wie CodeRabbit oder Greptile; auch SonarQube ist in erster Linie regelbasierte statische Analyse und kein LLM-Reviewer.
Wie stark verkürzt KI-Code-Review die Review-Zeit?
Ein Branchenleitfaden eines Dritten (DigitalApplied, 2025) berichtet von 40% weniger Review-Zeit und 62% weniger Produktionsfehlern; PromptQuorum hat dies nicht gemessen. In der Arbeit von Khaleefulla et al. (IJERT) berichten die Autoren von einer um 65% verkürzten durchschnittlichen Triage-Zeit bei ihrem KI-Triage-System. Unabhängig vom Tool: Messen Sie vor und nach der Anpassung des Prompt-Umfangs den Anteil der KI-Kommentare, die Ihre Entwickler umsetzen.
Wie schneidet KI-Code-Review im Vergleich zu klassischer statischer Analyse (SAST) ab?
Regelbasiertes SAST wendet feste Schwachstellensignaturen an und neigt zu vielen Falsch-Positiven, während KI-gestützte Tools kontextbezogenes Schließen ergänzen: Sie bewerten, wie Codepfade zusammenwirken, statt Signaturen abzugleichen. In einem Drittanbieter-Vergleich von 2025 erreichten Snyk Code, Semgrep Enterprise und CodeQL bei KI-generiertem Code 84–92/100 (nicht von PromptQuorum gemessen). Die beiden Ansätze ergänzen einander.
Ist KI-Code-Review für europäische Teams mit der DSGVO vereinbar?
Nicht automatisch. Das Senden von Quellcode, der die Verarbeitung personenbezogener Daten berührt, an externe KI-APIs kann eine Datenschutz-Folgenabschätzung (DPIA) nach Artikel 35 DSGVO erfordern; fragen Sie Ihre Datenschutzbeauftragte oder Ihren Datenschutzbeauftragten. DSGVO und EU-KI-Verordnung (EU AI Act) können gleichzeitig gelten. Bei strengen Anforderungen nutzen Sie Self-Hosting (CodeRabbit Enterprise, Kunden mit 500+ Sitzplätzen angeboten, sendet Code weiterhin an den von Ihnen konfigurierten LLM-Anbieter) oder betreiben Open-Weight-Modelle lokal über Ollama, sodass kein Code Ihre Infrastruktur verlässt.
Verbessert Chain-of-Thought-Prompting die Qualität von KI-Code-Review?
Ja — bei komplexer Logik mit mehreren bedingten Zweigen fordert Chain-of-Thought-Prompting (CoT) das Modell auf, den Datenfluss durch jeden Ausführungspfad nachzuvollziehen, bevor es Befunde liefert. Das deckt Logikfehler auf, die Mustererkennung übersieht, weil das Modell explizit jeden Pfad nachbilden muss, den ein Null-Wert oder ein unerwarteter Eingabetyp durch die Funktion nehmen kann — statt den Code mit Vorlagen gängiger Fehler abzugleichen. CoT ist am wertvollsten bei sicherheitskritischen Funktionen und komplexem Zustandsmanagement; es erhöht die Latenz und ist für einfache Hilfsfunktionen unnötig.
Welcher Anteil der KI-Code-Review-Kommentare ist tatsächlich nützlich?
Eine belastbare öffentliche Zahl konnten wir nicht bestätigen, und der Anteil variiert je nach Tool, Prompt und Codebase; messen Sie ihn daher selbst: Zählen Sie einen Monat lang den Anteil der KI-Kommentare, die Ihre Entwickler umsetzen. Wenn die meisten Kommentare ignoriert werden, grenzen Sie den Umfang enger ein — schließen Sie Stilkommentare ausdrücklich aus und fordern Sie nur Befunde zu Logik, Sicherheit und Performance an — und messen Sie erneut.
Welches KI-Modell ist für Code-Review am besten?
Es gibt kein einzelnes bestes Modell. Lassen Sie dieselbe risikoreiche Änderung von zwei oder drei Modellen verschiedener Anbieter prüfen und behandeln Sie Probleme, die mehr als ein Modell meldet, als hochgradig verlässlich. Die Modelle unterscheiden sich im Kontextfenster (Cloud-Frontier-Modelle bieten rund 1M Tokens, etwa 75.000–100.000 Codezeilen; Llama 4 Scout unterstützt lokal 10M Tokens), darin, wie gut sie einer Umfangsanweisung folgen, und bei den Kosten pro Review. Testen Sie Kandidaten an Ihren eigenen früheren Pull Requests mit bekannten Bugs, bevor Sie sich auf einen Standard festlegen.
Wie verringere ich Falsch-Positive beim KI-Code-Review?
Drei Techniken: (1) den Prompt ausdrücklich eingrenzen — „Prüfe nur auf Logikfehler, Sicherheitslücken und Performance-Regressionen; kommentiere NICHT Stil oder Benennung“; (2) eine Rausch-Anweisung ergänzen — „Wenn du in einer Kategorie nichts findest, schreibe Keine gefunden, füge keine Füllkommentare hinzu“; (3) bei komplexen Funktionen Chain-of-Thought nutzen — das Modell soll Ausführungspfade nachvollziehen, bevor es Befunde liefert. Erfassen Sie den Anteil der Kommentare, die Entwickler umsetzen, und grenzen Sie den Umfang enger ein, wenn er unter 40% fällt.
Wie binde ich KI-Code-Review in unsere CI/CD-Pipeline ein?
Die meisten Tools werden als GitHub- oder GitLab-App oder -Bot installiert, der jeden Pull Request automatisch prüft; die Plattformunterstützung variiert, prüfen Sie daher die Vergleichstabelle oben. Lassen Sie das KI-Review parallel zu anderen Prüfungen (Linting, Unit-Tests) laufen und blockieren Sie Merges nur bei kritischen Sicherheitsbefunden; andere Befunde bleiben beratende Kommentare, über die Entwickler nach eigenem Ermessen entscheiden.
Kann KI-Code-Review Sicherheitslücken besser erkennen als spezialisierte SAST-Tools?
In Vergleichen von Drittanbietern erzielten KI-gestützte SAST-Tools (Snyk Code, Semgrep Enterprise, CodeQL) bei KI-generiertem Code 84–92/100 in einem Drittanbieter-Vergleich von 2025 (nicht von PromptQuorum gemessen), und regelbasierte statische Analyse bleibt als schnelles Merge-Gate nützlich. Klassisches SAST ist bei der Massenprüfung großer Codebasen weiterhin schneller, weil KI pro PR mehr Rechenleistung benötigt. Bewährte Praxis: Nutzen Sie leichtgewichtiges SAST und Linting für die Geschwindigkeit und ergänzen Sie es um KI-Review für die tiefe Sicherheitsanalyse bei risikoreichen Änderungen (Authentifizierung, Zahlungen, Infrastruktur).
Kann ich KI-Code-Review lokal für vollständig privaten Code betreiben?
Ja. Devstral Small 24B (Mistral AI, 16 GB RAM) und Llama 4 Scout (~55 GB VRAM, 10M Kontext) laufen über Ollama vollständig On-Premises. Die Inferenz läuft auf Ihrer Hardware, sodass Code nicht an einen Cloud-Reviewer gesendet wird; das kann den Verarbeitungsschritt durch Dritte entfallen lassen, den eine DPIA sonst abdecken müsste, doch klären Sie das Verhalten beim Modell-Download und bei Updates mit Ihrem Security-Team. Die Qualität liegt bei komplexer Sicherheitsanalyse unter der von Cloud-Frontier-Modellen, genügt aber für die meisten Reviews auf PR-Ebene.
Welches ist das beste KI-Code-Review-Tool für kleine Teams (unter 10 Entwickler)?
GitHub Copilot Code Review ist die reibungsärmste Option, wenn Ihr Team bereits für einen Copilot-Tarif zahlt, der es enthält (Pro, Pro+, Max, Business oder Enterprise); die Nutzung wird in KI-Credits abgerechnet. CodeRabbit prüft öffentliche Repositories kostenlos, Greptile Starter ist für einen aktiven Entwickler kostenlos, Snyk Code Free umfasst 100 Tests pro Monat, und Qodo bietet eine 14-tägige Testphase, aber keinen dauerhaft kostenlosen Tarif. Promptfoo (kostenlos, Open Source) kann Code-Review-Assertions in CI/CD automatisieren. Legen Sie sich als Team mit unter 10 Entwicklern erst dann auf Jahrestarife fest, wenn das Review-Volumen die Kosten rechtfertigt.
Quellen & weiterführende Lektüre
- Greptile, 2025. "AI code review bug catch benchmark" — vom Hersteller durchgeführte Bewertung von fünf Tools anhand von 50 eingebauten Bugs aus fünf Open-Source-Repositories (Juli 2025); Quelle der Erkennungsraten 82% / 58% / 54% / 44%
- CodeRabbit pricing — Tarife, Preise pro Nutzer, kostenlose Reviews für öffentliche Repositories
- CodeRabbit self-hosted documentation — Enterprise-Self-Hosting, unterstützte Plattformen, Angebot ab 500+ Sitzplätzen, Option für den eigenen LLM-Anbieter
- CodeRabbit CLI documentation — lokales Review nicht committeter Änderungen
- Greptile pricing — Starter, Pro-Credits, Enterprise-Self-Hosting, unterstützte Plattformen
- Qodo pricing — Pro Team und Enterprise-Tarife, Testphase, On-Prem-Optionen
- Snyk plans — Grenzen von Snyk Code Free, Team und Enterprise
- Cursor Bugbot documentation — nutzungsbasierte Abrechnung und unterstützte Git-Plattformen
- GitHub Docs: Copilot code review — Tarife mit Code-Review und Abrechnung in KI-Credits
- Graphite, 2025. "Effective prompt engineering for AI code reviews" — technischer Leitfaden zu eng gefassten Prompts, um Falsch-Positive zu verringern und das Signal zu verbessern
- Sanjay, 2025. "Best AI Code Security Tools 2025: Snyk vs Semgrep vs CodeQL" — Drittanbieter-Benchmark von drei SAST-Tools an KI-generiertem Code (Quelle der Werte 92 / 87 / 84)
- Khaleefulla, Sudeep und Savithri. "Automated Bug Categorization and Task Assignment System Using Artificial Intelligence" (IJERT) — eigene Ergebnisse der Autoren: über 85% Klassifizierungsgenauigkeit, 82% Präzision bei der Priorität, 65% kürzere Triage-Zeit
- DigitalApplied, 2025. "AI Code Review Automation: Complete Guide" — Branchenzahlen: 40% Zeitersparnis, 62% weniger Produktionsfehler
- Hinweis: Die Erkennungsraten stammen von den Herstellern und wurden nicht von PromptQuorum gemessen; die Preise sind Listenpreise von den oben genannten Herstellerseiten. KI-Code-Review ist ein sich schnell entwickelnder Markt — prüfen Sie aktuelle Preise und Plattformunterstützung vor dem Kauf auf den Websites der Hersteller.