Points clés
- Quantification Q4_K_M : Llama 3.3 70B nécessite ~40 Go RAM ; Qwen3 72B nécessite ~43 Go RAM.
- Matériel neuf le moins cher : Mac mini M5 Pro (64 Go, 1 699 $, disponible le 22 sept. 2026) est l'option neuve la moins chère avec GPU complet pour 70B. Le Mac mini M6 de base (899 $) plafonne à 32 Go et ne peut pas exécuter un modèle 70B.
- Matériel grand public le plus facile : Mac Studio M2 Ultra (64 Go unifiée) ou MacBook Pro M5 Max 64 Go -- accélération GPU complète, pas de déchargement nécessaire.
- Option NVIDIA : RTX 4090 (24 Go VRAM) + 32 Go RAM système avec déchargement de couches dans Ollama. Environ 20-30 % des couches s'exécutent sur CPU.
- 70B sur CPU uniquement : possible sur 64 Go RAM, mais produit 1-3 tok/sec -- à peine utilisable pour les tâches batch, pas pour le chat interactif.
- Depuis août 2026, un modèle 70B local égale toujours la qualité de GPT-4 (2023) et reste le seul chemin grand public vers ce niveau sans coûts cloud.
📍 En une phrase
Exécuter un modèle 70B localement nécessite 40-48 Go de RAM en quantification Q4_K_M, réalisable sur des Mac Apple Silicon avec 64 Go de mémoire unifiée, des stations de travail avec 64 Go DDR5, ou un GPU NVIDIA 24 Go combiné à 32 Go de RAM système via déchargement de couches.
💬 En termes simples
Un modèle 70B est l'une des plus grandes tailles qu'on puisse réellement faire tourner chez soi, et il exige beaucoup de mémoire -- environ 40-48 Go. Le chemin le plus simple est un Mac avec assez de mémoire unifiée, puisqu'elle est partagée entre le CPU et le GPU. Sur un PC, il faut généralement une grosse carte graphique plus de la RAM système supplémentaire pour décharger les parties qui ne tiennent pas sur la carte.
Quel matériel peut réellement exécuter un modèle 70B ?
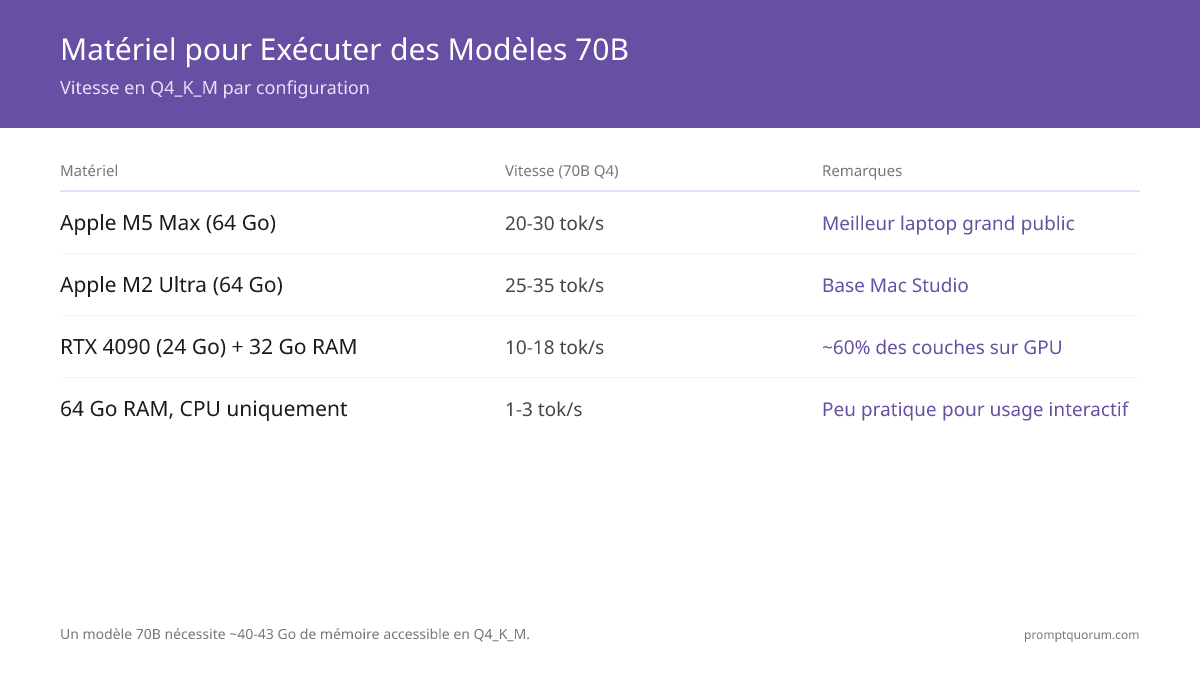
Un modèle 70B en quantification Q4_K_M nécessite environ 40-43 Go de mémoire accessible au moteur d'inférence. Cela peut provenir de VRAM GPU, de mémoire système unifiée (Apple Silicon), de RAM système, ou d'une combinaison via déchargement de couches.
Matériel | Peut exécuter 70B ? | Vitesse (70B Q4) | Notes |
|---|---|---|---|
| Apple M5 Max MacBook Pro (64 Go) | Oui -- GPU complet | 20-30 tok/sec | Meilleure option laptop grand public |
| Apple Mac Studio M5 Max (64 Go) | Oui -- GPU complet | 22-32 tok/sec | Nouveau août 2026, 2 499 $ |
| Apple Mac mini M5 Pro (64 Go) | Oui -- GPU complet | Pas encore de benchmarks | Nouveau, dispo 22 sept. 2026, 1 699 $ -- option neuve la moins chère |
| Apple Mac mini M6 (32 Go max.) | Non -- 32 Go max. | N/D | Nouveau, dispo 22 sept. 2026, 899 $ -- mémoire insuffisante pour 70B |
| Apple M2 Ultra (64 Go unifiée) | Oui -- GPU complet | 25-35 tok/sec | Configuration de base Mac Studio, occasion |
| Apple Mac Studio M5 Ultra (256Go+) | Oui -- GPU complet | 35-50 tok/sec | Nouveau août 2026, à partir de 5 499 $. Exécute Q8_0/FP16 avec marge. |
| NVIDIA DGX Spark (128 Go unifiée) | Oui -- GPU complet | 18-28 tok/sec | Q8_0 tient (70 Go). Idéal pour flux CUDA. |
| NVIDIA RTX 4090 (24 Go) + 32 Go RAM | Oui -- avec déchargement | 10-18 tok/sec | ~60% couches GPU, ~40% CPU |
| NVIDIA RTX 4080 (16 Go) + 32 Go RAM | Déchargement partiel uniquement | 5-10 tok/sec | Seulement ~35% couches GPU |
| 64 Go RAM, CPU uniquement | Oui -- CPU uniquement | 1-3 tok/sec | Impratique pour usage interactif |

Combien de RAM un modèle 70B nécessite-t-il à chaque niveau de quantification ?
Quantification | RAM requise | Qualité | Pratique ? |
|---|---|---|---|
| FP16 (précision complète) | ~140 Go | Qualité de référence | Non -- serveurs uniquement |
| Q8_0 | ~70 Go | Quasi-sans perte | Mac Ultra 192 Go uniquement |
| Q5_K_M | ~50 Go | Perte minimale | Mac Ultra 64 Go, serré |
| Q4_K_M | ~40-43 Go | Perte faible -- recommandé | Oui -- option la plus viable |
| Q3_K_S | ~30 Go | Perte modérée | Oui -- machines 32 Go possibles |
| Q2_K | ~22 Go | Perte élevée | Non recommandé |

Pourquoi Apple Silicon est-il la meilleure option grand public pour les modèles 70B ?
Apple Silicon utilise la mémoire unifiée -- le CPU et le GPU partagent le même pool mémoire physique. Un MacBook Pro M5 Max avec 64 Go de mémoire unifiée peut exécuter un modèle 70B en Q4_K_M entièrement sur GPU, atteignant 20-30 tok/sec sans surcharge de déchargement de couches.
Sur le matériel NVIDIA, le GPU et la RAM système sont séparés. Un GPU VRAM 24 Go ne peut contenir que ~60 % d'un modèle 70B Q4_K_M ; les couches restantes s'exécutent sur CPU, créant un goulot d'étranglement de bande passante mémoire qui réduit la vitesse à 10-18 tok/sec.
En août 2026, un Mac Studio M2 Ultra d'occasion (64 Go, ~2 000 euros) reste le chemin d'occasion le plus rentable vers une inférence 70B locale à vitesse utilisable. Apple a lancé une nouvelle gamme Mac Studio avec les puces M5 Max et M5 Ultra en août 2026 : le nouveau Mac Studio M5 Max (64 Go, 2 499 $) est une option neuve avec GPU complet, et le Mac Studio M5 Ultra (256 Go ou 512 Go, à partir de 5 499 $) double la bande passante mémoire unifiée à 1,2 To/s, exécutant les modèles 70B en Q8_0 ou FP16 sans compromis de qualité.
Apple a renouvelé le Mac mini le 25 août 2026, disponible le 22 septembre 2026, ce qui change à nouveau quelle est l'option neuve la moins chère. Le Mac mini M5 Pro (à partir de 1 699 $) atteint 64 Go de mémoire unifiée avec 307 Go/s de bande passante et Thunderbolt 5 -- suffisant pour exécuter un modèle 70B en Q4_K_M entièrement sur GPU, et 800 $ moins cher que le Mac Studio M5 Max. Le Mac mini M6 de base (à partir de 899 $) est une machine différente : il plafonne à 32 Go de mémoire unifiée et 170 Go/s de bande passante, bien en dessous des 40+ Go dont un modèle 70B a besoin, il ne peut donc exécuter un modèle 70B à aucun niveau de quantification. Aucun benchmark indépendant n'existe encore pour l'une ou l'autre puce -- toutes deux sont disponibles le 22 septembre 2026.
NVIDIA DGX Spark : option 128 Go de mémoire unifiée pour les modèles 70B
Le NVIDIA DGX Spark (4 699 $) est un ordinateur IA de bureau compact lancé en octobre 2025, construit sur le superpuce GB10 Grace Blackwell avec 128 Go de mémoire unifiée LPDDR5x. Son architecture à mémoire unifiée signifie que le GPU et le CPU partagent le même pool de 128 Go -- similaire à Apple Silicon mais avec accélération CUDA.
Avec 128 Go de mémoire unifiée, le DGX Spark exécute Llama 3.3 70B et Qwen3 72B en Q8_0 (70 Go -- qualité quasi sans perte). La vitesse d'inférence pour 70B en Q8_0 est d'environ 18-28 tok/sec.
NVIDIA a augmenté le prix du DGX Spark Founders Edition de 3 999 $ à 4 699 $ en février 2026, invoquant des contraintes d'approvisionnement en mémoire -- la même pénurie de DRAM qui a aussi poussé les prix des GPU RTX série 50 bien au-dessus du prix conseillé.
Spécification | Valeur |
|---|---|
| Mémoire | 128 Go unifiée LPDDR5x |
| 70B en Q8_0 | Oui -- qualité quasi sans perte |
| Vitesse d'inférence 70B | 18-28 tok/sec |
| Taille maximale du modèle | ~200B paramètres en FP4 |
| Prix | 4 699 $ (NVIDIA direct / Amazon) |
| Commande Ollama | ollama run llama3.3:70b |
Comment fonctionne le déchargement de couches NVIDIA GPU + pour les modèles 70B ?
Ollama et llama.cpp supportent la division d'un modèle entre VRAM GPU et RAM système. Les couches chargées en VRAM s'exécutent à la vitesse GPU ; les couches en RAM système s'exécutent à la vitesse CPU :
# Ollama décharge automatiquement autant de couches que possible en VRAM
# Pour contrôler explicitement les couches :
ollama run llama3.3:70b

# Vérifiez combien de couches sont sur GPU :
ollama ps
# Affiche : llama3.3:70b  ...  23/80 couches GPU

# Pour llama.cpp directement :
./llama-cli -m llama-3.3-70b-q4_k_m.gguf \
  -ngl 40   # nombre de couches à décharger sur GPU
  --ctx-size 4096
L'inférence 70B sur CPU uniquement est-elle pratique ?
Un modèle 70B en Q4_K_M sur un CPU multi-cœur (AMD Threadripper, Intel Xeon) avec 64 Go RAM produit 1-3 tokens/sec. À 2 tok/sec, une réponse de 200 mots prend environ 75 secondes.
C'est impratique pour le chat interactif mais utilisable pour le traitement batch -- résumé de documents, génération de rapports, ou traitement de fichiers de nuit. Pour un usage interactif, le matériel minimum pratique est une machine capable de 8+ tok/sec, ce qui nécessite soit Apple Silicon soit un déchargement GPU NVIDIA.
Quel modèle 70B devriez-vous exécuter localement ?
Modèle | MMLU | HumanEval | Meilleur pour |
|---|---|---|---|
| Llama 3.3 70B | 82 % | 88 % | Tâches anglais générales, suivi d'instructions |
| Qwen3 72B | 84 % | 87 % | Codage, multilingue (29 langues) |
| Mistral Large 123B | 84 % | 80 % | Nécessite 80+ Go -- stations de travail uniquement |
Exécuter des modèles 70B localement : contexte régional
UE / RGPD : un modèle 70B local représente le plafond pratique de qualité IA exécutable en privé. Pour les entreprises européennes traitant des données sensibles -- documents juridiques, dossiers médicaux, analyses financières -- un modèle 70B exécuté sur site offre une qualité GPT-4 2023 avec une conformité RGPD complète. Aucun contenu de prompt, contexte ou sortie ne quitte l'infrastructure de l'organisation.
Pour la conformité CNIL en France : le Mac Studio M2 Ultra (Apple, États-Unis) et le NVIDIA DGX Spark (NVIDIA, États-Unis) proviennent tous deux de fournisseurs hors UE. Pour les organisations exigeant du matériel de chaîne d'approvisionnement européenne, les partenaires OEM de NVIDIA (Dell, HP, Lenovo) produisent des systèmes GB10 compatibles DGX Spark avec support en Europe.
Choix de modèle pour la conformité UE : Mistral Large 123B (Mistral AI, France, Apache 2.0) est le seul modèle 70B+ développé par une entreprise européenne. Il nécessite plus de 80 Go de RAM (station de travail uniquement), mais offre le récit de conformité et de propriété intellectuelle le plus solide pour l'UE.
Quelles sont les erreurs courantes lors de l'exécution de modèles 70B sur matériel grand public ?
Acheter un GPU avec moins de 24 Go VRAM et s'attendre à une performance 70B complète
Un RTX 4070 Ti (12 Go VRAM) ne peut contenir que ~30 % d'un modèle 70B Q4_K_M en VRAM. Les 70 % restants s'exécutent sur CPU, résultant en 3-5 tok/sec -- à peine plus rapide que l'inférence CPU uniquement. Pour les modèles 70B, 24 Go VRAM (RTX 4090) est le minimum pratique pour une accélération GPU utile. En dessous, envisagez d'exécuter un modèle 34B à la place.
Ne pas utiliser le déchargement de couches dans Ollama
Par défaut, si un modèle 70B ne rentre pas entièrement en VRAM, Ollama bascule à l'inférence CPU uniquement. Définissez explicitement les couches GPU avec `OLLAMA_GPU_LAYERS=999` -- Ollama déchargera autant de couches que possible en VRAM et exécutera le reste sur CPU, ce qui est nettement plus rapide que l'inférence CPU-seul.
Utiliser Q4_K_M quand Q3_K_S conviendrait mieux au matériel disponible
Sur les machines avec 32-40 Go RAM, Q4_K_M pour un modèle 70B peut être trop serré (laissant une marge insuffisante pour l'OS). Q3_K_S réduit la RAM à ~30 Go avec une perte de qualité modérée. Exécutez `ollama ps` après avoir chargé le modèle -- si vous voyez l'usage swap, passez à Q3_K_S.
Acheter le Mac mini M6 de base en s'attendant à ce qu'il exécute un modèle 70B
Le Mac mini M6 (899 $) plafonne à 32 Go de mémoire unifiée -- bien en dessous des 40+ Go dont un modèle 70B a besoin en Q4_K_M. Il ne peut exécuter un modèle 70B à aucun niveau de quantification. Pour 70B sur un Mac mini, la version requise est le Mac mini M5 Pro (1 699 $, 64 Go de mémoire unifiée) -- vérifiez « M5 Pro » et 64 Go avant de commander, pas le M6 de base.
Questions fréquentes sur l'exécution de modèles 70B sur matériel grand public
Quel est le matériel le moins cher qui peut exécuter un modèle 70B de manière utilisable ?
Le Mac mini M5 Pro (1 699 $, 64 Go de mémoire unifiée, disponible le 22 septembre 2026) devrait devenir le matériel neuf le moins cher capable d'exécuter un modèle 70B, 800 $ de moins que l'ancienne option neuve la moins chère, le Mac Studio M5 Max (64 Go, 2 499 $). Un Mac Studio M2 Ultra d'occasion (64 Go mémoire unifiée) à ~2 000 euros reste le chemin d'occasion le moins cher avec des performances éprouvées de 25+ tok/sec. Aucun benchmark indépendant n'existe encore pour le Mac mini M5 Pro. Un assemblage de bureau NVIDIA RTX 4090 (24 Go VRAM + 32 Go RAM) coûte ~3 000-4 000 euros mais produit une inférence plus lente en raison du déchargement de couches. Ne confondez pas le Mac mini M5 Pro avec le Mac mini M6 de base (899 $) -- le M6 plafonne à 32 Go de mémoire unifiée et ne peut pas exécuter un modèle 70B.
Le Mac mini M6 peut-il exécuter un modèle 70B ?
Non. Le Mac mini M6 (à partir de 899 $) plafonne à 32 Go de mémoire unifiée et 170 Go/s de bande passante -- bien en dessous des 40+ Go qu'exige un modèle 70B en Q4_K_M. Pour 70B sur un Mac mini, commandez le Mac mini M5 Pro (à partir de 1 699 $, 64 Go de mémoire unifiée, 307 Go/s de bande passante, Thunderbolt 5). Les deux sont disponibles le 22 septembre 2026, et aucun benchmark indépendant n'existe encore pour l'une ou l'autre puce.
Puis-je exécuter un modèle 70B sur deux GPU ?
Oui -- llama.cpp et Ollama supportent l'inférence multi-GPU sur matériel NVIDIA. Deux RTX 4090 (48 Go VRAM total) rentrent entièrement dans VRAM un modèle 70B Q4_K_M. Ollama gère multi-GPU automatiquement quand plusieurs GPU sont présents. Le parallélisme de tenseur dans llama.cpp (`--tensor-split`) contrôle comment les couches sont distribuées.
Comment la qualité 70B locale se compare-t-elle à GPT-5.5 ?
Sur les benchmarks MMLU et HumanEval, Llama 3.3 70B (82 %, 88 %) et Qwen3 72B (84 %, 87 %) égalent ou dépassent légèrement les scores GPT-4 (2023). GPT-5.5 (2024) obtient des scores plus élevés sur les tâches lourdes en raisonnement. Pour le suivi d'instructions général, résumé et génération de code, les modèles 70B locaux sont compétitifs avec GPT-5.5 sur la plupart des tâches.
Ollama supporte-t-il l'exécution automatique de modèles 70B ?
Oui. Exécuter `ollama run llama3.3:70b` télécharge et exécute le modèle avec déchargement automatique de couches GPU. Ollama détecte la VRAM disponible et la RAM système, décharge autant de couches que possible en GPU, et exécute le reste sur CPU. Aucune configuration manuelle requise pour l'usage basique.
Combien d'électricité consomme l'exécution d'un modèle 70B ?
Un Mac Studio M2 Ultra exécutant l'inférence 70B consomme environ 30-50 W. Un ordinateur de bureau NVIDIA RTX 4090 sous charge consomme 350-450 W. À 0,15 euro par kWh, l'inférence 70B continue sur un RTX 4090 coûte environ 0,05-0,07 euro par heure. Apple Silicon est 7-10× plus économe en énergie pour cette charge de travail.
Les modèles 70B en valent-ils la peine par rapport aux modèles 13B pour les tâches quotidiennes ?
Pour le raisonnement complexe, l'analyse de documents longs et l'écriture nuancée, oui -- la différence de qualité est notable. Pour la résumé simple, les questions-réponses et la classification, un modèle 13B ou même 7B produit une sortie quasi-identique. Exécutez les deux sur votre cas d'usage spécifique avec PromptQuorum pour quantifier la différence de qualité avant d'investir dans du matériel 70B.
Quel est l'intérêt pour un utilisateur français ou belge d'exécuter 70B localement ?
Pour les entreprises et professionnels en France, Belgique ou Suisse, l'exécution de 70B localement offre : conformité RGPD complète (zéro données vers des serveurs tiers), coûts prévisibles (pas d'abonnements API), et confidentialité commerciale (vos documents restent locaux). Les agences créatives, cabinets d'avocats, banques et PME de la région DACH apprécient particulièrement cette garantie de données.
Combien de temps faut-il pour télécharger et configurer un modèle 70B ?
Avec Ollama sur une connexion ADSL/fibre standard (10-100 Mbps), le téléchargement prend 10-30 minutes. Une fois téléchargé, la première exécution initialise le GPU ou CPU en 5-10 secondes. Après cela, les appels API consécutifs ne nécessitent que du temps d'inférence (pas de rechargement). Pour une configuration robuste avec plusieurs modèles, allouez 1-2 heures au total.
Sources
- Documentation GPU Offloading llama.cpp -- github.com/ggerganov/llama.cpp/blob/master/docs/backend/CUDA.md
- Bibliothèque de modèles Ollama -- ollama.com/library/llama3.3
- Benchmarks d'inférence Apple M5 Max -- github.com/ggerganov/llama.cpp/discussions (fil de discussion benchmarks communautaires)
- Carte de modèle Meta Llama 3.3 -- huggingface.co/meta-llama/Llama-3.3-70B-Instruct