- Tous les puces M-series utilisent mémoire unifiée (GPU + CPU partagent le même pool RAM).
- Le M6 (Mac mini) et les M5 Pro/M5 Max/M5 Ultra (Mac mini et Mac Studio) sont les recommandations 2026 après le renouvellement Apple du 25/8/2026 ; M4 et plus ancien restent viables mais moins futurs-sécurisés.
- Metal est le framework de programmation GPU d'Apple ; intégré dans macOS, aucune bibliothèque externe requise.
- Le choix du framework (Ollama, MLX, llama.cpp) affecte la vitesse 0–25% mais ne change pas les modèles qui s'adaptent.
- Mac mini M6 (à partir de 899 $ avec 16 Go, jusqu'à 32 Go) est le point d'entrée le moins cher et quasi silencieux (Apple indique 5 dBA au repos).
- Coût d'électricité annuel estimé (indicatif, 24/7 à 0,15 $/kWh, non mesuré) : Mac mini M6 (~35 $) vs Desktop RTX 4090 (~400 $) — environ 10×.
Pourquoi Apple Silicon pour LLMs locaux ?
Apple Silicon excelle à l'inférence LLM locale pour une raison : mémoire unifiée. Quand vous achetez un Mac avec 64 GB RAM, environ 56 GB (64 GB moins les 8 GB dont macOS a besoin) sont disponibles pour le modèle LLM. Un GPU discret comme RTX 4090 a seulement 24 GB VRAM (séparé de votre RAM système) — les modèles plus grands que 24 GB ne rentrent simplement pas sans configurations multi-GPU complexes.
Cette différence architecturale unique est transformatrice :
- Mémoire unifiée : RAM disponible moins environ 8 GB pour macOS (16–512 GB au total selon la puce). RTX 4090 : VRAM discret uniquement (24 GB codé en dur).
- Accélération Metal : inférence GPU sans dépendance CUDA ni pilotes propriétaires.
- Efficacité énergétique : 20–100 W sous charge vs 300 W+ pour GPU de bureau. Permet opération sans ventilateur ou presque silencieuse.
- Silence : le MacBook Air est sans ventilateur ; Apple indique 5 dBA au repos pour le Mac mini.
- Pas de gestion de pilotes : Metal fonctionne prêt à l'emploi sur macOS. Pas de conflits version CUDA, pas mise à jour pilotes NVIDIA.
- Coût matériel : Mac mini M5 Pro (à partir de 1 699 $) avec 64 Go vs configuration dual-GPU (4 000 $+) pour capacité modèle équivalente.
Puces Apple Silicon pour LLMs — Comparaison complète
Puce | Mémoire max. | Bande passante | Cœurs GPU | Optimum LLM | Publié |
|---|---|---|---|---|---|
| M1 | 16 GB | 68 GB/s | 8 | 7B Q4 | Nov 2020 |
| M1 Pro | 32 GB | 200 GB/s | 16 | 13B Q4 | Oct 2021 |
| M1 Max | 64 GB | 400 GB/s | 32 | 32B Q4 | Oct 2021 |
| M1 Ultra | 128 GB | 800 GB/s | 64 | 70B Q4 | Mar 2022 |
| M2 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | Jun 2022 |
| M2 Pro | 32 GB | 200 GB/s | 19 | 13B Q4 | Jan 2023 |
| M2 Max | 96 GB | 400 GB/s | 38 | 34–70B Q4 | Jan 2023 |
| M2 Ultra | 192 GB | 800 GB/s | 76 | 70B+ Q4 | Jun 2023 |
| M3 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | Oct 2023 |
| M3 Pro | 36 GB | 150 GB/s | 18 | 13–32B Q4 | Oct 2023 |
| M3 Max | 128 GB | 400 GB/s | 40 | 70B Q4 | Oct 2023 |
| M4 | 32 GB | 120 GB/s | 10 | 13B Q4 | May 2024 |
| M4 Pro | 48 GB | 273 GB/s | 20 | 32B Q4 | Oct 2024 |
| M4 Max | 128 GB | 546 GB/s | 40 | 70B Q4 | Oct 2024 |
| M5 (base) | 32 GB | ~150 GB/s | 10 | 13B Q4 | Oct 2025 |
| M6 (Mac mini) | 32 GB | Jusqu'à 170 GB/s | 12 | 13B Q4 | Août 2026 |
| M5 Pro | 64 GB | 307 GB/s | Jusqu'à 20 | 32B Q5 | Août 2026 |
| M5 Max | 128 GB | 460–614 GB/s | 32–40 | 70B Q5 | Août 2026 |
| M5 Ultra | 512 GB | 1.2 TB/s | Jusqu'à 80 | 120B+ Q4 / 70B FP16 | Août 2026 |
Le M5 Pro a débuté sur MacBook Pro (mars 2026) ; le renouvellement du 25/8/2026 l'a apporté au Mac mini aux côtés du tout nouveau M6. M5 Max et M5 Ultra sont nouveaux sur Mac Studio depuis le 25/8/2026. Les quatre sont en vente depuis le 22/9/2026 ; la configuration M5 Ultra 512 Go est commandable depuis le 28/10/2026. Les chiffres M6, M5 Pro, M5 Max et M5 Ultra proviennent des caractéristiques Apple du Mac mini et du Mac Studio.
Renouvellement d'août 2026 : Mac mini M6/M5 Pro, Mac Studio M5 Max/M5 Ultra
Apple a annoncé un renouvellement du Mac mini et du Mac Studio le 25 août 2026. Les deux machines sont en vente depuis le 22 septembre 2026, et la configuration M5 Ultra 512 Go est commandable depuis le 28 octobre 2026. Les affirmations de performance d'Apple sont signalées comme telles ; les résultats indépendants sont cités avec leur source.
- Mac mini M6 : à partir de 899 $ (799 $ éducation) avec 16 Go, configurable jusqu'à 32 Go. CPU 12 cœurs, GPU 12 cœurs, bande passante mémoire jusqu'à 170 GB/s. Apple annonce un CPU 40 % plus rapide et jusqu'à 4x plus de performance IA que le Mac mini M4 — chiffres d'Apple, non vérifiés de manière indépendante.
- Mac mini M5 Pro : à partir de 1 699 $. Jusqu'à 18 cœurs CPU, jusqu'à 20 cœurs GPU, 307 GB/s, jusqu'à 64 Go de mémoire unifiée.
- Mac Studio M5 Max : à partir de 2 499 $. CPU 18 cœurs, GPU 32 ou 40 cœurs, jusqu'à 128 Go de mémoire unifiée, 460–614 GB/s selon la configuration.
- Mac Studio M5 Ultra : à partir de 5 499 $ (5 099 $ éducation), 96 Go de mémoire unifiée de base, 256 Go et 512 Go en option sur commande. Jusqu'à 36 cœurs CPU, jusqu'à 80 cœurs GPU, 1.2 TB/s de bande passante. L'option 512 Go exige le modèle CPU 36 cœurs / GPU 80 cœurs, est commandable depuis le 28 octobre 2026 et porte la configuration minimale 512 Go à 22 299 $.
- Le Mac Studio prend en charge le clustering Thunderbolt 5 avec RDMA ; Apple annonce jusqu'à 3x plus de performance en inférence IA distribuée par rapport à une seule machine — chiffre d'Apple, non vérifié de manière indépendante.
- Premiers résultats indépendants du M5 Ultra (BGR, 21 septembre 2026 ; modèle 256 Go, LM Studio, MLX 4 bits) : environ 55 tok/s sur Qwen 3.8 27B contre environ 40 sur un M3 Ultra, et environ 80 contre 60 tok/s sur Qwen 3.5 122B A10B. BGR indique une performance moyenne supérieure de 30–40 % au M3 Ultra dans ses tests ; la longueur de contexte et le nombre d'exécutions ne sont pas précisés.
- Le Mac mini M4/M4 Pro et le Mac Studio M4 Max/M3 Ultra sont désormais la génération précédente.
- Les 512 Go du M5 Ultra sont la configuration maximale ; c'est ce qui permet d'exécuter localement des modèles de 120B+ paramètres sur un seul Mac grand public.
La bande passante mémoire est plus importante que la taille mémoire
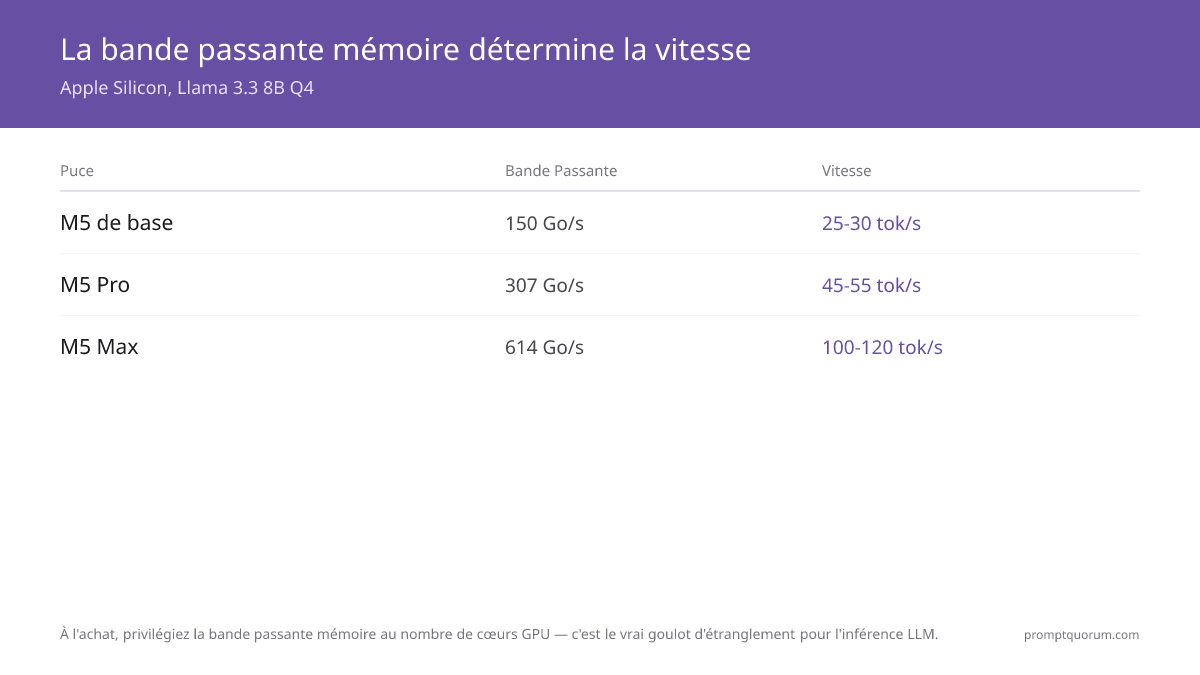
L'inférence LLM est limitée bande passante, pas calcul-limitée. Cela signifie que la vitesse génération token met à l'échelle linéairement avec bande passante, pas cœurs GPU.
M5 Max à 614 GB/s vs RTX 4090 à 1 008 GB/s semble que NVIDIA gagne sur bande brute. Mais utilisateurs Apple Silicon peuvent utiliser l'essentiel de la mémoire (le total moins environ 8 Go pour macOS, jusqu'à la limite de mémoire GPU par défaut de macOS, qui peut être relevée), donc peuvent charger modèles plus grands qu'NVIDIA ne peut pas adapter à 24GB.
- M5 base (150 GB/s) → ~25–30 tok/s (estimation) Llama 3.1 8B Q4
- Mac mini M6 (jusqu'à 170 GB/s) → plage similaire au M5 base, légèrement supérieure grâce à la bande passante accrue. Apple ne publie que des affirmations relatives (jusqu'à 4x de performance IA par rapport au Mac mini M4) et nous n'avons pas vérifié de chiffres tok/s indépendants pour le M6.
- M5 Pro (307 GB/s) → ~45–55 tok/s (estimation) Llama 3.1 8B Q4 (2× M5 base cause 2× bande passante)
- M5 Max (614 GB/s) → ~100–120 tok/s (estimation) Llama 3.1 8B Q4
- M5 Ultra (1.2 TB/s, spécification Apple) → BGR a mesuré environ 55 tok/s sur un Qwen 3.8 27B en 4 bits contre environ 40 sur un M3 Ultra (environ 819 GB/s). Soit environ 1,4× de vitesse de génération pour environ 1,5× de bande passante — cohérent avec une inférence limitée par la bande passante.
- Leçon : priorisez bande passante sur cœurs GPU lors de l'achat.

Efficacité énergétique et thermalique — l'avantage silencieux
Configuration | Puissance (ralenti) | Puissance (LLM) | Bruit | Chaleur |
|---|---|---|---|---|
| Mac mini M6 | 5W | 25–35W | Quasi silencieux (5 dBA au repos) | Tiède |
| MacBook Air M5 | 3W | 20–30W | Silencieux (sans ventilateur) | Tiède |
| Mac mini M5 Pro | 5W | 40–60W | Calme (ventilateur rare) | Frais |
| Mac Studio M5 Max | 10W | 60–100W | Calme | Frais |
| Mac Studio M5 Ultra | 10W | Max 480W en continu (Apple) | Calme | Frais |
| Desktop RTX 4090 | 50W | 350–450W | Bruit de ventilateurs audible sous charge | Chaud |
| Desktop RTX 3060 | 30W | 170–200W | Modéré | Tiède |
Coût d'électricité annuel estimé à 0,15$/kWh pour un serveur IA 24/7 (indicatif, non mesuré ; le coût réel dépend de l'usage) : Mac mini M6 (~35$/an) vs Desktop RTX 4090 (~400$/an). Les consommations au repos et en charge sont des estimations de PromptQuorum, pas des mesures ni des caractéristiques Apple ; Apple indique une puissance continue maximale de 155W pour le Mac mini et 480W pour le Mac Studio.

Scénarios utilisateurs réels sur Apple Silicon
- 1Agent de codage
Why it matters: Llama 3.1 8B sur M5 Pro livre 45–55 tok/s (estimation); la latence de complétion de code dépend de la taille du modèle et des réglages (non mesurée par PromptQuorum). Fonctionne silencieusement en arrière-plan sur MacBook Pro. - 2Pipeline RAG
Why it matters: Modèle embedding + Llama 3.1 8B + ChromaDB rentre entièrement mémoire unifiée 36GB M5 Pro. Aucune limite GPU. - 3Assistant vocal
Why it matters: Whisper Metal + Ollama Llama + Piper TTS : la latence dépend de la taille des modèles et des réglages ; PromptQuorum ne l'a pas mesurée sur M5 Pro. Mac mini silencieux, adapté à un setup always-on. - 4Multimodal
Why it matters: Whisper + LLaVA 7B vision + Llama 3.1 8B reasoning = tout rentre 36GB, traitement simultané. - 5Écriture privée
Why it matters: Llama 3.3 70B Q5 sur M5 Max 128GB = haute qualité pour la rédaction longue, fonctionne hors ligne une fois le modèle téléchargé, aucun coût d'API par token, et vos prompts restent sur l'appareil pendant l'inférence. Sur le nouveau Mac Studio M5 Ultra (jusqu'à 512GB), les modèles 120B+ deviennent possibles si vous voulez plus de marge.
Quel Mac acheter ?
- À partir de 899 $ : Mac mini M6 (16 GB, jusqu'à 32 GB moyennant supplément) → modèles 7–13B, jusqu'à 170 GB/s, en vente depuis le 22/9/2026
- 1 699$ : Mac mini M5 Pro (64GB) → jusqu'à 32B modèles à 15–20 tok/s (estimation)
- 1 500–2 500€ : MacBook Pro M5 Pro (64GB) → station travail IA portable, même perf Mac mini
- 2 499$ : Mac Studio M5 Max (128GB) → modèles 70B à 12–18 tok/s (estimation), serveur always-on
- De 5 499 $ (96 GB) à 22 299 $ et plus (512 GB) : Mac Studio M5 Ultra → l'un des rares Macs grand public pour modèles 120B+ ; configuration 512 Go commandable depuis le 28/10/2026
- Critique : la mémoire est fixée à l'achat et ne peut pas être mise à niveau, achetez donc la plus grande configuration compatible avec votre budget et vos modèles. L'option 512 Go du M5 Ultra ajoute à elle seule 15 500 $ (MacRumors). Prix catalogue américains ; les prix en France peuvent différer.
Premiers pas : aperçu du framework
- Ollama : setup le plus simple, détection Metal automatique, aucune config. API REST incluse. Meilleur pour débutants.
- MLX : framework Apple natif, souvent plus rapide qu'Ollama dans les tests de la communauté, intégration Python, support fine-tuning LoRA. Courbe apprentissage plus raide.
- llama.cpp : multiplateforme C++, plus large support format modèle (GGUF), backend Metal. Meilleur pour intégration applications plus grandes.
Qu'a annoncé Apple pour Mac mini et Mac Studio le 25 août 2026 ?
Apple a renouvelé le Mac mini avec la nouvelle puce M6 (899 $ avec 16 Go, configurable jusqu'à 32 Go) et le M5 Pro (1 699 $, jusqu'à 64 Go), et renouvelé le Mac Studio avec le M5 Max (2 499 $, jusqu'à 128 Go) et le M5 Ultra (5 499 $ avec 96 Go, jusqu'à 512 Go). Tous sont en vente depuis le 22 septembre 2026 ; la configuration M5 Ultra 512 Go est commandable depuis le 28 octobre 2026, à partir de 22 299 $.
M5 Pro ou M5 Max est meilleur pour LLMs locaux ?
M5 Pro (64GB) offre meilleur rapport qualité-prix — exécute 32B modèles bien et coûte à partir de 1 699$. M5 Max (à partir de 2 499$) nécessaire uniquement si vous besoin régulier modèles 70B. M5 Pro (64GB) offre un très bon rapport qualité-prix pour la plupart des cas d'usage de classe 32B couverts dans ce guide ; M5 Max vaut le coup si vous avez régulièrement besoin de modèles 70B.
Puis-je upgrader mémoire après achat Mac ?
Non. Mémoire Apple Silicon est soudée, non-upgradable. Achetez mémoire maximum vous pouvez vous permettre à achat.
Quelles obligations conformité françaises dois-je considérer ?
Si vous traitez des données sensibles, consultez les recommandations de la CNIL sur l'IA. Les LLMs locaux sur Apple Silicon peuvent éviter certains transferts de données vers des tiers et faciliter la mise en conformité ; celle-ci dépend toutefois de votre cas d'usage et ne constitue pas un conseil juridique.
M5 Pro peut concurrencer RTX 4090 ?
Sur les modèles qui tiennent dans 24GB de VRAM, la RTX 4090 est généralement plus rapide ; l'écart varie selon le modèle et la quantification, et PromptQuorum ne l'a pas mesuré. Un modèle 70B ne tient pas entièrement dans les 24GB d'une RTX 4090 (le déport partiel vers le CPU est possible mais bien plus lent), alors qu'un M5 Pro de 64GB peut le contenir en quantification 4 bits.
Le M5 Ultra avec jusqu'à 512 Go change-t-il quelque chose ?
Oui. Le M5 Ultra (Mac Studio, à partir de 5 499 $ avec 96 Go, 1.2 TB/s de bande passante, jusqu'à 512 Go à partir de 22 299 $) exécute les modèles 70B en FP16 (non quantifié, sans perte due à la quantification) et permet les modèles 120B+ sur un seul Mac grand public (configuration 512 Go). Le premier test indépendant que nous avons vérifié (BGR, 21 septembre 2026, modèle 256 Go) a mesuré environ 55 tok/s sur un Qwen 3.8 27B en 4 bits contre environ 40 sur un M3 Ultra. PromptQuorum n'a pas réalisé ses propres benchmarks du M5 Ultra.
Ai-je besoin d'Ollama, MLX ou llama.cpp ?
Commencez avec Ollama (le plus simple). Si vous avez besoin d'une inférence plus rapide ou de fine-tuning, passez à MLX. Pour une compatibilité multiplateforme, utilisez llama.cpp. Les trois fonctionnent sur Apple Silicon.
Apple Silicon vaut-il le coup pour les LLMs locaux en 2026 ?
Oui, surtout pour les modèles 32B+. Apple Silicon est l'une des rares options grand public qui exécutent les modèles 70B sans configuration multi-GPU complexe, et le Mac Studio M5 Ultra est l'un des rares qui accueillent des modèles 120B+. Pour les modèles 8B qui tiennent dans la VRAM NVIDIA, la RTX 4090 est plus rapide mais coûte plus cher à exploiter.
Un MacBook Air M5 peut-il faire tourner des LLMs locaux ?
Oui, avec des limites. Un MacBook Air M5 exécute les modèles 7–8B avec 16 Go (environ 8 Go restent après macOS) et jusqu'à 13B avec 24–32 Go. Ce design sans ventilateur peut subir un throttling thermique sous charge soutenue. Pour un usage occasionnel : parfait. Pour de l'inférence permanente : un Mac mini M5 Pro est plus adapté.
Quelles performances attendre de l'Apple M6 pour les LLMs locaux ?
Apple n'a publié que des affirmations relatives : jusqu'à 4x de performance IA et un CPU 40 % plus rapide que le Mac mini M4. Lors du renouvellement d'août 2026, le M6 n'a débuté que dans le Mac mini (899 $ avec 16 Go, jusqu'à 32 Go, jusqu'à 170 GB/s). La vitesse de génération suivant la bande passante mémoire, attendez-vous à un niveau proche du M5 de base plutôt que du M5 Pro ; nous n'avons pas encore vérifié de chiffres tok/s indépendants pour le M6.
Quelle configuration LLM locale pour un Mac M1 avec 32 Go ?
Un M1 Pro ou M1 Max avec 32 Go (200 GB/s et 400 GB/s) exécute confortablement les modèles 13B en Q4, soit l'optimum du tableau des puces ci-dessus ; un M1 Max 64 Go atteint le 32B en Q4. Le M1 d'origine plafonne à 16 Go : restez sur du 7B Q4.
Comment le M3 Ultra se compare-t-il au M5 Max pour les LLMs locaux ?
Un M3 Ultra dépasse un M5 Max en capacité mémoire (jusqu'à 512 Go contre 128 Go), ce qui lui permet d'accueillir les plus gros modèles. Côté vitesse, BGR a indiqué qu'un MacBook Pro M5 Max avait des performances proches d'un Mac Studio M3 Ultra sur son test 27B, et que le M5 Ultra était en moyenne 30–40 % meilleur que le M3 Ultra. Un M5 Pro 48 Go se situe en dessous des deux et reste l'optimum pour qui veut de la marge sans tarif Ultra.
Méthodologie des benchmarks et fraîcheur
- Les chiffres M5 Pro/Max pour les configurations MacBook Pro reposent sur des benchmarks communautaires de mars à mai 2026
- M5 Ultra : des résultats indépendants existent (BGR, 21 septembre 2026, modèle 256 Go — voir la section sur le renouvellement d'août 2026). Les chiffres tok/s du M6 et des M5 Pro/M5 Max des Mac mini/Mac Studio sont des estimations fondées sur la bande passante ou des résultats communautaires ; les affirmations de performance d'Apple sont signalées comme telles.
- Dernière vérification : 2026-11-02
- Les performances progressent avec les mises à jour des frameworks (Ollama, MLX, llama.cpp publient chaque mois)
- Cet article est revu chaque trimestre et ajoutera des résultats indépendants pour le M6 et le Mac Studio M5 Max une fois vérifiés