Points clés rapides
- Meilleur raisonnement : Llama 3.1 8B — 82 % benchmark MATH, 73 % HumanEval
- Meilleur suivi d'instructions : Mistral Small — 92 % sur les benchmarks d'instructions
- Meilleur multilingue : Qwen3 8B — 27 langues dont le chinois, le japonais et l'arabe
- VRAM requis : 8 Go pour les trois modèles principaux (quantification Q4)
- Vitesse : ~15 tokens/sec sur RTX 3060 12 Go pour les trois
- Choix budget : Phi 2.7B — 4 Go VRAM, 20 tokens/sec, anglais uniquement
Points clés
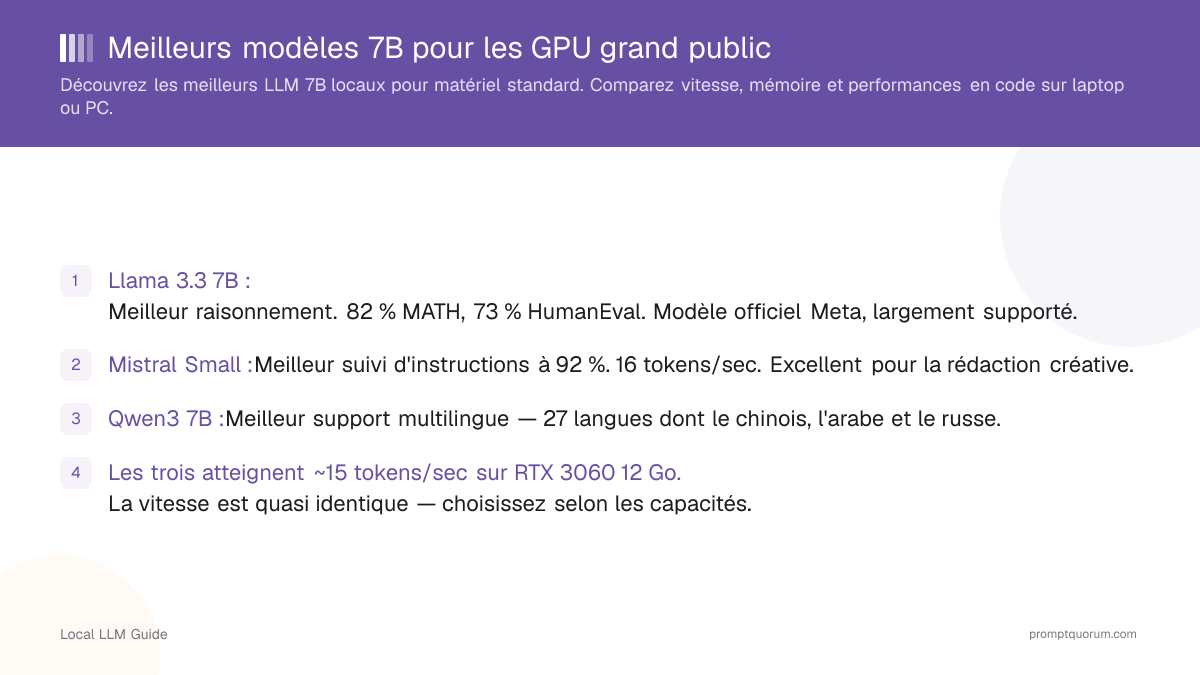
- Llama 3.1 8B : Meilleur raisonnement. 82 % MATH, 73 % HumanEval. Modèle officiel Meta, largement supporté.
- Mistral Small : Meilleur suivi d'instructions à 92 %. 16 tokens/sec. Excellent pour la rédaction créative.
- Qwen3 8B : Meilleur support multilingue — 27 langues dont le chinois, l'arabe et le russe.
- Les trois atteignent ~15 tokens/sec sur RTX 3060 12 Go. La vitesse est quasi identique — choisissez selon les capacités.
- Raisonnement (maths, logique) : Llama 3.1 8B (82 %) > Qwen3 (79 %) > Mistral (75 %).
- Rédaction créative : Mistral > Llama 3.1 8B > Qwen3.
- Code : Llama 3.1 8B > Qwen3 > Mistral.
📍 En une phrase
Pour les GPU grand public avec 8-12 Go de VRAM, Llama 3.1 8B domine en raisonnement (82% MATH), Mistral Small domine dans le suivi des instructions (92%) et Qwen3 8B domine côté multilingue (27 langues), les trois tournant à une vitesse similaire (~15 tok/s sur une RTX 3060 12 Go).
💬 En termes simples
Ces trois modèles d'IA gratuits sont les meilleurs choix si votre carte graphique dispose de 8 à 12 Go de mémoire. Ils tournent à une vitesse similaire, donc la vraie question est ce dont vous avez besoin : Llama 3.1 8B pour les maths et la logique, Mistral Small pour l'écriture et le suivi d'instructions, ou Qwen3 8B si vous avez besoin d'un bon support pour des langues autres que l'anglais.
Quel modèle 7B offre les meilleures performances ?
Métrique | Llama 3.1 8B | Mistral Small | Qwen3 8B | Phi 2.7B |
|---|---|---|---|---|
| VRAM requis | 8 Go | 8 Go | ~6 Go | 4 Go |
| Tokens/sec (RTX 3060) | 15 | 16 | 15 | 20 |
| Raisonnement (MATH) | 82 % | 75 % | 79 % | 45 % |
| Code (HumanEval) | 73 % | 60 % | 64 % | 48 % |
| Suivi d'instructions | 85 % | 92 % | 84 % | 55 % |
| Multilingue | Bon | Limité | Excellent | Anglais uniquement |
| Licence | Ouvert (Meta) | Apache 2.0 | Ouvert (Alibaba) | MIT |

Comment Llama 3.1 8B, Mistral et Qwen3 se comparent-ils directement ?
Llama 3.1 8B excelle en raisonnement structuré, Mistral Small en narration créative, et Qwen3 8B en réponses multilingues concises.
Exemple : problème de mathématiques « Si un train parcourt 100 km en 2 heures, quelle est sa vitesse ? »
- Llama 3.1 8B : « Vitesse = distance / temps = 100 km / 2 h = 50 km/h. » Montre le raisonnement — utile pour le débogage.
- Mistral : « 100 km en 2 heures donne 50 km/h. » Concis et correct.
- Qwen3 : « Le train parcourt 100 km en 2 heures, donc vitesse = 50 km/h. » Structuré et correct.
Les trois donnent des réponses correctes ; Llama 3.1 8B détaille les étapes — utile pour les tâches de code et d'analyse.
Exemple : prompt créatif « Écrivez une courte histoire de science-fiction sur l'IA. »
- Mistral : Récit riche et captivant, 300+ mots. Le plus fort pour la création.
- Llama 3.1 8B : Bonne histoire, ton légèrement plus formel. Mieux pour les documents structurés.
- Qwen3 : Bonne histoire, légèrement plus courte. Qualité constante entre les langues.
Quel modèle 7B convient le mieux au raisonnement et au code ?
Llama 3.1 8B domine le raisonnement 7B à 82 % MATH ; Qwen3 8B obtient 79 %, Mistral Small 75 %. L'écart de 9 points entre Llama 3.1 8B et Mistral est significatif pour le code et les mathématiques.
Les trois modèles 7B peinent sur le raisonnement multi-étapes comparés aux modèles 13B+ — consultez le guide des meilleurs LLM locaux pour le code pour la comparaison des modèles plus grands.
Mistral Small est plus faible en maths (75 %) mais excellent pour suivre des instructions complexes en plusieurs parties.
Qwen3 8B offre un bon équilibre (~79 % maths, 84 % suivi d'instructions) — un modèle polyvalent solide pour les charges de travail mixtes.
Pour les entretiens de code et la génération de code : Llama 3.1 8B > Qwen3 > Mistral.
Pour les chatbots et les applications d'assistance : Mistral > Llama 3.1 8B > Qwen3.

Quel modèle 7B supporte le plus de langues ?
Qwen3 8B supporte 27 langues — le leader multilingue incontesté de la classe 7B. Llama 3.1 8B dispose de solides capacités multilingues ; Mistral Small est principalement optimisé pour l'anglais.
- Qwen3 8B (Alibaba) : 27 langues dont le chinois (mandarin/cantonais), le japonais, le coréen, l'arabe et le russe. Entraîné sur 7 000 milliards de tokens avec un accent multilingue.
- Llama 3.1 8B (Meta) : Bon pour les langues d'Europe occidentale. Plus faible sur les langues CJK (chinois/japonais/coréen) comparé à Qwen3.
- Mistral Small : Principalement en anglais. Français/allemand/espagnol acceptables, mais à éviter pour les tâches en langues asiatiques ou arabes.
- Anglais uniquement (à éviter pour le multilingue) : Phi 2.7B, Stablelm 3B.
- Variante spécialisée code : Qwen3-Coder 7B surpasse les modèles généraux 7B sur la complétion de code. Voir meilleurs LLM locaux pour le code.
- Fine-tunes de domaine : Médecine ? Utilisez BioLlama. Droit ? Utilisez des variantes ajustées sur Legalbench.
Quelles sont les meilleures alternatives budget sous 4 Go de VRAM ?
Si vous avez 8 Go de VRAM, utilisez un modèle 7B — ne régressez pas vers Phi 2.7B ou TinyLlama sauf si 4 Go est votre limite absolue.
Phi 2.7B (Microsoft) : 4 Go de VRAM, 20 tokens/sec. Étonnamment capable pour 2.7B — 45 % MATH, 55 % suivi d'instructions. Limites : anglais uniquement, raisonnement faible. Pour les compromis de quantification, voir le comparatif Q4 vs Q8.
Stablelm 3B : À éviter. Raisonnement et suivi d'instructions faibles (~50 %). Aucun avantage sur Phi 2.7B.
TinyLlama 1.1B : Ultra-compact et rapide. Acceptable uniquement pour la classification simple ou l'extraction de mots-clés.
Verdict : Choisissez toujours un modèle 7B (Llama 3.1 8B, Mistral ou Qwen3) plutôt qu'un 2.7B si 8 Go de VRAM sont disponibles. L'écart de qualité est substantiel.
Considérations régionales
Utilisateurs européens (RGPD) : Faire tourner Llama 3.1 8B ou Mistral Small localement signifie zéro exfiltration de données — l'inférence reste sur votre machine. Cela satisfait l'article 5(1)(f) du RGPD sur l'intégrité des données sans accords de traitement avec les fournisseurs. La CNIL recommande l'IA locale pour le traitement de données professionnelles sensibles (financières, médicales, juridiques) afin de garantir la maîtrise du traitement.
Utilisateurs de langues asiatiques : Qwen3 8B est le choix évident. Alibaba l'a entraîné sur 7 000 milliards de tokens dans 27 langues avec d'excellentes performances en chinois, japonais et coréen.
Licences entreprise : Mistral Small utilise Apache 2.0 — usage commercial illimité. Llama 3.1 8B utilise la licence commerciale de Meta, qui nécessite un accord pour les déploiements dépassant 700 millions d'utilisateurs actifs mensuels.
Erreurs fréquentes lors du choix d'un modèle 7B
- 1Considérer tous les modèles 7B comme identiques — Llama 3.1 8B obtient 82 % au benchmark MATH contre 75 % pour Mistral. Un écart de 9 points est significatif pour le code et le raisonnement.
- 2Traiter Phi 2.7B comme équivalent à un 7B — Phi 2.7B atteint environ 60 % de la précision des modèles 7B sur la plupart des benchmarks. Il tient en 4 Go de VRAM, mais le compromis qualité est réel.
- 3Utiliser la quantification Q2 pour faire tourner plusieurs modèles 7B simultanément — Q2 réduit la qualité de ~30 %. Mieux vaut exécuter un seul 7B en Q4 que deux en Q2.
Questions fréquemment posées
Quel modèle 7B dois-je choisir ?
Utilisez Llama 3.1 8B pour le code, les mathématiques et les tâches analytiques — il obtient 82 % au benchmark MATH et 73 % à HumanEval. Utilisez Mistral Small pour la rédaction créative, le chat et le suivi d'instructions — il obtient 92 % aux benchmarks d'instructions. Utilisez Qwen3 8B pour le support multilingue en chinois, japonais, allemand ou arabe.
Puis-je exécuter deux modèles 7B sur 16 Go de VRAM ?
Oui. Ollama prend en charge le chargement séquentiel de plusieurs modèles. Avec 16 Go de VRAM, vous pouvez exécuter deux modèles 7B en quantification Q4, chacun nécessitant ~4.5 Go. Chaque modèle tourne à ~15 tokens/sec indépendamment — ils ne fonctionnent pas en parallèle.
Faut-il rester sur Llama 3.1 8B ou passer à un 13B ?
Pour le code et le raisonnement, passer à Qwen3 14B (ou Qwen3-Coder 14B) apporte 10–15 % de précision et nécessite 16 Go de VRAM. Pour le chat et la rédaction créative, Llama 3.1 8B ou Mistral Small avec 8 Go suffit — l'écart est négligeable pour les tâches conversationnelles.
Quel modèle 7B a la plus longue fenêtre de contexte ?
En avril 2026, Llama 3.1 8B, Mistral Small et Qwen3 8B supportent tous 8K tokens dans les builds Q4 standard. Pour des contextes plus longs (32K+), il faut des modèles plus grands — Qwen3 72B supporte 128K tokens mais nécessite 40 Go+ de VRAM.
Existe-t-il un modèle 7B meilleur que Llama 3.1 8B, Mistral et Qwen3 ?
En avril 2026, ces trois représentent la frontière de la classe 7B. Chacun mène dans une catégorie : Llama 3.1 8B en raisonnement (82 % MATH), Mistral en suivi d'instructions (92 %), Qwen3 en multilingue (27 langues). Des variantes comme Qwen3-Coder 7B surpassent les modèles généraux sur le code.
Quel modèle 7B choisir selon mon cas d'usage ?
Utilisez Llama 3.1 8B pour le code, les mathématiques et les tâches analytiques — il obtient 82 % au benchmark MATH et 73 % à HumanEval. Utilisez Mistral Small pour la rédaction créative, le chat et le suivi d'instructions — il obtient 92 % aux benchmarks d'instructions. Utilisez Qwen3 8B si vous avez besoin d'un support multilingue en chinois, japonais, allemand ou arabe.
Sources
- Llama 3.1 8B Model Card — Benchmarks MATH, HumanEval et MTBench (Meta AI, 2024)
- Mistral Small Technical Report — Évaluation du suivi d'instructions et du raisonnement (Mistral AI, 2023)
- Documentation Qwen3 — Support multilingue et résultats des benchmarks (Alibaba Cloud, 2024)
- Open LLM Leaderboard — Classements en direct des modèles 7B sur MATH, HumanEval et les tâches d'instructions (HuggingFace)