Démarrage rapide : Lancez votre premier LLM local en 3 minutes
1. Installer Ollama (1 minute)
Téléchargez depuis ollama.com et lancez l'installeur. Aucune configuration requise.
2. Lancez Llama 3.2 3B (2 minutes)
Ouvrez votre terminal et exécutez : `ollama run llama3.2:3b`
Ollama télécharge le modèle (~2 Go) lors de la première exécution. C'est le modèle recommandé pour la plupart des utilisateurs.
3. Commencez à discuter (immédiat)
Une fois le modèle chargé, tapez votre question ou demande et appuyez sur Entrée. Vous verrez des réponses à 25–45 tokens/seconde sur un laptop typique.
C'est tout. Aucune configuration manuelle, aucun GPU requis. Si vous avez 8 Go+ RAM, vous êtes prêt. Si vous avez 4–6 Go, utilisez `ollama run gemma4:e2b` à la place (plus rapide, utilise 1,7 Go RAM).
Liste de vérification pour débutant : Local est-il le bon choix pour vous ?
Avant de télécharger votre premier modèle, répondez à ces trois questions :
1. Avez-vous 8 Go de RAM ou plus ? (Sinon, les APIs cloud sont plus rapides pour débuter.)
2. Avez-vous besoin que vos données restent privées ? (Sinon, les APIs cloud offrent meilleure qualité.)
3. Pouvez-vous tolérer 20–40 minutes de configuration ? (Sinon, les APIs cloud sont prêtes en 5 minutes.)
Si vous avez répondu « non » à deux questions ou plus, lisez la comparaison complète local vs cloud pour déterminer si une API cloud convient mieux à vos contraintes matérielles et à votre calendrier. Les débutants supposent souvent que les LLMs locaux sont toujours meilleur — ce n'est pas vrai. Le bon choix dépend de vos contraintes spécifiques.
Comment choisir un modèle LLM local pour débutant ?
Le choix d'un modèle LLM local dépend de trois contraintes : RAM disponible, vitesse d'inférence et type de tâche — dans cet ordre de priorité.
Le nombre de paramètres (3B, 7B, 13B) est le principal facteur du besoin en RAM. Avec la quantification 4 bits — standard pour la plupart des outils d'inférence locale — multipliez le nombre de paramètres par ~0.5 pour estimer les Go de RAM nécessaires. Un modèle 7B en Q4_K_M requiert environ 4.5 Go de RAM.
Pour la plupart des débutants, les modèles 7B en quantification Q4_K_M offrent le meilleur équilibre qualité/vitesse/RAM sur les machines disposant de 8 Go ou plus. Sur les machines avec 4–6 Go de RAM, les modèles 3B constituent le plafond pratique.

#1 Meta Llama 3.2 3B — Meilleur modèle débutant
Meta Llama 3.2 3B est le meilleur point de départ pour la plupart des utilisateurs. Il se télécharge en moins de 5 minutes, fonctionne sur toute machine avec 4 Go de RAM et offre une meilleure compréhension des instructions que les modèles 3B précédents. Il utilise une fenêtre de contexte de 128K — bien supérieure aux modèles de taille comparable.
Comptez environ 25–45 tokens/s sur un CPU de laptop 8 cœurs et nettement plus sur Apple Silicon comme le M3 Pro (estimations approximatives ; PromptQuorum n'a pas mesuré cela ici, et la vitesse varie selon le matériel et les réglages). La qualité convient pour la synthèse, le Q&A et le code simple, mais reste en retrait des modèles 7B pour le raisonnement multi-étapes.
Spécification | Valeur |
|---|---|
| Paramètres | 3B |
| RAM requise | ~2.5 Go (Q4_K_M) |
| Taille du téléchargement | ~2 Go |
| Fenêtre de contexte | 128K tokens |
| Vitesse CPU (laptop 8 cœurs) | 25–45 tok/s |
| Commande Ollama | ollama run llama3.2:3b |
#2 Microsoft Phi-4 Mini 3.8B — Meilleur pour peu de RAM
Phi-4 Mini est le modèle compact de Microsoft optimisé pour le raisonnement et le code à petite échelle. Il atteint 68 % MMLU et 70 % HumanEval — des scores supérieurs à beaucoup de modèles 7B de 2024 — grâce à un entraînement sur des données synthétiques de haute qualité.
C'est le modèle recommandé pour les machines avec 4–6 Go de RAM quand la qualité est importante. Phi-4 Mini utilise 2.5 Go de RAM (contre 3 Go pour Phi-3.5 Mini), le rendant plus accessible sur les machines à 4 Go.
Spécification | Valeur |
|---|---|
| Paramètres | 3.8B |
| RAM requise | ~2.5 Go (Q4_K_M) |
| Taille du téléchargement | ~2.3 Go |
| Score MMLU | 68 % |
| Fenêtre de contexte | 128K tokens |
| Vitesse CPU (laptop 8 cœurs) | 30–50 tok/s |
| Commande Ollama | ollama run phi4-mini |
#3 Google Gemma 4 E2B — Parmi les modèles 2B les plus rapides
Gemma 4 E2B est le modèle 2B mis à jour de Google et l'une des options les plus rapides pour l'inférence CPU uniquement. Il génère environ 40–60 tokens/s sur un CPU laptop milieu de gamme (estimation approximative, pas une mesure de PromptQuorum ; variable selon le matériel). La fenêtre de contexte passe de 8K (Gemma 2) à 128K tokens.
Gemma 4 E2B est un bon choix quand la rapidité de réponse prime, sur les machines avec ≤4 Go de RAM, ou comme modèle de test pour vérifier votre configuration avant de télécharger des modèles plus lourds.
Spécification | Valeur |
|---|---|
| Paramètres | 2B |
| RAM requise | ~1.7 Go (Q4_K_M) |
| Taille du téléchargement | ~1.6 Go |
| Fenêtre de contexte | 128K tokens |
| Vitesse CPU (laptop 8 cœurs) | 40–60 tok/s |
| Commande Ollama | ollama run gemma4:e2b |
#4 Meta Llama 3.1 8B — Meilleur polyvalent 7B/8B
Meta Llama 3.1 8B est le généraliste de référence à cette taille, avec un score de 72 % sur HumanEval et un raisonnement solide en anglais. Il remplace Mistral 7B comme choix polyvalent 7B/8B de cette liste — Mistral 7B était le standard communautaire en 2023-2024, mais des modèles plus récents obtiennent de meilleurs scores aux benchmarks publiés au même niveau de RAM et doit être considéré comme une option historique (voir Erreurs courantes ci-dessous pour comprendre pourquoi nous ne le recommandons plus par défaut).
Pour les machines avec 8 Go de RAM, Llama 3.1 8B est une progression naturelle par rapport aux modèles 3B. Il gère de manière plus fiable les textes longs, les instructions complexes et les conversations multi-tours que tout modèle 3B, avec une fenêtre de contexte de 128K.
Spécification | Valeur |
|---|---|
| Paramètres | 8B |
| RAM requise | ~5.5 Go (Q4_K_M) |
| Taille du téléchargement | ~5 Go |
| Fenêtre de contexte | 128K tokens |
| Score HumanEval | 72 % |
| Vitesse CPU (laptop 8 cœurs) | 10–18 tok/s |
| Commande Ollama | ollama run llama3.1:8b-instruct |
#5 Qwen3 8B — Meilleur pour le multilingue
Qwen3 8B (8,2 milliards de paramètres) obtient 57,3 % sur HumanEval, égale ou dépasse Llama 3.1 8B sur MMLU, et supporte nativement 29+ langues dont le chinois, le japonais, le coréen, l'arabe et toutes les principales langues européennes. C'est le choix recommandé pour les workflows non-anglophones ou intensifs en code, et il remplace le précédent Qwen2.5 7B comme choix multilingue de cette liste.
Qwen3 8B utilise une fenêtre de contexte de 32K (extensible à 131K avec YaRN) et supporte les sorties structurées avec le mode JSON, ainsi qu'un « mode réflexion » optionnel pour les tâches de raisonnement plus complexes (plus lent, mais plus précis). Le modèle est disponible en variantes instruct et base — pour le chat, utilisez toujours la version instruct. Consultez la comparaison Qwen vs Llama vs Mistral pour des données de benchmark détaillées.
Spécification | Valeur |
|---|---|
| Paramètres | 8.2B |
| RAM requise | ~5.2 Go (Q4_K_M) |
| Taille du téléchargement | ~5.2 Go |
| Fenêtre de contexte | 32K tokens (131K avec YaRN) |
| Score HumanEval | 57.3 % |
| Vitesse CPU (laptop 8 cœurs) | 10–18 tok/s (mode non-réflexion) |
| Commande Ollama | ollama run qwen3:8b |
Quel modèle gagne sur la RAM, la vitesse et la fenêtre de contexte ?
Modèle | RAM | Vitesse (CPU) | Contexte | Idéal pour |
|---|---|---|---|---|
| Llama 3.2 3B | 2.5 Go | 25–45 tok/s | 128K | Usage général, premier modèle |
| Phi-4 Mini 3.8B | 2.5 Go | 30–50 tok/s | 128K | Raisonnement, code, peu de RAM |
| Gemma 4 E2B | 1.7 Go | 40–60 tok/s | 128K | Vitesse, très peu de RAM |
| Llama 3.1 8B | 5.5 Go | 10–18 tok/s | 128K | Généraliste polyvalent, 72 % HumanEval |
| Qwen3 8B | 5.2 Go | 10–18 tok/s | 32K (131K YaRN) | Multilingue, code |

Par quel modèle commencer ?
- 2 Go de RAM (bas de gamme extrême) : `ollama run llama3.2:1b` — option la plus légère utilisable, ~1,3 Go à télécharger. La qualité est nettement en retrait par rapport aux modèles 3B+, mais fonctionne sur du matériel très ancien ou limité.
- 4 Go de RAM ou moins : `ollama run gemma4:e2b` — téléchargement le plus rapide, empreinte mémoire minimale, contexte 128K. Qualité acceptable pour les tâches de base.
- 8 Go de RAM, premier modèle : `ollama run llama3.2:3b` — meilleur équilibre qualité/RAM pour une première expérience.
- 4–6 Go de RAM, raisonnement/code : `ollama run phi4-mini` — 68 % MMLU, 70 % HumanEval avec seulement 2.5 Go de RAM.
- 8 Go de RAM, usage sérieux : `ollama run llama3.1:8b-instruct` ou `ollama run qwen3:8b` — pour les documents longs et les instructions complexes.
- Principalement du code : `ollama run llama3.1:8b-instruct` — valeur HumanEval la plus élevée de cette liste (72 %) ; pour un modèle dédié au code, essayez `ollama run qwen2.5-coder:7b`.
- Langue non anglaise : `ollama run qwen3:8b` — support natif de 29+ langues, sans surcharge de traduction.

Quel modèle choisir selon votre région ?
UE / RGPD : Pour les organisations européennes traitant des données personnelles localement, la provenance du modèle compte pour la documentation de conformité. Documenter l'origine et le type de licence des modèles est une bonne pratique pour les systèmes IA utilisés en contexte professionnel. Llama (Meta/USA), Gemma (Google/USA) et Qwen (Alibaba/Chine) : l'inférence locale ne suffit pas à écarter l'un de ces modèles au regard du RGPD, et la licéité de votre déploiement dépend de la base juridique, des mesures techniques et organisationnelles et de la finalité — pour la justification de provenance UE la plus simple, Mistral AI (France) propose des modèles sous licence Apache 2.0 ; l'inférence locale peut aussi limiter l'exposition des données sensibles (documents juridiques, dossiers médicaux, analyses financières). Notez toutefois que les versions actuelles de Mistral Small (24B+) dépassent la plage de RAM débutant de 4–8 Go de cette page ; consultez le guide matériel pour connaître le palier GPU nécessaire pour les exécuter.
Japon (METI) : Pour les workflows en japonais, Qwen3 8B est un bon premier choix — selon des retours de la communauté, le tokenizer de Qwen3 tend à utiliser moins de tokens sur les textes japonais que celui de Llama ; les résultats varient selon le texte. Commande : `ollama run qwen3:8b`. Documenter le nom et la version du modèle est une bonne pratique de gouvernance IA au Japon (voir les lignes directrices IA du METI) — les cinq modèles de cette page utilisent des tags Ollama versionnés qui facilitent cela.
Chine : Qwen3 8B (Alibaba) est le premier modèle naturel pour les workflows en chinois. La tokenisation chinoise native et le support de 29+ langues en font le standard pour les workflows Mandarin. Pour les déploiements d'entreprise chinois sous la loi sur la sécurité des données (数据安全法), l'inférence exécutée localement via Ollama garde les prompts et les sorties sur votre matériel, ce qui peut simplifier les questions de localisation des données pour cette couche ; la conformité de votre déploiement dépend de l'ensemble de votre traitement.
Corée : Parmi ces cinq choix pour débutants, Qwen3 8B offre la meilleure tokenisation coréenne native. Pour des modèles locaux dédiés au coréen au-delà de ce niveau débutant, consultez Meilleurs modèles de langue coréenne pour usage local.
Information générale, pas un conseil juridique : les notes régionales ci-dessus sont des informations générales et ne constituent pas un conseil juridique ; vérifiez les exigences applicables à votre situation auprès d'un professionnel qualifié.
Comment télécharger et exécuter ces modèles ?
Les cinq modèles s'installent avec une seule commande Ollama — sans configuration manuelle. Consultez Installer Ollama pour la configuration, puis Lancer votre premier LLM local pour un guide pas à pas. Sur un laptop avec peu de RAM, Exécuter des LLM locaux sur laptop couvre la quantification et l'optimisation des performances.
Une fois votre premier modèle lancé, l'étape suivante est d'apprendre à le prompter efficacement. Commencez par les fondamentaux du prompt engineering — 16 guides couvrant les éléments de base de tout prompt, des réglages de température au formatage des sorties.
Quelles erreurs font les débutants dans le choix d'un LLM local ?
- Choisir la taille du modèle uniquement d'après le nombre de paramètres — un 7B bien quantifié peut surpasser un 13B mal quantifié.
- Ne pas tenir compte de la surcharge de quantification VRAM — un modèle peut nécessiter 10–15 % de VRAM supplémentaire.
- Utiliser d'anciennes quantifications (Q3_K_S) alors que les nouvelles (Q4_K_M) offrent une meilleure qualité à la même taille.
- Choisir Mistral 7B comme modèle 7B par défaut : c'était le standard communautaire en 2023–2024 (7B, ~4,1 Go à télécharger, `ollama run mistral`) mais les modèles plus récents comme Qwen3 8B obtiennent généralement de meilleurs scores sur des benchmarks publiés, à besoin en RAM équivalent. Si un tutoriel ou un outil utilise par défaut `ollama run mistral`, passez à `ollama run qwen3:8b` ou `ollama run llama3.1:8b-instruct` pour de meilleurs résultats sans augmenter la RAM nécessaire. À noter : il s'agit d'un modèle différent, sans rapport, de la gamme actuelle « Mistral Small 3.x » (24B+), qui nécessite bien plus de RAM que tout modèle de cette page.
- Télécharger un modèle sans vérifier la RAM disponible : Si le modèle dépasse la RAM disponible, Ollama bascule vers une inférence CPU lente — parfois sous 1 tok/s. Vérifiez avec `free -h` (Linux/macOS) avant de télécharger des modèles au-dessus de 7B.
Questions fréquentes
Quel est le meilleur modèle LLM local pour débutants en 2026 ?
Llama 3.2 3B pour la plupart des utilisateurs — fonctionne sur toute machine avec 4 Go de RAM, se télécharge en moins de 5 minutes. Avec 8 Go de RAM, Qwen3 8B offre de meilleures performances en code et multilingue. Pour le minimum absolu de RAM, Gemma 4 E2B tourne avec 1,7 Go à 40–60 tok/s, ou Llama 3.2 1B avec 2 Go ou moins.
Quelle est la RAM minimum pour exécuter un LLM local ?
Le minimum pratique est 4 Go de RAM avec un modèle 3B en Q4_K_M. Avec 2 Go ou moins, Llama 3.2 1B est l'option la plus légère utilisable, bien que la qualité baisse nettement. 8 Go de RAM donnent accès aux modèles 7-8B qui produisent des résultats nettement meilleurs sur les tâches complexes.
Quel est le meilleur LLM local de 1 milliard de paramètres ?
Llama 3.2 1B est le modèle 1B recommandé — ~1,3 Go à télécharger, fonctionne avec 2 Go de RAM ou moins via `ollama run llama3.2:1b`. Il est utilisable pour la synthèse basique et les questions-réponses courtes, mais nettement plus faible que les modèles 3B+ sur le raisonnement multi-étapes. À réserver aux cas où le matériel ne peut vraiment pas supporter un modèle 3B.
Mistral Small 3.2 est-il un bon LLM local pour débutants ?
Non — Mistral Small 3.2 est un modèle de 24 milliards de paramètres qui nécessite environ 14 Go ou plus de RAM/VRAM, bien au-delà de la plage débutant de 4–8 Go couverte sur cette page. Il s'agit d'un modèle différent, bien plus volumineux, du 7B « Mistral 7B » autrefois recommandé ici. Avec 8 Go de RAM, commencez plutôt avec Llama 3.1 8B ou Qwen3 8B. Consultez le guide matériel pour connaître le palier GPU de 16 Go+ nécessaire pour exécuter Mistral Small 3.2.
Comment exécuter ces modèles avec Ollama ?
Installez Ollama depuis ollama.com, puis lancez : `ollama run llama3.2:3b`. Ollama télécharge le modèle au premier lancement. Les cinq modèles sont disponibles dans la bibliothèque Ollama.
Llama 3.2 3B est-il suffisant pour les tâches quotidiennes ?
Oui pour : synthèse, Q&A simple, explication de code de base, chat. Non pour : raisonnement multi-étapes, code complexe, rédaction structurée longue. Pour ces tâches, passez à Llama 3.1 8B ou Qwen3 8B avec 8 Go de RAM.
Quelle est la différence entre les modèles 3B et 7B ?
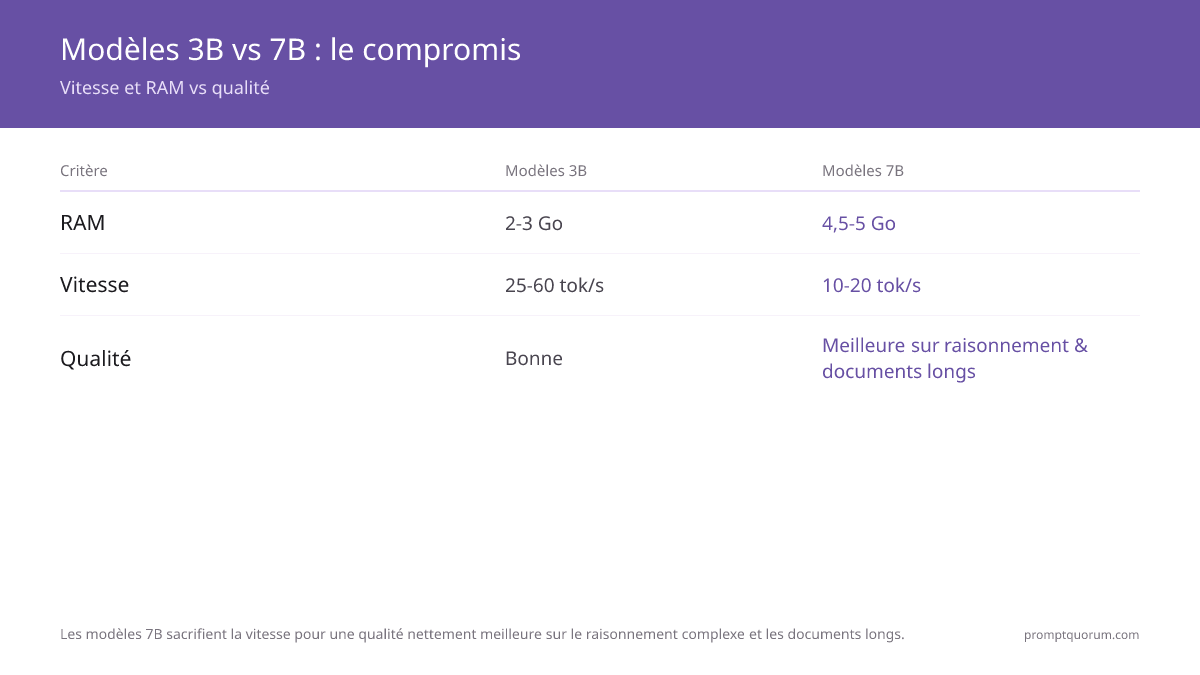
Un 7B produit des résultats nettement meilleurs sur les instructions complexes. Un 3B utilise moitié moins de RAM et tourne 2–3× plus vite. Le choix dépend de la RAM disponible — 3B sur 4–6 Go, 7B sur 8 Go.
Quel modèle est le meilleur pour le code ?
Llama 3.1 8B affiche la valeur HumanEval la plus élevée des cinq modèles de ce tableau (72 %, contre 70 % pour Phi-4 Mini 3.8B et 57,3 % pour Qwen3 8B) ; Qwen3 8B est le choix pour l'usage multilingue. Pour un modèle dédié au code, essayez `ollama run qwen2.5-coder:7b`. Avec 4–6 Go de RAM, Phi-4 Mini affiche la valeur HumanEval la plus élevée des modèles présentés ici (70 % à 2.5 Go).
Quel modèle utiliser pour les langues non anglaises ?
Qwen3 8B supporte nativement 29+ langues dont le chinois, le japonais, le coréen, l'arabe et toutes les principales langues européennes. Selon des retours de la communauté, son tokenizer tend à utiliser moins de tokens que celui de Llama sur les textes non anglophones ; les résultats varient selon le texte.
Ces modèles sont-ils sûrs avec des données privées ?
L'inférence s'exécute sur votre propre matériel, donc les prompts ne sont pas envoyés à une API cloud ; Ollama peut toutefois accéder au réseau pour télécharger des modèles et vérifier les mises à jour, sauf si vous le désactivez. Pour les données sensibles, cela évite de partager les prompts avec un fournisseur cloud, mais ce n'est pas une garantie de conformité.
Combien de temps prend le téléchargement de ces modèles ?
Sur une connexion à 100 Mb/s : Llama 3.2 1B (1,3 Go) ~2 min. Gemma 4 E2B (1,6 Go) ~2 min. Llama 3.2 3B (2 Go) ~3 min. Phi-4 Mini (2,3 Go) ~3 min. Llama 3.1 8B (~5 Go) et Qwen3 8B (~5,2 Go) ~6-7 min chacun. Mis en cache après le premier téléchargement — les lancements suivants démarrent en quelques secondes.
Puis-je exécuter plusieurs modèles sur la même machine ?
Oui — les cinq peuvent coexister sur le disque simultanément. Prévoyez 15–20 Go pour les cinq. Ollama charge un modèle à la fois et le décharge après 5 minutes d'inactivité.
Sources
- Meta AI. (2024). « Llama 3.2 Model Card. » llama.meta.com/ — Spécifications et benchmarks officiels pour Llama 3.2 3B et 1B.
- Microsoft. (2025). « Phi-4 Mini Technical Report. » huggingface.co/microsoft/Phi-4-mini-instruct — Données de benchmark pour Phi-4 Mini (68 % MMLU, 70 % HumanEval).
- Google DeepMind. (2025). « Gemma Documentation. » ai.google.dev/gemma/docs/core — Spécifications et performances de Gemma 4 E2B, incluant la mise à niveau vers 128K tokens.
- Ollama. (2026). « Ollama Model Library. » ollama.com/library — Source officielle des tags, tailles et commandes pull Ollama.
- Mistral AI. (2024). « Mistral 7B Release Notes. » mistral.ai/news/announcing-mistral-7b/ — Spécifications techniques et détails de la licence Apache 2.0 pour le modèle 7B historique mentionné dans Erreurs courantes.
- Alibaba Qwen Team. (2025). « Qwen3 Technical Report. » arXiv:2505.09388. arxiv.org/abs/2505.09388 — Données de benchmark multilingues et détails architecturaux pour Qwen3 8B.
- Meta AI. (2025). « Llama 3.1 Model Card. » llama.meta.com/ — Spécifications et benchmarks officiels pour Llama 3.1 8B.