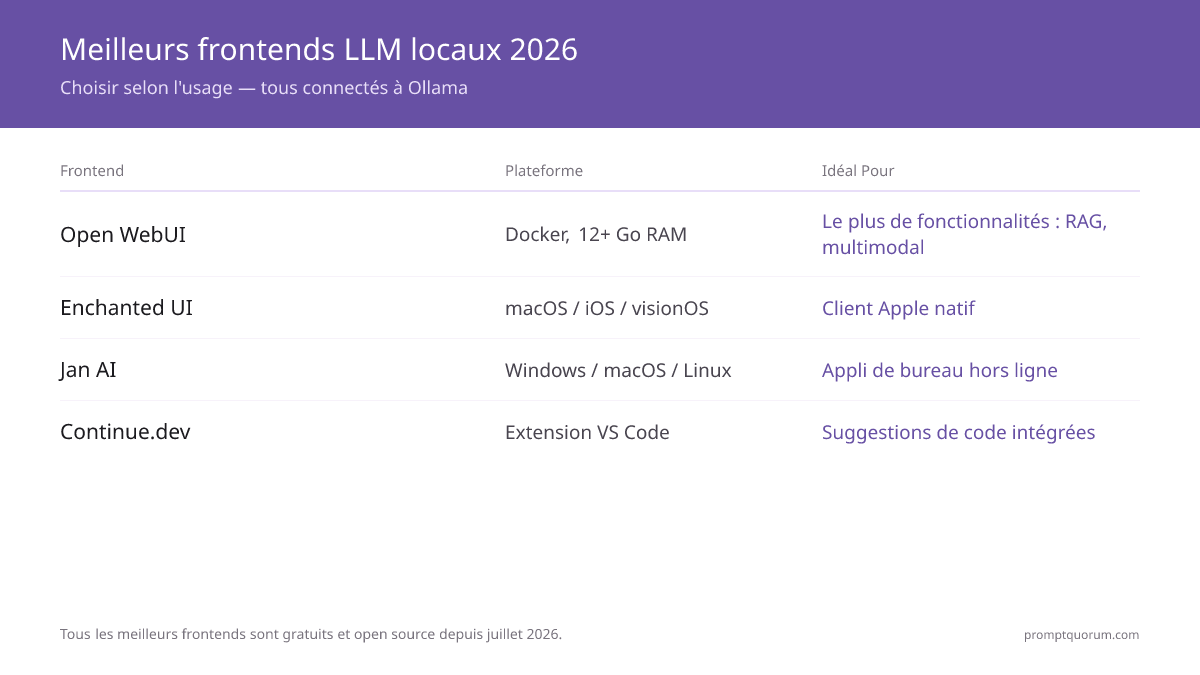
Top 8 des interfaces LLM locales : comparaison des fonctionnalités
Interface | Type | Idéal pour | Mise en route | RAM requise | Open source |
|---|---|---|---|---|---|
| Open WebUI | App web (Docker/pip) | Riche en fonctions, RAG, équipes | 5 min (avec Docker) | 12 Go+ | Source disponible (clause de marque) |
| App de bureau Ollama | App native (macOS/Windows) | Chat de base, rien à installer en plus | ~2 min | 8 Go+ | Oui (dépôt MIT) |
| Enchanted UI | App native (iOS/macOS/visionOS) | Utilisateurs Apple (aucune mise à jour depuis juil. 2026) | ~2 min (App Store) | 8 Go+ | Oui (Apache-2.0) |
| Jan AI | App de bureau | Non-techniciens, hors ligne | 3 min (installation) | 8 Go+ | Oui (Apache-2.0) |
| Continue.dev | Extension VS Code | Complétion de code (développement arrêté en juin 2026) | 2 min (installer l'extension) | 8 Go+ | Oui (Apache-2.0) |
| LobeHub (Lobe Chat) | App web | Confidentialité, personnalisation | 5 min | 8 Go+ | Licence communautaire basée sur Apache |
| Gradio / Streamlit | Bibliothèques Python | Interfaces sur mesure, tableaux de bord | 5 min (Python) | 8 Go+ | Oui (Apache-2.0) |
| TextGen (anciennement Text-generation-webui) | Web (complexe) | Expérimentation, utilisateurs avancés | 15 min | 12 Go+ | Oui (AGPL-3.0) |

Qu'est-ce qui fait d'Open WebUI l'interface la plus populaire ?
Open WebUI est l'interface LLM locale la plus étoilée de ce guide, avec plus de 150 000 étoiles GitHub -- elle réunit RAG, multimodal, recherche web et collaboration multi-utilisateurs dans un seul conteneur Docker ou paquet Python. Elle fonctionne avec Ollama, LM Studio ou n'importe quelle API compatible OpenAI. Dernière version : v0.12.3 (16 octobre 2026).
Fonctionnalités principales :
- RAG (génération augmentée par récupération) : téléversez des documents (PDF, fichiers texte) et laissez le modèle répondre aux questions à leur sujet.
- Support multimodal : téléversez des images et posez des questions à leur sujet.
- Intégration de la recherche web : le modèle peut chercher des informations actuelles sur le web.
- Bases de connaissances : créez des collections persistantes de documents auxquelles le modèle se réfère.
- Appel de fonctions et outils : construisez des workflows où le modèle peut appeler des fonctions ou des outils.
- Collaboration en équipe : plusieurs utilisateurs peuvent partager la même instance.
- Marketplace de modèles : parcourez et téléchargez des modèles directement depuis l'interface.
La principale limite est la mise en place. Docker est l'installation officiellement recommandée (environ 5 minutes) ; `pip install open-webui` (Python 3.11 ou 3.12) et une application de bureau sont les alternatives. Une fois lancé, il ajoute RAG, multimodal, multi-utilisateurs et recherche web -- des fonctions absentes des alternatives légères.
Licence : le code jusqu'à la v0.6.5 est sous BSD-3-Clause. À partir de la v0.6.6 (avril 2025), Open WebUI utilise une licence modifiée avec une clause de marque : vous ne pouvez pas retirer ni modifier la marque « Open WebUI », sauf si vous avez 50 utilisateurs ou moins sur une période de 30 jours, une autorisation écrite ou une licence entreprise. Son usage est gratuit, mais sa page de licence précise qu'il ne s'agit pas d'une licence open source approuvée par l'OSI.
# Run Open WebUI with Docker (5 min setup)
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway \
  -e OLLAMA_BASE_URL=http://host.docker.internal:11434 \
  --name open-webui ghcr.io/open-webui/open-webui:latest

# Then open http://localhost:3000 in your browser

# Alternative without Docker (Python 3.11 or 3.12)
pip install open-webui
open-webui serve   # then open http://localhost:8080
•⚠️ Avertissement: Docker est la méthode recommandée pour exécuter Open WebUI. Si Docker n'est pas installé, ajoutez 10 à 15 minutes à la mise en place (lancez `docker --version` pour vérifier) ou utilisez l'installation pip ci-dessous.
•💡 Astuce: L'authentification est activée par défaut (WEBUI_AUTH=True) et le premier lancement vous demande de créer un compte administrateur. Créez-le vous-même avant d'exposer l'instance sur un réseau, surtout pour tout déploiement multi-utilisateurs ou en équipe.
Pourquoi choisir Enchanted UI comme app native Apple ?
⚠️ Aucune mise à jour depuis le 7 juillet 2026 (plus de 3 mois) -- ce projet est peut-être abandonné. Vérifiez le dépôt avant de vous y fier. La dernière version publiée est la v1.8.2 (15 juin 2026).
Enchanted UI est une application native iOS, macOS et visionOS pour discuter avec votre modèle Ollama local -- installez-la depuis l'App Store ou compilez-la depuis le code source, puis indiquez-lui l'adresse de votre serveur Ollama. Le projet open source compte plus de 6 000 étoiles GitHub et est publié sous licence Apache-2.0 ; c'est l'option native la plus soignée pour le matériel Apple dans ce guide.
Fonctionnalités principales :
- App Apple native : fonctionne sur iPhone, iPad, Mac et Apple Vision Pro avec une interface façon ChatGPT -- pas un onglet de navigateur.
- Entrées multimodales : prend en charge les prompts vocaux et les images jointes en plus du texte.
- Privé : l'historique des conversations reste sur votre appareil et votre propre réseau ; rien n'est envoyé à un serveur tiers.
- Intégration Spotlight sur macOS et mode sombre : lancez des chats depuis Spotlight ; interface moderne et épurée.
Enchanted UI convient aux utilisateurs Apple qui veulent une app native façon ChatGPT plutôt qu'un onglet de navigateur ou un conteneur Docker. Elle n'a ni RAG ni bases de connaissances, mais pour le chat quotidien sur iPhone, iPad, Mac ou Vision Pro, c'est l'option la plus soignée de ce guide -- à condition d'accepter le risque de maintenance indiqué ci-dessus.
# 1. Start your Ollama model
ollama run llama3.2:3b

# 2. Install Enchanted UI from the App Store (iOS/macOS/visionOS)
# or build from source: https://github.com/gluonfield/enchanted

# 3. In Enchanted UI settings, enter your Ollama server address
# (localhost:11434 on the same Mac, or the Mac's LAN IP from iOS/visionOS)•💡 Astuce: Sur macOS, Enchanted UI utilise par défaut Ollama à l'adresse localhost:11434. Sur iOS ou visionOS, vous devez saisir manuellement l'adresse réseau de votre Mac (par ex. http://192.168.1.x:11434) dans les réglages, car le téléphone ou le casque ne peut pas joindre « localhost » sur une autre machine. Lancez toujours `ollama serve` (ou démarrez l'app Ollama) en premier.
Pourquoi Jan AI est-il le meilleur choix pour le bureau ?
Jan AI est une application de bureau (Windows, macOS, Linux) qui réunit gestion des modèles, inférence et chat dans une seule application hors ligne -- sans serveur ni configuration Docker. Elle ressemble à LM Studio, mais elle est open source (Apache-2.0) et portée par une approche communautaire. Dernière version : v0.8.7 (20 octobre 2026).
Fonctionnalités principales :
- Hors ligne d'abord : les modèles sont stockés sur votre appareil ; aucune connexion internet n'est nécessaire pour discuter.
- GPU avec repli sur le CPU : utilise automatiquement le GPU s'il est disponible (y compris l'accélération AMD ROCm/HIP sous Linux, ajoutée dans la v0.8.2), sinon bascule sur le CPU.
- Privé par défaut : aucun compte requis ; les statistiques d'usage ne sont collectées que si vous les autorisez au premier lancement.
- Marketplace d'extensions : ajoutez des plugins comme RAG, recherche web ou outils.
Jan convient surtout aux non-techniciens qui veulent une application de bureau soignée. Jan AI compte plus de 45 000 étoiles GitHub et un support natif complet sur Windows, macOS et Linux -- une alternative mature à LM Studio, avec une communauté active.
•📌 À retenir: Jan AI stocke ses modèles dans ~/jan/models -- séparément du cache de modèles d'Ollama. Si vous utilisez les deux, les modèles téléchargés ne sont pas partagés et l'espace disque double pour tout modèle utilisé dans les deux applications.
Comment utiliser Continue.dev pour la complétion de code ?
⚠️ Développement arrêté : aucune version depuis le 19 juin 2026 (plus de 4 mois). Ce projet est peut-être abandonné -- vérifiez avant de vous y fier.
Continue.dev transforme votre modèle Ollama local en suggestions de code en ligne dans VS Code ou JetBrains -- la configuration prend 2 minutes et ne nécessite aucune clé d'API cloud. Quand vous commencez à taper, Continue propose des complétions basées sur votre modèle local.
Cursor a racheté Continue en juin 2026 et la dernière version est sortie le 19 juin 2026 -- l'extension VS Code et le plugin JetBrains s'installent et fonctionnent toujours avec un modèle Ollama local, mais aucune mise à jour n'est prévue.
Configuration (2 minutes) :
1. Installez Continue depuis le marketplace VS Code.
2. Indiquez-lui votre instance Ollama (Config → Configure Continue → Add localhost:11434).
3. Commencez à écrire du code et appuyez sur Tab pour accepter une complétion.
Continue fonctionne toujours pour les développeurs qui veulent des suggestions de code sans envoyer leur code à des API cloud, mais un outil qui continue de recevoir des mises à jour est un choix plus prudent à long terme. Tabby, un serveur de complétion de code open source et auto-hébergé, est l'alternative la plus proche, mais son dépôt est lui aussi resté silencieux depuis le 30 juin 2026 (dernière version v0.32.0, 25 janvier 2026) ; vérifiez-le avant de l'adopter. Consultez LLM locaux avec VS Code et Cursor pour les options actuelles.
•⚠️ Avertissement: Cursor a racheté Continue en juin 2026 et le développement s'est arrêté -- l'extension fonctionne toujours avec Ollama, mais n'attendez ni nouvelles fonctions ni corrections de bugs. Tabby, l'alternative auto-hébergée la plus proche, n'a lui aussi enregistré aucune activité sur son dépôt depuis le 30 juin 2026.
•💡 Astuce: Pour la complétion de code, Qwen2.5-Coder 7B (`ollama run qwen2.5-coder:7b`) est un modèle spécialisé en code, plus adapté aux complétions que des modèles de chat généralistes comme Llama 3.2. Sélectionnez-le dans la configuration de Continue après l'installation.
Quelles interfaces légères et alternatives à Open WebUI méritent d'être essayées ?
Si Open WebUI vous semble trop lourd, commencez par l'app de bureau Ollama ou l'extension de navigateur Page Assist ; si les questions-réponses sur documents sont votre objectif principal, essayez AnythingLLM. Chaque option ci-dessous se connecte à la même API Ollama locale (localhost:11434).
- App de bureau Ollama -- Chat intégré pour macOS et Windows : téléchargez des modèles, glissez-déposez des fichiers texte ou PDF, envoyez des images aux modèles multimodaux. Rien d'autre à installer. Téléchargez-la sur ollama.com/download.
- Page Assist -- Chat en barre latérale du navigateur pour Chrome et Firefox, plus de 8 000 étoiles GitHub (MIT). L'option la plus légère : ni serveur supplémentaire ni Docker. Dernière version v1.5.88 (18 octobre 2026) sur GitHub.
- AnythingLLM -- Application de bureau et image Docker construites autour d'espaces de travail RAG, plus de 67 000 étoiles GitHub (MIT). Dernière version v1.18.0 (13 octobre 2026) sur GitHub.
- LM Studio -- Application de bureau à code fermé (gratuite pour un usage personnel et professionnel) avec chat intégré et serveur local compatible OpenAI sur localhost:1234, que Open WebUI et d'autres interfaces peuvent utiliser comme backend. Voir son journal des modifications (dernière mise à jour le 12 octobre 2026).
- Cherry Studio -- Client de bureau multi-fournisseurs avec bases de connaissances intégrées, plus de 52 000 étoiles GitHub (AGPL-3.0). Dernière version v2.1.7 (19 octobre 2026). Lisez l'avis sur Cherry Studio.
•📌 À retenir: Pour des comparaisons détaillées, voir LM Studio vs Jan AI et LobeChat, Big-AGI, NextChat, Page Assist et Chatbox comparés.
Faut-il auto-héberger ou utiliser une interface cloud ?
Toutes les interfaces de ce guide tournent sur votre machine ou votre serveur -- aucune donnée de prompt ne quitte votre appareil, et il n'y a aucun coût d'API. L'alternative, ce sont les interfaces cloud comme ChatGPT, Claude ou Gemini, qui se connectent à des serveurs distants.
- Choisissez l'auto-hébergement si : vous manipulez des données sensibles, vous voulez zéro coût d'API, vous voulez personnaliser l'interface ou vous travaillez hors ligne.
- Choisissez le cloud si : vous avez besoin de la meilleure qualité de modèle, vous ne voulez pas gérer d'infrastructure ou votre volume est faible.
- Utilisez les deux en parallèle : des outils comme PromptQuorum permettent d'envoyer un prompt simultanément à votre modèle local et aux API cloud, pour comparer les résultats côte à côte.
•📌 À retenir: Toutes les interfaces peuvent pointer vers la même instance Ollama -- localhost:11434 sur la même machine, ou l'IP locale de votre machine pour les apps mobiles comme Enchanted UI. Changer d'interface ne demande aucun nouveau téléchargement de modèle -- Ollama conserve tous les modèles téléchargés, quelle que soit l'interface utilisée.
Comment les règles de conformité régionales influencent-elles le choix d'une interface ?
UE / RGPD
Pour les organisations de l'UE qui déploient des interfaces LLM locales, la souveraineté des données est le principal moteur. Les 8 interfaces de ce guide peuvent fonctionner entièrement sur site -- ni le contenu des prompts, ni l'historique des conversations, ni les documents téléversés n'ont besoin de quitter votre infrastructure. Cela va dans le sens de l'article 5 du RGPD (minimisation des données) et peut éviter le recours à une relation de sous-traitance au titre de l'article 28 avec un fournisseur d'inférence.
Pour les secteurs réglementés de l'UE (santé, juridique, finance), Open WebUI est un choix courant car il stocke l'historique des conversations sur votre propre serveur et propose des rôles utilisateurs et des contrôles d'administration. Le compendium BSI IT-Grundschutz est un cadre de référence courant pour la sécurité informatique des organisations allemandes ; les orientations de la CNIL sur l'IA et le RGPD indiquent que l'inférence locale peut éviter une relation avec un sous-traitant tiers, notamment lorsque des données professionnelles sensibles (financières, médicales, juridiques) sont traitées. Ces documents d'orientation ne constituent pas une approbation réglementaire formelle pour votre déploiement spécifique — consultez l'autorité de protection des données de votre secteur ou un conseil juridique pour les exigences contraignantes. Au titre de l'hygiène technique, gardez l'authentification activée dans Open WebUI (elle l'est par défaut, `WEBUI_AUTH=True`), créez vous-même le compte administrateur avant d'exposer l'instance, et limitez l'accès aux utilisateurs autorisés. Votre DPO détermine si cela satisfait l'article 32 du RGPD pour vos traitements.
Licences pour les organisations
La clause de marque d'Open WebUI (v0.6.6 et suivantes) impose de garder sa marque visible pour les déploiements de plus de 50 utilisateurs sur une période de 30 jours, sauf si vous disposez d'une licence entreprise. Faites relire ce point par votre service juridique avant un déploiement à l'échelle de l'entreprise ou en marque blanche. Les autres interfaces de ce guide utilisent Apache-2.0 (Jan AI, Enchanted UI), AGPL-3.0 (TextGen) ou des licences communautaires (LobeHub).
Japon (METI)
Les orientations du METI sur la gouvernance de l'IA encouragent à documenter les outils d'IA et leurs versions utilisés en production. La version d'Open WebUI est visible dans Réglages → À propos, et les tags d'images Docker permettent de figer précisément la version pour vos registres. Pour les équipes d'entreprise japonaises, Open WebUI avec Qwen3 8B (`ollama run qwen3:8b`) est une pile pratique -- la tokenisation native du japonais offre une meilleure qualité pour les questions-réponses sur documents japonais dans la fonction RAG.
Chine
Exécuter les interfaces sur site ou chez des fournisseurs cloud nationaux (Alibaba Cloud, Tencent Cloud) maintient les données sur une infrastructure locale, ce qui va dans le sens des exigences de localisation des données de la Loi sur la sécurité des données chinoise (数据安全法) ; confirmez les détails auprès d'un conseil juridique. Open WebUI sous Docker est compatible avec les instances de VM cloud chinoises. Pour les déploiements RAG d'entreprise en Chine, associez Open WebUI à Qwen3 14B pour une analyse optimale de documents en chinois.
•⚠️ Avertissement: Pour les secteurs réglementés de l'UE (santé, juridique, finance) : l'authentification est une mesure technique nécessaire au regard de l'article 32 du RGPD, mais la conformité complète à l'article 32 exige une évaluation plus large des mesures techniques et organisationnelles (TOM). Gardez l'authentification d'Open WebUI activée, créez le compte administrateur avant d'exposer l'instance et consultez votre DPO.
•🔍 Le saviez-vous ?: Les orientations du METI sur la gouvernance de l'IA encouragent à documenter les versions des outils d'IA en production. La version d'Open WebUI est visible dans Réglages → À propos, et figer les images Docker sur un tag de version précis (au lieu de :latest) fournit un historique exact des versions pour la conformité.
Quelles sont les 5 erreurs les plus courantes dans le choix d'une interface ?
- Croire qu'il faut l'interface la plus riche en fonctionnalités. Open WebUI offre le plus de fonctions, mais si vous voulez seulement discuter, l'app de bureau Ollama ou Enchanted est plus rapide à mettre en place. Choisissez selon vos besoins réels, pas selon le nombre de fonctionnalités.
- Ne pas réaliser qu'on peut changer d'interface facilement. Vos modèles Ollama sont indépendants de l'interface. Passez d'Open WebUI à Enchanted UI ou à l'app de bureau Ollama sans retélécharger de modèles -- elles partagent toutes la même instance Ollama (Jan AI conserve son propre dossier de modèles).
- Essayer d'exécuter Open WebUI sur une machine de 8 Go de RAM sans GPU. Open WebUI + l'inférence du modèle demandent plus de 12 Go au total. Sur du matériel limité, utilisez l'app de bureau Ollama, Page Assist ou Enchanted UI.
- Ignorer la quantification des modèles et les besoins de l'interface. Un modèle 13B en 8 bits pèse déjà 13 Go à lui seul. Open WebUI ajoute de la charge. Faites le calcul : taille du modèle + surcharge de l'interface + système = RAM totale nécessaire.
- Ne pas configurer Ollama d'abord comme service d'arrière-plan. Beaucoup de nouveaux utilisateurs essaient de lancer plusieurs interfaces sans réaliser qu'Ollama doit tourner. Configurez Ollama en premier (comme service via `ollama serve` en arrière-plan), puis ajoutez l'interface choisie.
•⚠️ Avertissement: Exécuter Open WebUI + l'inférence d'un modèle sur 8 Go de RAM provoque fréquemment des plantages par manque de mémoire. Le minimum pour une expérience fluide est 16 Go de RAM système au total -- 12 Go pour le modèle, 4 Go pour le système et Docker.
Questions courantes sur les interfaces LLM locales
Puis-je exécuter plusieurs interfaces en même temps ?
Oui. Toutes les interfaces se connectent à la même API Ollama (localhost:11434). Vous pouvez faire tourner Open WebUI, Enchanted UI et l'app de bureau Ollama en même temps avec le même modèle. Cela ne double pas l'utilisation de la VRAM -- elles partagent toutes la même instance du modèle.
Quelle interface est la meilleure pour le RAG ?
Open WebUI propose l'implémentation RAG généraliste la plus aboutie parmi les interfaces de ce guide -- téléversez des documents et le modèle répond aux questions à leur sujet. Si les questions-réponses sur documents sont votre usage principal plutôt qu'une fonction secondaire, AnythingLLM (plus de 67 000 étoiles GitHub) est conçu autour d'espaces de travail RAG et mérite d'être évalué séparément. Pour des workflows RAG avancés, voir Meilleurs outils RAG locaux.
Ai-je vraiment besoin d'une interface ?
Non. Ollama fournit une API REST à l'adresse localhost:11434, et sur macOS et Windows son application de bureau inclut déjà une fenêtre de chat de base. Vous pouvez aussi écrire des scripts Python, JavaScript ou bash pour parler directement au modèle via l'API. Une interface séparée sert au confort, au RAG, à l'accès multi-utilisateurs ou à l'usage mobile.
Ollama a-t-il une interface graphique ?
Oui, sur macOS et Windows. Depuis juillet 2025, Ollama propose une application de bureau qui télécharge les modèles, discute avec eux, accepte les fichiers texte et PDF déposés par glisser-déposer et envoie des images aux modèles multimodaux. L'annonce couvre macOS et Windows ; sous Linux, utilisez la ligne de commande et l'API, ou associez Ollama à une interface comme Open WebUI ou Page Assist.
Open WebUI est-il open source ?
En partie. Le code jusqu'à la v0.6.5 est sous BSD-3-Clause. À partir de la v0.6.6 (avril 2025), il utilise une licence modifiée avec une clause de marque, que la page de licence d'Open WebUI elle-même décrit comme non approuvée par l'OSI. Son usage reste gratuit ; gardez la marque visible si vous servez plus de 50 utilisateurs sur une période de 30 jours, sauf si vous avez une licence entreprise ou une autorisation écrite.
Open WebUI nécessite-t-il Docker ?
Non. Docker est l'installation recommandée, mais vous pouvez exécuter Open WebUI avec `pip install open-webui` (Python 3.11 ou 3.12 ; Python 3.13 n'est pas encore pris en charge), ou utiliser l'application de bureau Open WebUI disponible sur github.com/open-webui/desktop.
Quelles sont les meilleures alternatives à Open WebUI ?
Pour une installation plus légère : l'app de bureau Ollama (macOS/Windows), Page Assist (extension de navigateur) ou Jan AI (bureau). Pour les questions-réponses sur documents : AnythingLLM. Pour un client de bureau multi-fournisseurs : Cherry Studio. Pour une interface web auto-hébergée : LobeHub. Voir la section sur les alternatives ci-dessus pour les versions et les licences.
Quelle interface fonctionne sous Linux ?
Open WebUI, Jan AI, LobeHub, Page Assist (dans un navigateur Linux) et Gradio/Streamlit fonctionnent tous sous Linux. Jan AI a ajouté l'accélération GPU AMD ROCm/HIP sous Linux dans la v0.8.2 (juin 2026), Linux n'est donc plus une plateforme bêta pour lui. Enchanted UI est réservée à iOS/macOS/visionOS, et l'app de bureau Ollama est annoncée pour macOS et Windows. Continue.dev fonctionne via VS Code sur toutes les plateformes, bien que le projet ait cessé son développement actif en juin 2026 après son rachat par Cursor.
Puis-je héberger une interface sur un serveur distant ?
Oui. Les interfaces web comme Open WebUI et LobeHub fonctionnent bien sur un serveur : exécutez Ollama dessus, déployez l'interface dans Docker et ouvrez-la depuis votre portable via HTTP. Les apps natives comme Enchanted UI se connectent à un serveur Ollama distant quand vous saisissez son adresse dans les réglages. Sécurisez l'ensemble avec une authentification ou un pare-feu.
Quelle est l’interface de chat LLM locale la plus légère (peu de RAM) ?
Les clients natifs et sous forme d'extension ajoutent le moins de charge : l'app de bureau Ollama, Enchanted UI, Page Assist et Continue.dev n'ont ni Docker ni couche de base de données. L'image Docker allégée d'Open WebUI consomme environ 300 Mo au repos d'après sa documentation, et davantage dès que le RAG et les modèles d'embedding sont actifs. Si la RAM est limitée, utilisez l'app de bureau Ollama ou Page Assist, Enchanted UI sur les appareils Apple, ou Continue.dev pour le code.
Puis-je utiliser ces interfaces avec LM Studio au lieu d'Ollama ?
Oui. Open WebUI fonctionne avec toute API compatible OpenAI, y compris l'API de LM Studio à l'adresse localhost:1234. L'API REST de LM Studio a atteint une version v1 stable (elle n'est plus en bêta) et a aussi ajouté un point d'accès compatible Anthropic, de sorte qu'Ollama comme LM Studio peuvent servir de backend fiable. Modifiez l'URL de base dans les réglages.
Quelle interface est la meilleure pour une équipe de 5 développeurs ou plus ?
Open WebUI. Elle est conçue pour un déploiement multi-utilisateurs : authentification, historiques de conversation séparés par utilisateur, bases de connaissances partagées et contrôles d'administration. Déployez-le sur un serveur partagé avec Docker et tous les membres de l'équipe y accèdent via le navigateur. Il demande plus de 12 Go de RAM sur le serveur hôte. Vérifiez la clause de marque si plus de 50 utilisateurs doivent s'en servir.
Sources
- Open WebUI Contributors. (2026). "Open WebUI GitHub." -- Code source, versions et documentation d'installation Docker d'Open WebUI.
- Open WebUI. (2026). "Open WebUI License." -- BSD-3-Clause jusqu'à la v0.6.5 ; clause de marque à partir de la v0.6.6.
- Open WebUI. (2026). "Quick Start." -- Méthodes d'installation Docker, pip et application de bureau.
- Ollama. (2025). "Ollama's new app." -- Annonce de l'application de bureau pour macOS et Windows (30 juillet 2025).
- Jan AI. (2026). "Jan AI Official Site." -- Documentation de l'application de bureau et guide de gestion des modèles ; versions sur GitHub.
- Enchanted Contributors. (2026). "Enchanted GitHub." -- Code source du client Ollama natif iOS/macOS/visionOS ; dernière mise à jour le 7 juillet 2026.
- The New Stack. (2026). "Cursor acquires Continue." -- Article sur le rachat de juin 2026.
- Continue.dev. (2026). "Continue GitHub Repository." -- Code source de l'extension VS Code et JetBrains ; dernière version le 19 juin 2026.
- LobeHub. (2026). "LobeHub GitHub." -- Code source, versions et licence du successeur de Lobe Chat.
- Page Assist and AnythingLLM. (2026). "Page Assist GitHub." -- Code source du client en barre latérale de navigateur ; AnythingLLM se trouve sur github.com/Mintplex-Labs/anything-llm.
- Le choix d'une interface influe sur l'expérience utilisateur, pas sur la sortie du modèle. La qualité des réponses dépend des prompts, pas des interfaces : le guide du prompt engineering s'applique à toutes les interfaces.