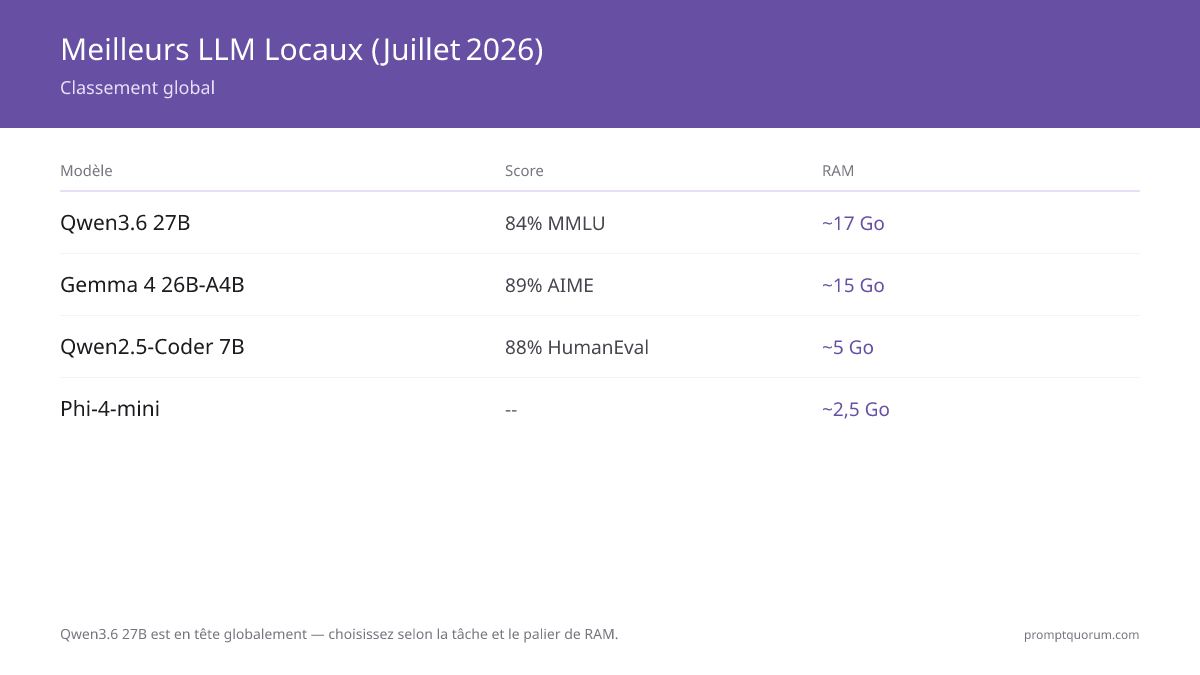
Comment ces modèles ont été classés
Les classements sont basés sur des benchmarks publiés par chaque laboratoire ainsi que des mesures communautaires indépendantes : MMLU (connaissances générales), HumanEval et SWE-bench Verified (capacité de codage), AIME (mathématiques compétitives) et GPQA Diamond (raisonnement de niveau doctorat). Les scores proviennent des fiches officielles de chaque modèle et de trackers de benchmarks communautaires à partir de Q3 2026.
Les exigences matérielles sont calculées pour la quantification Q4_K_M -- le paramètre standard pour débuter qui équilibre la qualité et l'utilisation de RAM. Pour une introduction à la quantification, consultez Local LLM Hardware Guide.
Tous les modèles sont disponibles via Ollama. Pour l'installation, consultez How to Install Ollama.

#1 Qwen3.8-27B -- Meilleur LLM local global en 2026
Qwen3.8-27B est le meilleur LLM local pour la plupart des utilisateurs en 2026. 89,2 % GPQA Diamond, 61,7 % SWE-bench Pro -- tient dans ~24 GB RAM avec Q4_K_M. Contrairement au précédent Qwen3.6 27B, c'est un modèle vision-langage natif -- il comprend les images et la vidéo directement, pas seulement le texte. Contexte natif de 262K tokens (extensible à 1M).
Cette architecture dense de 27B remplace la génération précédente de Qwen3 (désormais obsolète) et nécessite bien plus de RAM. Les machines avec 16 GB devraient plutôt utiliser la variante MoE Qwen3.6-35B-A3B ou un modèle plus petit.
Spécification | Valeur |
|---|---|
| GPQA Diamond | 89,2 % |
| SWE-bench Pro | 61,7 % |
| RAM requise (Q4_K_M) | ~24 GB |
| Fenêtre de contexte | 262K tokens (jusqu'à 1M étendu) |
| Commande Ollama | ollama pull qwen3.8:27b |
#2 Gemma 4 26B-A4B -- Meilleur pour le raisonnement
Gemma 4 26B-A4B est le meilleur modèle local pour les tâches à forte composante de raisonnement en 2026. 88,3 % AIME 2026 -- grâce à une conception Mixture-of-Experts qui n'active que ~4B de paramètres par token, générant du texte à une vitesse proche d'un modèle 4B malgré le chargement de 26B de paramètres en mémoire.
Le téléchargement Ollama pèse 16–19 GB (Ollama n'indique pas la quantification de l'étiquette par défaut) : prévoyez autant de RAM plus une marge pour le contexte ; tient sur une seule RTX 4090 ou un Mac avec 32 GB+ de mémoire unifiée (macOS en réserve environ 8 GB). Consultez DeepSeek vs Qwen Coding Comparison.
Spécification | Valeur |
|---|---|
| Score AIME 2026 | 88,3 % |
| Paramètres actifs | ~4B sur 26B (MoE) |
| RAM requise (taille du téléchargement Ollama) | 16–19 GB |
| Fenêtre de contexte | 256K tokens |
| Commande Ollama | ollama pull gemma4:26b |
#3 Qwen2.5-Coder 7B -- Meilleur pour la génération de code
Qwen2.5-Coder 7B est un solide petit modèle local pour le code. 88 % HumanEval, ~5 GB avec Q4_K_M, entraîné sur 80+ langages de programmation.
Avec 24 GB de RAM ou plus, Qwen3.8-27B (61,7 SWE-bench Pro selon Qwen, 18 GB sur Ollama, `ollama run qwen3.8`) est le choix le plus puissant pour le code, et Devstral Small 2 (15 GB) convient aux machines de 16 GB. La version 7B est un point de départ rapide et léger. Consultez Meilleurs LLM locaux pour coder.
Spécification | Valeur |
|---|---|
| Score HumanEval | 88 % |
| Score EvalPlus | 78 % |
| RAM requise (Q4_K_M) | ~5 GB |
| Fenêtre de contexte | 128K tokens |
| Commande Ollama | ollama run qwen2.5-coder:7b |
#4 Phi-4-mini -- Meilleur modèle CPU uniquement
Microsoft Phi-4-mini atteint 67,3 % sur MMLU (5-shot, selon la fiche du modèle Microsoft) grâce à des données de raisonnement synthétique de haute qualité. ~2.5 GB RAM avec Q4_K_M, 30-50 tokens/s sur n'importe quelle CPU de portable moderne.
Recommandé pour 4-8 GB RAM, Raspberry Pi/SBC. Son suivi d'instructions dépasse Gemma 4 E2B à RAM comparable.
Spécification | Valeur |
|---|---|
| Score MMLU | 67,3 % |
| Score HumanEval | — |
| RAM requise (Q4_K_M) | ~2.5 GB |
| Fenêtre de contexte | 128K tokens |
| Commande Ollama | ollama run phi4-mini |
#5 Gemma 4 E2B -- Meilleur petit modèle
Google Gemma 4 E2B est le meilleur modèle sous 3B de paramètres effectifs. 2,3 Md de paramètres effectifs (5,1 Md avec les embeddings) -- seulement ~2 GB VRAM requis. Le contexte 128K est inhabituellement large pour cette taille de modèle.
Recommandé pour l'edge, les SBC (fonctionne sur un Raspberry Pi 5), les cartes NVIDIA Jetson et les téléphones. Pour la plupart des utilisateurs de bureau/portable, Phi-4-mini offre une meilleure qualité à RAM similaire. Téléchargement : `ollama pull gemma4:e2b`.
Spécification | Valeur |
|---|---|
| Paramètres effectifs | 2,3 Md (5,1 Md avec embeddings) |
| VRAM requise (Q4_K_M) | ~2 GB |
| Fenêtre de contexte | 128K tokens |
| Commande Ollama | ollama pull gemma4:e2b |
Comparaison complète des benchmarks : Top 5 LLMs locaux 2026
Modèle | MMLU | HumanEval | RAM | Best For |
|---|---|---|---|---|
| Qwen3.8-27B | — | — | ~24 GB | Global (GPQA Diamond 89,2 %) |
| Gemma 4 26B-A4B | — | — | 16–19 GB | Raisonnement, AIME (88,3 %) |
| Qwen2.5-Coder 7B | — | 88 % | ~5 GB | Génération de code |
| Phi-4-mini 3.8B | 67,3 % | — | ~2.5 GB | CPU uniquement, edge |
| Gemma 4 E2B | — | — | ~2 GB | Petit / SBC |
Quel LLM local devriez-vous utiliser en 2026?
- <4 GB RAM (CPU uniquement): Phi-4-mini (`ollama run phi4-mini`) -- meilleur suivi d'instructions avec un minimum de RAM.
- 2-4 GB RAM (tiny/edge): Gemma 4 E2B (`ollama pull gemma4:e2b`) -- modèle viable le plus petit, contexte 128K.
- 8-16 GB RAM: Phi-4-mini ou la variante MoE Qwen3.6-35B-A3B -- Qwen3.8-27B (~24 GB) ne tient plus confortablement à ce niveau.
- 24 GB+ VRAM/RAM (meilleure qualité globale): Qwen3.8-27B (`ollama pull qwen3.8:27b`) -- meilleure qualité globale à ce niveau.
- Tâches de code: Qwen2.5-Coder 7B (`ollama run qwen2.5-coder:7b`) sur petites machines ; Devstral Small 2 (`ollama run devstral-small-2`) avec 16 GB ; Qwen3.8-27B avec 24+ GB RAM -- consultez Meilleurs LLM locaux pour coder.
- Raisonnement / mathématiques: Gemma 4 26B-A4B (`ollama pull gemma4:26b`, 16–19 GB RAM) -- 88,3 % AIME 2026.
- Langues non-anglaises: Qwen3.8-27B -- consultez Qwen vs Llama vs Mistral.

Quelles régions régulent le déploiement des LLMs locaux?
Les organisations de l'UE priorisent la minimisation des données de l'article 5 du RGPD. Le Règlement général sur la protection des données et la Loi de l'UE sur l'IA émergente exigent une documentation de modèle transparente et la traçabilité des données pour les systèmes traitant des données personnelles. Les modèles avec des ensembles de données d'entraînement publiés (Meta Llama, Mistral) satisfont mieux les exigences d'audit que les modèles avec des pipelines d'entraînement opaques. L'inférence locale élimine le transfert de données vers des serveurs externes.
Les autorités de protection des données françaises (CNIL) recommandent les LLMs locaux lors de la gestion de données professionnelles sensibles. Pour la manipulation de données financières, médicales ou juridiques, la CNIL conseille l'inférence locale pour minimiser les risques de conformité et maintenir la souveraineté des données.
Les lignes directrices japonaises sur l'IA pour les entreprises sont volontaires et ne prescrivent pas le déploiement local. Le ministère de l'Économie, du Commerce et de l'Industrie (METI) et le ministère de l'Intérieur et des Communications (MIC) ont publié les AI Guidelines for Business (version 1.0, 19 avril 2024 ; annonce du METI). Exécuter un modèle en local peut garder les données clients dans les systèmes de l'organisation, ce qui soutient les attentes de ces lignes directrices en matière de gestion des données ; le respect de ces attentes dépend de l'organisation dans son ensemble, pas du seul modèle. Les modèles compatibles avec la tokenisation japonaise (Qwen3.8-27B, ELYZA) peuvent être privilégiés pour le traitement interne de textes en japonais.
Les industries réglementées aux États-Unis (santé, finance, gouvernement) exigent l'inférence uniquement locale. Les entités couvertes par la HIPAA évitent les API cloud pour les données des patients. Les institutions financières en vertu de la GLBA et de la SOX utilisent des modèles locaux isolés par air-gap pour l'analyse des transactions. Les agences fédérales vérifient que les licences de modèle de poids ouvert (Apache 2.0, Llama Community License, licence Gemma) permettent l'utilisation gouvernementale.
Questions fréquemment posées sur le choix des LLMs locaux
Quel est le meilleur LLM local en 2026 ?
Qwen3.8-27B est le meilleur global (89,2 % GPQA Diamond, 61,7 % SWE-bench Pro, ~24 GB RAM, contexte 262K). Gemma 4 26B-A4B est le meilleur pour le raisonnement (88,3 % AIME 2026, 16–19 GB RAM). Qwen2.5-Coder 7B est le meilleur pour le code (~5 GB RAM). Phi-4-mini est le meilleur en CPU uniquement (~2.5 GB RAM). Gemma 4 E2B est le meilleur petit modèle (~2 GB RAM).
Combien de RAM faut-il pour Qwen3.8-27B ?
Environ 24 GB avec la quantification Q4_K_M. Une GPU avec 24 GB de VRAM (RTX 4090, RTX 3090) ou un Mac avec 32 GB+ de mémoire unifiée (macOS en réserve environ 8 GB) convient ; c'est juste sur les cartes 16 GB. Il est déjà disponible officiellement dans la bibliothèque Ollama : `ollama pull qwen3.8:27b`.
Gemma 4 26B-A4B est-il meilleur que Qwen3.8-27B ?
Cela dépend de la tâche. Gemma 4 26B-A4B est le seul des deux à publier un score AIME 2026 (88,3 %), et sa conception Mixture-of-Experts lui donne une vitesse proche d'un modèle 4B. Sur les benchmarks publiés par les deux éditeurs, Qwen3.8-27B est devant : GPQA Diamond 89,2 % contre 82,3 % et LiveCodeBench v6 90,3 % contre 77,1 % (chiffres annoncés par chaque éditeur, avec sa propre configuration d'évaluation). Pour un usage général (écriture, analyse, multilingue, vision), Qwen3.8-27B est plus polyvalent et nativement multimodal. Gemma 4 26B-A4B nécessite 16–19 GB (taille de téléchargement Ollama) contre ~24 GB RAM pour Qwen3.8-27B.
Quel est le meilleur LLM local pour 8 GB de RAM ?
Phi-4-mini (~2.5-3.5 GB) est le meilleur choix pour 8 GB de RAM, laissant de la marge pour le système. Ni Qwen3.8-27B (~24 GB) ni Gemma 4 26B-A4B (16–19 GB) ne tiennent dans 8 GB.
Quel est le meilleur LLM local pour le code en 2026 ?
Qwen2.5-Coder 7B (88 % HumanEval, ~5 GB RAM) est un choix solide sous 10 GB de RAM ; il a été entraîné spécifiquement sur du code. Avec 24 GB de RAM ou plus, Qwen3.8-27B (61,7 SWE-bench Pro selon Qwen, 18 GB) est le choix le plus puissant pour le code, et Devstral Small 2 (15 GB) convient aux machines de 16 GB.
Quels nouveaux modèles locaux sont arrivés depuis septembre ?
Trois ajouts notables sur Ollama : Gemma 4 propose désormais aussi un modèle de 12B (contexte 256K, environ 8 GB) et un modèle dense de 31B (contexte 256K, 19–20 GB) en plus de E2B, E4B et 26B-A4B ; NVIDIA Nemotron 3.5 Lightning (`ollama run nemotron-3.5-lightning`) est un modèle à mélange d'experts de 30B avec 3B actifs, 19–25 GB, conçu pour des agents toujours actifs avec jusqu'à 1M de contexte ; et IBM Granite 4.2 (`ollama run granite4.2`, Apache 2.0, contexte 128K) existe en 3B (2,2 GB), 8B (5,3 GB) et 30B (18 GB). Aucun ne change les choix ci-dessus : Qwen3.8-27B reste le meilleur choix global pour 24 GB, mais Granite 4.2 8B et Gemma 4 12B méritent un essai sur les machines de 8 à 16 GB.
Ces modèles sont-ils gratuits pour un usage commercial ?
Oui. Qwen3.8-27B, Qwen2.5-Coder 7B et Gemma 4 (26B-A4B et E2B) sont sous licence Apache 2.0 d'après leurs fiches de modèle officielles ; Phi-4-mini est sous licence MIT.
Que signifie la quantification Q4_K_M ?
Elle compresse les poids du modèle à une précision de 4 bits. Qwen3.8-27B passe ainsi de ~56 GB (BF16 complet) à ~24 GB avec une perte de qualité minimale. Ollama l'applique automatiquement par défaut.
Puis-je exécuter ces modèles entièrement hors ligne ?
Oui. Les cinq modèles s'exécutent via Ollama, 100 % en local, sans aucune connexion internet après le téléchargement.
Pourquoi le tableau de benchmarks n'indique-t-il pas de score MMLU, HumanEval ou AIME pour Qwen3.8-27B ?
La fiche modèle officielle de Qwen3.8-27B, publiée par Alibaba, ne communique aucun score MMLU, HumanEval ou AIME pour ce modèle -- ces données sont réellement non divulguées, ce n'est pas une omission de cette page. Les benchmarks publiés par Alibaba sont GPQA Diamond (89,2 %), SWE-bench Pro (61,7 %), LiveCodeBench v6 (90,3 %) et Terminal-Bench 2.1 (73,0 %), tous indiqués ci-dessus. Pour un modèle de taille comparable avec un score MMLU/HumanEval publié, Qwen2.5-Coder 7B (88 % HumanEval) et Phi-4-mini (67,3 % MMLU) communiquent ces chiffres. Pour les autres tailles de Qwen3 (8B, 14B, 32B) et la comparaison avec DeepSeek et Llama, consultez Qwen vs Llama vs Mistral.
Quels sont les scores HumanEval, GSM8K et AIME de la famille Qwen3, et quel est son classement dans le Hugging Face Open LLM Leaderboard ?
Les scores officiels publiés par l'équipe Qwen (Technical Report) sont : Qwen3-8B obtient 72,0 % sur HumanEval et 84,2 % sur GSM8K ; Qwen3-32B (post-entraîné) obtient 81,4 % sur AIME 2024 et 72,9 % sur AIME 2025. Ces chiffres sont distincts du choix Qwen3.8-27B mentionné plus haut -- la fiche modèle Qwen3.8-27B d'Alibaba ne publie pas de score HumanEval, GSM8K ou MMLU pour ce modèle précis (voir la question précédente), donc pour comparer les tailles de Qwen3 à DeepSeek ou Llama sur ces benchmarks exacts, utilisez les scores Qwen3-8B/32B ci-dessus, pas les champs non divulgués de Qwen3.8-27B. Pour des classements de modèles ouverts mis à jour en continu entre Qwen, DeepSeek et Llama sur MMLU, HumanEval et MATH, consultez le Hugging Face Open LLM Leaderboard en direct -- les positions évoluent à chaque nouveau checkpoint soumis, donc cette page rapporte ce que la fiche officielle de chaque laboratoire divulgue, plutôt qu'un instantané d'un classement en direct qui serait obsolète en quelques jours.
Comment ces modèles se comparent-ils aux modèles frontier cloud actuels ?
Qwen3.8-27B et Gemma 4 26B-A4B approchent d'anciens modèles frontier sur le texte, mais les modèles frontier actuels restent devant sur le raisonnement complexe et la vision. Choisissez le local pour la confidentialité, le coût et la vitesse.
Erreurs courantes lors du choix de modèles 2026
- Choix basé uniquement sur les benchmarks -- la performance réelle sur votre tâche peut être nettement différente. Testez toujours les modèles sur votre cas d'usage spécifique.
- Ne pas tester les résultats du modèle sur votre cas d'usage spécifique avant le déploiement en production.
- Oublier de vérifier les restrictions de licence pour l'utilisation commerciale -- la Llama Community License, la licence Gemma et Apache 2.0 ont des restrictions différentes.
- Supposer qu'un modèle plus grand est toujours meilleur -- les modèles quantisés plus petits (4 bits) surpassent souvent les modèles plus grands non quantisés en pratique.
- Ne pas mettre à jour votre liste de modèles locaux régulièrement -- de nouvelles versions (Qwen3.8-27B, Gemma 4 26B-A4B, Qwen2.5-Coder) deviennent disponibles régulièrement et améliorent la performance.
- Supposer que les « paramètres actifs » d'un modèle MoE déterminent son besoin en RAM -- pour Gemma 4 26B-A4B et les modèles MoE similaires, chaque expert doit être chargé en mémoire avant l'inférence ; prévoyez la RAM en fonction du total de paramètres, pas du nombre actif.
Vous n'êtes pas sûr que local soit le bon choix ?
Avant de choisir entre Qwen3.8-27B, Gemma 4 ou Qwen2.5-Coder 7B, confirmez que l'inférence locale correspond à vos besoins. Comparez les LLMs locaux avec les APIs cloud pour comprendre le compromis complet — vous découvrez peut-être qu'une API cloud est moins chère, plus rapide ou plus pratique pour votre cas d'usage spécifique, surtout si vous avez besoin d'accès à l'information en temps réel ou de raisonnement frontier.
Les meilleurs modèles locaux échangent la vitesse et la complexité d'installation contre la confidentialité et le contrôle des coûts. Si vous avez un matériel limité (< 16 GB RAM), une connexion internet peu fiable ou des tâches nécessitant des connaissances actualisées, les APIs cloud peuvent être le meilleur choix.
Une fois un modèle choisi, l'étape suivante pour la plupart des lecteurs est de le connecter à votre machine. Voir Agents IA locaux avec MCP pour le protocole qui transforme n'importe lequel des modèles ci-dessus en un agent capable de lire des fichiers, d'interroger des bases de données et de piloter un navigateur.
Sources
- Hugging Face Open LLM Leaderboard -- huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard -- Classements de benchmarks en temps réel pour les modèles de poids ouvert
- Ollama Model Library -- ollama.com/library -- Modèles disponibles avec tailles de téléchargement et commandes Ollama
- Qwen3.8-27B Model Card -- huggingface.co/Qwen/Qwen3.8-27B -- Spécifications officielles Alibaba, licence et détails de benchmark (vision-langage)
- Qwen Team, "Qwen3 Technical Report" -- arxiv.org/abs/2505.09388 -- Scores officiels HumanEval, GSM8K et AIME pour les modèles de base Qwen3-8B et Qwen3-32B.
- Gemma 4 26B-A4B -- ollama.com/library/gemma4:26b -- Carte de modèle et exigences matérielles
- Qwen2.5-Coder Model Card -- huggingface.co/Qwen/Qwen2.5-Coder-7B -- Spécifications du modèle de code et benchmarks