Quel est le modèle le plus rapide pour votre matériel ?
Adaptez votre matériel au bon modèle — le mauvais choix laisse 4–10× de vitesse sur la table. Tous les niveaux ci-dessous sont CPU seul sauf indication contraire. Les vitesses sont des estimations de PromptQuorum pour une RAM double canal, pas des mesures de laboratoire ; avec une RAM simple canal ou un portable DDR4 ancien, attendez-vous à moins.
Votre matériel | Modèle recommandé | Commande Ollama | Vitesse attendue |
|---|---|---|---|
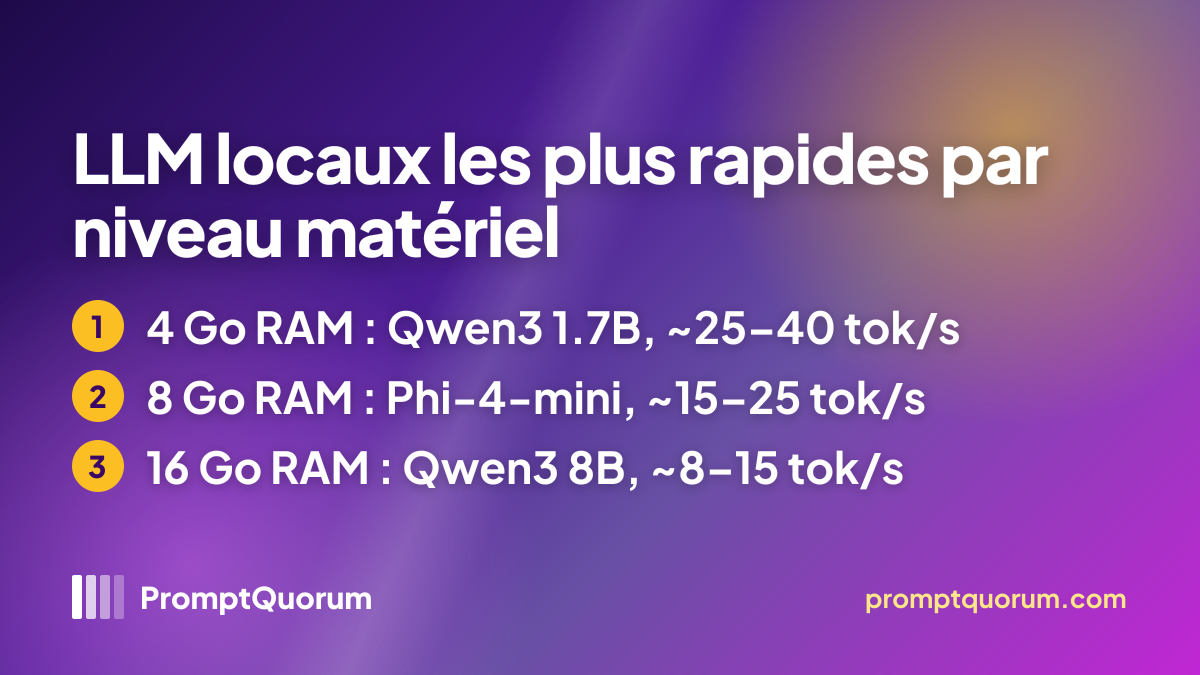
| 4 Go RAM, CPU seul | Qwen3 1.7B Q4_K_M | ollama run qwen3:1.7b | 25–40 tok/s |
| 8 Go RAM, CPU seul | Phi-4-mini 3.8B Q4_K_M | ollama run phi4-mini | 15–25 tok/s |
| 8 Go RAM + iGPU Intel Iris | Qwen3 4B Q4_K_M | ollama run qwen3:4b | 12–20 tok/s |
| 16 Go RAM, CPU seul | Qwen3 8B Q4_K_M | ollama run qwen3:8b | 8–15 tok/s |
| 16 Go RAM + iGPU | Llama 3.2 3B Q4_K_M | ollama run llama3.2:3b | 20–35 tok/s |
Quel modèle devriez-vous utiliser ?
Associez votre situation au bon modèle — c'est la décision la plus importante :
- Portable avec 8 Go de RAM (sans GPU dédié) : Phi-4-mini (3.8B) en Q4_K_M — 15–25 tok/s, gère le code et le raisonnement. `ollama run phi4-mini`
- 4 Go de RAM, PC très ancien : Qwen3 1.7B Q4_K_M — 25–40 tok/s, la réponse la plus rapide avec un minimum de RAM. `ollama run qwen3:1.7b`
- 16 Go de RAM, sans GPU : Qwen3 8B Q4_K_M — 8–15 tok/s, qualité solide. `ollama run qwen3:8b`
- 8 Go de RAM + iGPU Intel Iris : Qwen3 4B — est. 12–20 tok/s si Ollama utilise l'iGPU (lancez `ollama ps` et lisez la colonne PROCESSOR). `ollama run qwen3:4b`
- Vous voulez un long contexte : Qwen3 4B (contexte 256K sur Ollama) ou Llama 3.2 3B (128K). Qwen3 1.7B et 8B sont listés avec 40K.
- Génération plus récente, fichiers les plus petits : Qwen3.5 0.8B (1.2 Go sur Ollama) est plus petit que Qwen3 1.7B (1.4 Go) ; il devrait donc tourner plus vite sur le même CPU, avec une qualité moindre. Qwen3.5 2B (2.7 Go) et 4B (3.3 Go) ont des fichiers plus gros que Phi-4-mini (2.5 Go) et Qwen3 4B (2.5 Go) : attendez-vous à des vitesses plus basses. `ollama run qwen3.5:0.8b`. PromptQuorum n'a pas chronométré Qwen3.5 sur le matériel de ce guide.
- À tester aussi avec 8 Go de RAM : Gemma 4 E2B (Google, sorti en avril 2026). Il compte environ 2.3B de paramètres effectifs, mais le téléchargement Ollama démarre à 4.6 Go à cause de ses tables d'embedding : ce n'est donc pas un modèle de 1.5–2 Go. `ollama run gemma4:e2b`. Voir le guide des modèles CPU uniquement pour les vitesses estimées selon le type de mémoire.
- Pour des recommandations par niveau de RAM et la gestion thermique, voir comment faire tourner un LLM local sur un portable.
Quel LLM local faire tourner sur votre matériel ?
Tous les niveaux ci-dessous sont CPU seul ou iGPU. Choisissez le plus grand modèle qui tient dans votre RAM en Q4_K_M, en gardant de la marge pour le système d'exploitation et le contexte. Les vitesses sont des estimations.
Hardware | Model | Quant | Speed | Experience |
|---|---|---|---|---|
| 4 Go RAM, CPU seul | Qwen3 1.7B | Q4_K_M | 25–40 t/s | rapide, qualité utilisable |
| 8 Go RAM, CPU seul | Phi-4-mini 3.8B | Q4_K_M | 15–25 t/s | code + raisonnement |
| 8 Go RAM + iGPU Iris | Qwen3 4B | Q4_K_M | 12–20 t/s | si l'iGPU est utilisé |
| 16 Go RAM, CPU seul | Qwen3 8B | Q4_K_M | 8–15 t/s | qualité solide |
| 16 Go RAM + iGPU | Llama 3.2 3B | Q4_K_M | 20–35 t/s | si l'iGPU est utilisé |

GPU vs CPU pour les LLMs locaux : lequel est plus rapide sur matériel bas de gamme ?
GPU dédié : généralement 5–10× plus rapide que le CPU seul pour le même modèle, car la VRAM offre bien plus de bande passante mémoire que la RAM système. Une RTX 4060 8 Go d'occasion (prix variable) est une mise à niveau économique courante. Consultez le guide GPU budget pour des options économiques.
iGPU (graphiques intégrés) : partage la RAM système avec le CPU, donc la principale limite — la bande passante mémoire — reste la même. Le gain est généralement modeste et dépend de la prise en charge des pilotes. La documentation d'Ollama indique que la prise en charge GPU Vulkan sous Windows et Linux est activée par défaut lorsque le backend est installé, et cite les iGPU AMD Ryzen AI sous ROCm ; elle ne répertorie pas les GPU intégrés Intel dans un tableau de prise en charge. Vérifiez avec `ollama ps` : la colonne PROCESSOR indique si le modèle tourne sur CPU, GPU ou en mode partagé.
CPU seul : fonctionne sur n'importe quel PC sans configuration de pilote. La vitesse est à peu près la bande passante mémoire ÷ la taille du fichier du modèle, d'où l'importance de la RAM double canal et d'un petit fichier Q4_K_M, plus que de la fréquence du CPU.
Règle : Utilisez un GPU dédié si vous en avez un. Sinon, lancez le même prompt avec l'iGPU activé puis désactivé (`OLLAMA_VULKAN=0` désactive les GPU Vulkan) et gardez le réglage le plus rapide.

Pourquoi les modèles plus petits sont plus rapides sur PC bas de gamme
La taille du modèle détermine directement la vitesse. Un modèle 1B–3B tient entièrement en RAM système, permettant au CPU ou GPU de diffuser les données en continu. Les modèles plus grands nécessitent un échange mémoire — déplacer des données entre la RAM et le disque — ce qui ralentit fortement la génération (le goulot d'étranglement est l'E/S disque, pas le calcul).
Le tableau de décision matérielle ci-dessus illustre ce principe : les plus petits fichiers donnent la vitesse la plus élevée, tandis que les modèles 13B+ sont impraticables sur matériel bas de gamme car l'échange mémoire domine.
- Modèles 1B–3B : Tiennent en 4–8 Go RAM → génération la plus rapide → qualité acceptable
- Modèles 7B : À la limite sur systèmes 8 Go → plus lents par pression mémoire → qualité élevée
- Modèles 13B+ : Nécessitent 16+ Go de RAM ou un swap massif → trop lents pour un usage interactif sur PC bas de gamme
À quelle vitesse fonctionnent les LLMs locaux sur PC bas de gamme ?
Sur systèmes CPU seul, attendez-vous à ces plages estimées :
- Modèles 3B → 15–40 tokens/sec (anciens CPU : 10–15, systèmes DDR5 double canal récents : 30–40)
- Modèles 7B–8B → 8–15 tokens/sec (Q4_K_M en RAM double canal ; la RAM simple canal donne moins)
- Estimez votre propre vitesse avec une seule division. Générer chaque token exige de lire une fois tout le modèle depuis la RAM : les tokens par seconde ne peuvent donc jamais dépasser la bande passante mémoire ÷ la taille du fichier du modèle. Bande passante crête = débit de transfert (MT/s) × 8 octets × nombre de canaux.
- Exemples chiffrés (des plafonds, pas des prévisions) : de la DDR4-3200 double canal donne 3200 × 8 × 2 = 51.2 Go/s ; divisé par le fichier de 2.5 Go de Phi-4-mini, cela donne environ 20 tok/s au maximum. De la DDR5-5600 double canal donne 89.6 Go/s, soit environ 36 tok/s au maximum pour le même fichier. Un portable en DDR4-3200 simple canal donne 25.6 Go/s, soit environ 10 tok/s au maximum. La vitesse réelle est inférieure au plafond.
- Les mini PC Intel N100 n'ont qu'un seul canal mémoire (spécifications Intel : DDR4-3200, DDR5-4800 ou LPDDR5-4800). Avec de la DDR4-3200, le plafond pour le fichier de 1.4 Go de Qwen3 1.7B est d'environ 18 tok/s ; avec de la DDR5-4800, d'environ 27 tok/s. Attendez-vous à ce que le N100 reste en dessous des plages double canal de ce guide.
- C'est plus lent que les chatbots cloud, mais suffisant pour un usage interactif. Un modèle 3B à 25 tok/sec génère une réponse de 500 tokens en 20 secondes — acceptable pour des tâches non urgentes comme la revue de code, la synthèse et l'écriture créative.
Comment la quantification affecte-t-elle la vitesse sur PC bas de gamme ?
Q4 (4 bits) : le choix standard — environ un quart de la taille du fichier en 16 bits, avec une petite perte de qualité sur la plupart des tâches. Consultez le guide quantification pour tous les niveaux et leur fonctionnement.
Q3 (3 bits) : un fichier plus petit et une perte de qualité plus importante qu'en Q4. Acceptable pour le chat lorsque Q4 ne tient pas en RAM.
Q2 (2 bits) : le fichier le plus petit et la perte de qualité la plus importante. Risqué ; à utiliser uniquement si Q4 et Q3 manquent de mémoire.
Impact vitesse : comme le décodage CPU est limité par la bande passante mémoire, un fichier plus petit génère plus vite, à peu près dans la même proportion. Les fichiers Q3 et Q2 sont plus rapides que Q4, mais la baisse de qualité ne vaut généralement pas le coup sur des modèles aussi petits.
Stratégie : choisissez d'abord la taille du modèle, puis utilisez Q4_K_M. Un petit modèle en Q4_K_M bat généralement un modèle plus gros écrasé en Q2, qui perd en précision et demande quand même plus de RAM.
Les modèles plus rapides sacrifient la qualité pour la vitesse — mais en réglant la température et le top-p, vous pouvez récupérer beaucoup de cette qualité. Une température plus basse (0,1–0,3) sur les modèles rapides produit une sortie plus cohérente que les paramètres par défaut. Consultez température et top-p expliqués pour les paramètres exacts.

Comment accélérer l'inférence CPU seul ?
- Remplir les deux canaux mémoire : deux barrettes de RAM identiques doublent la bande passante crête par rapport à une seule barrette, ce qui est la plus grosse accélération possible sur un PC CPU seul. Les portables et mini PC à barrette unique tournent à la moitié du plafond.
- Réduire la fenêtre de contexte : le cache KV grandit avec la longueur du contexte. Définissez `OLLAMA_CONTEXT_LENGTH=2048` (la valeur par défaut d'Ollama est 4096), ou `/set parameter num_ctx 2048` dans `ollama run`.
- Quantifier le cache KV : `OLLAMA_FLASH_ATTENTION=1` avec `OLLAMA_KV_CACHE_TYPE=q8_0` divise grosso modo par deux la mémoire du cache KV par rapport au f16 par défaut, ce qui aide surtout les machines de 4 Go et 8 Go.
- Garder le modèle chargé : Ollama décharge un modèle après 5 minutes par défaut. `OLLAMA_KEEP_ALIVE=30m` évite de recharger le fichier à chaque session.
- Fermer les applications gourmandes en mémoire : un navigateur avec de nombreux onglets pousse le modèle vers le swap, ce qui ralentit la génération de nombreuses fois.
- Tester l'iGPU : lancez `ollama ps` pendant qu'un modèle est chargé. Si PROCESSOR affiche 100 % CPU, comparez avec une exécution sur GPU ; si l'iGPU est instable, définissez `OLLAMA_VULKAN=0`.
Peut-on faire tourner du RAG local avec 2 Go de RAM ?
Oui, pour de petits corpus de documents : Qwen3 0.6B (523 Mo sur Ollama) pour les réponses et le modèle d'embedding nomic-embed-text (274 Mo) pour la recherche demandent environ 0.8 Go de fichiers de modèle au total. Cela tient si 2 Go de RAM sont réellement libres, par exemple sur une installation Linux légère, un vieux netbook ou un PC dont les autres applications sont fermées. Attendez-vous à des réponses simples tirées de vos documents, pas à un raisonnement poussé.
- Modèle de chat : `ollama pull qwen3:0.6b` (523 Mo, contexte 40K sur Ollama). Avec un peu plus de RAM libre, `qwen3.5:0.8b` (1.2 Go) est la petite option plus récente.
- Modèle d'embedding : `ollama pull nomic-embed-text` (274 Mo, fenêtre de contexte de 2K). Découpez les documents en blocs de quelques centaines de tokens pour que chaque bloc tienne dans la fenêtre de 2K.
- Récupérer peu de blocs : ne transmettez au modèle de chat que les 2–3 meilleurs blocs correspondants. Chaque bloc supplémentaire allonge le contexte et fait grossir le cache KV.
- Garder le contexte court : définissez `OLLAMA_CONTEXT_LENGTH=2048` pour que le cache KV reste petit.
- Vérifier les réponses : un modèle 0.6B sait extraire un fait d'un passage récupéré, mais raisonne mal en plusieurs étapes ; vérifiez donc les réponses importantes dans le passage source.
- Quand 2 Go est trop juste : passez à Qwen3 1.7B (1.4 Go) avec 4 Go de RAM, ou à Phi-4-mini avec 8 Go, en gardant le même modèle d'embedding.
À quelle vitesse tournent ces modèles ? Vitesses estimées
Vitesses estimées par classe de matériel, pas des mesures de laboratoire. Ces plages sont des approximations propres à PromptQuorum, dérivées du plafond de bande passante mémoire de chaque classe, avec les paramètres par défaut d'Ollama et des fichiers Q4_K_M. Considérez-les comme des plafonds pour une installation saine ; la sortie de votre propre `ollama run <model> --verbose` indique les vrais tokens par seconde :
- Mini PC Intel N100 (RAM simple canal, niveau 4 Go) + Qwen3 1.7B Q4_K_M : jusqu'à environ 18 tok/s en DDR4-3200 et environ 27 tok/s en DDR5-4800 (plafonds de bande passante). `ollama run qwen3:1.7b`
- i5/Ryzen 5 récent à double canal (niveau 4 Go) + Qwen3 1.7B Q4_K_M : est. 25–40 tok/s. `ollama run qwen3:1.7b`
- Portable de classe Core i5-1235U (8 Go de RAM) + Phi-4-mini Q4_K_M : est. 15–22 tok/s en LPDDR5 ; les portables DDR4 donnent moins. `ollama run phi4-mini`
- PC de bureau de classe Ryzen 5 5600G (8 Go de RAM) + Qwen3 4B Q4_K_M : est. 15–20 tok/s (le plafond du DDR4-3200 double canal est d'environ 20) ; une iGPU partage la même bande passante RAM, n'en attendez donc pas plus.
- Portable de classe Intel Iris Xe (8 Go de RAM) + Qwen3 4B Q4_K_M : est. 12–18 tok/s. `ollama run qwen3:4b`
- PC de bureau de classe Ryzen 7 7700X (16 Go de RAM, DDR5 double canal) + Qwen3 8B Q4_K_M : est. 8–13 tok/s. `ollama run qwen3:8b`
- Portable de classe Iris Xe (16 Go de RAM) + Llama 3.2 3B Q4_K_M : est. 20–30 tok/s. `ollama run llama3.2:3b`
Qu'est-ce qui est vraiment « rapide » pour les LLMs locaux ?
La perception de la vitesse varie selon la tâche — utilisez ceci comme référence :
Si votre modèle tourne sous 15 tok/s, réduisez la taille du modèle (7B → 3B) ou descendez d'un niveau de quantification (Q5 → Q4) avant d'acheter du nouveau matériel.
- Sous 10 tok/s → semble cassé. Les mots apparaissent un par un avec des pauses perceptibles. Inutilisable pour le chat interactif.
- 15–25 tok/s → acceptable. Vitesse lisible pour la plupart des utilisateurs. Bon pour les Q&R, résumés et aide au code.
- 30+ tok/s → fluide. Se ressent comme un véritable assistant. Confortable pour toutes les tâches interactives.
- 60+ tok/s → instantané. Plus rapide que la lecture. Idéal pour l'autocomplétion en temps réel et l'itération rapide.

Ce qu'il faut éviter sur PC bas de gamme
- N'exécutez pas de modèles 13B+ — ils dépassent les limites RAM. Un modèle 13B en Q4 demande environ 8 Go rien que pour le fichier, ce qui dépasse ce qu'un PC de 8 Go peut contenir une fois le système d'exploitation compté. Restez sur 8B et moins avec 16 Go, et sur 4B et moins avec 8 Go.
- Évitez la quantification Q8 — plus lente pour un gain de qualité minimal. Q8 double à peu près la taille du fichier de Q4, et un fichier plus gros signifie moins de tokens par seconde sur un CPU limité par la bande passante. Pour les systèmes 4 Go, Q8 est impraticable ; pour 8 Go, Q4 reste optimal. Q3 est le seul compromis à envisager quand Q4 manque de mémoire.
- N'attendez pas une autocomplétion en temps réel. À 3 tok/sec sur CPU, générer 50 tokens prend environ 17 secondes. L'autocomplétion interactive demande des vitesses bien supérieures. Les LLMs locaux sur CPU bas de gamme conviennent au chat par lots, aux brouillons et à la révision — pas à l'autocomplétion en direct ni au code au fil de la frappe.
- N'utilisez pas l'inférence CPU seul pour des chatbots en production. Acceptable pour les outils internes, les prototypes et le travail par lots hors ligne. Un CPU bas de gamme sert un seul utilisateur à la fois et lentement, alors qu'une API hébergée passe à l'échelle pour de nombreux utilisateurs. Utilisez l'inférence locale pour les scénarios critiques en confidentialité ou hors ligne, pas pour les scénarios critiques en vitesse.
Erreurs courantes
- Erreur : Utiliser une seule barrette de RAM. Problème : un seul canal mémoire divise par deux la bande passante crête, donc le même modèle génère environ deux fois plus lentement. Solution : installez deux barrettes identiques (ou achetez un mini PC double canal) avant d'acheter un CPU plus rapide.
- Erreur : Juger la vitesse d'après le seul modèle de CPU. Problème : un CPU plus récent sur de la DDR4 simple canal lente peut être plus lent qu'un CPU plus ancien sur de la DDR5 double canal, car la génération de tokens est limitée par la bande passante mémoire. Solution : comparez la vitesse et les canaux de la RAM, puis lisez le chiffre réel dans `ollama run <model> --verbose`.
- Erreur : Forcer Q2 pour faire tenir un 7B dans 4 Go. Problème : La quantification Q2 provoque souvent des crashs OOM à cause du surcoût du cache KV pendant l'inférence, et la qualité de sortie chute fortement. Solution : Utilisez un modèle 3B en Q4 à la place.
- Erreur : Laisser la fenêtre de contexte grande. Problème : un contexte long fait grossir le cache KV et pousse une petite machine vers le swap. Solution : définissez `OLLAMA_CONTEXT_LENGTH=2048` sauf si vous avez besoin de longs documents.
- Erreur : Utiliser le mauvais slug Ollama pour votre modèle. Problème : `ollama run phi` charge Phi-2, pas Phi-4-mini. Solution : Utilisez `ollama run phi4-mini` pour le modèle Phi mini actuel. Vérifiez toujours ollama.com/library pour les tags de modèle exacts.
LLMs locaux sur PC bas de gamme : contexte régional
UE / RGPD : Local sur matériel d'entrée de gamme : en fonctionnement hors ligne, aucune donnée d'inférence ne quitte l'appareil — pour beaucoup de PME et d'indépendants, une méthode techniquement simple pour éviter les risques de transfert de l'art. 44 RGPD. L'application du règlement européen sur l'IA ou d'autres obligations à votre usage dépend de qui déploie le système et dans quel but ; ce guide ne constitue pas un conseil juridique. Pour les données professionnelles sensibles (financières, médicales, juridiques), garder les documents sur l'appareil évite de les confier à un sous-traitant tiers, et la CNIL publie des ressources sur l'IA et le RGPD à consulter. La conformité globale en matière de protection des données dépend cependant de l'ensemble de votre fonctionnement, et pas seulement de l'architecture d'inférence.
Japon : Les lignes directrices IA du METI pour les entreprises insistent sur une gestion responsable des données. L'inférence CPU sur matériel bas de gamme, même lente, garde vos prompts sur l'appareil — une fois le modèle téléchargé, l'inférence elle-même ne nécessite aucun appel API. Pour des tâches en japonais avec Qwen3 aux vitesses CPU indiquées ci-dessus, quelques secondes par phrase restent acceptables pour des résumés de documents non urgents.
Chine : L'inférence locale de Qwen3 et de versions distillées de DeepSeek-R1 sur matériel grand public est une option pour les utilisateurs en Chine qui ne peuvent pas accéder aux API cloud de modèles non chinois. Qwen3 0.6B, 1.7B et 4B fonctionnent sur matériel CPU seul, offrant une alternative fonctionnelle aux API cloud pour les utilisateurs avec un matériel limité.
Questions fréquentes sur l'exécution de LLMs locaux sur PC bas de gamme
Qu'est-ce qui qualifie un PC comme bas de gamme pour les LLMs locaux ?
Un PC bas de gamme pour les LLMs locaux est toute machine CPU seul (sans GPU dédié) avec 4–16 Go de RAM système. Cela inclut la plupart des portables avec graphiques intégrés Intel Iris ou AMD Radeon, les vieux PC de bureau sans GPU dédié, et les mini PC comme l'Intel N100. La contrainte clé est la RAM système pour les poids du modèle, pas la fréquence du CPU.
Puis-je faire tourner un modèle de classe 7B sans aucun GPU ?
Oui — Qwen3 8B en Q4_K_M tourne à 8–15 tok/s estimés avec 16 Go de RAM, CPU seul (estimation pour un poste de bureau double canal de classe Ryzen 7 7700X). C'est plus lent que les options plus petites mais offre une qualité nettement meilleure. Avec 8 Go de RAM, préférez plutôt Phi-4-mini (3.8B) — un modèle 8B en Q4_K_M a besoin d'une marge qu'un système 8 Go ne garantit pas toujours de façon fiable.
L'inférence CPU est-elle utilisable pour les chatbots ?
Oui, pour un usage interactif si vous choisissez la bonne taille de modèle. Phi-4-mini à 15–25 tok/s (8 Go de RAM) et Qwen3 1.7B à 25–40 tok/s (4 Go de RAM) sont tous deux assez rapides pour le chat en temps réel. Un modèle de classe 7B sur CPU (8–15 tok/s) convient mieux aux tâches par lots — rédaction, résumés, révision hors ligne — qu'à la conversation en direct.
Dois-je utiliser Phi-4-mini ou Qwen3 1.7B sur du matériel CPU seul ?
Utilisez Phi-4-mini (3.8B) si vous avez 8 Go de RAM — il gère le code et le raisonnement à 15–25 tok/s. Utilisez Qwen3 1.7B si vous n'avez que 4 Go de RAM ou voulez la réponse la plus rapide possible (25–40 tok/s) au prix d'un peu de qualité sur les tâches complexes.
Comment vérifier si j'ai un GPU quelconque ?
Exécutez `nvidia-smi` dans le terminal pour les GPU NVIDIA dédiés. Si la réponse est « command not found », vérifiez `lspci` (Linux) ou le Gestionnaire de périphériques (Windows) pour une iGPU Intel Iris Xe ou AMD Radeon — la capacité d'Ollama à l'utiliser dépend du support des pilotes et du backend ; confirmez-le avec `ollama ps`.
Comment la quantification affecte-t-elle la vitesse d'inférence ?
La quantification réduit principalement les besoins en bande passante mémoire, pas le calcul. Un fichier Q2 (2 bits) est plus petit qu'un fichier Q4 (4 bits) : le CPU lit donc moins d'octets par token et génère plus vite, à peu près en proportion de la taille du fichier. Cependant, Q2 perd beaucoup plus en qualité de sortie. Règle pratique : utilisez Q4_K_M par défaut pour chaque niveau de ce guide, ne descendez à Q3 que si Q4_K_M ne tient pas dans la RAM disponible.
Puis-je quantifier en dessous de Q2 ?
Techniquement oui (des formats IQ1 à 1 bit existent dans llama.cpp), mais la qualité de sortie s'effondre à cette taille. Non recommandé pour aucun cas d'usage pratique, y compris le niveau 4 Go de RAM de ce guide — choisissez plutôt un modèle plus petit en Q4_K_M.
L'inférence hybride CPU + iGPU est-elle supportée ?
Parfois. Ollama peut répartir un modèle entre CPU et GPU lorsqu'il trouve un backend GPU pris en charge, et `ollama ps` affiche la répartition dans sa colonne PROCESSOR. Une iGPU partage la RAM système avec le CPU : la bande passante mémoire, principale limite de vitesse, n'augmente donc pas. Sur un système 8 Go de RAM avec iGPU Intel Iris Xe, Qwen3 4B est estimé à 12–20 tok/s si l'iGPU est utilisée. Testez avec `OLLAMA_VULKAN=0` pour comparer avec le CPU seul.
Quel est le LLM local le plus rapide pour un PC bas de gamme ?
Qwen3 1.7B en Q4_K_M est le plus rapide des modèles recommandés par palier dans ce guide (des modèles plus petits, comme Qwen3 0.6B, sont encore plus rapides, mais de bien moindre qualité) — environ 25–40 tok/s estimés sur un i5/Ryzen 5 récent avec 4 Go de RAM et sans GPU. Pour une meilleure qualité à une vitesse similaire, Phi-4-mini (3.8B) tourne à 15–25 tok/s avec 8 Go de RAM et gère le code et le raisonnement nettement mieux.
Puis-je faire tourner un LLM local avec 4 Go de RAM ?
Oui — Qwen3 1.7B en Q4_K_M est le choix recommandé pour 4 Go de RAM, CPU seul, atteignant 25–40 tok/s sur un i5/Ryzen 5 récent. C'est le plus rapide des modèles recommandés par palier dans ce guide et il tient avec une marge pour l'OS.
Un GPU est-il nécessaire pour la vitesse ?
Non — tous les modèles de ce guide tournent en CPU seul. Une iGPU Intel Iris peut apporter un gain de vitesse modeste (Qwen3 4B : est. 12–20 tok/s si l'iGPU est utilisée) mais reste optionnelle et dépend de la prise en charge des pilotes. Un GPU dédié comme une RTX 4060 8 Go d'occasion est généralement 5–10× plus rapide qu'en CPU seul pour le même modèle, mais c'est une voie de mise à niveau séparée, pas un prérequis.
Une iGPU Intel Iris est-elle suffisante pour les LLM locaux ?
Cela peut aider, mais ce n'est pas garanti. Avec 8 Go de RAM et une iGPU Intel Iris Xe, Qwen3 4B est estimé à 12–20 tok/s si Ollama utilise réellement l'iGPU ; avec 16 Go de RAM, Llama 3.2 3B est estimé à 20–35 tok/s. Comme une iGPU partage la RAM système avec le CPU, le gain est généralement modeste. Lancez le même prompt avec et sans l'iGPU et gardez le réglage le plus rapide.
Devrais-je utiliser la quantification Q2 ou Q4 sur du matériel bas de gamme ?
Commencez par Q4_K_M — il tient dans chaque niveau de modèle de ce guide (1.7B à 8B) avec une petite perte de qualité. Ne descendez à Q3 ou Q2 que si Q4_K_M provoque des erreurs de mémoire insuffisante. Les fichiers Q2 sont plus rapides car plus petits, mais la perte de qualité est perceptible sur les tâches de raisonnement et de code.
Comment vérifier ma RAM disponible sous Windows ?
Ouvrez le Gestionnaire des tâches → Performances → Mémoire. Le total affiché est votre RAM système — comparez-le au tableau de décision matérielle ci-dessus (niveaux 4, 8 ou 16 Go) pour choisir le bon modèle.
Ollama utilise-t-il automatiquement mon GPU intégré ?
Seulement là où un backend pris en charge existe. La documentation d'Ollama indique que la prise en charge GPU Vulkan sous Windows et Linux est activée par défaut lorsque le backend est installé, et cite les iGPU AMD Ryzen AI sous ROCm ; elle ne répertorie pas les GPU intégrés Intel dans un tableau de prise en charge. Vérifiez avec `ollama ps` après avoir chargé un modèle — la colonne PROCESSOR affiche 100 % CPU, 100 % GPU ou une répartition. Définissez `OLLAMA_VULKAN=0` pour désactiver les GPU Vulkan.
Quelle est la meilleure alternative gratuite à ChatGPT sur un PC bas de gamme ?
Phi-4-mini (3.8B) en Q4_K_M sur Ollama avec 8 Go de RAM, CPU seul, donne 15–25 tok/s — suffisant pour le chat, les résumés et l'aide au code. La qualité est inférieure à un modèle cloud de pointe mais suffisante pour les tâches quotidiennes. Complètement gratuit, fonctionne hors ligne, aucune clé API requise.
De combien un GPU dédié est-il plus rapide que le CPU pour les LLM locaux ?
Généralement 5 à 10× plus rapide pour le même modèle. Une RTX 4060 8 Go d'occasion (prix variable) surpasse généralement les configurations CPU seul traitées dans ce guide. Une iGPU Intel Iris se situe au mieux entre les deux — par exemple, Qwen3 4B est estimé à 12–20 tok/s si l'iGPU est utilisée, contre 8–15 tok/s estimés en CPU seul au niveau comparable le plus proche.
Un modèle d'IA local est-il la même chose qu'un LLM local ?
Pour ce guide, oui. « Modèle d'IA local » est la formulation courante pour ce que le secteur appelle un LLM local (grand modèle de langage) — des poids générateurs de texte que vous téléchargez une fois et exécutez sur votre propre machine, hors ligne. La distinction ne compte que lorsque le modèle d'IA n'est pas basé sur le texte : les générateurs d'images comme Stable Diffusion et les modèles vocaux comme Whisper fonctionnent aussi en local, mais avec des profils matériels différents, et aucun des chiffres de tok/s de ce guide ne s'applique à eux.
Quel est le LLM local le plus léger qui écrit encore un texte utilisable ?
Qwen3 1.7B en Q4_K_M est le modèle le plus léger de ce guide qui vaut la peine d'être utilisé — 1.4 Go sur disque dans Ollama, tourne avec 4 Go de RAM, environ 25–40 tok/s estimés en CPU seul. Des options plus petites existent (TinyLlama 1.1B, Qwen3 0.6B) et sont encore plus rapides, mais la qualité de sortie chute suffisamment pour qu'elles soient plutôt traitées comme de l'autocomplétion que comme un assistant de rédaction. En dessous d'environ 1 milliard de paramètres, aucun modèle léger ne produit de texte long de façon fiablement cohérente.
Gemma 4 E2B est-il plus rapide que Qwen3 1.7B sur un PC bas de gamme ?
Probablement pas sur des machines de 4 Go. Gemma 4 E2B (Google, sorti en avril 2026) compte environ 2.3B de paramètres effectifs, mais le téléchargement Ollama démarre à 4.6 Go à cause de ses tables d'embedding, et sur un CPU limité par la bande passante, un fichier plus gros signifie moins de tokens par seconde. Il convient mieux aux systèmes de 8 Go ou 16 Go de RAM. Le guide des modèles CPU uniquement l'estime à 8–14 tok/s avec une RAM double canal. Qwen3 1.7B (1.4 Go) reste le choix de vitesse de ce guide pour le matériel le plus faible ; essayez `ollama run gemma4:e2b` pour comparer avec 8 Go ou plus.
Pourquoi mon LLM local est-il si lent sur un PC bas de gamme ?
La cause habituelle est la bande passante mémoire, pas la vitesse du CPU : chaque token exige de relire tout le fichier du modèle depuis la RAM, donc la vitesse est plafonnée par la bande passante mémoire divisée par la taille du fichier. Vérifiez quatre points : une seule barrette de RAM (un seul canal divise le plafond par deux), un fichier de modèle trop gros pour la RAM libre (l'échange mémoire ralentit la génération de nombreuses fois), une grande fenêtre de contexte (définissez `OLLAMA_CONTEXT_LENGTH=2048`) et l'exécution du modèle sur CPU ou GPU (`ollama ps`). Passez ensuite à un modèle plus petit comme Qwen3 1.7B ou Phi-4-mini en Q4_K_M.
Quelle est la vitesse d'un mini PC Intel N100 pour les LLM locaux ?
Le N100 n'a qu'un seul canal mémoire (DDR4-3200, DDR5-4800 ou LPDDR5-4800, selon Intel). Pour le fichier Qwen3 1.7B Q4_K_M de 1.4 Go, le plafond de bande passante est d'environ 18 tok/s en DDR4-3200 et d'environ 27 tok/s en DDR5-4800, et la vitesse réelle est inférieure. Phi-4-mini (2.5 Go) a un plafond proche de 10 tok/s en DDR4 et de 15 tok/s en DDR5. Utilisez Qwen3 1.7B ou plus petit sur un N100.
Peut-on faire tourner du RAG local sur un portable avec 2 Go de RAM ?
Oui, pour de petits corpus de documents, si environ 2 Go de RAM sont libres. Utilisez Qwen3 0.6B (523 Mo) comme modèle de chat et nomic-embed-text (274 Mo, contexte 2K) pour les embeddings, gardez des blocs de quelques centaines de tokens, ne transmettez au modèle que les 2–3 meilleurs blocs et définissez `OLLAMA_CONTEXT_LENGTH=2048`. Attendez-vous à des réponses simples tirées de vos documents plutôt qu'à un raisonnement poussé, et vérifiez les réponses importantes dans le passage source.
Faut-il utiliser Qwen3.5 plutôt que Qwen3 sur un PC bas de gamme ?
Pour la réponse la plus rapide, restez pour l'instant sur Qwen3 1.7B. Ollama liste Qwen3.5 0.8B à 1.2 Go, 2B à 2.7 Go et 4B à 3.3 Go, contre 1.4 Go pour Qwen3 1.7B et 2.5 Go pour Qwen3 4B. Sur un CPU limité par la bande passante, un fichier plus gros génère moins de tokens par seconde ; seul Qwen3.5 0.8B devrait donc être plus rapide que Qwen3 1.7B, avec une qualité moindre. Qwen3.5 2B et 4B valent le test si vous privilégiez un entraînement plus récent à la vitesse. PromptQuorum n'a pas chronométré Qwen3.5 sur le matériel de ce guide.
Quel est le plus gros modèle que je puisse faire tourner en CPU seul ?
La limite est la RAM libre pour le fichier plus le contexte. Ollama liste environ 5.2 Go pour Qwen3 8B, 9.3 Go pour Qwen3 14B et 20 Go pour Qwen3 32B, soit une règle approximative de 0.65 Go par milliard de paramètres en Q4. Un PC de 32 Go peut contenir Qwen3 32B, mais le plafond de bande passante en DDR5-5600 double canal est d'environ 4.5 tok/s (89.6 Go/s ÷ 20 Go), ce qui en fait un outil de traitement par lots. Les modèles à mélange d'experts comme Qwen3 30B-A3B (19 Go) ne lisent que quelques milliards de paramètres actifs par token ; ils devraient donc tourner plus vite que leur taille de fichier ne le laisse penser.
Sources
- Fiche modèle Phi-4 Mini — Microsoft Research. Résultats de benchmarks publiés par le développeur ; sorti en 2025.
- Bibliothèque Ollama : Qwen3 — tailles de fichiers et longueurs de contexte pour qwen3:0.6b, 1.7b, 4b et 8b (vérifié le 2026-10-23).
- Bibliothèque Ollama : Qwen3.5 — tailles de fichiers pour qwen3.5:0.8b, 2b et 4b (vérifié le 2026-10-23).
- Bibliothèque Ollama : Gemma 4 — taille de téléchargement de gemma4:e2b et contexte 128K (vérifié le 2026-10-23).
- Bibliothèque Ollama : Phi-4-mini — 2.5 Go, contexte 128K (vérifié le 2026-10-23).
- Bibliothèque Ollama : nomic-embed-text — modèle d'embedding de 274 Mo, fenêtre de contexte de 2K (vérifié le 2026-10-23).
- Documentation Ollama : prise en charge GPU — Vulkan, ROCm et variables de sélection GPU dont OLLAMA_VULKAN.
- Documentation Ollama : FAQ — OLLAMA_CONTEXT_LENGTH, OLLAMA_KV_CACHE_TYPE, OLLAMA_FLASH_ATTENTION, OLLAMA_KEEP_ALIVE et `ollama ps`.
- Spécifications du processeur Intel N100 — un seul canal mémoire ; DDR4-3200, DDR5-4800, LPDDR5-4800.
- Couverture de l'annonce de Gemma 4 — date de sortie 2 avril 2026, environ 2.3B de paramètres effectifs et 5.1B au total (synthèse tierce).
- Documentation de compilation llama.cpp — backends CPU et options de compilation.