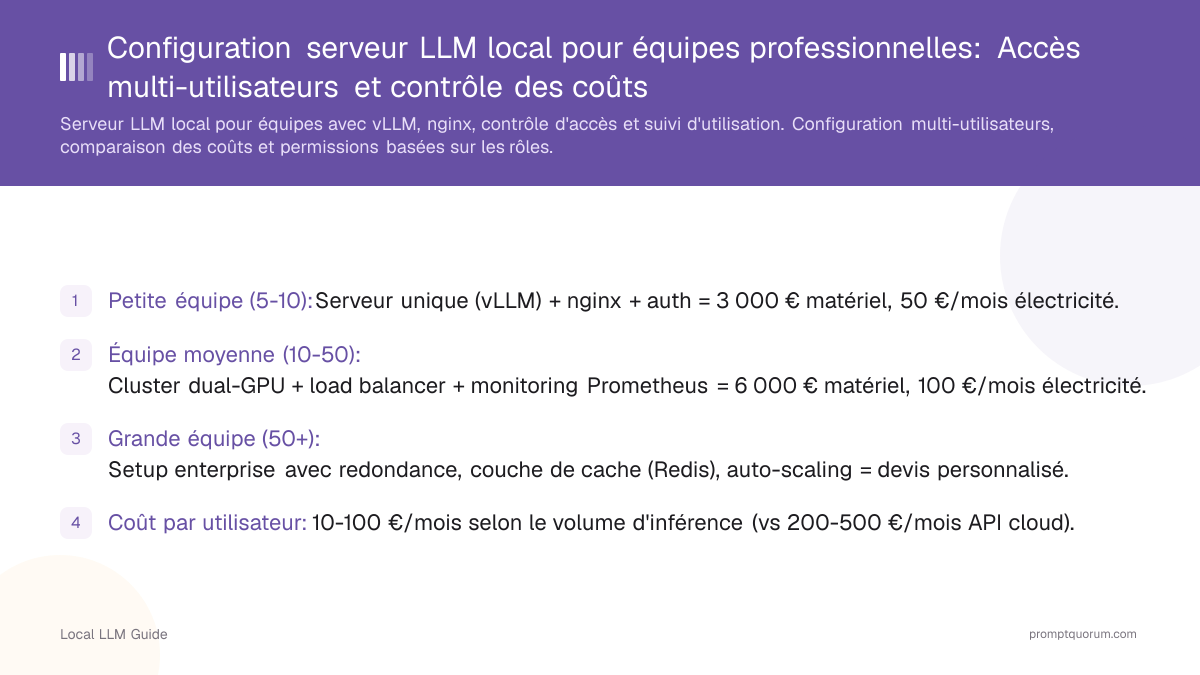
Quelle architecture: serveur unique ou cluster multi-GPU?
Serveur vLLM unique (5-10 utilisateurs):
- 1× RTX 4090 + 64 GB RAM + 1 TB SSD.
- Gère 10 utilisateurs concurrents (5 tok/sec par utilisateur).
- Setup simple, point de défaillance unique. Voir meilleur stack LLM local pour les choix de framework.
- Coût: 2 500 € matériel + 50 €/mois électricité.
Cluster dual-GPU (10-50 utilisateurs):
- 2× instances vLLM (une par GPU) + nginx load balancer.
- Gère 20 utilisateurs concurrents (10 tok/sec par utilisateur).
- Failover automatique (si GPU 0 tombe en panne, GPU 1 continue). En savoir plus dans scaler les LLMs locaux en enterprise.
- Coût: 5 000 € matériel + 100 €/mois électricité.
Couche de mise en cache Redis (optionnel):
- Mettez en cache les prompts courants (messages système, templates).
- Réduction de latence de 30% pour les requêtes répétées.
- Coût: 1 000 € matériel supplémentaire.
Comment configurer l'authentification & le contrôle d'accès utilisateur?
Auth simple (PME < 50 utilisateurs): Clé API par utilisateur. L'utilisateur envoie `Authorization: Bearer $API_KEY` dans l'en-tête de la requête. Pour la conformité, voir conformité enterprise avec LLMs locaux.
Auth enterprise: Intégration OAuth 2.0 + SAML 2.0 avec Okta/Azure AD. Connexion SSO, attribution de groupe automatique.
Rate limiting: Quota de tokens par utilisateur (ex: 100K tokens/jour). Empêche une équipe de surcharger le serveur.
Piste d'audit: Enregistrez chaque appel API avec ID utilisateur, IP, taille de requête, taille de réponse, timestamp.
Comment tracker l'attribution des coûts & la mesure d'utilisation?
Tracking: Tokens générés par utilisateur par jour. Somme sur l'équipe pour le coût total. Voir LLM local privé pour données sensibles pour le metering en priorité sur la confidentialité.
Attribution: Allocez les coûts du serveur proportionnellement (ex: si Alice génère 40% des tokens, elle reçoit 40% de la facture).
Rapport de showback: Rapport mensuel par utilisateur: tokens utilisés, coût estimé API cloud, coût interne, économies.
Outils: Prometheus + service de facturation personnalisé. Ou option open-source: Metered.io (tracking des coûts basé sur le cloud).
Comment skaliser les serveurs LLM locaux à mesure que l'équipe grandit?
5-10 utilisateurs: 1× RTX 4090. Serveur saturé quand tout le monde fait de l'inférence simultanément. Pics de latence acceptables.
10-30 utilisateurs: 2× RTX 4090 (machine dual-GPU). nginx load balancer distribue la charge. 20 concurrents = confortable.
30-100 utilisateurs: Cluster 3-4× GPU (machines séparées) + load balancer dédié (hardware ou software). Kubernetes optionnel.
100+ utilisateurs: Architecture enterprise (failover cloud, couche de cache, API gateway) = envisager un déploiement hybride (local + cloud burst).
Comment superviser la performance & résoudre les problèmes?
Métriques Prometheus: vLLM exporte la latence des requêtes, tokens/sec, longueur de la queue. Scrape toutes les 15 secondes.
Tableau de bord Grafana: Visualisez la profondeur de la queue, percentiles de latence (p50, p99), utilisation du GPU.
Alertes: Si latence > 2 sec ou queue > 10 requêtes, alerte l'ingénieur on-call.
Logs: Centralisez les logs vLLM + nginx dans ELK Stack. Recherchez par utilisateur, timestamp, erreur.
Identification du goulot: Si GPU saturé (>90% utilisation) et latence > 1 sec, ajoutez un GPU. Si CPU saturé, upgrader le CPU.
Erreurs courantes de setup
- Point de défaillance unique (une GPU, pas de failover). GPU meurt, l'équipe perd l'accès. Utilisez dual-GPU minimum.
- Pas de rate limiting. Un utilisateur lance 1M token d'inférence, bloque tout le monde. Implémentez des quotas de tokens.
- Pas de logs d'audit. Impossible de tracker qui a accédé à quoi. La journalisation est obligatoire pour les équipes de conformité.
Questions fréquemment posées
Puis-je ajouter plus d'utilisateurs sans acheter du nouveau matériel?
Jusqu'à 20-30 par GPU. Au-delà, ajoutez un GPU. 1 RTX 4090 gère environ 5 tok/sec par utilisateur concurrent.
Comment gérer les mises à jour de modèles (nouvelle variante Llama 3)?
Téléchargez sur une machine séparée, testez, échangez. vLLM supporte le hot-swapping de modèles avec zéro temps d'arrêt.
Devrais-je utiliser Kubernetes pour le déploiement en équipe?
Non pour <50 utilisateurs. Docker + docker-compose est plus simple. Kubernetes ajoute de la complexité sans bénéfice.
Puis-je facturer les utilisateurs en fonction des tokens?
Oui, via rapports de showback. Mais décidez d'abord la politique (coûts partagés vs facturation par département).
Et si un utilisateur supprime accidentellement les données du serveur?
Sauvegardes. Sauvegardez quotidiennement tous les logs entrée/sortie en stockage externe. RAID-6 pour la redondance.
Puis-je intégrer avec Slack/Teams pour un accès facile?
Oui. Bot Slack appelle l'API vLLM, retourne réponse. Intégration populaire: wrapper OpenAI API pour Slack.
Combien coûte un serveur LLM local en équipe comparé aux API cloud?
Serveur unique: 2 500 € matériel + 50 €/mois électricité (600 €/an) contre 1 000+€/mois API cloud (12 000+€/an). Période d'amortissement: 2-3 mois pour les équipes actives.
Comment configurer l'authentification utilisateur pour un serveur LLM en équipe?
OAuth 2.0 avec SSO (Active Directory / Okta) pour enterprise. Authentification simple par token pour PME. Toutes les requêtes sont enregistrées avec ID utilisateur, timestamp et nombre de tokens pour l'attribution des coûts.
Que se passe-t-il si un GPU tombe en panne dans un setup en équipe?
Utilisez un cluster dual-GPU avec load balancer: si GPU 0 tombe en panne, toutes les requêtes sont automatiquement routées vers GPU 1. Zéro temps d'arrêt. Pour les setups single-server, RAID protège les données mais le failover GPU nécessite de la redondance.
Comment gérer les mises à jour de modèles dans un setup en équipe?
Téléchargez le nouveau modèle sur une machine séparée, testez, puis échangez. vLLM supporte le hot-swapping de modèles avec zéro temps d'arrêt en pausant les nouvelles requêtes et finissant les requêtes en vol.
Comment sauvegarder les données et logs des utilisateurs sur un serveur en équipe?
Exécutez des sauvegardes quotidiennes de tous les logs entrée/sortie vers un stockage externe. Utilisez la redondance RAID-6 (tolère 2 défaillances simultanées de disques). Testez la récupération mensuellement pour assurer la validité des sauvegardes.
Comment puis-je mesurer et tracker l'utilisation des utilisateurs pour la facturation?
Chaque requête API contient l'ID utilisateur, l'IP, la taille de la requête et la taille de la réponse. Prometheus scrape toutes les 15 secondes pour les métriques de latence, tokens/sec et queue. Agrégez par utilisateur par jour pour l'attribution proportionnelle des coûts.
Sources
- Documentation officielle vLLM — Setup multi-utilisateurs et rate limiting
- Documentation Prometheus — Collecte de métriques et alerting
- Kubernetes best practices — Orchestration de conteneurs pour les grands déploiements