Points clés
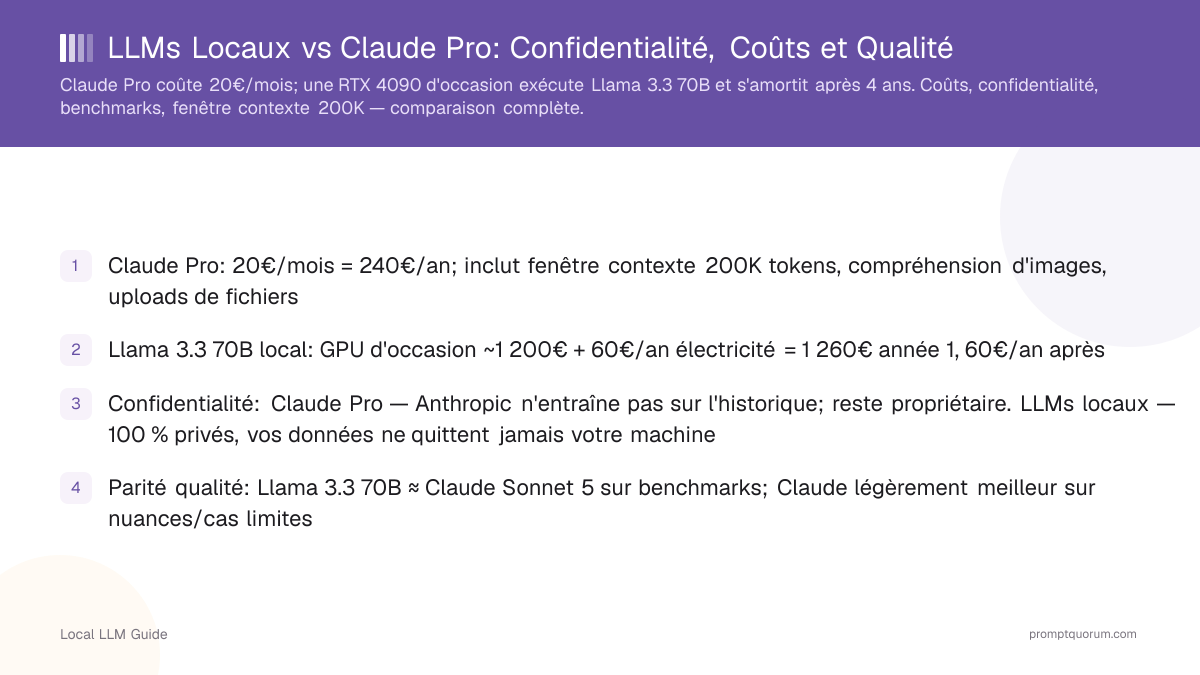
- Claude Pro: 20€/mois = 240€/an; inclut fenêtre contexte 200K tokens, compréhension d'images, uploads de fichiers
- Llama 3.3 70B local: dual RTX 4070s d'occasion ~550€ (recommandé) + 60€/an électricité = 610€ année 1, 60€/an après. Une RTX 4090 d'occasion coûte désormais 2 100–2 800€ (arrêtée par NVIDIA en 2026).
- Confidentialité: Claude Pro — Anthropic n'entraîne pas sur l'historique; reste propriétaire. LLMs locaux — 100 % privés, vos données ne quittent jamais votre machine
- Parité qualité: Llama 3.3 70B ≈ Claude Sonnet 5 sur benchmarks; Claude légèrement meilleur sur nuances/cas limites
- Fenêtre contexte: Claude Pro 200K tokens vs Llama 3.3 70B 128K tokens (toujours excellent pour documents)
- TCO 5 ans: Claude Pro 1 200€ vs Local avec dual RTX 4070s (550€ GPU + 300€ électricité) = 850€ — moins cher que Claude. Une RTX 4090 d'occasion (2 100–2 800€ + 300€ électricité) peut ne pas s'amortir en 5 ans.
- Avantage local: Requêtes illimitées, zéro limite débit, capacité hors ligne, propriété du modèle
- Avantage Claude Pro: Multimodal meilleur (images), mises à jour temps réel, zéro surcharge infrastructure
Faits rapides
- Prix Claude Pro: 20€/mois (240€/an), aucun matériel nécessaire
- Matériel Llama 3.3 70B: dual RTX 4070s (~550€ d'occasion, recommandé) ou une RTX 4090 d'occasion (2 100–2 800€ — arrêtée par NVIDIA en 2026)
- TCO 5 ans: Claude Pro 1 200€ vs Local ~850€ (dual RTX 4070s) — le local est moins cher. Une RTX 4090 d'occasion (~2 600€) peut ne pas s'amortir en 5 ans.
- Scores MMLU: Claude Sonnet 5 97 % vs Llama 3.3 70B 96 %
- Fenêtre contexte: Claude Pro 200K tokens vs Llama 3.3 128K tokens
- Seuil rentabilité: ~Mois 37 (dual RTX 4070s) — après cela, local est meilleur marché indéfiniment. Une RTX 4090 d'occasion dépasse la fenêtre de 5 ans.
Quelle est la différence de prix entre Claude Pro et les LLMs locaux?
Claude Pro facture 20€/mois sans matériel requis; Llama 3.3 70B local coûte ~550€ d'avance avec dual RTX 4070s (recommandé) ou 2 100–2 800€ avec une RTX 4090 d'occasion (arrêtée par NVIDIA en 2026), plus ~60€/an en électricité. L'année 1 reste moins chère avec Claude Pro en valeur absolue, mais dual RTX 4070s s'amortissent vers le mois 37.
Coût total de propriété 5 ans: Claude Pro 1 200€ vs Llama local (dual RTX 4070s d'occasion) 850€ vs Llama local (RTX 4090 d'occasion) 2 400–3 100€. Année 1: Claude Pro 240€ vs Local 610€ (4070s) ou 2 160–2 860€ (4090). Année 3: Claude Pro 720€ vs Local 730€ (4070s) ou 2 280–2 980€ (4090). Année 5: Claude Pro 1 200€ vs Local 850€ (4070s) ou 2 400–3 100€ (4090).
Meilleures GPUs pour LLMs locaux détaille les options matériel et les prix actuels du marché.
•⚠️ Avertissement: NVIDIA a arrêté la RTX 4090 en 2026 ; les prix d'occasion ont grimpé à 2 100–2 800€, ce qui peut empêcher l'amortissement face à Claude Pro en 5 ans.
•💡 Conseil utile: Dual RTX 4070s (~550€ d'occasion) exécutent Llama 3.3 70B à 60–70 % de la vitesse d'une seule 4090 pour environ un quart du coût — l'option la plus rentable en 2026.
Comment les modèles de confidentialité diffèrent-ils entre Claude Pro et les LLMs locaux?
Claude Pro (Anthropic): Vos conversations ne sont pas utilisées pour entraîner les futurs modèles Claude (politique de confidentialité explicite Anthropic depuis 2026). Cependant, les requêtes sont enregistrées sur les serveurs Anthropic pour surveillance sécurité et débogage. Anthropic est basée aux USA, soumise à la loi américaine.
LLMs locaux: Toutes les données restent sur votre machine. Zéro journalisation cloud, zéro visibilité tiers. Adapté pour workflows santé (HIPAA), finance (PCI-DSS) et légal (secret professionnel). Depuis avril 2026, Llama 3.3 est pleinement open-source (zéro collecte données Anthropic). Pour les organisations françaises manipulant données sensibles (données médicales, financières, légales), la CNIL recommande l'inférence locale pour se conformer à la souveraineté de données.
•📌 Point clé: Anthropic n'entraîne pas sur l'historique chat, mais les conversations sont journalisées sur serveurs USA pour surveillance sécurité.
•🛡️ Conformité: Pour workflows HIPAA, PCI-DSS ou secret professionnel, seuls les LLMs locaux sont conformes — aucun serveur tiers n'accède jamais à vos données.
Comment Claude Sonnet 5 et Llama 3.3 70B se comparent-ils en qualité?
Claude Sonnet 5 (Anthropic, 2026): raisonnement de premier plan, nuance et suivi des instructions (selon les données de benchmark d'Anthropic). Score MMLU 97 % (compréhension langage). Excelle en analyse complexe, rédaction, révision code. Score MMLU: 97 %. Fenêtre contexte: 200K tokens. Compréhension images: Native. Fine-tuning: Non disponible. Hors ligne: Non. Limites débit: Oui.
Llama 3.3 70B (Meta, avril 2024): Score MMLU 96 %. Raisonnement excellent, quasi-parité Claude sur benchmarks. Performance coding supérieure (+2 % sur HumanEval). Légèrement plus faible en tâches créatives/narrative. Score MMLU: 96 %. HumanEval: +2 % vs Claude. Fenêtre contexte: 128K tokens. Compréhension images: Via adaptateur seulement. Fine-tuning: Complet (LoRA, complet). Hors ligne: Oui. Limites débit: Aucune.
Sur 80 % des tâches réelles (résumé, Q&R, extraction données, coding), Llama 3.3 70B et Claude Sonnet 5 produisent output équivalent. Sur cas limites (analyse narrative subtile, rédaction créative domaine-spécifique), Claude est marginalement meilleur. Combien de VRAM faut-il pour LLMs locaux? couvre les exigences matériel pour exécuter modèles 70B.
📍 En une phrase
Llama 3.3 70B égale Claude Sonnet 5 sur 80 % des tâches réelles, mais Claude se distingue sur raisonnement nuancé et cas limites rédaction créative.

•💡 Conseil utile: Sur benchmarks coding (HumanEval), Llama 3.3 70B surpasse Claude Sonnet 5 de ~2 % depuis avril 2026.
Combien de longs documents chacun peut-il gérer?
Claude Pro 200K tokens: ~150 000 mots (équivalent 3 livres). Peut traiter une codebase complète, contrats légaux ou documents recherche en une requête.
Llama 3.3 70B 128K tokens: ~96 000 mots. Toujours excellent pour la plupart des documents; certaines très grandes codebases ou contrats 500+ pages dépassent cette limite.
Depuis avril 2026: Pour workflows traitement documents (RAG, résumé masse, révision contrat), la fenêtre 200K de Claude Pro est un avantage tangible. Llama 3.3 128K suffit pour ~95 % des documents métier.
•📌 Point clé: Les deux fenêtres contexte sont massives. Seules très grandes codebases ou contrats 500+ pages frappent limite 128K de Llama.
Quel est le coût total de propriété 5 ans?
Claude Pro: 20€ × 60 mois = 1 200€ total.
Llama 3.3 70B local (dual RTX 4070s, d'occasion): 550€ + électricité 5 ans 300€ = 850€ total. La voie recommandée depuis l'arrêt de la RTX 4090 par NVIDIA.
Llama 3.3 70B local (RTX 4090 d'occasion): 2 100–2 800€ + 300€ électricité = 2 400–3 100€ total.
Seuil rentabilité: ~37 mois (environ 3 ans) avec dual RTX 4070s. Une RTX 4090 d'occasion ne s'amortit pas dans la fenêtre de 5 ans aux prix actuels.
💬 En termes simples
Sur 5 ans, dual RTX 4070s coûtent environ 850€ au total contre 1 200€ pour Claude Pro — moins cher. Une RTX 4090 d'occasion coûte désormais 2 100–2 800€ (NVIDIA l'a arrêtée en 2026), elle ne s'amortit donc plus face à Claude Pro en 5 ans.

•💡 Conseil utile: Limiter puissance d'une 4070 à 350W économise 40 % électricité avec seulement ~10 % perte vitesse — ramenant le coût local 5 ans avec dual 4070s sous 750€.
FAQ Coûts & Confidentialité
•🔍 Le saviez-vous?: Claude Pro est tarifé identiquement ChatGPT Plus à 20€/mois, mais offre fenêtre contexte 10× plus large (200K vs 16K tokens).
Puis-je utiliser Claude Pro hors ligne?
Non. Claude Pro requiert connexion internet active et serveurs Anthropic. Llama 3.3 local fonctionne entièrement hors ligne.
Anthropic utilise-t-il mes conversations Claude Pro pour entraînement?
Non (depuis avril 2026). Anthropic n'entraîne explicitement pas sur l'historique chat. Les conversations sont journalisées pour sécurité/débogage mais non utilisées pour amélioration modèle.
Llama 3.3 70B est-il réellement gratuit à utiliser?
Oui. Llama 3.3 est open-source sous licence communauté Meta. Une fois le GPU acheté, coûts inférence $0 (seulement électricité). Mises à jour modèle gratuites.
Puis-je fine-tuner Claude Pro ou Llama 3.3 différemment?
Claude Pro: Zéro fine-tuning disponible depuis avril 2026. Llama 3.3 local: Support fine-tuning complet (LoRA, tuning paramètre complet). Local gagne pour customisation.
Que si mon GPU local tombe en panne?
Vous perdez capacité compute jusqu'à remplacement (~550€ avec dual RTX 4070s, ~2 100–2 800€ avec une RTX 4090 d'occasion). Claude Pro se dégrade gracieusement (limitation débit). Local requiert planification redondance (GPU sauvegarde, failover cloud).
Llama 3.3 peut-il gérer images comme Claude Pro?
Multimodal natif: Non (depuis avril 2026). Vous pouvez intégrer avec modèles vision open-source (CLIP, LLaVA) contournement, mais pas aussi fluide que Claude.
Claude Pro est-il meilleur que Llama 3.3 à une tâche spécifique?
Oui. Claude Sonnet 5 excelle en analyse narrative nuancée, raisonnement multi-étape complexe avec contexte ambigu, cas limites rédaction créative. Sur coding, Llama 3.3 70B surpasse réellement Claude ~2 % sur benchmarks HumanEval depuis avril 2026.
Puis-je passer de Claude Pro à un LLM local sans perdre workflows?
Oui. Plupart cas usage Claude Pro (Q&R, résumé, coding) transfèrent directement Llama 3.3 70B via Ollama ou LM Studio. Migration: installer Ollama, télécharger llama3.1:70b, mettre à jour intégrations API de claude.ai vers localhost:11434. Aucune données verrouillées Claude Pro.
Erreurs courantes en comparant Claude Pro et LLMs locaux
- Croire Claude Pro moins cher parce que coût mensuel visible. Sur 5+ ans, dual RTX 4070s rattrapent et deviennent meilleur marché ; une RTX 4090 d'occasion ne le fait plus aux prix actuels.
- Supposer qu'une RTX 4090 d'occasion reste l'option économique pour Llama 3.3 70B. NVIDIA l'a arrêtée en 2026 et le marché d'occasion est monté à 2 100–2 800€. Dual RTX 4070s (500–600€ total) sont la voie la plus rentable.
- S'attendre à Llama 3.3 égaler compréhension images Claude. Multimodal natif non disponible; utiliser adaptateur CLIP.
- Oublier Claude Pro avantage 200K contexte. Pour traitement document requête-unique, Claude gagne. Pour Q&R moyenne, Llama 3.3 suffisant.
- Ne pas compter surcharge infrastructure. Exécuter Llama 3.3 70B requiert expertise (CUDA, PyTorch, Docker). Claude Pro clés-en-main.
Lectures connexes
Sources
- Politique tarification & confidentialité Claude Pro Anthropic — Anthropic, avril 2026
- Carte modèle Meta Llama 3.3 70B — Meta, avril 2024
- Leaderboard LLM ouvert — Benchmarks MMLU & HumanEval — Hugging Face, avril 2026