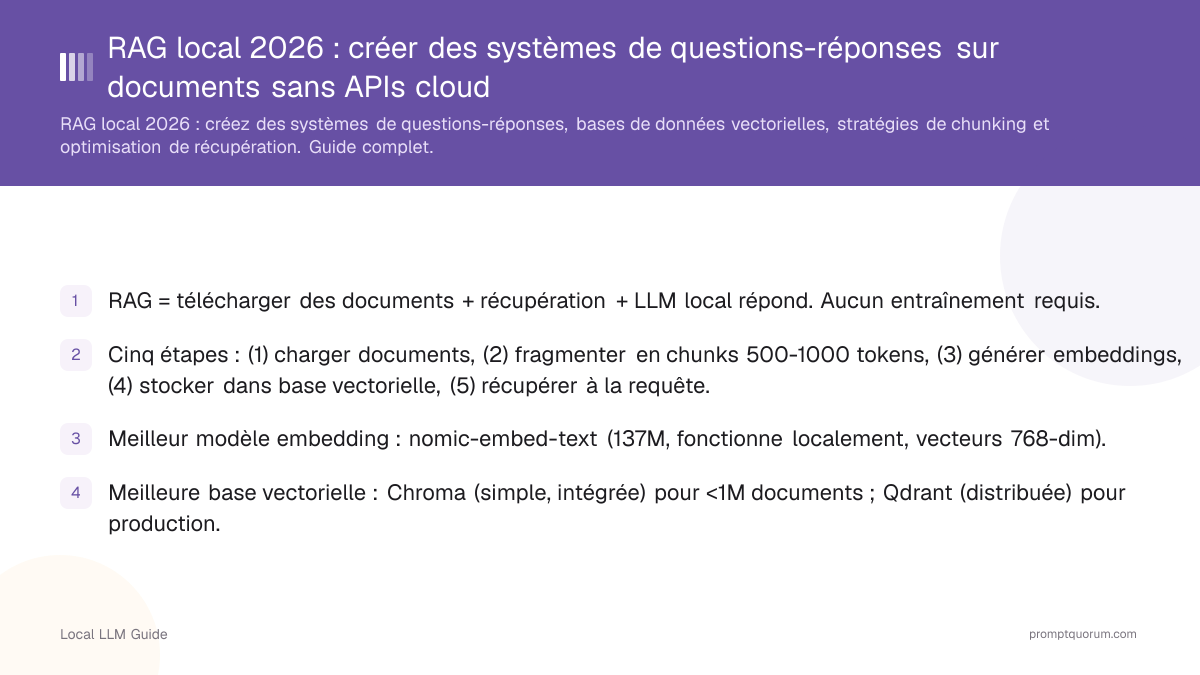
Comment fonctionne RAG étape par étape ?
- 1Ingestion de documents : charger des fichiers PDF, texte ou pages Web.
- 2Chunking : diviser documents en chunks 500-1000 tokens (chevauchement 20% pour éviter ruptures contexte).
- 3Embedding : convertir chaque chunk en vecteur (768-1536 dimensions) avec modèle embedding local.
- 4Stockage : stocker vecteurs dans base de données vectorielle (Chroma, Qdrant, Milvus) avec métadonnées (nom document, page, timestamp).
- 5Temps requête : convertir question utilisateur en embedding, rechercher base vectorielle pour top K chunks similaires (k=5-10).
- 6Assemblage contexte : combiner chunks récupérés dans prompt avec instructions pour LLM local.
- 7Génération : LLM local génère réponse basée sur contexte récupéré.
- 8Attribution : retourner quels documents la réponse provenait.

Quelle est la stratégie de chunking optimale ?
La stratégie de chunking détermine la qualité de récupération. Mauvais chunking = informations pertinentes divisées sur chunks, récupération échoue.
Chunking sémantique (recommandé) : diviser par phrases ou paragraphes, préservant le sens. Exemple : chaque paragraphe = 1 chunk.
Chunking de taille fixe : 500 tokens par chunk, chevauchement 20%. Simple mais peut diviser phrases.
Chunking récursif : d'abord par paragraphes, puis par phrases si trop gros. Préserve hiérarchie.
Chunking sémantique avec chunks 500-1000 tokens et chevauchement 20% est optimal pour la plupart des cas.
# Python: exemple chunking sémantique
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
  chunk_size=1000,
  chunk_overlap=200,  # chevauchement 20%
  separators=["\n\n", "\n", ".", " "]  # diviser par paragraphe, puis phrase
)
chunks = splitter.split_documents(documents)
print(f"Créé {len(chunks)} chunks")
Quelle base de données vectorielle devriez-vous utiliser ?
Base de données | Type | Capacité | Effort installation | Idéal pour |
|---|---|---|---|---|
| Chroma | Intégrée | <1M docs | pip install | Prototypage, petit RAG |
| Qdrant | Distribuée | Illimitée | Docker ou cloud | Production, scalable |
| Milvus | Distribuée | Illimitée | Complexe | Entreprise, grand déploiement |
| Weaviate | Graphe + Vecteur | Illimitée | Docker | Requêtes complexes, relations |
| Pinecone (cloud) | Gérée | Illimitée | Clé API | Sans serveur, sans maintenance |

Quel modèle d'embedding devriez-vous choisir ?
Modèle | Dimensions | Vitesse | Qualité | Recommandation |
|---|---|---|---|---|
| nomic-embed-text (local) | 768 | Rapide | Excellente | Meilleur pour RAG local |
| bge-m3 (local) | 1024 | Rapide | Excellente | Support multilingue |
| OpenAI text-embedding-3 (cloud) | 3072 | Très rapide | Meilleure classe | Approche hybride |
| Cohere (cloud) | 4096 | Rapide | Excellente | RAG cloud production |
Comment optimisez-vous la qualité de récupération ?
La qualité de récupération détermine le succès de RAG. Bonne récupération = bonnes réponses. Mauvaise récupération = hallucinations.
- Sélection Top K : récupérer k=5-10 chunks. K plus élevé = plus contexte (plus lent), k inférieur = moins de distractions.
- Seuil de similarité : filtrer résultats par score similarité minimum (p.ex. >0,75). Évite chunks peu pertinents.
- Reranking : utiliser reranker (cross-encoder) pour re-classer chunks par pertinence. Petite amélioration précision.
- Recherche hybride : combiner recherche sémantique (embeddings) avec recherche par mots-clés BM25. Capture documents avec mots-clés exacts.
- Expansion requête : élargir requête utilisateur avec synonymes ou termes connexes. Améliore rappel.
Comment évaluez-vous la qualité de RAG ?
La qualité de RAG a deux dimensions : (1) qualité récupération (avons-nous des chunks pertinents ?), et (2) qualité génération (l'LLM a-t-il bien répondu ?)
Évaluation récupération : créer requêtes test avec documents corrects connus. Mesurer précision (combien de récupérés sont pertinents ?) et rappel (avons-nous tous documents pertinents ?).
Évaluation génération : exécuter LLM sur chunks récupérés, noter manuellement réponses (échelle 0-5) pour exactitude et complétude.
Outils d'évaluation automatisés (comme Ragas) peuvent mesurer métriques récupération et génération automatiquement.
Modèles de RAG en production
Pour services production, utilisez ces modèles :
- Mise en cache : mettre en cache embeddings documents fréquemment interrogés pour éviter recalcul.
- Indexation incrémentale : ajouter nouveaux documents sans tout ré-indexer. Qdrant et Milvus supportent ceci.
- Surveillance : suivre latence récupération, taux hit cache et retours utilisateur sur qualité réponse.
- Fallback : si récupération échoue (aucun chunks pertinents), répondre "Je n'ai pas d'informations là-dessus" au lieu d'halluciner.
- Versioning : conserver versions documents pour audit trails. Stocker quelle version utilisée pour chaque réponse.
Erreurs courantes dans l'implémentation de RAG local
- Mauvais chunking documents. Trop petit chunks = bruit récupération. Trop gros chunks = information divisée. Tester tailles chunks empiriquement.
- Pas évaluer récupération. Construire RAG sans tester si récupération fonctionne c'est comme construire voiture sans tester moteur. Toujours mesurer précision/rappel.
- Utiliser embeddings génériques pour documents domaine-spécifique. Documents légaux, médicaux ou techniques peuvent nécessiter embeddings ajustés. Considérer modèles domaine-spécifiques.
- Oublier fréquence mise à jour. Si documents changent hebdomadairement, base vectorielle devient stale. Construire pipeline pour ré-embedding et mise à jour.
- Attendre RAG remplace fine-tuning. RAG est injection contexte. Fine-tuning est adaptation modèle. Pour meilleurs résultats, combiner les deux.
Questions courantes sur RAG local
Combien de documents peut gérer RAG local ?
Chroma gère 100K-1M documents sur hardware consumer. Qdrant scale à milliards avec déploiement distribué. Au-delà 1M, utilisez Qdrant ou Milvus.
Quelle latence dois-je attendre ?
Requête embedding (nomic-embed-text sur CPU) : 50-200ms. Récupération (Chroma sur disque) : 10-50ms. Génération LLM : 2-10 secondes (dépend taille modèle). Total : 2-10 secondes par requête.
RAG peut-il gérer mises à jour documents en temps réel ?
Oui. Ajouter dynamiquement nouveaux documents à base vectorielle. Latence indexation 100-500ms par document, donc mises à jour temps réel sont pratiques.
RAG local est-il moins cher que les APIs cloud ?
Oui. Aucun coût par-token, aucuns appels API à services externes. Setup one-time d'embeddings, puis requêtes gratuites.
Puis-je utiliser embeddings cloud avec LLMs locaux ?
Oui. Utiliser OpenAI, Cohere ou autres embeddings cloud pour indexation, puis LLMs locaux pour génération. Approche hybride.
Sources
- Documentation LlamaIndex -- docs.llamaindex.ai
- Guide RAG LangChain -- python.langchain.com/docs/use_cases/question_answering
- Documentation Chroma -- docs.trychroma.com
- Moteur recherche vectorielle Qdrant -- qdrant.tech
- Papier RAG (Lewis et al.) -- arxiv.org/abs/2005.11401