Qu'est-ce que la longueur de contexte et pourquoi compte-t-elle pour les LLM locaux ?
La longueur de contexte est le nombre maximal de tokens qu'un modèle peut contenir dans une requête : votre prompt, les documents, la conversation jusque-là et la réponse qu'il rédige, additionnés. Un token vaut environ 0.75 mot anglais : 128K tokens font donc environ 100 000 mots et 256K tokens environ 200 000 mots.
La fenêtre annoncée est le maximum que l'architecture du modèle prend en charge. La fenêtre utilisable est la longueur à laquelle les réponses restent exactes pour votre tâche, et elle est plus courte.
Les longues fenêtres comptent pour des bases de code entières, des contrats, de longues transcriptions, des chapitres de livre et des sessions d'agents où les sorties d'outils s'accumulent. La documentation d'Ollama recommande au moins 64 000 tokens pour les agents, la recherche web et les outils de code.
Trois éléments fixent la limite sur votre propre machine : la fenêtre du modèle, la mémoire dont son cache KV a besoin à cette longueur et la fiabilité avec laquelle il exploite le texte à cette longueur. Les sections suivantes les traitent tour à tour.
Quels LLM locaux prennent en charge plus de 128K tokens en 2026 ?
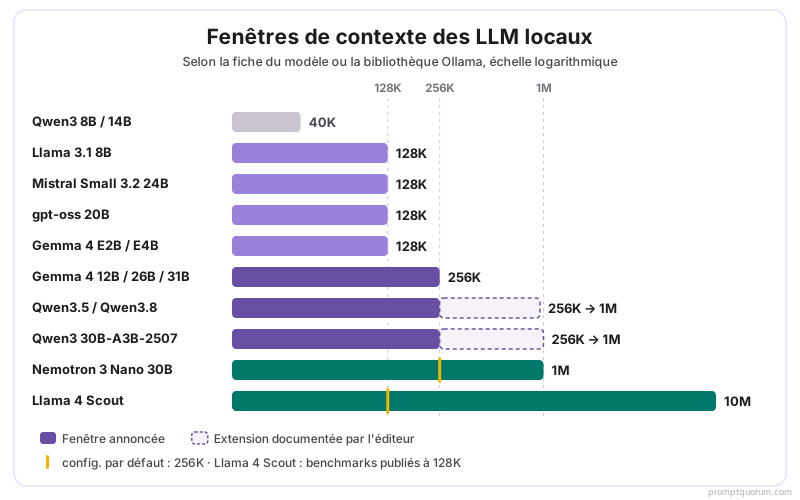
Plusieurs : Qwen3.5, Qwen3.8 et Gemma 4 (à partir de 12B) annoncent des fenêtres de 256K dans la bibliothèque Ollama, NVIDIA Nemotron 3 Nano 30B annonce 1M et Llama 4 Scout annonce 10M. Les modèles publiés avant 2026 s'arrêtent en majorité à 128K.
Le tableau indique la fenêtre annoncée par la fiche du modèle ou la bibliothèque Ollama. Une extension de contexte, comme YaRN, est une option documentée par l'éditeur qui demande une configuration et de la mémoire supplémentaires.
Llama 4 Scout annonce 10M tokens, mais sa fiche rapporte ses benchmarks de contexte long à une fenêtre de 128K, et le téléchargement Ollama fait 67 Go. Llama 4 Maverick annonce 1M mais pèse 245 Go au téléchargement : il exige du matériel de serveur.
Les tags Ollama peuvent différer par la taille de fenêtre : qwen3:8b et qwen3:14b annoncent 40K, tandis que qwen3:4b et qwen3:30b annoncent 256K. Lisez la valeur de contexte sur la page Ollama du modèle avant de planifier.
Modèle | Fenêtre annoncée | Contexte plus long | Tag Ollama |
|---|---|---|---|
| Nemotron 3 Nano 30B-A3B | 1M (défaut 256K) | — | ollama run nemotron-3-nano:30b |
| Qwen3.8 27B | 256K | Jusqu'à 1M (YaRN) | ollama run qwen3.8:27b |
| Qwen3.5 9B / 27B | 256K | Jusqu'à 1.01M (YaRN) | ollama run qwen3.5:9b |
| Qwen3 30B-A3B-2507 | 256K | 1M (DCA, ~240 Go GPU) | ollama run qwen3:30b |
| Gemma 4 12B / 26B / 31B | 256K | — | ollama run gemma4:26b |
| Gemma 4 E2B / E4B | 128K | — | ollama run gemma4:e4b |
| Llama 4 Scout 109B | 10M annoncés | Benchmarks à 128K | ollama run llama4:16x17b |
| Mistral Small 3.2 24B | 128K | — | ollama run mistral-small3.2 |
| gpt-oss 20B | 128K | — | ollama run gpt-oss:20b |
| Llama 3.1 8B | 128K | — | ollama run llama3.1:8b |
| Qwen3 8B / 14B | 40K | — | ollama run qwen3:14b |
Quelle mémoire exige un contexte long ?
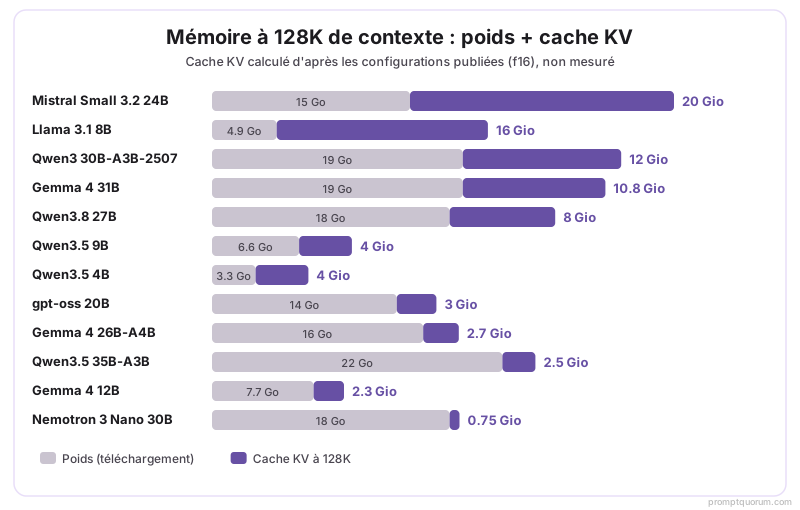
La mémoire d'un contexte long, ce sont les poids du modèle plus le cache KV, et le cache KV dépend de l'architecture, pas seulement de la fenêtre. Le cache KV stocke les clés et valeurs d'attention de chaque token du contexte et s'alloue en plus des poids.
Octets KV par token = 2 (clés et valeurs) × couches d'attention complète × têtes KV × dimension de tête × octets par valeur (2 pour le cache f16 par défaut). Llama 3.1 8B : 2 × 32 × 8 × 128 × 2 = 131 072 octets (128 Kio) par token, soit 16 Gio à 128K tokens, plus de trois fois son téléchargement de 4.9 Go.
Les architectures récentes réduisent ce coût. Gemma 4 utilise l'attention à fenêtre glissante dans la plupart des couches (fenêtre de 1 024 tokens pour les 12B, 26B et 31B), gpt-oss dans une couche sur deux (128 tokens), Qwen3.5 et Qwen3.8 l'attention linéaire Gated DeltaNet dans trois couches sur quatre, et Nemotron 3 Nano n'a que 6 couches d'attention sur 52. Seules les couches d'attention complète croissent avec la fenêtre.
Les valeurs ci-dessous sont calculées à partir de la configuration publiée de chaque modèle, et non mesurées. Les environnements d'exécution ajoutent des tampons de calcul et les implémentations du cache diffèrent : confirmez l'usage réel avec ollama ps.
Quantifier le cache KV le réduit : selon la documentation d'Ollama, q8_0 utilise environ la moitié de la mémoire de f16 et q4_0 environ un quart, avec une perte de précision faible à moyenne pour q4_0.
Modèle | Téléchargement | KV à 32K | KV à 128K | KV à fenêtre max. |
|---|---|---|---|---|
| Llama 3.1 8B | 4.9 Go | 4 Gio | 16 Gio | 16 Gio (128K) |
| Mistral Small 3.2 24B | 15 Go | 5 Gio | 20 Gio | 20 Gio (128K) |
| gpt-oss 20B | 14 Go | 0.8 Gio | 3 Gio | 3 Gio (128K) |
| Qwen3.5 4B | 3.3 Go | 1 Gio | 4 Gio | 8 Gio (256K) |
| Qwen3.5 9B | 6.6 Go | 1 Gio | 4 Gio | 8 Gio (256K) |
| Gemma 4 12B | 7.7 Go | 0.8 Gio | 2.3 Gio | 4.3 Gio (256K) |
| Gemma 4 26B-A4B | 16 Go | 0.8 Gio | 2.7 Gio | 5.2 Gio (256K) |
| Gemma 4 31B | 19 Go | 3.3 Gio | 10.8 Gio | 20.8 Gio (256K) |
| Qwen3.8 27B | 18 Go | 2 Gio | 8 Gio | 16 Gio (256K) |
| Qwen3.5 35B-A3B | 22 Go | 0.6 Gio | 2.5 Gio | 5 Gio (256K) |
| Qwen3 30B-A3B-2507 | 19 Go | 3 Gio | 12 Gio | 24 Gio (256K) |
| Nemotron 3 Nano 30B-A3B | 18 Go | 0.2 Gio | 0.8 Gio | 6 Gio (1M) |
Quel modèle à contexte long convient à votre machine ?
Choisissez d'abord selon la mémoire : les poids plus le cache KV au contexte voulu doivent tenir, avec 2 à 3 Go de marge pour le système d'exploitation et l'environnement d'exécution. Les choix ci-dessous sont de l'arithmétique à partir du tableau ci-dessus, pas des classements de qualité ; nous n'avons pas évalué la précision en contexte long.
- 8 Go : Qwen3.5 4B (téléchargement de 3.3 Go). Le cache KV fait 1 Gio à 32K et 2 Gio à 64K ; 128K exige 4 Gio, ce qui est juste sur 8 Go.
- 16 Go : Qwen3.5 9B (6.6 Go) tient à 128K avec environ 4 Gio de cache KV. Gemma 4 12B (7.7 Go) tient dans sa fenêtre complète de 256K avec environ 4.3 Gio.
- 24 à 32 Go : Gemma 4 26B-A4B (16 Go) exige environ 5.2 Gio à 256K. Qwen3.8 27B (18 Go) exige environ 8 Gio à 128K. gpt-oss 20B (14 Go) exige environ 3 Gio à son maximum de 128K.
- 48 Go et plus : Gemma 4 31B (19 Go) exige environ 21 Gio à 256K. Mistral Small 3.2 24B (15 Go) exige 20 Gio à 128K avec un cache f16 et environ 10 Gio avec q8_0.
- 1M tokens : d'après sa configuration, Nemotron 3 Nano 30B exige environ 6 Gio de cache KV à 1M en plus de son téléchargement de 18 Go : la mémoire seule ne l'exclut donc pas sur une machine de 32 Go. NVIDIA livre 256K par défaut et cite des GPU H100 et A100 comme matériel pris en charge, et Unsloth avertit que 1M peut provoquer des plantages par manque de mémoire : considérez-le comme une expérience. Qwen indique que 1M tokens sur Qwen3-30B-A3B-Instruct-2507 exige environ 240 Go de mémoire GPU.
Pourquoi le contexte utilisable est-il plus court que le maximum annoncé ?
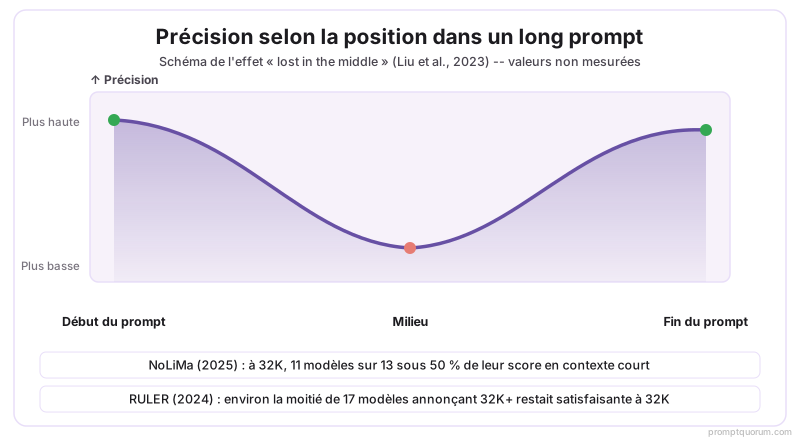
La fenêtre annoncée est une borne supérieure d'architecture, pas une garantie de qualité. Liu et al. (2023) ont constaté que les modèles de langage répondent le plus précisément quand le texte pertinent se trouve au début ou à la fin de l'entrée, et moins précisément quand il est au milieu : l'effet « lost in the middle ».
RULER (Hsieh et al., 2024) a testé 17 modèles annonçant tous 32K tokens ou plus ; seule la moitié environ a gardé une performance satisfaisante à 32K. NoLiMa (Modarressi et al., 2025) a testé 13 modèles annonçant au moins 128K ; à 32K, 11 d'entre eux sont tombés sous 50 % de leur score en contexte court, et GPT-4o est passé de 99.3 % à 69.7 %.
Ces études précèdent la plupart des modèles de ce guide : voyez-y la preuve du phénomène, pas des scores pour un modèle cité ici. Pour vérifier un modèle vous-même, cachez un fait à 10 %, 50 % et 90 % d'un long prompt, interrogez-le avec d'autres mots et recommencez à 32K, 64K et 128K.
Quand la précision compte, placez les instructions et faits critiques au début ou à la fin du prompt, ne récupérez que les passages pertinents (voir la section RAG ci-dessous) ou traitez les longs documents par sections qui se chevauchent.
Comment régler la longueur de contexte dans Ollama, LM Studio et llama.cpp ?
Ollama choisit son contexte par défaut selon votre VRAM : 4K tokens sous 24 Gio, 32K de 24 à 48 Gio et 256K à partir de 48 Gio. L'entrée au-delà du contexte actif est tronquée : le modèle ne voit alors jamais le début d'un long document.
Vous pouvez régler le contexte avec le curseur de l'application Ollama, la variable d'environnement OLLAMA_CONTEXT_LENGTH, /set parameter num_ctx dans ollama run, un Modelfile ou l'option num_ctx de l'API. Confirmez le résultat avec ollama ps.
Dans LM Studio, ouvrez My Models, cliquez sur l'icône d'engrenage d'un modèle et réglez la taille de contexte et Flash Attention. Dans llama.cpp, -c fixe la taille de contexte (0 la charge depuis le modèle), -fa contrôle Flash Attention, et --cache-type-k et --cache-type-v quantifient le cache KV.
Ollama ne quantifie le cache KV que si Flash Attention est activé, et le réglage est global pour tous les modèles. OLLAMA_KV_CACHE_TYPE=q8_0 utilise environ la moitié de la mémoire de f16 et q4_0 environ un quart.
# 1. Check what a loaded model really uses (see the CONTEXT column)
ollama ps

# 2. Server-wide default (the Ollama app has a context slider instead)
OLLAMA_CONTEXT_LENGTH=65536 ollama serve

# 3. One interactive session
ollama run qwen3.5:9b
>>> /set parameter num_ctx 65536

# 4. A persistent custom model
cat << EOF > Modelfile
FROM qwen3.5:9b
PARAMETER num_ctx 131072
EOF
ollama create qwen3.5-9b-128k -f Modelfile
ollama run qwen3.5-9b-128k

# 5. Optional: shrink the KV cache (global setting, needs Flash Attention)
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# llama.cpp equivalent
llama-server -m model.gguf -c 131072 -fa on --cache-type-k q8_0 --cache-type-v q8_0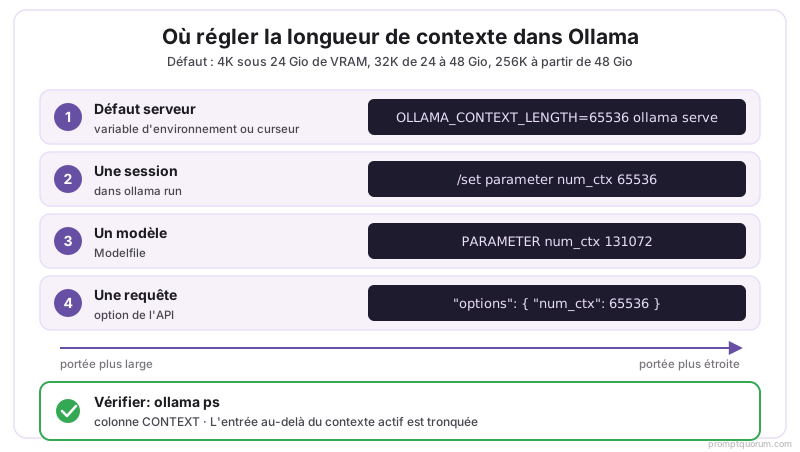
Les documents non anglais consomment-ils plus de fenêtre de contexte ?
Ils le peuvent : Petrov et al. (2023) ont constaté que le même texte peut exiger jusqu'à 15 fois plus de tokens dans une langue que dans une autre, selon le tokenizer. Que le texte japonais, chinois, coréen ou arabe soit concerné dépend du tokenizer du modèle.
Ne convertissez pas les pages en tokens avec la règle anglaise de 0.75 mot par token. Comptez les tokens avec le modèle que vous comptez utiliser : ollama run <model> --verbose affiche le nombre de tokens du prompt après une réponse.
Budgétez la fenêtre par langue et par famille de modèles, car les tokenizers diffèrent d'une famille de modèles à l'autre.
Contexte long ou RAG pour les documents ?
Utilisez le RAG quand la réponse se trouve dans quelques passages d'une grande collection, et le contexte long quand le modèle doit raisonner sur un document cohérent.
Le RAG (retrieval-augmented generation) récupère les segments les plus pertinents, souvent quelques milliers de tokens au total, et garde le prompt court. Le contexte long préserve les renvois, comme les clauses d'un contrat ou les chaînes d'appels d'une base de code, que le découpage peut séparer.
Beaucoup de configurations combinent les deux : récupérer des sections entières plutôt que des fragments et les placer dans une fenêtre de 32K à 128K. Voir Meilleurs outils RAG locaux pour les options locales et Le RAG expliqué pour la méthode.
Erreurs courantes avec les LLM locaux à contexte long
- Se fier au contexte par défaut : Ollama utilise 4K tokens par défaut sous 24 Gio de VRAM, quoi que le modèle prenne en charge : un document de 100 pages est tronqué avant que le modèle ne le lise. Définissez explicitement le contexte et confirmez-le dans la colonne CONTEXT de ollama ps.
- Budgétiser la mémoire d'après la taille du téléchargement : le cache KV peut dépasser les poids. Llama 3.1 8B pèse 4.9 Go au téléchargement mais exige environ 16 Gio de cache KV à 128K. Utilisez la formule ou le tableau ci-dessus avant d'augmenter le contexte.
- Supposer que chaque tag a la longue fenêtre : dans la bibliothèque Ollama, qwen3:14b annonce 40K tandis que qwen3:30b annonce 256K. Lisez la valeur de contexte sur la page du modèle avant de planifier.
- Confondre fenêtre annoncée et fenêtre utilisable : RULER et NoLiMa ont constaté de fortes baisses de précision à 32K pour de nombreux modèles annonçant 128K ou plus. Testez avec vos propres documents à la longueur que vous comptez utiliser.
- Viser 1M tokens par défaut : le temps de préremplissage et la mémoire croissent avec le prompt, et Unsloth avertit que 1M peut provoquer des plantages par manque de mémoire pour Nemotron 3 Nano. Réservez 1M à des tâches occasionnelles et préférez le RAG ou le découpage au quotidien.
- Choisir q4_0 pour le cache KV sans test : Ollama documente une perte de précision faible à moyenne pour q4_0, plus sensible à de grands contextes, et le réglage s'applique à tous les modèles. Commencez par q8_0.
Questions fréquemment posées
Quelle est la plus longue fenêtre de contexte qu'un LLM local peut utiliser en 2026 ?
Llama 4 Scout annonce 10M tokens, mais sa fiche rapporte des benchmarks à 128K et le téléchargement Ollama fait 67 Go. Parmi les modèles qui tournent sur une machine grand public, NVIDIA Nemotron 3 Nano 30B-A3B prend en charge 1M tokens (256K est la configuration par défaut), et Qwen3.8 et Qwen3.5 prennent en charge 256K en natif, jusqu'à environ 1M avec YaRN. Qu'une longue fenêtre soit utilisable dépend de la mémoire et de la précision avec laquelle le modèle lit de longues entrées.
Une fenêtre de contexte de 128K suffit-elle encore ?
128K tokens représentent environ 100 000 mots, assez pour la plupart des documents isolés. Un livre de 300 pages compte typiquement 75 000 à 100 000 mots, soit à peu près 100K à 135K tokens : il dépasse donc généralement une fenêtre de 128K ou la remplit presque, sans place pour les questions et réponses. Une fenêtre de 256K contient le livre et la réponse ; au-delà, utilisez le RAG ou le découpage.
De quelle mémoire un contexte de 1M tokens a-t-il besoin ?
Cela dépend de l'architecture. D'après les configurations publiées, le cache KV en f16 à 1M tokens représente environ 32 Gio pour Qwen3.5 9B, environ 64 Gio pour Qwen3.8 27B et environ 6 Gio pour Nemotron 3 Nano 30B-A3B, en plus des poids. Qwen indique que 1M tokens sur Qwen3-30B-A3B-Instruct-2507 exige environ 240 Go de mémoire GPU. Un cache q8_0 divise par deux les valeurs KV, et le temps de lecture d'un prompt de 1M tokens croît avec sa longueur : réservez-le à des tâches occasionnelles.
Pourquoi des modèles de même fenêtre de contexte exigent-ils des quantités de mémoire différentes ?
Le cache KV croît avec couches d'attention complète × têtes KV × dimension de tête × tokens. Llama 3.1 8B exige 128 Kio par token, Gemma 4 26B-A4B environ 20 Kio car seules 5 de ses 30 couches utilisent l'attention complète, et Nemotron 3 Nano environ 6 Kio car seules 6 de ses 52 couches sont des couches d'attention. Les couches à fenêtre glissante, à attention linéaire et Mamba conservent un état de taille fixe au lieu de croître avec la fenêtre.
Qu'est-ce que le cache KV et comment le réduire ?
Le cache KV contient les clés et valeurs d'attention de chaque token du contexte, pour que le modèle ne les recalcule pas à chaque nouveau token. Il s'alloue en plus des poids et croît avec la longueur de contexte. Pour le réduire, baissez num_ctx, activez Flash Attention et réglez OLLAMA_KV_CACHE_TYPE sur q8_0 (environ la moitié de la mémoire de f16) ou q4_0 (environ un quart, avec plus de perte de précision aux longs contextes), ou choisissez un modèle au cache plus petit par token. Dans Ollama, le type de cache est global et s'applique à tous les modèles.
Pourquoi mon modèle local oublie-t-il le début de mon document ?
Le plus probable : le contexte actif est plus petit que votre document. Ollama utilise par défaut 4K tokens sur les GPU de moins de 24 Gio de VRAM, 32K de 24 à 48 Gio et 256K à partir de 48 Gio, quoi que le modèle prenne en charge, et l'entrée au-delà du contexte est tronquée. Vérifiez la colonne CONTEXT de ollama ps et augmentez-le avec OLLAMA_CONTEXT_LENGTH, /set parameter num_ctx, un Modelfile ou l'option num_ctx de l'API.
Comment régler un contexte de 128K dans Ollama ?
Créez un Modelfile avec FROM qwen3.5:9b et PARAMETER num_ctx 131072, exécutez ollama create qwen3.5-9b-128k -f Modelfile, puis ollama run qwen3.5-9b-128k et vérifiez avec ollama ps. Vous pouvez aussi démarrer le serveur avec OLLAMA_CONTEXT_LENGTH=131072 ollama serve. Assurez-vous d'abord que poids plus cache KV tiennent en mémoire ; pour Qwen3.5 9B, cela fait environ 6.6 Go plus 4 Gio.
Un contexte plus long ralentit-il un LLM local ?
Oui. Le modèle doit lire tout le prompt (préremplissage) avant d'écrire le premier token : le temps avant le premier token croît donc avec la longueur du prompt, et l'attention sur un cache plus grand réduit aussi la vitesse de génération. Les couches à attention linéaire et Mamba atténuent cette croissance sans la supprimer. Mesurez sur votre matériel avec ollama run <model> --verbose, qui affiche les débits d'évaluation du prompt et de génération.
Qu'est-ce que le problème « lost in the middle » et s'applique-t-il encore ?
Liu et al. (2023) ont constaté que les modèles de langage répondent le plus précisément quand le texte pertinent se trouve au début ou à la fin de l'entrée, et moins précisément quand il est au milieu. RULER (2024) et NoLiMa (2025) ont ensuite montré que de nombreux modèles annonçant des fenêtres de 32K à 128K perdent en précision bien avant leur limite. Ces études portaient sur des modèles antérieurs : faites donc votre propre vérification en cachant un fait à 10 %, 50 % et 90 % d'un long prompt, puis interrogez-le. Placez les instructions critiques au début ou à la fin, ou ne récupérez que les passages pertinents.
Contexte long ou RAG : que choisir pour répondre à des questions sur des documents ?
Le RAG est généralement plus économe en mémoire et en temps quand la réponse tient dans quelques passages d'une grande collection, car il garde le prompt à quelques milliers de tokens. Le contexte long est préférable quand le modèle doit raisonner sur un document cohérent, comme un contrat, une base de code ou un chapitre de livre, où le découpage séparerait des renvois. Beaucoup de configurations combinent les deux en récupérant des sections entières dans une fenêtre de 32K à 128K.
Puis-je résumer un livre entier avec un LLM local ?
Un livre de 300 pages représente à peu près 100K à 135K tokens : il tient dans une fenêtre de 256K (Qwen3.5, Qwen3.8, Gemma 4 à partir de 12B) et peut ne pas tenir dans une fenêtre de 128K une fois le résumé compté. Avec un modèle de 128K ou moins de mémoire, résumez chapitre par chapitre puis résumez les résumés. Définissez num_ctx explicitement pour que tout le livre soit dans le contexte actif.
Les documents non anglais consomment-ils plus de fenêtre de contexte ?
Ils le peuvent. Petrov et al. (2023) ont constaté que le même texte peut exiger jusqu'à 15 fois plus de tokens dans une langue que dans une autre, selon le tokenizer. Comptez les tokens avec votre modèle au lieu d'appliquer la règle anglaise de 0.75 mot par token : ollama run <model> --verbose affiche le nombre de tokens du prompt.
Quels modèles à contexte long tournent sur une machine de 16 Go ?
Par le calcul de mémoire, Qwen3.5 9B (téléchargement de 6.6 Go plus environ 4 Gio de cache KV à 128K) et Gemma 4 12B (7.7 Go plus environ 4.3 Gio à sa fenêtre complète de 256K) tiennent dans 16 Go avec quelques Go de marge. Ce sont des calculs à partir de configurations publiées, non des exécutions mesurées ; confirmez avec ollama ps.
Sources
- Ollama. (2026). "Context length" documentation. docs.ollama.com -- contexte par défaut selon la VRAM, OLLAMA_CONTEXT_LENGTH, recommandation de 64 000 tokens pour les agents.
- Ollama. (2026). "FAQ". docs.ollama.com -- /set parameter num_ctx, OLLAMA_FLASH_ATTENTION, OLLAMA_KV_CACHE_TYPE (f16, q8_0, q4_0).
- Ollama. (2026). "qwen3.8" library page. ollama.com -- 27B, 18 Go, contexte de 256K.
- Ollama. (2026). "qwen3.5" library page. ollama.com -- tags de 0.8B à 122B, contexte de 256K.
- Ollama. (2026). "qwen3" library page. ollama.com -- 40K pour 8B/14B/32B, 256K pour 4B/30B.
- Ollama. (2026). "gemma4" library page. ollama.com -- E2B/E4B 128K, 12B/26B/31B 256K.
- Ollama. (2026). "nemotron-3-nano" library page. ollama.com -- le tag 30B annonce un contexte de 1M, 18 Go.
- Ollama. (2026). "llama4" library page. ollama.com -- Scout 67 Go et 10M, Maverick 245 Go et 1M.
- Ollama. (2026). "mistral-small3.2", "gpt-oss" et "llama3.1" library pages. ollama.com -- fenêtres de 128K, téléchargements de 15 Go, 14 Go et 4.9 Go.
- Qwen Team. (2026). "Qwen3.8-27B" model card. huggingface.co -- 262 144 en natif, jusqu'à 1 000 000 avec YaRN, Apache-2.0.
- Qwen Team. (2026). "Qwen3.5-9B" model card. huggingface.co -- 262 144 en natif, jusqu'à 1 010 000 avec YaRN ; architecture hybride Gated DeltaNet.
- Qwen Team. (2025). "Qwen3-30B-A3B-Instruct-2507" model card. huggingface.co -- 262 144 en natif, 1M avec Dual Chunk Attention, environ 240 Go de mémoire GPU.
- Google. (2026). "Gemma 4 31B" model card. huggingface.co -- 128K pour E2B/E4B, 256K pour les plus grandes tailles.
- NVIDIA. (2025). "NVIDIA-Nemotron-3-Nano-30B-A3B-BF16" model card. huggingface.co -- 23 couches Mamba-2 et MoE plus 6 couches d'attention, 1M pris en charge, 256K par défaut.
- Meta. (2025). "Llama-4-Scout-17B-16E-Instruct" model card. huggingface.co -- 109B au total, 10M annoncés, benchmarks de contexte long à 128K.
- Unsloth. (2026). "NVIDIA Nemotron 3 Nano -- How To Run Guide". unsloth.ai -- le contexte de 1M peut manquer de mémoire, 262 144 par défaut.
- Liu et al. (2023). "Lost in the Middle: How Language Models Use Long Contexts". arxiv.org -- la précision est la plus élevée au début et à la fin de l'entrée.
- Hsieh et al. (2024). "RULER: What's the Real Context Size of Your Long-Context Language Models?". arxiv.org -- seule la moitié environ de 17 modèles annonçant 32K+ reste satisfaisante à 32K.
- Modarressi et al. (2025). "NoLiMa: Long-Context Evaluation Beyond Literal Matching". arxiv.org -- 11 modèles sur 13 tombent sous 50 % de leur score en contexte court à 32K.
- Petrov et al. (2023). "Language Model Tokenizers Introduce Unfairness Between Languages". arxiv.org -- jusqu'à 15 fois plus de tokens pour le même texte.
- llama.cpp. "llama-server" README. github.com -- --ctx-size, --flash-attn, --cache-type-k, --cache-type-v.
- LM Studio. "Per-model default parameters". lmstudio.ai -- taille de contexte et Flash Attention par modèle.
- Les tailles de cache KV de ce guide sont calculées à partir du config.json de chaque dépôt de modèle sur Hugging Face (couches, têtes KV, dimension de tête, types de couches d'attention) et ne sont pas mesurées.