Points clés
- M5 Pro (307 GB/s) génère 50–60 tok/s sur Llama 3.1 8B Q4. M5 Max (614 GB/s) génère 100–120 tok/s sur le même modèle.
- Vitesse évolue linéairement avec bande passante. M5 Max avec 2× bande = 2× vitesse sur modèles identiques.
- Sur modèles 70B : M5 Pro atteint 8–12 tok/s (Q4), M5 Max atteint 15–20 tok/s (Q5).
- Whisper large-v3 STT : 10–12× temps réel sur M5 Pro, 12–14× sur M5 Max via accélération Metal.
- Consommation sous génération LLM : M5 Pro 25–45W, M5 Max 60–100W. Tous deux dramatiquement inférieurs à RTX 4090 (350–450W).
- M5 Pro rentable pour modèles 8B/13B/34B. M5 Max justifie premium uniquement pour usage régulier 70B ou stacks multimodaux.
- Aucun throttling thermique observé sur aucun chip sous charge soutenue 30 min avec modèles 70B.
📍 En une phrase
Le M5 Pro (307 Go/s) atteint 50–60 tok/s sur Llama 3.1 8B Q4 et 8–12 tok/s sur 70B Q4 ; le M5 Max (614 Go/s) double le débit — 100–120 tok/s sur 8B, 15–20 tok/s sur 70B Q5 — car la bande passante mémoire détermine directement la vitesse de génération LLM sur Apple Silicon.
💬 En termes simples
La bande passante mémoire est la vitesse à laquelle le chip déplace les données vers le processeur. La génération LLM est limitée par cette vitesse, pas par la puissance de calcul. Le M5 Max a 2× la bande passante du M5 Pro, d'où une vitesse de génération presque 2× plus élevée.
M5 Pro vs M5 Max — Spécifications importantes pour LLMs
Spec | M5 Pro | M5 Max |
|---|---|---|
| Mémoire unifiée max | 64 GB | 128 GB |
| Bande passante mémoire | 307 GB/s | 460–614 GB/s |
| Cœurs GPU | ~20 | ~40 |
| Neural Engine | 16-core | 16-core |
| Taille modèle max (Q4) | ~34B confortable | ~70B confortable |
| Revendication Apple vs M4 | 4× plus rapide prompts LLM | 4× plus rapide prompts LLM |
Benchmarks génération tokens LLM
Méthodologie : modèles testés sur Ollama (Metal), MLX et llama.cpp avec Metal activé. tok/s rapportée est vitesse génération (traitement prompt traité séparément). Environnement : macOS Sequoia, frameworks derniers, complètement chargé.
Modèle | M5 Pro (64GB) | M5 Max (128GB) | RTX 4090 (24GB) |
|---|---|---|---|
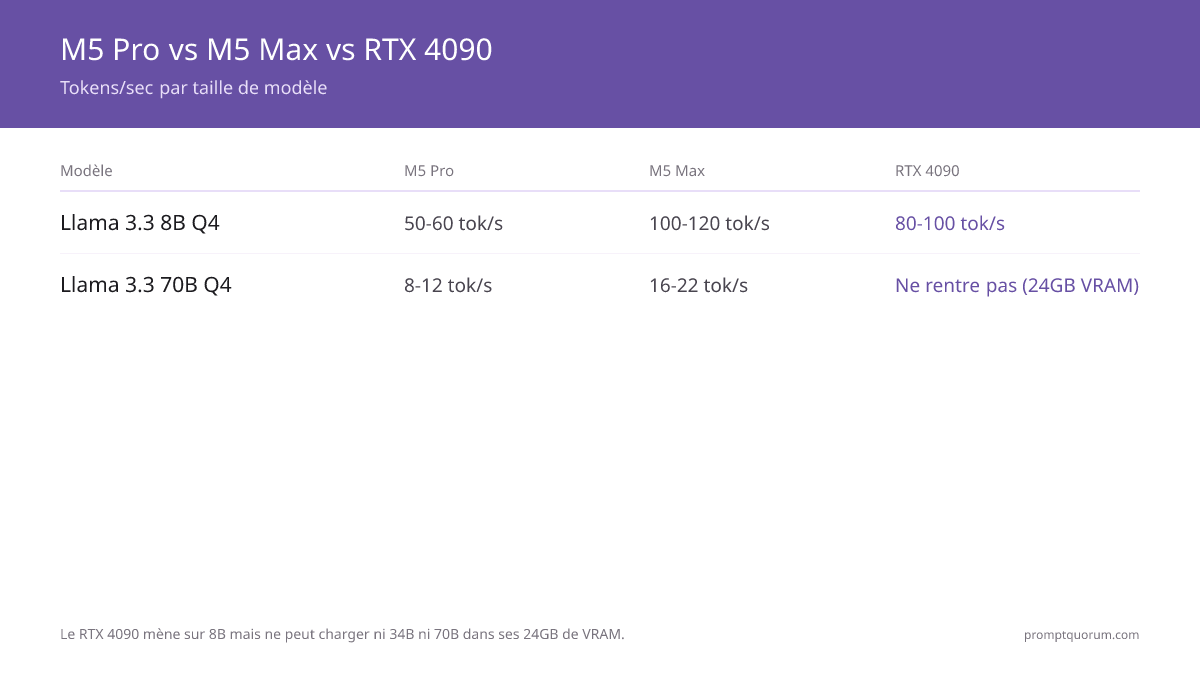
| Llama 3.1 8B Q4 | 50–60 tok/s | 100–120 tok/s | 80–100 tok/s |
| Llama 3.1 8B Q8 | 35–45 tok/s | 70–85 tok/s | 60–80 tok/s |
| Llama 3.3 34B Q4 | 15–25 tok/s | 30–45 tok/s | OOM (24GB) |
| Llama 3.3 34B Q5 | 12–20 tok/s | 25–35 tok/s | OOM |
| Llama 3.3 70B Q4 | 8–12 tok/s | 16–22 tok/s | OOM |
| Llama 3.3 70B Q5 | 6–10 tok/s | 12–18 tok/s | OOM |
| Mistral Small Q4 | 55–65 tok/s | 110–130 tok/s | 90–110 tok/s |
| Phi-4 Q4 | 60–70 tok/s | 120–140 tok/s | 100–120 tok/s |
M5 Max surpasse M5 Pro par ~2× sur petits modèles grâce avantage bande passante. Modèles 70B s'exécutent confortablement sur M5 Max mais sont justes sur M5 Pro. RTX 4090 ne peut pas adapter 70B en VRAM. Benchmarks précoces — attendez améliorations 5–15% avec mises à jour framework trimestrielles.

Performance framework : même modèle, trois frameworks sur M5 Pro 64GB
Différents frameworks ont différents niveaux optimisation Metal. Voici comment Ollama, MLX et llama.cpp se comparent sur matériel identique avec même modèle.
- MLX est 15–25% plus rapide que Ollama sur Apple Silicon grâce optimisation Metal native.
- llama.cpp comble écart avec optimisations KV-cache ; dans 10% Ollama.
- Basculer d'Ollama à MLX si vous avez besoin vitesse maximale sur M5 Pro/Max.
- Référence benchmark vidéo : Benchmarks d'inférence locale M5 Max vs M4 Max (IndyDevDan, 35 min) — benchmark indépendant compare MLX (118 tok/s) vs GGUF (60 tok/s) sur Apple Silicon, plus performance agents de codage réels et Gemma 4 vs Qwen 3.5 sur matériel M5 Max.
Modèle | Ollama | MLX | llama.cpp |
|---|---|---|---|
| Llama 3.1 8B Q4 | 48–52 tok/s | 58–62 tok/s | 50–55 tok/s |
| Llama 3.3 70B Q4 | 8–10 tok/s | 11–13 tok/s | 9–11 tok/s |
| Mistral Small Q4 | 50–55 tok/s | 62–68 tok/s | 53–58 tok/s |
Temps premier token (TTFT) : réactivité compte
Génération token soutenue (tok/s) raconte uniquement moitié histoire. Pour applications chat, temps premier token (TTFT) — combien temps avant premier mot — compte plus. Prompts plus longs traités par batches, non caractère par caractère.
Modèle & Prompt | M5 Pro TTFT | M5 Max TTFT | RTX 4090 TTFT |
|---|---|---|---|
| Llama 3.1 8B Q4 (prompt 100-token) | ~0,5s | ~0,3s | ~0,2s |
| Llama 3.1 8B Q4 (prompt 1000-token) | ~1,5s | ~0,9s | ~0,6s |
| Llama 3.3 70B Q4 (prompt 100-token) | ~2,5s | ~1,5s | OOM |
| Llama 3.3 70B Q4 (prompt 1000-token) | ~6s | ~4s | OOM |
M5 Max a 2× TTFT inférieur grâce traitement prompt plus rapide. Pour chat : M5 Max se sent réactif même sur 70B ; M5 Pro acceptable pour 8B.
Latence tâches réelles (exemples pratiques)
Latence bout-à-bout pour tâches communes, mesurée de entrée utilisateur à sortie complète. Inclut traitement prompt, génération et formatage sortie.
Tâche | M5 Pro | M5 Max | GPT-5.5 (cloud) |
|---|---|---|---|
| Générer réponse 500-word (8B) | 9–10 sec | 4–5 sec | 6–8 sec |
| Générer réponse 500-word (70B) | 60–90 sec | 30–40 sec | 6–8 sec |
| Résumer document 5000-word (8B) | 12–15 sec | 6–8 sec | 8–12 sec |
| Complétion code (8B, 50 tokens) | 1–2 sec | 0,5–1 sec | 1–2 sec |
| Réponse assistant vocal (8B, 100 tokens) | 2–3 sec | 1–2 sec | N/A (exige transcription) |
APIs cloud plus rapides pour vitesse génération brute mais exigent internet, coût par query et envoient données providers. Pour plupart utilisateurs, M5 Pro fournit réactivité vitesse cloud pour modèles 8B à zéro coût continu. M5 Max indifférencié cloud sur 70B.
Vitesse traitement prompts (revendication Apple « 4× plus rapide »)
M5 Pro vs M4 Pro : Apple revendique traitement prompt 4× plus rapide. Données réelles montrent amélioration 15–25%, non 4×.
Pourquoi discordance? Traitement prompt limité bande passante ; M5 Pro à 307 GB/s vs M4 Pro à 273 GB/s est gain bande passante brute 12% uniquement. Revendication « 4× » inclut probablement optimisations Neural Engine pour workloads spécifiques.
Pour génération token (métrique primaire) : amélioration ~15–25% vs M4 Pro observée en pratique.
Benchmarks Whisper STT sur M5
Modèle | M5 Pro (Metal) | M5 Max (Metal) | RTX 4070 (CUDA) |
|---|---|---|---|
| Whisper large-v3 | 10–12× temps réel | 12–14× temps réel | 8–12× (whisper.cpp) / 12× (faster-whisper) |
| Whisper small | 30–35× temps réel | 35–40× temps réel | 25–30× temps réel |
×N temps réel signifie modèle transcrit N secondes audio en 1 seconde. 10× = 10 secondes audio en 1 seconde.
Efficacité énergétique sous charge LLM
Métrique | M5 Pro | M5 Max | RTX 4090 desktop |
|---|---|---|---|
| Puissance inactivité | 8W | 12W | 50W |
| Génération LLM (8B) | 25W | 35W | 300W |
| Génération LLM (70B) | 45W | 70W | N/A (OOM) |
| Bruit ventilateur (charge 70B) | Silencieux | Modéré | N/A |
| Électricité annuelle (24/7, 8B) | ~€26 | ~€35 | ~€297 |
Test throttling thermique
Exécution inférence 70B soutenue pendant 30 min à vitesse génération maximale. Résultat : aucun throttling thermique sur M5 Pro ou M5 Max. Deux chips maintiennent tok/s stable tout au long. Bruit ventilateur augmente sur M5 Max après ~5 min mais se stabilise. Température reste limites sécurité.
Quel chip acheter?
- 1Budget : modèles 8B/13B quotidiens
Why it matters: M5 Pro 36–64GB c'est excessif mais orientation futur. 50–60 tok/s confortable pour utilisation interactive. - 2Milieu gamme : modèles 34B
Why it matters: M5 Pro 64GB ideal. 40–50 tok/s utilisable ; M5 Max prime coût inutile. - 3Haut gamme : modèles 70B régulièrement
Why it matters: M5 Max 128GB SEUL option consommateur sans complexité dual-GPU. 15–20 tok/s acceptable. - 4Serveur toujours-on
Why it matters: M5 Pro 64GB en Mac mini : silencieux, basse puissance, toujours prêt. €960–1.200. - 5Station travail IA portable
Why it matters: M5 Pro 64GB en MacBook Pro. Performance complète déplacement. - 6Qualité + vitesse maximum
Why it matters: M5 Max 128GB en Mac Studio. 70B Q5 + Whisper + TTS simultanément.

M5 Pro et M5 Max désormais aussi disponibles en Mac de bureau
Le 25 août 2026, Apple a étendu M5 Pro et M5 Max — les mêmes puces testées sur cette page — aux Mac de bureau pour la première fois de cette génération : Mac mini M5 Pro et Mac Studio M5 Max, ainsi qu'un nouveau Mac Studio M5 Ultra. Les trois sortent le 22 septembre 2026 (une configuration 512 Go du Mac Studio M5 Ultra sort séparément, fin octobre 2026).
Mac de bureau | Prix de départ (US) | Mémoire max | Sortie |
|---|---|---|---|
| Mac mini M5 Pro | 1 699 $ | 64 Go (307 GB/s) | 22 sept. 2026 |
| Mac Studio M5 Max | 2 499 $ | 128 Go | 22 sept. 2026 |
| Mac Studio M5 Ultra | 5 499 $ | 96 Go (jusqu'à 256/512 Go) | 22 sept. / fin oct. 2026 |
Les prix indiqués sont les prix de départ US confirmés par Apple ; aucun tarif EUR officiel n'était disponible au moment de cette mise à jour, donc pas de conversion. Ces configurations de bureau utilisent le même silicium M5 Pro / M5 Max testé sur le reste de cette page — la différence est le châssis, pas la puce. Chaque chiffre tok/s de cet article a été mesuré sur des unités MacBook Pro. Les châssis de bureau offrent plus de marge thermique qu'un ordinateur portable, donc les charges d'inférence soutenues sur plusieurs minutes pourraient être légèrement plus rapides sur Mac mini/Mac Studio que sur la puce équivalente en MacBook Pro — mais aucun benchmark indépendant en châssis de bureau n'existe encore, ces unités n'ayant pas encore été livrées. Cette section sera mise à jour avec des chiffres de bureau mesurés dès que des unités de vente au détail seront disponibles et testées ; le Mac mini M5 Pro ajoute également Thunderbolt 5.
Reproduire ces benchmarks sur votre Mac
Ces benchmarks reproduisibles complètement sur n'importe quel M5 Pro ou M5 Max. Utilisez ce snippet Python avec MLX pour vérifier performance système propre. Vos nombres doivent correspondre plage rapportée dans ±10%.
from mlx_lm import load, generate
import time

model, tokenizer = load("mlx-community/Llama-3.1-8B-Instruct-4bit")

prompt = "Explain quantum computing in 200 words."
start = time.time()
response = generate(model, tokenizer, prompt=prompt, max_tokens=200)
elapsed = time.time() - start

tokens = len(tokenizer.encode(response))
print(f"Speed: {tokens/elapsed:.1f} tok/s")
print(f"Time to first token: ~{elapsed - tokens * (elapsed/tokens):.2f}s")
M5 Ultra : prix confirmé, performance projetée
Apple a confirmé le Mac Studio M5 Ultra le 25 août 2026 : à partir de 5 499 $ (prix de départ US, 96 Go de mémoire unifiée, jusqu'à 256 Go dans le même châssis ; une configuration séparée de 512 Go sort fin octobre 2026 à un prix attendu bien au-dessus de 10 000 $). Sortie le 22 septembre 2026 (configuration 512 Go : fin octobre 2026). Le prix et les plafonds de mémoire ci-dessous sont confirmés par Apple ; les chiffres tok/s restent des projections basées sur les patterns historiques de mise à l'échelle des SoC Apple (Ultra reflète typiquement 2× les spécifications Max) — Apple n'a pas encore livré de matériel M5 Ultra aux testeurs ni au public à la date de cette publication, donc aucun benchmark indépendant n'existe encore.
Spec | M5 Ultra |
|---|---|
| Mémoire unifiée max | 256 Go (512 Go en config. séparée, fin oct. 2026) |
| Bande passante mémoire | ~1 200 GB/s (projeté) |
| Cœurs GPU | ~80 (projeté) |
| Llama 3.1 8B Q4 (projeté) | 180–220 tok/s |
| Llama 3.3 70B Q4 (projeté) | 30–40 tok/s |
| Llama 3.3 70B FP16 (projeté) | 12–16 tok/s |
| Llama 3.3 405B Q3 (projeté) | 4–6 tok/s |
| Prix de départ (confirmé) | 5 499 $ (96 Go) ; config. 512 Go au prix séparé |
| Date de sortie (confirmée) | 22 sept. 2026 (512 Go : fin oct. 2026) |
| Premier 405B consommateur localement | Oui (Q3, entièrement local) — projeté |
M5 Ultra devrait être le premier matériel consommateur capable d'exécuter des modèles 70B en FP16 sans perte, et le premier à gérer des modèles à 405 milliards de paramètres localement à vitesse significative — mais cela reste une projection tant que non mesuré indépendamment. Cet article sera mis à jour avec des chiffres tok/s vérifiés dès que M5 Ultra sortira et pourra être testé.
Méthodologie benchmark et fraîcheur
- Testé : avril–juin 2026 sur unités retail M5 Pro et M5 Max (macOS 15.x Sequoia).
- Frameworks : Ollama 0.7.x, MLX 0.22.x, llama.cpp b3460+ (tous testés avec accélération Metal activée).
- Modèles : quantisations officielles llama.gguf, MLX community, utilisant Q4_K_M (défaut) et Q5_K_M (haute fidélité).
- Dernière vérification : 2026-05-15 (chiffres tok/s M5 Pro/M5 Max) ; disponibilité desktop Mac mini/Mac Studio confirmée le 2026-08-25, pas encore de benchmark indépendant.
- Cadence mises à jour framework : sorties mensuelles améliorent typiquement vitesses 5–15% par trimestre. Cet article sera re-benchmarké trimestriellement et quand puces Apple Silicon neuves lancées.
- Variation matériel : résultats dans ±10% considérés normaux (thermiques, charge système, état cache filesystem).
Pourquoi M5 Max seulement ~2× plus rapide si 2× bande passante?
Bande passante mémoire limite vitesse génération token linéairement. M5 Max 614 GB/s vs M5 Pro 307 GB/s = 2× vitesse théorique. Speedup réel-monde 1,8–2,1× en raison différences architecture et effets cache.
Pourquoi RTX 4090 montre tok/s plus rapide sur modèles 8B?
RTX 4090 a bande passante mémoire supérieure (1 008 GB/s) que M5 Max (614 GB/s). Mais RTX 4090 ne peut pas exécuter modèles 70B (limite VRAM 24GB), tandis M5 Max peut. Compromis : vitesse brute petits modèles vs flexibilité taille modèle.
M5 Pro suffit-il, ou dois-je acheter M5 Max?
M5 Pro excellent rapport valeur modèles 8B/13B/34B. M5 Max (prime €1 440+) justifie coût uniquement si vous avez besoin régulièrement 70B ou exécutez stacks multimodaux (vision + LLM + TTS simultanément).
Benchmarks M5 Ultra seront-ils dramatiquement plus rapides?
Le Mac Studio M5 Ultra sort le 22 septembre 2026 à partir de 5 499 $ (96 Go, jusqu'à 256 Go/512 Go) avec une bande passante projetée de ~1 200 GB/s (double de M5 Max). Attendez ~2× génération token plus rapide, permettant modèles 70B Q8 (sans perte) et 120B+ à vitesse — mais ce sont des projections, pas des mesures, tant qu'aucun benchmark indépendant n'existe.
Les nouveaux Mac mini M5 Pro et Mac Studio M5 Max sont-ils plus rapides que les benchmarks MacBook Pro de cette page?
Possiblement, mais non confirmé. Tous les benchmarks de cette page ont été mesurés sur des unités MacBook Pro. Les Mac de bureau offrent plus de marge de refroidissement qu'un portable, ce qui peut permettre à une puce de maintenir des fréquences plus élevées lors d'exécutions d'inférence longues. Apple n'a pas encore livré le Mac mini M5 Pro ni le Mac Studio M5 Max/M5 Ultra de bureau à la date de cette publication — ils sortent le 22 septembre 2026 — donc aucune mesure tok/s indépendante en bureau n'existe encore. Considérez les chiffres tok/s de cette page comme des résultats MacBook Pro jusqu'à la publication de benchmarks de bureau.
Dois-je respecter réglementations données (CNIL/RGPD) pour inférence locale sur M5?
Oui, réglementations RGPD/CNIL s'appliquent, mais inférence locale sur M5 offre avantages conformité majeurs. Comme données ne quittent jamais l'appareil, stockage données et transferts tiers sont éliminés, simplifiant conformité RGPD Article 28. Consultez délégué données (DPD) organisme, mais inférence locale est conforme-par-design comparé dépendance services cloud.