Aperçu des familles de modèles : Qwen3.8-27B, Llama 4 et Mistral
Famille | Développeur | Tailles disponibles | Architecture | Contexte |
|---|---|---|---|---|
| Qwen3 | Alibaba | 0.6B, 1.7B, 4B, 8B, 14B, 30B-A3B, 32B, 235B-A22B ; Qwen3.8-27B (dernière, vision-langage) | Dense | 128K–262K tokens |
| Llama 4 Scout | Meta | 17B actif/109B total (16 experts, ~55 GB VRAM Q4) | MoE multimodal | 10M tokens |
| Mistral Small 3.1 | Mistral AI | 24B | Dense | 32K tokens |
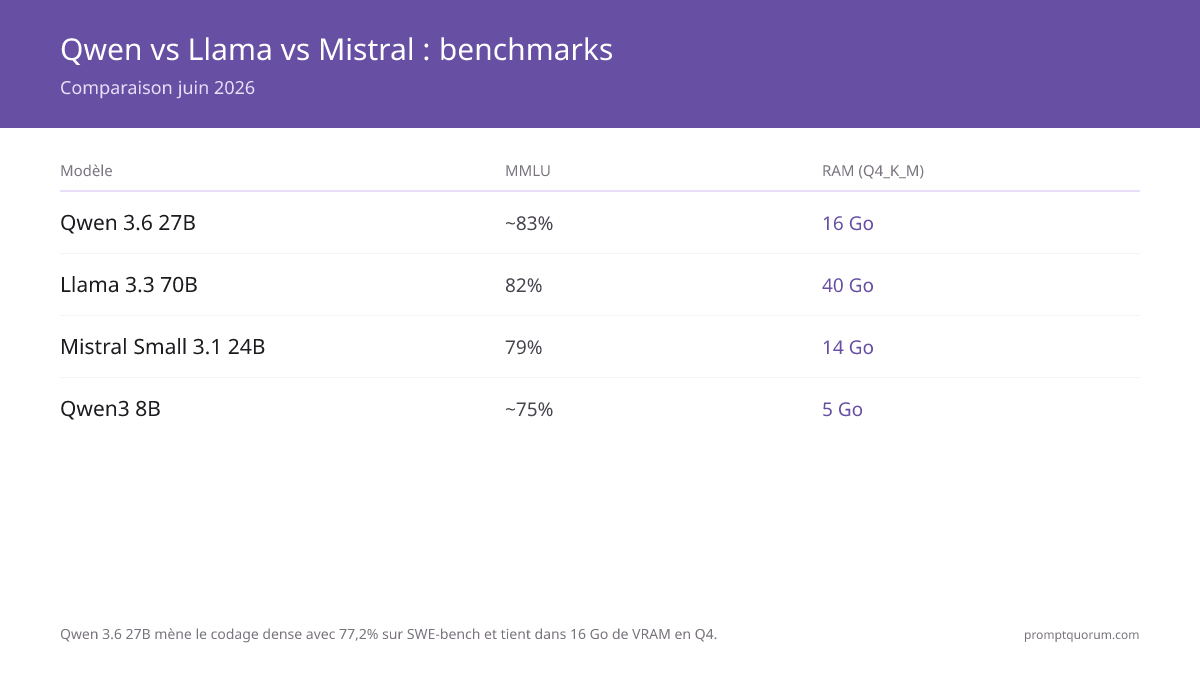
Comparaison des benchmarks : Qwen3.8-27B, Llama 4 Scout, Mistral 2026
Juin 2026 : SWE-bench devient le benchmark primaire pour les tâches de codage multi-fichier en production. Qwen3.8-27B affiche 61.7 SWE-bench Pro (chiffre Qwen) et tient dans 24 GB en Q4, tandis que Devstral Small 2 est conçu pour le codage agentic. Llama 4 Scout est le choix contexte long / multimodal mais nécessite ~55 GB VRAM en Q4. Les tirets indiquent des benchmarks non publiés ou non applicables. Valeurs rapportées par l'éditeur, non mesurées par PromptQuorum ; consultez la fiche de chaque modèle. SWE-bench Pro et Verified sont des variantes différentes et ne doivent pas être comparés directement.
Modèle | MMLU | HumanEval | SWE-bench | MATH | RAM (Q4_K_M) |
|---|---|---|---|---|---|
| Qwen3.8-27B | — | — | 61.7 (Pro) | — | 18 GB (carte 24 GB) |
| Llama 4 Scout 17B | — | — | — | — | ~55 GB |
| Devstral Small 2 | — | — | 65.8% (Verified) | — | 15 GB |
| Qwen3 32B | — | — | — | — | 20 GB |
| Mistral Small 3.1 24B | 79% | — | — | — | 14 GB |
| Llama 3.3 70B | — | — | — | — | 40 GB |
| Qwen3 14B | — | — | — | — | 9 GB |
| Qwen3 8B | — | — | — | — | ~5 GB |

Qwen3.8-27B : Forces et faiblesses
Qwen3.8-27B affiche 61.7 SWE-bench Pro (chiffre Qwen) — le meilleur résultat de codage dense de cette comparaison.
Forces : Codage dense meilleur (61.7 SWE-bench Pro selon Qwen), support natif 29 langues, contexte 128K tokens, tool calling.
Faiblesses : Moins de support écosystème que Llama (fine-tunes, guides, intégrations) ; style de génération anglaise créative moins naturel que Llama.
Llama 4 Scout : Forces et faiblesses
Llama 4 Scout (17B actif, 109B total MoE, 16 experts, multimodal) de Meta est le choix contexte long / multimodal en 2026. L'architecture MoE n'active que 17B paramètres par token, mais tous les experts doivent rester en mémoire : en Q4 il nécessite ~55 GB VRAM et ne tient pas sur un GPU grand public de 24 GB en quantification normale (seulement en 1,78-bit, ~20 tok/s).
Forces : contexte 10M tokens (record), entrée multimodale, support écosystème le plus large, fort suivi des instructions, excellent pour contexte très long.
Faiblesses : VRAM élevée (~55 GB en Q4) hors de portée d'un seul GPU grand public de 24 GB.
Mistral Small 3.1 : Forces et faiblesses
Mistral Small 3.1 24B fournit le meilleur rapport qualité-VRAM (79% MMLU sur 14 GB) — idéal pour matériel contraint.
Forces : Meilleur rapport qualité-VRAM (79% MMLU à 14 GB), excellent tool calling, licence Apache 2.0 sur plusieurs modèles (vérifiez la licence de chaque modèle avant tout usage commercial), origine européenne (France), très peu de dépendances.
Faiblesses : peu d'options de tailles comparé à Qwen/Llama.
Appels d'outils et capacités agentic
Qwen3.8-27B, Llama 4 Scout et Mistral Small 3.1 supportent nativement les appels d'outils. Devstral Small 2 est optimisé pour les workflows agentic multi-fichiers (éditions de code distribuées).
Modèle | Tool Calling | Agentic | Contexte |
|---|---|---|---|
| Qwen3.8-27B | ✅ Natif | ✅ Bon (61.7 SWE-bench Pro, chiffre Qwen) | 128K |
| Devstral Small 2 | ✅ Natif optimisé | ✅ Conçu pour le multi-fichier (65,8 % SWE-bench Verified, Mistral) | 32K |
| Llama 4 Scout 17B | ✅ Natif | ⚠️ Bon, pas spécialisé | 10M |
| Mistral Small 3.1 24B | ✅ Natif bien testé | ⚠️ Limité | 32K |
| Llama 3.3 70B | ✅ Natif | ⚠️ Bon, mais moins optimisé | 128K |
| Qwen3 8B | ✅ Natif | ⚠️ Modeste, léger en RAM | 128K |
Quelle famille gagne par tâche ?
Tâche | Gagnant | Pourquoi |
|---|---|---|
| Codage dense (SWE-bench) | Qwen3.8-27B | 61.7 SWE-bench Pro (chiffre Qwen) — meilleur modèle dense |
| Codage agentic multi-fichier | Devstral Small 2 | Conçu pour les workflows agentic multi-fichiers |
| Contexte long + multimodal | Llama 4 Scout 17B | MoE 17B actif, contexte 10M tokens, multimodal (~55 GB en Q4) |
| Q&A général (anglais) | Llama 3.x | Fort suivi des instructions en anglais ; consultez les fiches des modèles |
| Raisonnement mathématique | Qwen3 | Généralement fort en maths selon Qwen ; consultez les fiches des modèles |
| Langues non-anglaises | Qwen3.8-27B | 29 langues natives ; Llama/Mistral anglais-prioritaires |
| Qualité sur 14 GB RAM | Mistral Small 3.1 24B | Qualité proche de la classe 70B pour 14 GB de RAM |
| Premier modèle (débutant) | Llama 3.2 3B | Meilleur documenté, support communautaire maximal |

Comparaison taille par taille : MoE vs architecture dense
Classes 3B-7B : Qwen3 8B est en tête pour le codage. Llama 3.2 3B et Qwen3 8B offrent un bon support écosystème. Pour tâches non-codage, Llama 3.1 8B égale Qwen3 8B en qualité anglaise.
Classes 14B-24B : Qwen3 14B et Devstral Small 2 (agentic) sont les choix de codage. Mistral Small 3.1 24B offre le meilleur rapport qualité-VRAM (79% MMLU sur 14 GB).
Architecture MoE (Llama 4 Scout) : 17B paramètres actifs, 109B totaux, 16 experts, multimodal. Contexte 10M tokens (record 2026). Nécessite ~55 GB VRAM en Q4 (ne tient sur un GPU de 24 GB qu'en 1,78-bit, ~20 tok/s). Meilleur pour tâches nécessitant très long contexte ou entrée multimodale.
Classes 32B-70B : Qwen3 32B (~20 GB en Q4) et Llama 3.3 70B (~40 GB en Q4) sont les options denses de grande taille ; pour le codage, comparez d'abord les fiches de Qwen3 32B et Qwen3.8-27B ; Llama 3.3 70B reste un choix solide pour l'anglais. Valeurs indicatives ; consultez les fiches des modèles.
Comparaison avec modèles propriétaires (GPT-5.6, Claude Opus 5, Gemini 3.5) : voir GPT vs Claude vs Gemini : comment choisir.

Comment démarrer
Installez Ollama puis téléchargez n'importe quel modèle en une commande :
# Llama 4 Scout (contexte long, multimodal)
ollama run llama4:scout

# Qwen3 (codage)
ollama run qwen3:8b

# Devstral Small (agentic multi-fichier)
ollama run devstral:24b

# Mistral Small 3.1 (meilleur efficacité RAM)
ollama run mistral-small

# Llama 3.3 (anglais, large support écosystème)
ollama run llama3.3:70b
Chaque commande télécharge et exécute le modèle. Pas d'API requise, pas de GPU obligatoire (CPU fonctionne à 5-15 tokens/sec pour 7B-14B).
Contexte régional : EU/RGPD, Japon, Chine
UE/RGPD : les trois familles de modèles (Qwen3, Llama 3.x/4, Mistral) peuvent s'exécuter entièrement sur votre propre matériel, ce qui évite d'envoyer les données d'inférence à des prestataires externes. Cela écarte une question de transfert de données, mais ne rend pas à lui seul un déploiement conforme au RGPD : base légale, mesures techniques et organisationnelles et, le cas échéant, analyse d'impact restent nécessaires. Mistral AI est une société française ; Devstral Small 2 est publié sous Apache 2.0, tandis que pour Codestral 22B, vérifiez les conditions de licence avant tout usage commercial. Qwen3 (Apache 2.0) peut aussi être utilisé dans l'UE. Les modèles multimodaux Llama 4 sont soumis à des restrictions territoriales dans la licence Llama ; vérifiez la licence avant tout usage dans l'UE. Vérifiez les obligations du règlement européen sur l'IA applicables à votre déploiement. Ceci est une information générale, non un conseil juridique.
Japon (METI) : les lignes directrices du METI sur la gouvernance de l'IA encouragent les entreprises à documenter la provenance et les performances des modèles ; Qwen3, Llama 3.x/4 et Mistral publient tous des fiches de modèle ou des rapports techniques utilisables à cette fin. Un déploiement sur infrastructure privée garde les données dans votre réseau, mais l'existence d'obligations de déclaration ou autres dépend de votre cas d'usage : vérifiez-la avec vos conseillers juridiques. Qwen3 dispose d'une tokenisation japonaise native parmi ses 29 langues, ce qui en fait un candidat naturel pour les charges de travail en japonais.
Chine (CAC) : les mesures provisoires de 2023 sur les services d'IA générative, appliquées par la Cyberspace Administration of China (CAC), visent surtout les services proposés au public en Chine ; leur application à un déploiement donné dépend de la manière dont il est offert, à confirmer avec un conseil local. Qwen3 (Alibaba) est conçu pour un usage en chinois parmi ses 29 langues natives. Si vous traitez des données en Chine, vérifiez les exigences de localisation des données et de transfert transfrontalier avant d'utiliser des API cloud.
Erreurs courantes
- Comparer des tailles différentes : Qwen3.8-27B vs Llama 70B n'est pas une comparaison équitable. Compare 27B vs 27B ou 70B vs 70B.
- Ignorer SWE-bench pour codage : SWE-bench (problèmes GitHub réels, multi-fichier) est plus pertinent qu'HumanEval (problèmes simples en fichier unique) pour tâches de production.
- Oublier contexte long : Llama 4 Scout 10M contexte change les calculs pour résumé document ou RAG sur larges corpus. N'utilisez pas pour 512K document si contexte 128K suffira.
- Mal interpréter la VRAM MoE : Llama 4 Scout n'active que 17B paramètres par token mais nécessite ~55 GB VRAM en Q4 (tous les experts doivent résider en mémoire), pas les ~14 GB d'un modèle dense de 17B. Il ne tient pas sur un GPU de 24 GB en quantification normale.
- Tester un benchmark : Test MMLU, HumanEval, SWE-bench ET MATH. Un modèle leader sur un peut être en retard sur autre.
Sources
- Qwen Team. (2025). « Qwen3 Technical Report ». arXiv:2505.09388 — Benchmarks de la famille Qwen3 (codage, mathématiques, multilingue).
- Meta AI. (2024). "Llama 4 Scout Model Card." ai.meta.com/blog/meta-llama-4 — Architecture MoE, contexte 10M tokens, benchmarks.
- Mistral AI. (2024). "Mistral Small 3.1 Technical Brief." mistral.ai — Efficacité RAM, architecture, benchmarks.
- Jimenez, C. E., et al. (2024). « SWE-bench : Can Language Models Resolve Real-World GitHub Issues? ». ICLR 2024, Princeton University. arXiv:2310.06770 — Benchmark de codage multi-fichiers.
- Chen, M., et al. (2021). « Evaluating Large Language Models Trained on Code ». github.com/openai/human-eval — Référence de codage mono-fichier, 164 problèmes.
- Hugging Face. (2026). "Open LLM Leaderboard." huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard — Classements MMLU/HumanEval/MATH en temps réel.
Questions fréquemment posées
Quel est le meilleur pour le codage dense : Qwen3.8-27B, Llama 4 Scout ou Mistral ?
Qwen3.8-27B affiche 61,7 SWE-bench Pro (chiffre Qwen) — meilleur codage dense de cette comparaison. Devstral Small 2 est conçu pour le codage agentic multi-fichier (65,8 % SWE-bench Verified selon Mistral). Llama 4 Scout excelle en contexte très long mais est moins orienté codage.
Llama 4 Scout vaut-il le coup comparé à Qwen3.8-27B ?
Dépend du cas. Scout : contexte 10M, multimodal, mais ~55 GB VRAM en Q4 (ne tient pas sur 24 GB en quantification normale). Qwen3.8-27B : meilleur globalement sur matériel grand public, meilleur codage dense (61,7 SWE-bench Pro selon Qwen), multilingue, tient dans 24 GB. Choisissez Scout si contexte 100K+ et VRAM suffisante, Qwen sinon.
Que signifie MoE et pourquoi Llama 4 Scout l'utilise ?
Mixture-of-Experts : 109B total paramètres, mais seuls 17B actifs par token. Tous les experts restent en mémoire, donc en Q4 Scout nécessite ~55 GB VRAM (pas les ~14 GB d'un dense 17B), permet contexte 10M et entrée multimodale. Compromis : VRAM élevée et moins optimal en codage que les architectures denses équivalentes.
Quel LLM local supporte le plus de langues ?
Qwen3.8-27B : 29 langues natives (chinois, japonais, arabe, allemand, français, coréen + autres). Llama 4 Scout, 3.3, 3.2 : ~8 langues. Mistral Small : principalement anglais + grandes langues UE.
SWE-bench vs HumanEval : quelle différence ?
HumanEval : 164 problèmes simples un fichier (test basique). SWE-bench : problèmes GitHub réels multi-fichier, éditions distribuées (test production). SWE-bench plus pertinent pour workflows codage sérieux. Qwen3.8-27B : 61,7 SWE-bench Pro selon Qwen.
Quel modèle avec 12 GB VRAM ?
Qwen3 14B (9 GB) ou Mistral Small 3.1 (14 GB, proche limite). Llama 4 Scout NE tient PAS sur 12 GB — il nécessite ~55 GB VRAM en Q4. Pour 24 GB, Qwen3.8-27B est le meilleur choix global.
Qwen3.8-27B remplace-t-il les modèles cloud pour le codage ?
Partiellement. Qwen3.8-27B affiche 61.7 SWE-bench Pro selon Qwen. Les modèles de frontière actuels (GPT-5.6, Claude Opus 5) gardent généralement une avance sur les tâches complexes ; l'écart dépend de la tâche. Pour refonte simple : Qwen suffisant. Pour refonte complexe : cloud conserve avantage.
Mistral Small 3.1 vaut-il 14 GB pour 79% MMLU ?
Oui si VRAM limité. Pour tâches non-codage, Mistral Small 24B offre qualité classe 70B. Pour codage, Qwen3.8-27B (61,7 SWE-bench Pro selon Qwen) est le choix le plus fort de cette comparaison. Choisissez Mistral si efficacité priori, Qwen si codage priori.
Puis-je utiliser ces modèles complètement hors ligne ?
Oui, pour l'inférence. Après le téléchargement initial du modèle, les trois familles (Qwen, Llama, Mistral) peuvent s'exécuter via Ollama ou LM Studio sans connexion internet et sans clé API. Vérifiez les réglages de télémétrie et de mise à jour de chaque outil si vous avez des exigences strictes.
Quelle famille pour débuter ?
Llama 3.2 3B : meilleure documentation, communauté maximal. Exécutez : ollama run llama3.2:3b (nécessite 8 GB RAM, pas GPU). Chaque outil (Ollama, LM Studio, OpenWebUI) supporte Llama par défaut.
Qu'est-ce qui a changé pour Qwen, Llama et Mistral depuis septembre ?
Qwen3.8 n'existe pour l'instant sur Ollama qu'en 27B (18 GB en Q4_K_M, contexte 256K) : Qwen3 8B et 14B restent donc les options Qwen plus petites. Devstral Small 2 (Mistral AI, 24B, 15 GB, 65,8 % SWE-bench Verified selon Mistral, Apache 2.0) est le tag Devstral actuel, et Mistral Large 4 (1,05T de paramètres au total / 52B actifs, selon sa fiche Ollama) est arrivé comme modèle d'échelle datacenter qui ne tient pas sur du matériel grand public. Llama 4 Scout (environ 55 GB en Q4) reste l'option contexte long de cette comparaison. Le classement pour matériel grand public ci-dessus ne change pas.