Points clés
- La RTX 4090 est arrêtée (EOL) depuis 2026 — chaque carte sur le marché est d'occasion, à ~2 000-2 600 $, très au-dessus des ~999-1 299 $ de début d'année.
- La RTX 5090 reste en production, mais la pénurie de mémoire GDDR7 de 2026 a fait grimper le prix de rue à 4 300-5 000 $+, plus du double du prix public de 1 999 $.
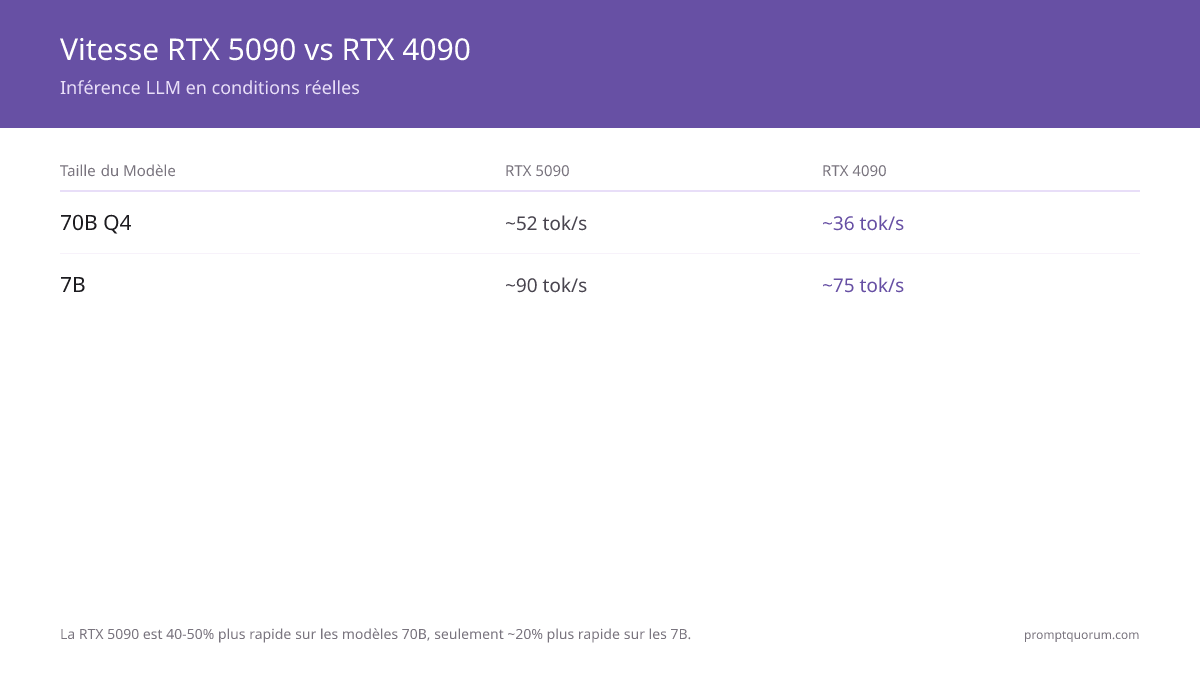
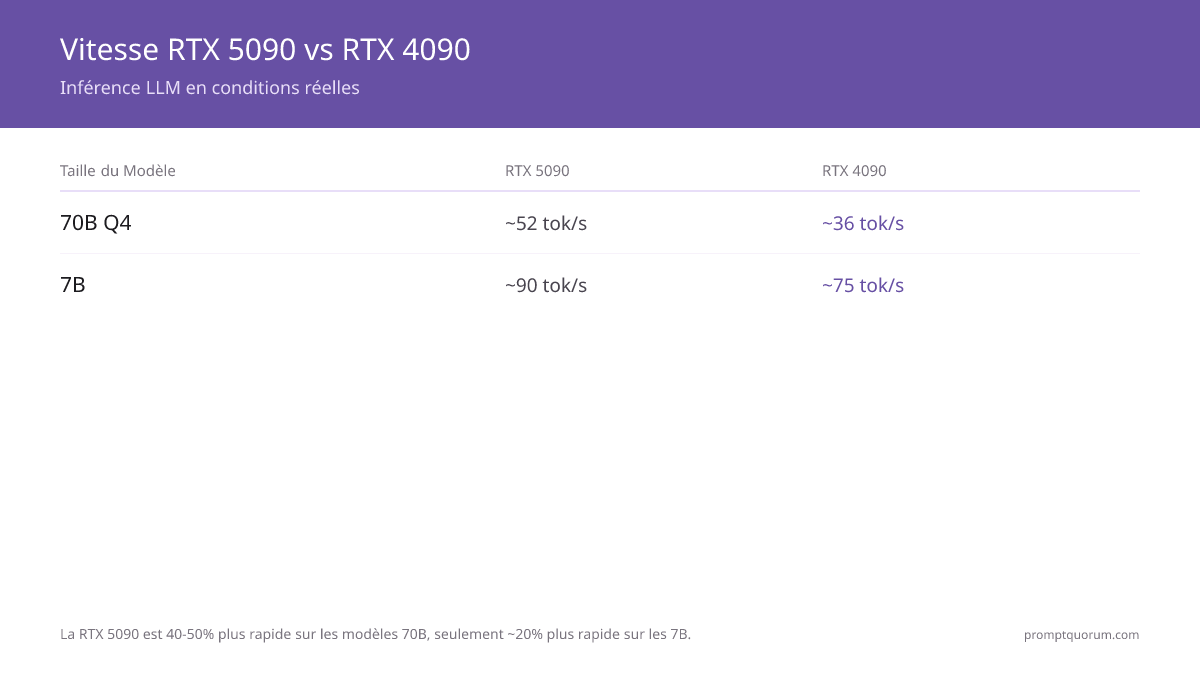
- La RTX 5090 est ~30-50% plus rapide que la RTX 4090 pour l'inférence LLM locale sur les gros modèles (70B Q4). Sur les modèles de 7B-13B, l'écart est plus faible (~20%).
- La RTX 5090 dispose de 32 Go GDDR7 contre 24 Go GDDR6X pour la RTX 4090 — les 8 Go supplémentaires comptent pour le 34B Q8 et les exécutions 70B Q4 à contexte large.
- Une RTX 4090 d'occasion (~56-72 $ par million de tokens) reste moins chère par token généré qu'une RTX 5090 neuve au prix de rue actuel (~83-96 $ par million de tokens).
- Pour les modèles de 7B-13B : la 4090 est excessive, quel que soit le prix. Vous atteindrez les limites du CPU ou du refroidissement avant de saturer le GPU.
- Pour les modèles de 70B : la 5090 brille. Elle peut exécuter 2-3 modèles de 70B en parallèle ou un seul 70B avec des tailles de lot plus grandes.
- La RTX 5080 offre souvent un meilleur rapport qualité-prix que la 5090 pour les LLM locaux, sauf besoin de configurations bi-GPU, mais elle subit aussi l'inflation des prix liée à la pénurie.
📍 En une phrase
La RTX 4090 est arrêtée et n'est plus disponible que d'occasion, tandis que la RTX 5090 reste en production mais coûte plus du double de son prix conseillé à cause d'une pénurie de mémoire GDDR7 ; la 5090 est 30 à 50 % plus rapide sur les gros modèles avec 32 Go de VRAM contre 24 Go pour la 4090, mais la 4090 d'occasion génère toujours des tokens moins cher par dollar.
💬 En termes simples
Si vous possédez déjà une RTX 4090, il y a peu de raisons de faire une mise à niveau maintenant -- la prime de prix de la 5090 ne compense pas le gain de vitesse pour la plupart des usages de LLM local. Si vous achetez à zéro et avez besoin d'une carte capable de faire tourner du 70B, une RTX 4090 d'occasion reste le meilleur rapport qualité-prix malgré sa prime liée à l'arrêt de production, car le prix de la 5090 elle-même a été poussé vers le haut par la pénurie de mémoire.
Quelles sont les différences réelles de vitesse ?
RTX 5090 : 21 760 cœurs CUDA, 1 457 TFLOPS, ~1 792 Go/s de bande passante mémoire, 32 Go GDDR7. Prix public 1 999 $, mais prix de rue de 4 300-5 000 $+ en août 2026 à cause de la pénurie de GDDR7.
RTX 4090 : 16 384 cœurs CUDA, 826 TFLOPS, ~1 008 Go/s de bande passante mémoire, 24 Go GDDR6X. Arrêtée (EOL) — NVIDIA a cessé sa production. Chaque unité en vente est d'occasion, à ~2 000-2 600 $.
Inférence LLM réelle (Llama 3.3 70B, Q4, batch=1) : la RTX 5090 atteint ~50-55 tokens/sec, la RTX 4090 atteint ~36 tokens/sec. 40-50% plus rapide sur les modèles de 70B. Ces vitesses par carte ne changent pas avec les prix — seul leur coût d'accès a changé.
Pour les modèles de 7B (limités par la mémoire, pas par le calcul) : la RTX 5090 atteint ~90 tokens/sec, la RTX 4090 ~75 tokens/sec. ~20% plus rapide. L'écart est plus faible sur les petits modèles.
La VRAM fait-elle une différence entre la 4090 et la 5090 ?
La RTX 5090 dispose de 32 Go GDDR7. La RTX 4090 dispose de 24 Go GDDR6X. Les 8 Go d'écart comptent pour certaines tailles de modèles — ce calcul de VRAM ne change ni avec l'arrêt de la 4090 ni avec le prix actuel de l'une ou l'autre carte.
L'avantage VRAM de la 5090 est réel : le 34B Q8 (~28 Go) tient confortablement dans 32 Go mais est juste dans 24 Go. Le 70B Q4 (~38-40 Go) ne tient sur AUCUNE des deux cartes seule — il faut un bi-GPU ou de l'Apple Silicon. Pour les modèles de 7B-13B, 24 Go suffisent largement.
Coût par token : laquelle est vraiment la moins chère ?
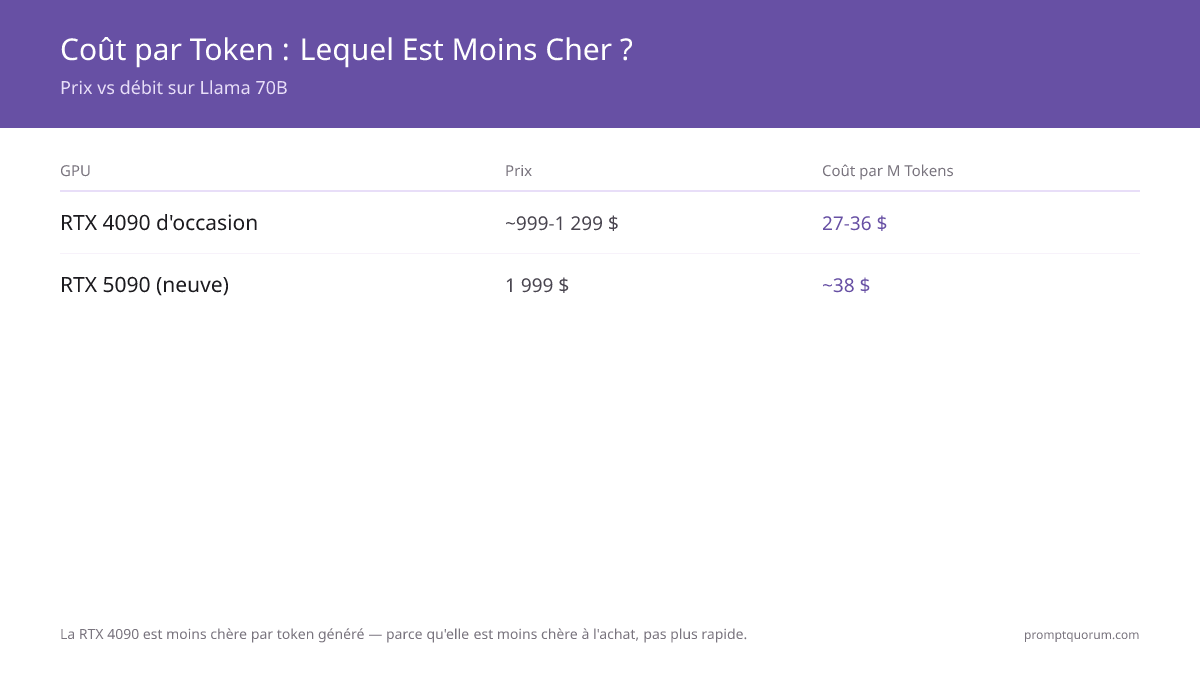
- RTX 4090 d'occasion : ~2 000-2 600 $ (EOL, uniquement sur le marché de l'occasion, contre ~999-1 299 $ en début 2026). Atteint 36 tokens/sec sur Llama 70B. Coût par token : ~56-72 $ par million de tokens.
- RTX 5090 neuve : prix de rue de 4 300-5 000 $+ (prix public 1 999 $, gonflé par la pénurie de GDDR7 de 2026). Atteint ~52 tokens/sec sur Llama 3.3 70B Q4. Coût par token : ~83-96 $ par million de tokens.
- Verdict : la 4090 reste moins chère par token généré, même après sa hausse de prix liée à l'arrêt de production — la prime de pénurie de la 5090 a augmenté plus vite que celle de la 4090.
Quand devriez-vous vraiment passer de la 4090 à la 5090 ?
Ne mettez jamais à niveau pour de l'inférence 7B-13B. La 4090 est excessive pour ces modèles, quel que soit le prix. Vous serez de toute façon limité par le CPU ou le refroidissement.
Si vous possédez déjà une 4090 : conservez-la. Avec la 5090 à 4 300-5 000 $+ de prix de rue, le calcul de mise à niveau n'a jamais été aussi défavorable. Passez à la 5090 seulement si vous avez besoin de plus de 40 tok/sec en 70B ou des 32 Go pour du 34B Q8, et que le coût n'est pas un frein.
Si vous n'avez ni l'une ni l'autre et avez besoin d'une carte capable de 70B : comparez les annonces actuelles. Une 4090 d'occasion (~2 000-2 600 $, EOL/occasion uniquement) bat toujours une 5090 neuve (~4 300-5 000 $+) en coût par token, au prix de 30-50% de débit en moins.
L'alternative bi-GPU a changé : deux RTX 4090 d'occasion coûtent désormais ensemble ~4 000-5 200 $ — proche du prix de rue d'une seule 5090 — pour ~65-72 tokens/sec combinés en 70B Q4 (similaire ou meilleur qu'une seule 5090). Le compromis : approvisionnement uniquement d'occasion (sans garantie, offre EOL) et plus de complexité de configuration (parallélisme tensoriel).
Suppositions courantes sur la 5090
- Croire que la RTX 4090 se vend encore neuve — ce n'est pas le cas. NVIDIA a arrêté la série RTX 40 en 2026 ; chaque 4090 sur le marché est d'occasion, à des prix bien supérieurs à ceux de début d'année.
- Penser que le prix public de 1 999 $ de la RTX 5090 est ce que vous paierez réellement — en août 2026, le prix de rue est de 4 300-5 000 $+ à cause de la pénurie de GDDR7.
- Penser que la 5090 est 2× plus rapide que la 4090 — elle n'est que 40-50% plus rapide sur le 70B, et seulement ~20% plus rapide sur le 7B.
- Supposer que les deux cartes ont la même VRAM — ce n'est pas le cas. La 5090 a 32 Go, la 4090 a 24 Go. L'écart de 8 Go compte pour les modèles de 34B Q8.
- Croire qu'il faut une 5090 pour exécuter des modèles de 70B — la 4090 les exécute bien à 36 tokens/sec, ce qui est "suffisant" pour la plupart des usages, et elle reste la carte la moins chère par token même après sa hausse de prix liée à l'arrêt de production.
Questions fréquentes
La RTX 4090 se vend-elle encore neuve en 2026 ?
Non. NVIDIA a arrêté la série RTX 40 en 2026. Chaque RTX 4090 en vente aujourd'hui est d'occasion, et les prix ont grimpé à ~2 000-2 600 $ à cause de la rareté liée à l'arrêt, en plus de la demande induite par la propre pénurie de GDDR7 de la série RTX 50.
La RTX 5090 vaut-elle le coup pour exécuter Llama 3.3 70B ?
Cela dépend plus que jamais du prix. La 4090 donne ~36 tok/sec pour ~2 000-2 600 $ d'occasion. La 5090 donne ~52 tok/sec mais coûte 4 300-5 000 $+ de prix de rue en août 2026. Ça vaut le coup pour un usage continu du 70B ; une 4090 d'occasion est le choix pragmatique sinon.
Dois-je acheter une RTX 5090 ou deux RTX 4090 ?
Deux 4090 d'occasion (~4 000-5 200 $ au total) battent une seule 5090 (~4 300-5 000 $+ de prix de rue) en vitesse brute sur le 70B (~72 tok/sec combinés contre ~52). Mais une configuration bi-GPU ajoute de la complexité — parallélisme tensoriel, pas de garantie pour les cartes d'occasion. La 5090 est plus simple et reste en production, et apporte 32 Go de VRAM unifiée pour le 34B Q8.
La RTX 5090 a-t-elle plus de VRAM que la 4090 ?
Oui. La RTX 5090 dispose de 32 Go GDDR7 contre 24 Go GDDR6X pour la RTX 4090. Les 8 Go supplémentaires permettent d'exécuter des modèles de 34B Q8 (~28 Go nécessaires) sans être à l'étroit. Aucune des deux cartes ne peut contenir un 70B Q4 (~38-40 Go) sans répartition sur plusieurs GPU. Cet écart de VRAM n'a aucun lien avec l'arrêt de production de la 4090.
La RTX 5090 est-elle excessive pour un modèle de 14B ?
Oui, dans la plupart des cas. Un modèle de 14B Q4 nécessite ~9 Go de VRAM et tourne à ~55-65 tok/sec sur une 4090 — déjà rapide. La 5090 donnerait ~65-75 tok/sec, une amélioration marginale. Une 4090 d'occasion (voire une 3090) est bien plus rentable pour l'inférence de 14B, surtout aux prix actuels de la 5090.
La RTX 5090 pour ordinateur portable a-t-elle 32 Go de VRAM ?
Non. La RTX 5090 Laptop GPU dispose de 24 Go GDDR7 (réduits par rapport aux 32 Go de la version bureau à cause des contraintes de puissance et thermiques). Elle est nettement plus lente que la 5090 de bureau, mais reste plus rapide qu'une 4090 sur la même tâche.
Le prix de la 5090 va-t-il redescendre à son prix public de 1 999 $ ?
Seulement quand la pénurie de mémoire GDDR7 de 2026 s'atténuera — il n'y a pas de calendrier fixe. Le prix de rue actuel est de 4 300-5 000 $+, plus du double du prix public. L'historique de la 4090 rappelle que le marché de l'occasion ne baisse pas toujours : elle est passée de 1 499 $ (lancement 2022) à un plancher de ~999 $ d'occasion, puis a rebondi à ~2 000-2 600 $ après son arrêt en 2026.
Puis-je utiliser la RTX 5090 avec une alimentation de 750 W ?
Difficilement. La RTX 5090 consomme 575 W à elle seule. Associez-la à une alimentation de 850 W ou 1000 W pour éviter les chutes de tension en charge.
La RTX 5080 offre-t-elle un meilleur rapport qualité-prix que la 5090 ?
Souvent oui — la 5080 atteint environ 80% de la vitesse de la 5090 à un prix nettement inférieur, bien qu'elle soit elle aussi sujette à l'inflation des prix liée à la pénurie de GDDR7 de 2026. Pour les LLM locaux, la 5080 est généralement le point d'équilibre optimal.
De combien la 5090 est-elle plus rapide sur des modèles multimodaux comme Qwen-VL 70B ?
Un gain similaire de 20-25%. Le calcul multimodal reste limité par la mémoire, donc l'avantage de bande passante de la 5090 aide, mais pas de façon spectaculaire.
Sources
- Spécifications officielles NVIDIA RTX 5090 et 4090 : cœurs CUDA, TFLOPS, bande passante mémoire
- MLCommons MLPerf Inference Benchmark : vitesse de génération de tokens sur LLaMA 70B et modèles Mistral
- Base de données GPU TechPowerUp : comparaison de la consommation électrique et de la bande passante mémoire RTX 5090 vs 4090