Quelle Est la Dernière Version d'Ollama et Qu'est-ce Qui a Changé ?
Version Ollama actuelle : v0.40.5 (publiée le 14 octobre 2026). C'est la dernière version stable, disponible sur ollama.com/download. Une préversion v0.40.6 est apparue le 16 octobre mais n'est pas encore marquée comme stable. Mettez à jour avec `curl https://ollama.ai/install.sh | sh` (macOS : `brew upgrade ollama`), puis vérifiez avec `ollama --version`.
Ce qui a changé dans la série v0.33–v0.40 (août–octobre 2026) : la v0.33.0 (21 août) a activé Claude Desktop comme passerelle tierce et fiabilisé les points de restauration du préremplissage du cache KV. La v0.34.0 (5 septembre) a permis d'utiliser les modèles Ollama dans ChatGPT Desktop et accéléré la sortie structurée sur Apple Silicon ; la v0.34.1 (14 septembre) a retiré le statut expérimental de `ollama create` avec safetensors MLX. La v0.40.0 (25 septembre) exécute par défaut sur MLX, sous Apple Silicon, les architectures compatibles comme qwen3.8, gemma4 et qwen3.6. La v0.35.0 (28 septembre) a ajouté les modèles de décision via `/v1/systemone` — des modèles qui renvoient des choix, des probabilités et des scores plutôt que du texte, à commencer par Nimble et Tev1 — et la v0.35.1 (29 septembre) les modèles multimodaux Clef. La v0.40.2 (8 octobre) conserve des sauvegardes lors de la mise à niveau en arrière-plan des anciens modèles, la v0.40.4 (12 octobre) a ajouté `ollama run <modèle-de-décision> --ask`, et la v0.40.5 (14 octobre) a apporté la prise en charge de NVIDIA Nemotron 3.5 Super et l'accès cloud aux modèles de décision Clef. Notes complètes : github.com/ollama/ollama/releases.
Nouveaux modèles ajoutés depuis la dernière mise à jour (fin juin–juillet 2026) :
- Laguna XS 2.1 (Poolside, 2 juillet 2026) — 33B au total / 3B actif MoE conçu pour le codage agentique et le travail local de longue durée : planifier, écrire du code, exécuter des tests, itérer. Contexte 256K, licence OpenMDW-1.1. SWE-bench Verified 70,9%, SWE-bench Multilingual 63,1%. Téléchargement : `ollama pull laguna-xs-2.1`
- Kimi K2.7 Code (Moonshot AI, juin 2026) — Modèle agentique axé sur le codage, construit sur Kimi K2.6, visant spécifiquement les sessions de codage de longue durée. Téléchargement : `ollama pull kimi-k2.7-code:cloud`
- DeepSeek V4 Pro (DeepSeek, 23 avril 2026) — Spécialiste du codage algorithmique, 93.5% LiveCodeBench, licence MIT. Variante économique DeepSeek V4 Flash pour le materiel plus léger. Téléchargement : `ollama pull deepseek-v4-pro`
- Kimi K2.6 (Moonshot AI, 20 avril 2026) — Modèle de codage de frontière, SWE-Bench Pro 58.6, SWE-bench Verified 80.2% (à égalité avec GPT-5.5). Architecture MoE (32B actif / 1T au total). Licence Modified MIT.
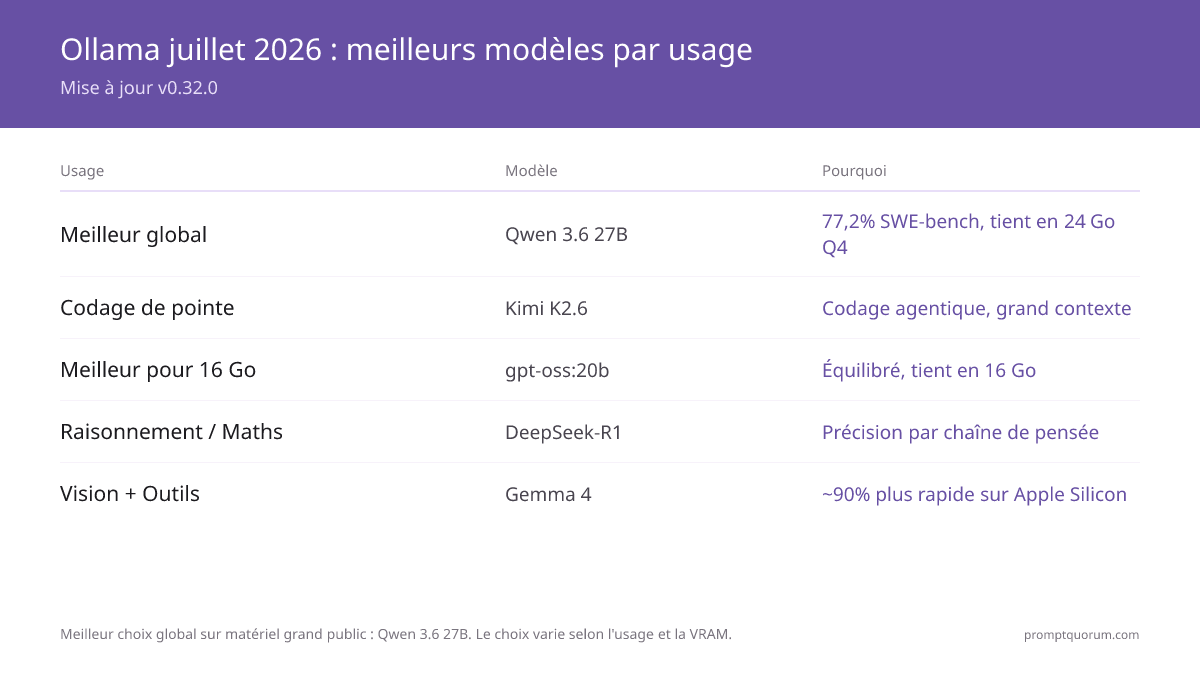
- Qwen3.8-27B (Alibaba, 16 avril 2026) — Meilleur global sur materiel grand public, 61,7 SWE-bench Pro, Apache 2.0, tient en 24 Go en Q4. Aussi Qwen3.6-35B-A3B (MoE, 73,4 SWE-bench).
- GLM-5.3 (Z.ai) — 744B / 40B actif MoE, licence MIT. Leader en génération de code structuré.
- gpt-oss (OpenAI, 2026) — MoE à poids ouverts : gpt-oss:20b (21B au total / 3,6B actif, tourne en 16 Go, ~niveau o3-mini, raisonnement reglable) et gpt-oss:120b (80 Go).
- Gemma 4 (Google, 2 avril 2026) — Tailles multimodales E2B / E4B / E12B (26B MoE) / E27B (31B dense), toutes avec vision et appel d'outils. Désormais ~90 % plus rapide sur Apple Silicon (mise à jour MLX de juillet 2026). E4B tourne en ~6 Go VRAM.
# Mettre à jour Ollama vers la dernière version (v0.40.5)
curl https://ollama.ai/install.sh | sh

# Ou sur Mac : brew upgrade ollama

# Vérifier la version actuelle
ollama --version  # Sortie : ollama version 0.40.5

# Télécharger les nouveaux modèles de juillet 2026
ollama pull laguna-xs-2.1
ollama pull kimi-k2.7-code:cloud
ollama pull nemotron-3.5-lightning
ollama pull kimi-k2.6:cloud
Quel est l'historique des versions d'Ollama ?
Ollama a publié sa première version, la v0.0.1, le 8 juillet 2023 et a atteint la v0.40.5 le 14 octobre 2026. Le tableau liste les versions qui ont changé ce que l'on peut faire avec Ollama ; tous les tags, avec leurs notes complètes, sont sur github.com/ollama/ollama/releases. La numérotation est passée de v0.35 à v0.40 fin septembre 2026 : la v0.40.0 (25 septembre) figure donc à côté des versions v0.35 (28-29 septembre) sur GitHub.
Version | Date | Changement clé |
|---|---|---|
| v0.40.5 | 14 oct. 2026 | Nemotron 3.5 Super ; modèles de décision cloud |
| v0.40.0 | 25 sept. 2026 | MLX par défaut sur Apple Silicon |
| v0.35.0 | 28 sept. 2026 | Modèles de décision via /v1/systemone |
| v0.34.0 | 5 sept. 2026 | Modèles Ollama dans ChatGPT Desktop |
| v0.33.0 | 21 août 2026 | Passerelle Claude Desktop ; cache KV |
| v0.32.0 | 11 juil. 2026 | Agent « Chat, Code & Work » |
| v0.0.1 | 8 juil. 2023 | Première version publique |
Les modèles les plus populaires sur Ollama
Ollama dispose de statistiques de téléchargement entièrement publiques. Selon les données de juillet 2026 :
Llama 3.2 3B reste le modèle le plus téléchargé au total, largement dû à son utilisation comme modèle de test standard lors de la première installation. Pour la qualité sur materiel grand public, Qwen3.8-27B (61,7 SWE-bench Pro, tient en 24 Go en Q4) est désormais le meilleur choix global.
Qwen3 et Qwen3.8 sont la famille de modèles la plus en forte croissance dans la bibliothèque Ollama, avec Qwen3 et la nouvelle variante dense Qwen3.8 déplaçant rapidement Qwen3. DeepSeek-R1 a connu des pics majeurs après sa sortie et reste très téléchargé pour les tâches de raisonnement. Dolphin 3.0 (Cognitive Computations, construit sur Llama 3.1) reste le modèle non censuré polyvalent le plus téléchargé pour les utilisateurs souhaitant un assistant local sans filtrage.
Llama 4 Scout a été lancé par Meta en avril 2026 avec les variantes Scout (17B actif, 109B au total, MoE) et Maverick (17B actif, 400B au total). Llama 4 Scout est maintenant stable dans la bibliothèque Ollama (`ollama pull llama4:scout`). La famille Llama 4 utilise une architecture Mixture-of-Experts (MoE) – seuls 17B paramètres sont actifs par token, mais avec 109B paramètres au total Scout nécessite ~55 Go VRAM en Q4 (tient en 24 Go uniquement en 1,78 bit, ~20 tok/s). Les atouts de Scout sont sa fenêtre de contexte de 10M tokens et son entrée multimodale, pas son adéquation au materiel grand public. L'écosystème Ollama s'est considérablement étendu depuis avril 2026. Kimi K2.6 (Moonshot AI, licence Modified MIT, 32B actif / 1T au total MoE) a obtenu SWE-Bench Pro 58.6, à égalité avec GPT-5.5. Laguna XS 2.1 (Poolside) est le nouveau challenger en codage agentique, conçu spécifiquement pour les sessions de codage local de longue durée. Qwen3.8-27B a atteint 61,7 SWE-bench Pro en tant que meilleur modèle global sur materiel grand public (tient en 24 Go en Q4). Le gpt-oss:20b d'OpenAI (21B au total / 3,6B actif MoE) tourne en 16 Go au ~niveau o3-mini avec raisonnement reglable. La version actuelle d'Ollama, la v0.40.5 (14 octobre 2026), ajoute la prise en charge de NVIDIA Nemotron 3.5 Super.La bibliothèque Ollama référence maintenant plusieurs centaines de modèles, Laguna XS 2.1 et Kimi K2.7 Code étant les ajouts les plus récents depuis la mise à jour de juin.
Note de version : Qwen3.6 et Qwen3.8 sont des générations de Qwen plus récentes sur Ollama (qwen3.6:35b, ~24 Go ; qwen3.8:27b, 18 Go) ; qwen3:30b et qwen3-coder:30b (19 Go chacun) sont des options de la génération précédente qui fonctionnent toujours. Le modèle Small actuel de Mistral est Mistral Small 4, mais la bibliothèque Ollama ne le listait pas lors de la vérification ; mistral-small3.1 et mistral-small:24b (Mistral Small 3) restent les modèles Small disponibles au téléchargement.
Meilleurs modèles par catégorie
La qualité de la sortie d'un modèle dépend fortement de la façon dont vous le promptez. Pour des techniques structurées applicables à tous les modèles locaux — chain-of-thought, exemples few-shot et formatage de sortie — consultez le guide de prompt engineering. Pour les tâches de raisonnement, le prompt engineering de chaîne de pensée améliore considérablement la qualité des sorties DeepSeek-R1 et Qwen3. Pour déterminer la RAM requise pour chaque modèle, consultez le guide des exigences VRAM →. Pour les workflows d'agents avec Gemma 4, voir Tree-of-Thought et ReAct. Une fois qu'un modèle à appel d'outils de cette liste est intégré dans une boucle multi-étapes avec accès aux fichiers et aux bases de données, voir Agents IA locaux avec MCP pour le pattern d'orchestration open source.
- Chat général (débutant) : `ollama run llama3.2:3b` -- la plupart de la documentation, le modèle de démarrage le mieux soutenu.
- Chat général (meilleur choix) : `ollama run qwen3.8:27b` -- 61,7 SWE-bench Pro, meilleur global sur materiel grand public, tient en 24 Go en Q4. Polyvalent : `ollama run qwen3:30b`. Pour les machines à 8 Go, gardez `ollama run llama3.2:3b`.
- Long contexte / multimodal : `ollama run llama4:scout` -- contexte 10M tokens + multimodal, MoE (17B actif/109B au total). Nécessite ~55 Go VRAM en Q4 (tient en 24 Go uniquement en 1,78 bit, ~20 tok/s).
- Meilleur petit / 16 Go : `ollama run gpt-oss:20b` -- 21B au total / 3,6B actif MoE, ~niveau o3-mini, raisonnement reglable. Plus grand : `ollama run gpt-oss:120b` (80 Go).
- Codage (7B) : `ollama run qwen3:8b` -- multilingue, option solide pour coder sur machines de 8 Go.
- Codage (meilleur agentique, 24B) : `ollama run devstral-small-2` -- Meilleur modèle de codage agentique (éditions multi-fichiers, débogage). 16 Go RAM. Par Mistral AI.
- Codage (meilleur dense, 27B) : `ollama run qwen3.8:27b` -- 61,7 SWE-bench Pro. Meilleur modèle de codage dense. 18 Go VRAM.
- Codage (frontière MoE) : `ollama run kimi-k2.6:cloud` -- SWE-Bench Pro 58.6 (à égalité avec GPT-5.5), tier supérieur. MoE (32B actif/1T au total). Licence Modified MIT.
- Codage (agentique, longue durée) : `ollama run laguna-xs-2.1` -- MoE 33B/3B actif de Poolside, SWE-bench Verified 70,9%, contexte 256K. Conçu pour les boucles multi-étapes planifier → coder → tester → itérer. Licence OpenMDW-1.1.
- Tâches d'agent et appel d'outils : `ollama run gemma4:e4b` -- Lancé le 2 avril 2026. Support d'appel d'outils intégré + vision. Recommandé pour les agents locaux, l'appel de fonctions et la sortie structurée. 6 Go RAM.
- Raisonnement et mathématiques : `ollama run deepseek-r1:7b` -- modèle de chaîne de pensée, meilleure performance mathématique locale à 7B.
- Multilingue : `ollama run qwen3:8b` -- 29+ langues natives, option multilingue polyvalente.
- Non censuré / polyvalent : `ollama run dolphin3` -- Dolphin 3.0 (Cognitive Computations, construit sur Llama 3.1), sans filtrage de contenu intégré, pour le chat, le codage et les tâches agentiques.
- Compréhension d'images : `ollama run gemma4:e4b` -- vision + appel d'outils (juillet 2026). Ou `ollama run llama3.2-vision:11b` pour une vision dédiée.
- Rapide et léger : `ollama run gemma2:2b` -- inférence CPU la plus rapide, 1,7 Go RAM.
- Haute qualité (16 Go RAM) : `ollama run mistral-small3.1` -- bonne qualité à 14 Go RAM.
- Domotique / IA mot de réveil : `ollama run phi4-mini` — Phi-4 Mini (3,8B, ~3 Go VRAM) peut gérer les commandes vocales Home Assistant sur un mini PC sans GPU dédié ; la vitesse dépend de votre matériel. Voir guide d'intégration Home Assistant + Ollama →.

Quels modèles ont été ajoutés le plus récemment à Ollama ?
Voici les modèles les plus récents de la bibliothèque Ollama, du plus récent au plus ancien. Confirmez leur disponibilité avec `ollama pull <modèle>` avant de bâtir des workflows : les nouveaux modèles apparaissent sur ollama.com/library quelques jours après leur sortie.
Modèle | Publié | Idéal pour | Commande Ollama |
|---|---|---|---|
| nemotron-3.5-super | 14 octobre 2026 | NVIDIA — vision-langage 120B, code, raisonnement, outils, jusqu'à 1M de contexte | ollama run nemotron-3.5-super |
| nemotron-3.5-bolt | 14 octobre 2026 | NVIDIA — MoE 74B au total / 9B actifs, code local et outils, 25 Go | ollama run nemotron-3.5-bolt |
| nemotron-3.5-lightning | 2026 | NVIDIA — MoE 30B, 3B actifs, agents toujours actifs, contexte 1M | ollama run nemotron-3.5-lightning |
| glm-5.3 | 2026 | Z.ai — poids ouverts phares pour le code et les agents longs | ollama run glm-5.3 |
| granite4.2 | 2026 | IBM — Apache 2.0, 3B / 8B / 30B, contexte 128K | ollama run granite4.2 |
| qwen3.8:27b | août 2026 | Meilleur global sur matériel grand public, 61,7 SWE-bench Pro (selon Qwen), 18 Go | ollama run qwen3.8:27b |
| laguna-xs-2.1 | 2 juillet 2026 | Poolside — code agentique, MoE 33B/3B actifs, 20 Go, contexte 256K | ollama run laguna-xs-2.1 |
| kimi-k2.7-code | 2026 | Moonshot AI — orienté code, tag cloud uniquement sur Ollama | ollama run kimi-k2.7-code:cloud |
| kimi-k2.6 | 20 avril 2026 | Code de taille frontière (SWE-Bench Pro 58,6), tag cloud uniquement sur Ollama | ollama run kimi-k2.6:cloud |
| gpt-oss:20b | 2026 | Meilleur petit modèle / 16 Go, ~o3-mini, raisonnement réglable | ollama run gpt-oss:20b |
| gemma4:e4b | 2 avril 2026 | Vision + appel d'outils (E2B/E4B/12B/26B/31B) | ollama run gemma4:e4b |
| qwen3:30b | 2026 | Polyvalent ; qwen3-coder:30b pour la complétion de code | ollama run qwen3:30b |
DeepSeek-R1 : Percée en raisonnement
DeepSeek-R1 a été lancé en janvier 2025 et représente une avancée significative en raisonnement sur tailles locales. Le modèle effectue un raisonnement explicite en chaîne de pensée (CoT) : vous voyez les chaînes de pensée internes du modèle avant la réponse finale. Note de version : DeepSeek-R1 est un modèle de la génération précédente. La famille open-weight actuelle de DeepSeek est DeepSeek-V4, que la bibliothèque Ollama ne listait pas lors de la vérification ; les versions distillées deepseek-r1 (1,5B à 70B) restent l'option de raisonnement téléchargeable. DeepSeek a remplacé le modèle R1 hébergé par DeepSeek-V4 dans son API.
- Tailles disponibles : versions distillées de 1.5B à 70B.
- Performance : logique améliorée et résolution multiétapes.
- Exigences RAM : 1.5B : 2 GB, 7B : 6 GB, 70B : 44 GB (quantification Q4).
- Licence : les modèles DeepSeek-R1 sont sous licence MIT ; les versions distillées héritent en plus des conditions de leurs modèles de base Qwen ou Llama. Vérifiez la fiche du modèle avant tout déploiement.
- Gestion des données : exécuté en local sur vos propres serveurs ou appareils, le modèle ne fait pas sortir vos prompts ni ses réponses de votre système. La conformité au RGPD dépend de votre configuration globale (pas un conseil juridique).
ollama run deepseek-r1:7b
# Exemple de prompt : "Si deux trains se rapprochent d'une gare à 100 km/h, quand se rencontrent-ils ?"
# DeepSeek-R1:7b répond avec les chaînes de pensée visibles :
# <pensée>
# ...explorer les chemins, vérifier les hypothèses...
# </pensée>
# Réponse : Ils se rencontrent ...
Modèles de vision sur Ollama
Quatre modèles de vision remarquables sont maintenant nativement disponibles sur Ollama :
Modèle | RAM | Support image | Commande Ollama |
|---|---|---|---|
| Llama 3.2 Vision 11B | 11 GB | JPEG, PNG, GIF; entrée multi-images | ollama run llama3.2-vision:11b |
| Qwen2.5-VL 7B | 8 GB | JPEG, PNG; meilleur en OCR et diagrammes | ollama run qwen2.5vl:7b |
| Gemma 3 Vision 9B | 9.5 GB | JPEG, PNG; contexte natif 128K | ollama run gemma3:9b |
| Mistral AI Pixtral 12B | 12.5 GB | JPEG, PNG; basé sur latent | ollama run pixtral:12b |

Comparaison complète du Top 10
Les nombres de téléchargements favorisent encore Llama 3.x en raison de la place des tutoriels. Pour de nouveaux projets en 2026, privilégiez Qwen3.8-27B (meilleur global sur matériel grand public), Laguna XS 2.1 ou Devstral Small 2 (codage), gpt-oss:20b et qwen3:30b.
# | Modèle | Meilleur pour | RAM | Benchmark |
|---|---|---|---|---|
| 1 | Qwen3.8-27B | Meilleur global sur matériel grand public | 24 Go (Q4) | 61,7 SWE-bench Pro (selon Qwen) |
| 2 | Kimi K2.6 | Codage de frontière, MoE (32B/1T), Modified MIT | Quantifié | 58,6 SWE-Bench Pro |
| 3 | gpt-oss:20b | Meilleur petit modèle / 16 Go, raisonnement réglable | 16 Go | ~o3-mini |
| 4 | qwen3:30b | Polyvalent ; qwen3-coder:30b pour le code | ~18 Go | — |
| 5 | Laguna XS 2.1 | Codage agentique, longue durée (planifier/coder/tester/itérer) | Quantifié | 70,9 % SWE-bench Verified |
| 6 | Devstral Small 2 24B | Codage agentique (multi-fichiers) | 15 Go | 68,0 % SWE-bench Verified (selon Mistral) |
| 7 | deepseek-r1:7b | Raisonnement, maths | 5 Go | — |
| 8 | gemma4:e4b | Vision + appel d'outils (multimodal) | ~6 Go | Prêt pour les agents |
| 9 | Llama 4 Scout | Contexte long 10M + multimodal, MoE | ~55 Go (Q4) | Contexte 10M |
| 10 | Llama 3.2 3B | Premier modèle, chat général | 2,5 Go | — |

Comment parcourir la bibliothèque Ollama ?
Il existe deux façons de travailler avec les modèles Ollama. Changer de modèle installé : Dans l'application Ollama pour Mac, cliquez sur le bouton déroulant de modèle en bas du champ de saisie du chat (affiche le nom du modèle actuel, ex. "gemma3:1b") pour basculer entre les modèles installés localement. Trouver et télécharger de nouveaux modèles : Visitez ollama.com/library pour parcourir plusieurs centaines de modèles par catégorie, puis utilisez les commandes CLI ci-dessous pour les télécharger.
- Ouvrez ollama.com/library dans un navigateur pour la bibliothèque complète interrogeable de plusieurs centaines de modèles.
- Les nouveaux modèles apparaissent en général dans la bibliothèque quelques jours après leur sortie.
ollama list
# Affiche tous les modèles installés

ollama pull llama3.1:8b
# Télécharge et installe Llama 3.1 8B

ollama pull qwen2.5:7b
# Télécharge Qwen3 8B (pour codage et mathématiques)

ollama run qwen2.5:7b
# Démarre une session de chat interactive

ollama run -m deepseek-r1:7b "Résoudre 2^10"
# Résout les tâches de raisonnement avec CoT
Comment les règles régionales de confidentialité influencent-elles votre choix de modèle Ollama ?
UE / RGPD + conformité des licences. Pour les organisations de l'UE qui déploient des modèles Ollama en production, la licence compte autant que la performance. Apache 2.0 (entièrement ouverte, usage commercial autorisé) : Mistral Small 3, Mistral Small 3.1, Qwen3 8B, Qwen3.8-27B, Devstral Small 2, Granite 4.2. Licence communautaire Meta Llama (usage commercial restreint au-delà de 700 M d'utilisateurs actifs mensuels) : Llama 3.1 8B, Llama 3.2 3B, Llama 3.2 Vision 11B. Llama 3.2 Vision fait exception : sa politique d'utilisation acceptable n'accorde pas les droits de la licence aux personnes ou entreprises domiciliées dans l'UE (les utilisateurs finaux de produits construits dessus ne sont pas concernés) ; vérifiez-le avant tout usage dans l'UE. MIT (usage commercial autorisé) : DeepSeek-R1 7B et 14B. MIT modifiée (usage commercial autorisé avec clause d'attribution) : Kimi K2.6. OpenMDW-1.1 (permissive, usage commercial autorisé) : Laguna XS 2.1. Vérifiez toujours les termes de licence avant un déploiement commercial. Pour les entreprises de l'UE dans des secteurs réglementés, les modèles Mistral (France, Apache 2.0) comme Devstral Small 2 sont un choix par défaut raisonnable : origine européenne et licence permissive. Exécuter les modèles entièrement sur site avec Ollama signifie que les prompts ne sont pas envoyés à des serveurs externes ; cela soutient, sans suffire à lui seul, le respect du RGPD (un tag `:cloud` envoie bien des données au service hébergé d'Ollama).
Japon (METI). Pour les déploiements d'entreprise japonais avec Ollama, Qwen3 / Qwen3.8 est une famille recommandée : elle traite nativement le texte japonais, ce qui aide le temps d'inférence et le cache KV. Pour le codage en japonais : Qwen3.8-27B (61,7 SWE-bench Pro selon Qwen) gère nativement les commentaires de code en japonais. Consigner la version exacte du modèle est une bonne pratique pour la documentation de conformité. Utilisez `ollama show <modèle>` pour obtenir la spécification complète (paramètres, quantification, longueur de contexte) pour vos dossiers de conformité.
Chine. Les Mesures de la CAC sur l'IA générative (2023) peuvent imposer des obligations de dépôt ou d'évaluation de sécurité aux fournisseurs de services d'IA générative destinés au public en Chine ; leur application à votre cas relève de votre conseiller juridique. Qwen3 / Qwen3.8 (Alibaba, Apache 2.0) est un choix naturel pour les déploiements d'entreprise chinois avec Ollama : origine chinoise, licence Apache 2.0, bonnes performances en chinois. Kimi K2.6 (Moonshot AI, MIT modifiée) est aussi d'origine chinoise, mais Ollama ne le liste qu'en tag cloud et l'exécution locale exige du matériel de classe serveur. Commandes : `ollama run qwen3.8:27b` pour la meilleure qualité, `ollama run qwen3:8b` pour la vitesse. DeepSeek-R1 (licence MIT) convient au raisonnement. Une inférence exécutée localement avec Ollama n'envoie pas à elle seule de données à l'étranger, ce qui écarte la question du transfert transfrontalier pour cette étape ; savoir si la PIPL ou d'autres obligations s'appliquent à votre traitement relève de vous et de votre conseiller juridique. Cette section est une information générale, non un conseil juridique.
Erreurs courantes lors du choix de modèles Ollama
J'ai téléchargé un grand tag de modèle mais ma RAM est pleine. Qu'est-ce qui s'est passé ?
Vous avez téléchargé trop vite sans vérifier la RAM. Utilisez `ollama show [model-name]` AVANT le téléchargement. Exemple : `ollama show llama3.1:70b` affiche les exigences (~42-48 GB avec quantification Q4). Pour les débutants : restez avec les modèles 7B-13B (moins de 16 GB RAM). Supprimez avec `ollama rm [model-name]`.
J'utilise un modèle polyvalent comme Llama 3.3, mais le codage est lent. Pourquoi ?
Llama 3.1 8B est convivial, mais Qwen3 ou Mistral Small sont spécialisés pour les tâches techniques. Pour le codage : essayez Qwen3 8B à la place de Llama 3.1 8B et comparez les résultats sur vos propres tâches. Les deux fonctionnent en moins de 8 GB RAM.
J'ai téléchargé un modèle mais ne le vois pas dans la liste. Comment vérifier l'installation ?
Exécutez `ollama list`. Ollama stocke les modèles sous `~/.ollama/models/` (Mac) ou `%USERPROFILE%.ollamamodels` (Windows). Si le modèle y est mais n'apparaît pas, redémarrez le daemon Ollama : fermez Ollama et rouvrez-le.
Étapes suivantes
- Meilleurs LLM locaux pour le code — Le meilleur modèle Ollama pour le développement →
- Meilleurs LLM sur CPU uniquement — Pas de GPU ? Par ici →
- Guide matériel LLM local — Votre machine peut-elle faire tourner ces modèles ? →
Questions fréquemment posées
Quelle est la dernière version d'Ollama ?
La dernière version stable d'Ollama est la v0.40.5, publiée le 14 octobre 2026. Une préversion v0.40.6 a suivi le 16 octobre mais n'est pas encore marquée comme stable. Téléchargez-la sur ollama.com/download ou mettez à jour avec `curl https://ollama.ai/install.sh | sh` sous Linux et `brew upgrade ollama` sous macOS.
Où trouver le changelog et les notes de version d'Ollama ?
Les notes de version de chaque tag figurent sur github.com/ollama/ollama/releases, avec la date et le changelog. Les entrées stables les plus récentes sont la v0.40.5 (14 octobre 2026 -- prise en charge de NVIDIA Nemotron 3.5 Super, accès cloud aux modèles de décision), la v0.40.4 (12 octobre -- modèles de décision avec `ollama run --ask`, chargement plus rapide) et la v0.40.0 (25 septembre -- MLX par défaut sur Apple Silicon).
Comment vérifier quelle version d'Ollama est installée ?
Exécutez `ollama --version` dans le terminal. La sortie ressemble à `ollama version 0.40.5`. Si le numéro est inférieur à la version actuelle, mettez à jour avec `curl https://ollama.ai/install.sh | sh` (Linux) ou `brew upgrade ollama` (macOS), puis relancez `ollama --version` pour confirmer.
Quand Ollama a-t-il été publié pour la première fois ?
La première version d'Ollama, la v0.0.1, a été publiée sur GitHub le 8 juillet 2023, peu après la création du dépôt le 26 juin 2023. En octobre 2026, le projet en était à la v0.40.5. La liste complète se trouve sur github.com/ollama/ollama/releases.
Combien de RAM me faut-il pour un modèle local ?
Modèles 7B : 6.5-8 GB RAM. 13B : 11-14 GB. 70B : 42-48 GB avec quantification (Q4_K_M). Petits (3B) : 2-3 GB. Vérifiez avec `ollama show [model-name]` avant le téléchargement.
Puis-je exécuter les modèles Ollama hors ligne ?
Oui. Après le téléchargement initial, chaque inférence s'exécute localement, sans connexion Internet. Ollama vérifie occasionnellement les mises à jour (mais ne les applique pas automatiquement).
Quel modèle a le meilleur support du français ?
Les modèles multilingues comme Qwen3 / Qwen3.8 et Mistral Small 3.1 prennent en charge le français ; cette page ne les classe pas selon la qualité du français, testez-les donc sur vos propres textes.
Les modèles Ollama sont-ils vraiment gratuits ?
Le téléchargement et l'exécution en local n'entraînent ni abonnement ni frais d'API, mais tous les modèles ne sont pas open source au sens de l'OSI : Llama 3.x/4.x utilisent la licence communautaire Meta Llama (non approuvée par l'OSI, usage commercial restreint au-delà de 700 M d'utilisateurs actifs mensuels), Mistral Small 3.1, Qwen3 et Gemma 4 sont sous Apache 2.0, Gemma 2 et Gemma 3 sous les conditions d'utilisation Gemma de Google. Vérifiez la licence avant un déploiement commercial.
Quelle est vraiment la vitesse de DeepSeek-R1 ?
La vitesse dépend du matériel, de la quantification et du prompt ; cette page ne publie pas de mesures. Comme DeepSeek-R1 génère une chaîne de pensée avant de répondre, il produit plus de tokens par réponse qu'un modèle de chat standard et met donc plus de temps ; pour l'interaction en temps réel, un modèle de chat standard convient mieux.
Pourquoi utiliser Ollama plutôt que simplement ChatGPT Plus ?
Confidentialité : en exécution locale, vos prompts ne quittent pas l'appareil (hors tags `:cloud`). Coût : pas d'abonnement ni de frais d'API pour les modèles eux-mêmes, mais des coûts de matériel et d'électricité. Hors ligne : après le téléchargement, l'inférence fonctionne sans connexion Internet. Personnalisable : invites système et paramètres du modèle sous votre contrôle.
Les modèles Ollama peuvent-ils traiter les images ?
Oui. Llama 3.2 Vision, Qwen2.5-VL et Gemma 3 sont tous multimodaux. Chargez les images comme fichiers locaux ; en exécution locale, aucune transmission cloud. Support : JPEG, PNG, GIF.
Comment mettre à jour vers les nouvelles versions des modèles Ollama ?
Exécutez `ollama pull [model-name]` à nouveau. Ollama télécharge uniquement les différences (déduplication). Les anciennes versions peuvent être supprimées avec `ollama rm [model-name]:tag`.
Dois-je me soucier du RGPD avec Ollama ?
Oui, dès que vous traitez des données personnelles. Le RGPD (art. 32) exige des mesures de sécurité appropriées. Une inférence locale sur des appareils ou serveurs privés peut aider à répondre aux exigences de protection des données dès la conception : sans transmission vers le cloud, les données ne quittent pas votre système, ce qui facilite la souveraineté des données ; la conformité effective dépend toutefois de votre configuration globale (pas un conseil juridique). Remarque : si vous utilisez un modèle cloud, vérifiez d'abord les contrats de traitement des données.
Ollama convient-il aux petites et moyennes entreprises (PME) françaises ?
Oui, dans de nombreux cas. Les PME françaises peuvent y gagner : souveraineté des données (sans verrouillage éditeur cloud), appui à la mise en œuvre de standards de sécurité IT (la conformité effective dépend de votre configuration globale ; pas un conseil juridique), scalabilité sur matériel standard et économies sur les frais d'API. Qwen3 8B s'exécute sur une GPU de bureau typique ; Llama 3.1 8B est souvent utilisé pour les outils internes, l'automatisation du service client et le traitement de documents.
Quel est le nom officiel de l'entreprise derrière Ollama ?
L'entreprise derrière Ollama est Ollama Inc. « Ollama » désigne à la fois l'entreprise et l'outil CLI open source ainsi que le runtime de modèles qu'elle publie ; la première version publique du projet, la v0.0.1, est apparue sur GitHub le 8 juillet 2023.
Quel modèle Dolphin dois-je utiliser avec Ollama ?
Utilisez Dolphin 3.0 (`ollama pull dolphin3`), pas l'ancien `dolphin-mistral` (dernière mise à jour en 2024, basé sur Mistral 0.2). Dolphin 3.0, maintenu par Cognitive Computations, est construit sur Llama 3.1, ne comporte aucun filtrage de contenu intégré et est conçu comme un modèle local polyvalent pour le codage, les mathématiques, les tâches agentiques et le chat sans restriction de contenu intégrée. Faute de filtrage de sécurité intégré, vous êtes responsable de l'usage de ses sorties, et les termes de la licence Llama 3.1 s'appliquent.
Quels modèles Ollama fonctionnent le mieux pour les tâches en russe ?
Qwen3 / Qwen3.8 et Mistral Small 3.1 incluent tous deux le russe dans leurs données d'entraînement multilingues natives. Cette page ne les classe pas pour le russe ; testez les deux avec vos propres prompts. Aucun des deux n'est d'origine russe.
Lectures connexes
- Modèles de vision Ollama (2026) -- un guide pratique et dédié pour exécuter des modèles capables d'images via Ollama, avec une syntaxe CLI/API réelle.
- Installer les modèles locaux avec VS Code et Cursor -- VS Code et Cursor reconnaissent maintenant automatiquement Ollama.
- Comment choisir un modèle local : Llama vs Qwen vs Mistral -- Comparaison complète pour les débutants.
- Ollama vs LM Studio : Lequel est le plus rapide ? -- Benchmarks GPU et comparaisons de débit.
- Comment installer Ollama sur Windows/Mac -- Configuration d'installation étape par étape et configuration d'environnement.
- Matériel pour les modèles locaux: Exigences GPU -- Quelle GPU, RAM et stockage il faut pour votre modèle.
- Dépannage : Erreurs Ollama et solutions -- CUDA, MPS, fallback CPU et erreurs courantes.
- Mises à jour des modèles LLM locaux 2026 -- chronologie complète de toutes les versions majeures open-weight avec dates de disponibilité sur Ollama.
Sources
- Bibliothèque de modèles Ollama -- Plusieurs centaines de modèles avec statistiques de téléchargement en direct.
- Livre blanc DeepSeek-R1 -- "DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning" (janvier 2025).
- Annonce Gemma 3 -- Blog Google Developers : Gemma 3 multimodal, contexte 128K, mars 2025.