Faits rapides
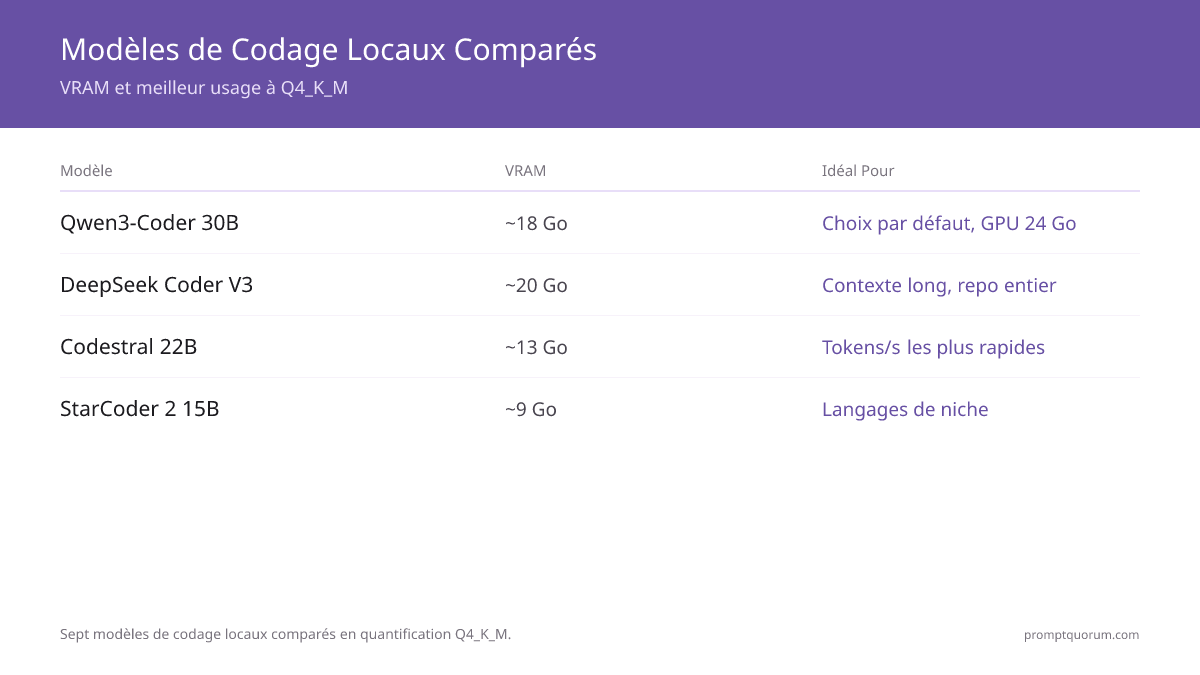
Six modèles de codage open-source, triés par choix standard puis tier hardware. Les benchmarks sont rapportés par fournisseur; voir la page fiche modèle pour méthodologie.
Modèle | Taille | Contexte | License | Direction HumanEval+ | Meilleure caractéristique | VRAM Q4_K_M |
|---|---|---|---|---|---|---|
| Qwen3-Coder 30B | 30B | 256K | Apache 2.0 | Menant | Balance performance-taille | ~18 GB |
| DeepSeek-V3 | 236B (MoE) | 128K | Mistral | Top-Tier | Fenêtre contexte plus longue | ~48 GB (tronqué) |
| Codestral 22B | 22B | 32K | Mistral Commercial | Bon | Inférence la plus rapide | ~13 GB |
| Kimi K2.7 Code | 1T total / 32B active (MoE) | 256K | Modified MIT | Solide | Compatibilité écosystème | ~340 GB (RAM+VRAM) |
| Granite Code 34B | 34B | 8K | Apache 2.0 | Bon | License enterprise (IBM) | ~20 GB |
| StarCoder 2 15B | 15B | 16K | BigCode Open RAIL | Solide | Couverture langage | ~9 GB |
Tableau de comparaison détaillé
Tous les critères pertinents en un coup d'œil. Les benchmarks proviennent des pages fiche modèle; VRAM quantisé est Q4_K_M sur runtimes typiques d'inférence.
Critère | Qwen3-Coder 30B | DeepSeek-V3 | Codestral 22B | Kimi K2.7 | Granite 34B | StarCoder 2 |
|---|---|---|---|---|---|---|
| Force principale | Balance | Contexte | Vitesse | Agentique/Contexte | Enterprise | Langues |
| Taille optimal pour | GPU 24 GB | VRAM 48+ GB | GPU 16 GB | 300+ Go RAM/VRAM | GPU 24 GB | GPU 8 GB |
| Focus formation | Code + Maths | Code seul | Code seul | Codage agentique | Code + Enterprise | Multi-langue |

Quel modèle choisir ?
Le choix dépend de trois facteurs : budget VRAM, requirements contexte, et constraint licence. Voici un arbre de décision.
- Vous avez 24 GB VRAM et voulez forte performance de codage général ? → Qwen3-Coder 30B. C'est le gagnant absolu. Meilleure performance HumanEval+, parfait dans le tier 24 GB, convivial Apache-2.0.
- Vous avez 8–16 GB et voulez fort codage ? → Qwen2.5-Coder 7B ou Codestral 22B. Codestral est plus rapide; Qwen2.5-Coder 7B est surprenamment capable pour petits fichiers.
- Vous avez 48 GB+ et avez besoin de très long contexte ? → DeepSeek-V3. 128K-tokens est grand avantage pour refactorisation whole-repo.
- Vous possédez du matériel serveur (300 Go+ RAM/VRAM) et voulez le codeur agentique le plus puissant ? → Kimi K2.7 Code. Pour un développeur seul sur une machine, Qwen3-Coder 30B reste le meilleur choix par défaut.
- Vous avez besoin licensing commercially-friendly ? → Codestral (Mistral a tiers commerciaux clairs) ou Granite Code (IBM Enterprise).
- Vous codez dans langues rares ? → StarCoder 2. Il a été entraîné sur 80+ langues de programmation; d'autres ont emphase sur Python/Typescript/C++.

Qwen3-Coder : Analyse approfondie
Qwen3-Coder 30B est le modèle recommandé standard pour codage local. Développé par Alibaba, avec clear code-focus et robust sous workflows développeur réels.
- Pourquoi choix standard 30B ? Meilleure performance HumanEval+ publiée (~92%) parmi modèles open-source en mai 2026. Contexte 256K est suffisant pour gros fichiers code. Quantisé Q4_K_M s'ajuste proprement sur GPUs 24 GB et MacBooks Apple M-Max.
- Pour qui adapté ? Développeurs avec GPUs 24 GB ou meilleurs. Codage Python, TypeScript, C++, Rust, Go. Scenarios fine-tuning où vous voulez construire sur code-performance. Entreprises avec requirements licence Apache-2.0.
- Erreurs courantes ? Utiliser correctement contexte-fenêtre — 256K est grand, mais non-illimité. Qualité code dégrade à fin (tokens 200K+). Connaître votre VRAM limitation exactement — Q4_K_M vs Q5_K_M est différence 2–3 GB.
- Qwen2.5-Coder 7B ? Surprenamment capable pour auto-complete et petits fichiers. S'ajuste sur laptops 8 GB. Besoin réelle IDE-integration, non juste analyse-code, utiliser 7B. Qualité code ~5–10% derrière 30B, mais non catastrophique.
DeepSeek-V3 : Analyse approfondie
DeepSeek-V3 est le modèle "si vous avez besoin contexte". 128K-token window est double Qwen3-Coder et rend whole-repo refactors plus praticable.
- Points forts ? Contexte plus long, forte raw-performance sur HumanEval+, formation multimodal (Code + Reasoning + Maths) signifie il pourrait aussi aller plus rapide sur logic-problems.
- Pour qui adapté ? Développeurs avec VRAM 48 GB+. Equipes qui veulent tenir repos entiers en contexte. Workflows lourds refactoring, grandes migrations.
- Licence-story ? DeepSeek licence sous Mistral Non-Production; usage commercial besoin accord ventes. Important pour open-source lovers — pensez à cela pour deployment.
- Erreurs courantes ? Trop contexte feeding mène explosion token. 48 GB est Q4_K_M floor pour full size; versions tronquées possibles mais perdent avantages.

Codestral 22B : Analyse approfondie
Codestral 22B est le modèle vitesse. Mistral l'a poli pour inférence rapide, signifiant c'est meilleure option si vous êtes latency-sensitive (IDE auto-complete, real-time refactoring).
- Points clés ? Token-rate plus rapide de classe 22B. Licencing commercial la plus claire — Mistral a deux licences séparées : Non-Production et Commercial (vendu). Si votre entreprise Mistral commercial besoin, il n'y a pas maudiction licence.
- Pour qui adapté ? Equipes qui doivent tenir latency petit. Développeurs IDE plug-in. Startups qui veulent clarté licence commerciale.
- Erreurs courantes ? Fenêtre contexte seulement 32K, non 256K — ça c'est grand stepback de Qwen3-Coder. Repos entiers ne rentrent pas. Pour petits fichiers / edits single-file c'est parfait.

Kimi K2.7 Code : Analyse approfondie
Kimi K2.7 Code est le choix des équipes qui possèdent déjà un serveur multi-GPU ou une grande machine à mémoire unifiée et font tourner de longues tâches de codage agentique — refactorisations sur tout le dépôt, migrations, chaînes d'outils multi-étapes.
- Pourquoi pas choix standard ? Il n'existe aucune petite variante — 1T de paramètres totaux avec ~32B actifs (MoE), aucune option laptop ni GPU unique. Pour la plupart des développeurs, Qwen3-Coder 30B reste le meilleur choix par défaut.
- Quand choisir ? Vous possédez déjà le matériel d'inférence et faites tourner de longues tâches d'agent autonome, où le contexte 256K et le coût de reasoning-tokens plus bas de Moonshot AI se rentabilisent.
- License ? Modified MIT de Moonshot AI — usage commercial autorisé, mais une mention d'attribution ("Kimi K2") est requise au-delà d'un certain seuil de déploiement. Lisez la modification avant de l'intégrer dans un produit.

Granite Code : Analyse approfondie
Granite Code (IBM) est le modèle enterprise. IBM s'est derrière licence story enterprise-friendly et taille 34B qui s'ajuste sur 24 GB.
- Points forts ? Support IBM pour deployments enterprise. License Apache 2.0 est clair. Taille 34B est entre 30B et 70B, avec VRAM-requirements raisonnables.
- Erreurs courantes ? Granite Code est moins largement "ciblé" qu'Qwen3-Coder et a nombres HumanEval+ plus petits. Si vous êtes enterprise, les contrats IBM pourraient justifier performance-nachteil.

StarCoder 2 : Analyse approfondie
StarCoder 2 est le modèle langage. BigCode l'a entraîné sur 80+ langues programmation, non juste les suspects habituels (Python, TypeScript, C++).
- Pour qui ? Développeurs qui écrivent langues rares (COBOL, Fortran, Lisp, Shell, Assembly). StarCoder 2 non mauvais aux langues populaires, mais son avantage c'est vraiment breadth.
- License ? BigCode Open RAIL — "Responsible AI License" ouvert modèle. C'est non-commercial en quelques use-cas; vérifiez licence-agenda.
Modèles qui ne fonctionnent pas
Il y a aussi modèles non-good pour codage local — soit par performance, licence, ou raisons pratiques.
- Kimi K2.6 (plus ancien) — Prédécesseur de Kimi K2.7 Code, sans tuning codage dédié. Choisir seulement si vous avez déjà du tooling construit dessus.
- Mistral Small sans Code-Training — Mistral Small général, non optimisé pour codage. Si vous besoin Mistral, utiliser Codestral, non Mistral général.
- Phi-3 5B / 3.8B — Trop petit pour vrai codage. Auto-complete scenarios seulement.
- ONNX-converted Modèles sans code-training explicite — Quelques gens convertissent GPT-J ou autres à ONNX et disent "codage local", mais sans code-training vous verrez hallucinations.
Erreurs courantes
Ces erreurs je les vois toujours quand équipes switch à codage local.
- Ignorer VRAM-calculations — Gens disent "24 GB devrait run Qwen3-Coder 70B" et surpris quand serveur AI OOM rapidement après start. Q4_K_M signifie "4-bit-quantization", non "0.1x original-size". VRAM actual c'est Model-size × 0.04 + (Batch-size × Context-length × 2 bytes × Layers). Connaître vos nombres.
- Overload contexte-length — "256K contexte signifie je peux fournir mon projet entier" — faux. Long contextes dégradent quality à fin (les 5K tokens finaux influence moins inférence). Utiliser 32K–64K pour vrai codage, non 256K.
- Choisir quantization-format mauvais — Q4_K_M c'est production floor. Q3 ne mirror pas performance — vous perdez coding-accuracy avant quality. Q5 ou supérieur c'est wasted VRAM pour codage local.
- Fullfeed contexte trop-rapide multi-turn dialogs — "J'ai 128K contexte, donc je fais 100 edits en même conversation" — faux. Token-length en contexte inclut aussi history. Après 10–20 turns vous êtes à 50K tokens. Commencer nouveau chat.
- No quantization-validation — Vous quantize un modèle localement et ne le testez pas contre baseline. Quelques quantization-tools mènent subtle bugs. Validater contre simple test-code d'abord.

Puis-je utiliser un format quantization sous Q4_K_M ?
Techniquement oui, mais non pour codage. Q3_K_M ou pire dégrade codage-accuracy noticeablement. Codage besoin fine-grain token-selection; Q4 c'est seuil minimal. Si vous êtes VRAM-pressed, choisissez modèle plus petit (7B au lieu 30B) au lieu pire quantization.
Devrais-je fine-tune localement un modèle ?
Seulement si vous avez code côté-firm qui ressemble différent du training public. Fine-tuning sur standard-code-patterns c'est compute wasted. Fine-tuning peut utile pour code domain-spécifique (legacy codebase vieux, proprietary DSLs), mais c'est besoin infrastructure et validation.
Qu'est HumanEval+ et pourquoi c'est important ?
HumanEval+ c'est benchmark qui mesure si un modèle écrit code qui passe input-output tests. C'est important parce que c'est plus réaliste qu'"code-writing-leaderboards", mais toujours non vrai production code. Utiliser HumanEval+ rankings comme signal, non toute l'histoire.
Peuvent ces modèles écrire SQL, Bash ou Dockerfile ?
Oui, tous six peuvent. Ils furent entraînés sur mixed-code-workloads. SQL est souvent même force. Bash-quality est bas (bash a complex edge-cases). Dockerfile c'est OK mais non parfait.
Quel modèle c'est meilleur pour une équipe ?
Pour équipe, consistency et deployment-easiness sont importants. Qwen3-Coder 30B c'est gagnant point : bonne performance, ajuste standard-hardware (24 GB), Apache 2.0 licence équipe-friendly. Si équipe polyglotte-code, StarCoder 2. Si équipe forte contrats IBM, Granite.
Combien souvent je devrais mettre à jour ces modèles ?
Cette liste c'est "semi_annual", ce qui signifie elle sera checked tous les six-mois (prochaine check début novembre 2026). Nouveaux modèles releasés fréquemment; significant performance-sprints pourraient justify faster updates. Ne pas utiliser comme ref eternel — check nouvelles releases modèles.
Puis-je courir plusieurs modèles parallèle sur un rig ?
Oui, mais seulement si vous suffisant VRAM. Par ex. sur rig 48 GB vous pouviez run Qwen3-Coder 30B (~18 GB) + modèle plus petit (~10 GB) = encore 20 GB left. C'est rarement worth complexité — switch entre modèles au lieu parallel.
Comment je obtiens modèles down et les runs ?
Utiliser llama.cpp (recommandé), vLLM, Text Generation WebUI, ou Ollama. Tous ces download GGUF-quantizations depuis Hugging Face. Exemple: llama.cpp -m qwen3-coder-30b-q4_k_m.gguf -c 4096 -n 512. Voir [LLM Quantization Explained] pour explication plus profonde.
Devrais-je choisir DeepSeek ou Qwen3-Coder si je pouvais les deux fit 48 GB ?
Choisir DeepSeek si context-window (128K) c'est bindant votre use-case. Choisir Qwen3-Coder si pure coding-performance et license-clarity c'est (Qwen c'est Apache 2.0, DeepSeek plus compliqué). Pour plupart équipes, Qwen3-Coder c'est meilleur, même 48 GB.
Quel modèle c'est meilleur pour code scientifique ?
Qwen3-Coder ou DeepSeek-V3. Qwen a math-training renforcé; DeepSeek aussi. Tous deux sont forts à NumPy, SciPy, JAX, PyTorch utilisation. Kimi K2.7 Code c'est aussi suffisant, mais non spécialisé.