Meilleurs modèles MoE pour le codage local ?
Par Hans Kuepper · Fondateur de PromptQuorum · Moteur de découverte de l'IA open-weight et open source
Points clés
- ✓Les modèles MoE chargent tous les experts en mémoire mais ne calculent que 3 à 5B de paramètres actifs par token : ils sont plus rapides que des modèles denses de même taille de fichier, sans consommer moins de mémoire
- ✓gpt-oss-20b (14 Go sur Ollama) est le choix MoE pour 16 Go ; Qwen3-Coder-30B-A3B et GLM-4.7-Flash (19 Go chacun) tiennent sur un GPU de 24 Go
- ✓Qwen3.6-35B-A3B (~24 Go) affiche 73,4 sur SWE-bench Verified dans sa fiche modèle, le chiffre le plus élevé des modèles comparés ici, et convient à 32 Go de mémoire
- ✓Qwen3-Coder-Next (52 Go) et gpt-oss-120b (65 Go) demandent 64 à 80 Go de mémoire unifiée ou de VRAM
Réponse rapide
Qwen3.6-35B-A3B affiche le score SWE-bench Verified publié par l'éditeur le plus élevé des modèles comparés et convient à 32 Go de mémoire, Qwen3-Coder-30B-A3B tient sur un GPU de 24 Go et gpt-oss-20b sur 16 Go. Les modèles MoE ne calculent que 3 à 5 Md de paramètres actifs par token, donc ils sont rapides, mais ils exigent quand même de la mémoire pour tous les experts.
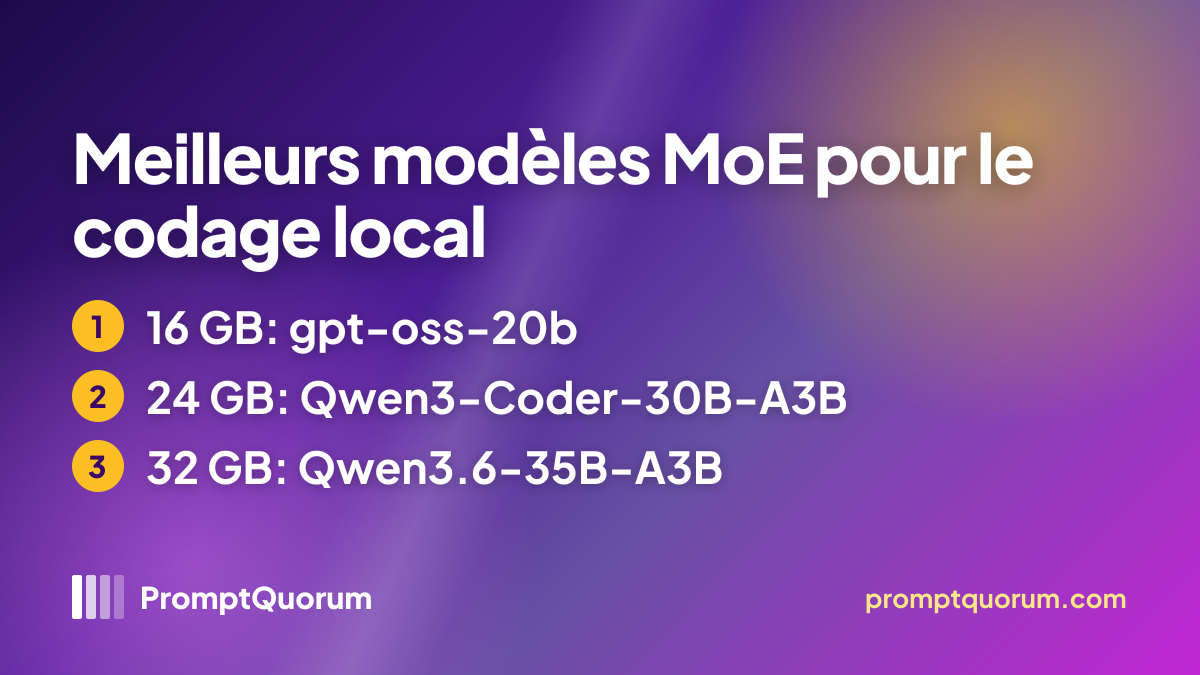
- ▸16 Go : gpt-oss-20b (21B au total, 3,6B actifs, 14 Go sur Ollama)
- ▸24 Go : Qwen3-Coder-30B-A3B ou GLM-4.7-Flash (19 Go chacun)
- ▸32 Go et plus : Qwen3.6-35B-A3B (~24 Go) ; 64–80 Go : Qwen3-Coder-Next, gpt-oss-120b
Les modèles MoE exigent de la mémoire pour tous les paramètres, pas seulement les actifs
Un modèle Mixture of Experts (MoE) fait passer chaque token par quelques sous-réseaux experts : la vitesse suit les paramètres actifs, la mémoire suit les paramètres totaux. Selon sa fiche Hugging Face, Qwen3.6-35B-A3B compte 256 experts et en active 8 routés plus 1 partagé par token (3B de ses 35B paramètres).
Un MoE à 3B actifs génère donc des tokens pour un coût proche d'un petit modèle dense, mais son téléchargement de 14 à 24 Go doit tout de même tenir en VRAM ou en mémoire unifiée rapide. Les tailles du tableau sont celles des téléchargements Ollama ; prévoyez une marge pour le cache de contexte.
Les scores des fiches modèles sont publiés par les éditeurs, avec des configurations d'agent différentes : SWE-bench Verified vaut 73,4 pour Qwen3.6-35B-A3B, 70,6 pour Qwen3-Coder-Next et 59,2 pour GLM-4.7-Flash. Lisez-les comme des ordres de grandeur, pas comme un duel direct ; PromptQuorum ne les a pas relancés.
| Modèle | Total / actifs | Taille Ollama | Palier mémoire |
|---|---|---|---|
| Qwen3.6-35B-A3B | 35B / 3B | ~24 GB | 32 GB |
| Qwen3-Coder-30B-A3B | 30B / 3.3B | 19 GB | 24 GB |
| GLM-4.7-Flash | 30B / 3B | 19 GB | 24 GB |
| gpt-oss-20b | 21B / 3.6B | 14 GB | 16 GB |
| Qwen3-Coder-Next | 80B / 3B | 52 GB | 64 GB |
| gpt-oss-120b | 117B / 5.1B | 65 GB | 80 GB |
Choisir le modèle MoE adapté à sa mémoire
Pour 16 Go de VRAM, lancez gpt-oss-20b : 21B au total, 3,6B actifs, 14 Go sur Ollama. Il reste environ 2 Go pour le contexte sur une carte de 16 Go ; gardez une fenêtre de contexte modeste.
Pour un GPU de 24 Go, lancez Qwen3-Coder-30B-A3B (19 Go, contexte 256K, conçu pour le code) ou GLM-4.7-Flash (19 Go, licence MIT). Ce sont deux MoE 30B-A3B avec 3 à 3,3B de paramètres actifs.
Pour un GPU de 32 Go, lancez Qwen3.6-35B-A3B (environ 24 Go, contexte 256K, Apache 2.0) ; sur un Mac, prévoyez 48 Go de mémoire unifiée, car macOS en réserve environ 8 Go. C'est juste sur un GPU de 24 Go : une partie du modèle déborde en RAM et la vitesse chute.
Pour 64 à 80 Go, Qwen3-Coder-Next (80B au total, 3B actifs, 52 Go en Q4_K_M) convient à une machine de 64 Go, et gpt-oss-120b (117B au total, 5,1B actifs, 65 Go) vise un seul GPU de 80 Go selon la fiche modèle d'OpenAI.
Sous 16 Go, le MoE n'est plus pratique ; voyez les meilleurs modèles 14B pour le codage pour des alternatives denses.
Exécuter des modèles MoE avec Ollama
Chaque modèle du tableau se lance avec une commande : ollama run gpt-oss:20b, ollama run qwen3-coder:30b, ollama run glm-4.7-flash, ollama run qwen3.6:35b, ollama run qwen3-coder-next et ollama run gpt-oss:120b.
Ollama répartit les couches entre GPU et RAM quand un modèle dépasse la VRAM. Avec llama.cpp, on peut piloter cela pour les MoE : les options --cpu-moe et --n-cpu-moe gardent les poids des experts en RAM pendant que l'attention reste sur le GPU, ce qui permet de faire tourner un modèle de 19 à 24 Go sur une carte de 16 Go, plus lentement. PromptQuorum n'a pas mesuré la vitesse.
Une erreur courante est de juger l'encombrement d'après les paramètres actifs : un modèle « 3B actifs » n'est pas un téléchargement de la taille d'un 3B. Vérifiez la taille du fichier sur la page Ollama du modèle avant de le télécharger.
Pour des alternatives denses à chaque palier de VRAM, consultez le guide des meilleurs LLM locaux pour le codage.
Guides associés
- ▸Meilleurs modèles 14B pour le codage -- modèles de codage denses pour 10–16 Go
- ▸Meilleurs LLM locaux pour le codage -- modèles de codage par palier de VRAM
- ▸Continue.dev racheté par Cursor : arrêt et alternatives -- coding tool comparison
Sources
- ▸Fiche modèle Qwen3.6-35B-A3B — architecture, experts, licence et score SWE-bench Verified.
- ▸Fiche modèle Qwen3-Coder-Next — 80B au total, 3B actifs, score SWE-bench Verified.
- ▸Fiche modèle GLM-4.7-Flash — MoE 30B-A3B, licence MIT, score SWE-bench Verified.
- ▸Fiche modèle gpt-oss-120b — paramètres totaux et actifs et cibles mémoire de gpt-oss-120b et gpt-oss-20b.
- ▸Bibliothèque Ollama : qwen3-coder — tags et tailles de téléchargement ; voir aussi gpt-oss, glm-4.7-flash, qwen3.6 et qwen3-coder-next.
Réponses rapides sur les modèles MoE pour le codage
Qu'est-ce qu'un modèle MoE et pourquoi est-ce important pour le codage local ?▾
Quel modèle MoE choisir pour 16 Go de VRAM ?▾
Quel est le meilleur petit modèle MoE ?▾
Un modèle MoE demande-t-il moins de VRAM qu'un modèle dense ?▾
Quels modèles MoE de codage sont disponibles sur Ollama ?▾
qwen3.6:35b, qwen3-coder:30b, glm-4.7-flash, gpt-oss:20b, qwen3-coder-next et gpt-oss:120b, pour des téléchargements d'environ 24, 19, 19, 14, 52 et 65 Go.Un modèle MoE est-il meilleur qu'un modèle dense pour coder ?▾
qwen3.6:27b (18–19 Go), peut être plus lent par token ; testez les deux sur vos propres dépôts avant de choisir.