De combien de VRAM avez-vous besoin pour un LLM local ?
Réponse rapide
4 Go VRAM suffisent pour Llama 3.2 3B et Phi-3.5-mini avec marge sûre pour expansion contexte. 6 Go font tourner Llama 3.1 8B en Q4. 12 Go accueillent Qwen3 14B Q4 efficacement. Les modèles 70B Q4 nécessitent 16+ Go.
- ▸4 Go : Llama 3.2 3B Q4, Phi-3.5-mini Q4
- ▸6 Go : Llama 3.1 8B Q4_K_M
- ▸8–12 Go : Llama 3.1 8B Q5_K_M, Qwen3 14B Q4
Points clés
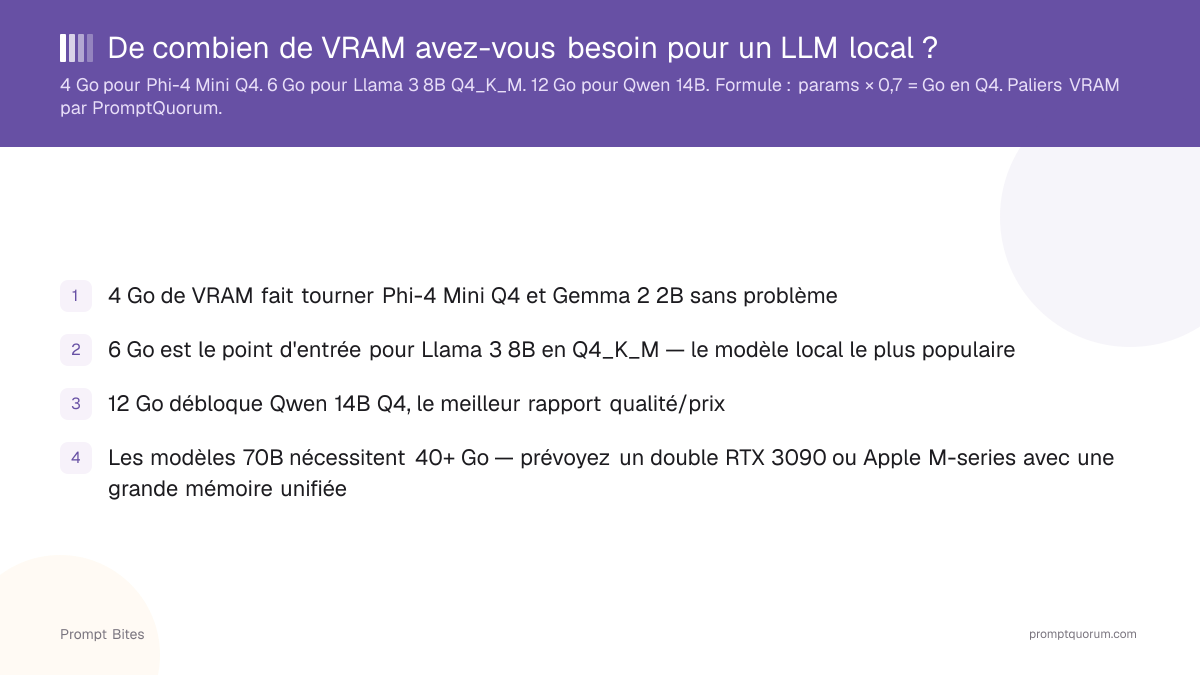
- ✓4 Go de VRAM fait tourner Llama 3.2 3B et Phi-3.5-mini sans problème
- ✓6 Go est le point d'entrée pour Llama 3.1 8B en Q4_K_M — la taille de modèle local la plus populaire
- ✓12 Go débloque Qwen3 14B Q4, le meilleur rapport qualité/prix
- ✓Les modèles 70B nécessitent 40+ Go — prévoyez un double RTX 3090 ou Apple M-series avec une grande mémoire unifiée
Besoins en VRAM par taille de modèle
Le besoin en VRAM d'un modèle suit une formule simple, vérifiée sur les tailles réelles des fichiers GGUF : nombre de paramètres en milliards × 0,6 = Go approximatifs en quantisation Q4. Un modèle 8B nécessite ~4,8 Go pour les poids, plus 0,5–1 Go de surcharge de contexte. C'est pourquoi 6 Go est le minimum pour le tier 7–8B, et pourquoi 12 Go débloque le tier 14B avec de la marge.
Utilisez le tableau ci-dessous comme référence de décision rapide. La colonne "Vitesse" suppose Ollama sur un GPU de bureau tournant avec le contexte par défaut (2048 tokens).
Gardez toujours 1–2 Go de VRAM libres au-dessus des besoins déclarés de votre modèle. Les systèmes d'exploitation, les onglets de navigateur et le runtime d'Ollama consomment 500 Mo–1 Go même sans modèle chargé. Une carte 6 Go faisant tourner Llama 3.1 8B Q4_K_M (~4,8 Go) ne laisse qu'environ 1,2 Go de marge — vous rencontrerez des erreurs de mémoire insuffisante si vous augmentez --num-ctx nettement au-delà de 2048 tokens. Pour le tier 6 Go avec une marge sécurisée, voir les meilleurs LLMs locaux pour 6 Go de VRAM.
| VRAM | Meilleur modèle en Q4_K_M | Vitesse |
|---|---|---|
| 4 Go | Llama 3.2 3B ou Phi-3.5-mini Q4 | ~25 tok/s |
| 6 Go | Llama 3.1 8B Q4_K_M | ~20 tok/s |
| 8 Go | Llama 3.1 8B Q5_K_M | ~18 tok/s |
| 12 Go | Qwen3 14B Q4_K_M | ~15 tok/s |
| 16+ Go | Qwen3 32B Q4 ou Llama 3.3 70B partiel | ~8 tok/s |
Quand votre VRAM est insuffisante
Si un modèle dépasse votre VRAM, vous avez trois options : réduire la quantisation (Q4_K_M au lieu de Q5), réduire la fenêtre de contexte avec --num-ctx 2048, ou laisser Ollama décharger des couches vers la RAM système.
Le déchargement CPU fonctionne mais est lent — chaque couche déplacée vers la RAM ajoute de la latence. Pour un usage interactif, restez dans les limites VRAM de votre GPU. Réduire le contexte de 4096 à 2048 tokens économise environ 2 Go sur un modèle 7-8B.
Pour une répartition complète des tailles de modèles et les calculs derrière les estimations VRAM, voir le guide VRAM complet pour les LLMs locaux. Pour le tier 7B spécifiquement, voir combien de RAM nécessite un modèle 7B.
Réponses rapides sur la VRAM
8 Go de VRAM suffisent-ils pour les LLMs locaux ?▾
Puis-je faire tourner un modèle 7B sur 4 Go de VRAM ?▾
La taille de la fenêtre de contexte affecte-t-elle l'utilisation de la VRAM ?▾
Que faire si mon modèle consomme plus de VRAM que prévu ?▾
--num-ctx 2048 dans votre commande Ollama. Cela réduit la VRAM de jusqu'à 2 Go sur les modèles 7B sans modifier le fichier modèle.