Peut-on faire tourner des LLMs locaux sur une Radeon RX 6800M ?
Par Hans Kuepper · Fondateur de PromptQuorum · Moteur de découverte de l'IA open-weight et open source
Points clés
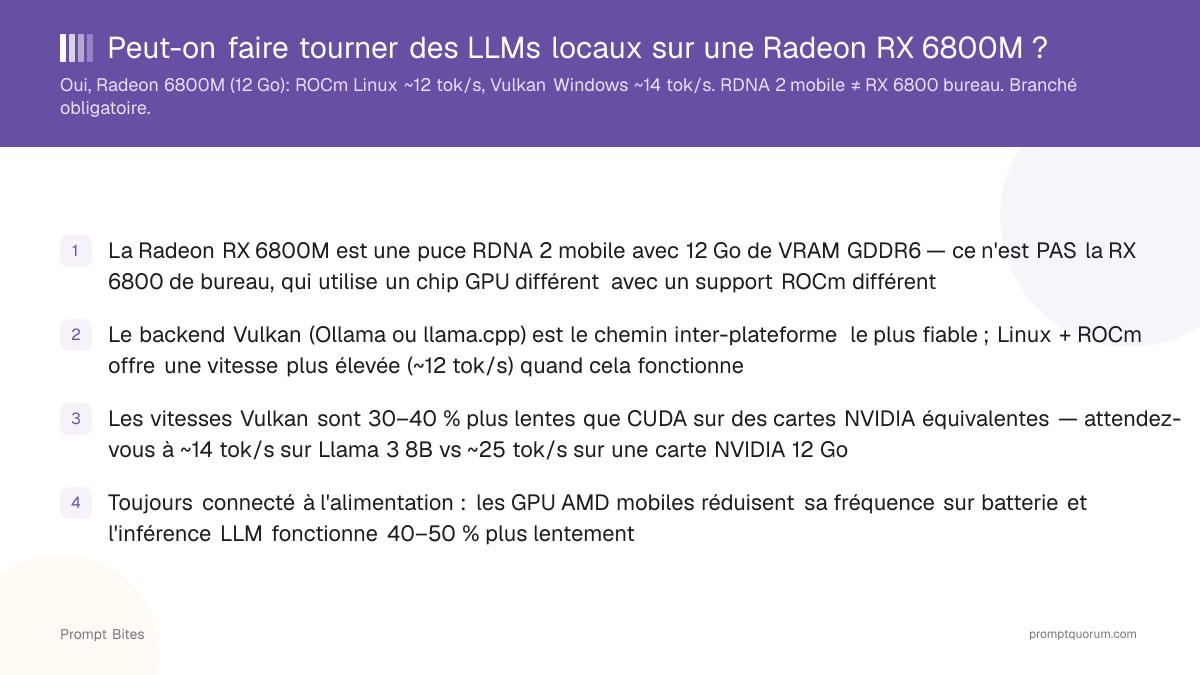
- ✓La RX 6800M est une puce RDNA 2 mobile (Navi 22, 12 Go de VRAM) — PAS la RX 6800 de bureau (Navi 21, 16 Go de VRAM)
- ✓Vulkan est la voie fiable sous Windows et Linux ; ROCm ne prend pas en charge officiellement la 6800M, et sous Windows la liste ROCm d'Ollama commence à la RX 7600
- ✓Vitesse estimée : environ 45–60 tok/s sur un modèle 8B en Q4_K_M et 25–35 tok/s sur un modèle 14B — extrapolée d'un benchmark de la RX 6700 XT (même puce), non mesurée par PromptQuorum
- ✓Utilisez toujours le secteur : sur batterie, les GPU de portable appliquent des limites de puissance plus strictes, ce qui ralentit l'inférence
Réponse rapide
Oui. La Radeon RX 6800M dispose de 12 Go de VRAM GDDR6 et fait bien tourner des LLMs locaux via le backend Vulkan d'Ollama ou de llama.cpp, sous Windows comme sous Linux. ROCm ne prend pas en charge officiellement cette puce ; sous Linux, il ne fonctionne que via un contournement non officiel. Un modèle 8B en Q4_K_M atteint environ 45–60 tok/s (estimation d'après un benchmark de la RX 6700 XT, même puce), non mesurée par PromptQuorum.
- ▸Windows et Linux : Vulkan est la voie fiable (Ollama l'active par défaut)
- ▸ROCm : la 6800M ne figure ni sur la liste d'AMD ni sur celle d'Ollama ; Linux exige HSA_OVERRIDE_GFX_VERSION=10.3.0 et peut être instable
- ▸12 Go de VRAM conviennent aux modèles jusqu'à 14B en Q4_K_M avec une fenêtre de contexte modérée
Ce que la Radeon RX 6800M peut réellement exécuter
La Radeon RX 6800M est une puce RDNA 2 mobile (Navi 22, gfx1031) avec 12 Go de VRAM GDDR6 — pas la RX 6800 de bureau, qui utilise la puce Navi 21, plus grande, avec 16 Go. Avec 12 Go, la 6800M accueille des modèles jusqu'à 14B en Q4_K_M sans déchargement de couches, soit la capacité d'une RTX 3060 12 Go de bureau. Les longues fenêtres de contexte ajoutent du cache KV en plus des poids du modèle.
La vitesse de génération pour un seul utilisateur est surtout limitée par la bande passante mémoire. La 6800M utilise la même puce Navi 22 et la même configuration mémoire de 12 Go que la RX 6700 XT de bureau, qui obtient environ 84 tok/s sur Llama 2 7B Q4_0 avec le backend Vulkan dans le classement Vulkan de llama.cpp. En ajustant ce chiffre à des fichiers de modèle plus gros, on obtient les estimations ci-dessous. Les limites de puissance et le refroidissement d'un portable peuvent placer la 6800M sous une carte de bureau.
Ces vitesses sont des estimations dérivées de ce benchmark public, et non des tests réalisés par PromptQuorum sur une 6800M. Lancez llama-bench sur votre machine pour obtenir vos chiffres réels. Pour une comparaison CUDA à 8 Go de VRAM, voir la comparaison AMD 5700X + RTX 3070 Ti.
| Modèle | VRAM (Q4_K_M) | Vitesse estimée (Vulkan) |
|---|---|---|
| Llama 3.1 8B | ~5 Go | ~45–60 tok/s |
| Qwen3 8B | ~5 Go | ~45–60 tok/s |
| Phi-4 14B | ~9 Go | ~25–35 tok/s |
| Qwen3 14B | ~9 Go | ~25–35 tok/s |
Configurer des LLMs locaux sur la 6800M
Sous Windows et Linux, installez Ollama — il utilise le backend Vulkan pour les GPU AMD, sans ROCm. La documentation GPU d'Ollama indique que Vulkan est activé par défaut lorsque le backend est installé ; sous Linux, des paquets Vulkan supplémentaires peuvent être nécessaires. Vous pouvez aussi utiliser un binaire Vulkan précompilé de llama.cpp et charger un GGUF avec -ngl 99 pour décharger toutes les couches sur le GPU.
ROCm est la voie la plus difficile. La RX 6800M ne figure ni dans le tableau de prise en charge ROCm d'AMD ni dans la liste AMD d'Ollama, et sous Windows la liste ROCm d'Ollama ne couvre que la RX 7600 et les modèles plus récents. Sous Linux, des retours de la communauté utilisent HSA_OVERRIDE_GFX_VERSION=10.3.0 pour que ROCm traite la puce comme gfx1030. C'est non officiel et peut planter ou basculer sur le CPU : essayez d'abord Vulkan.
Utilisez toujours le secteur — sur batterie, les GPU de portable appliquent des limites de puissance plus strictes, ce qui ralentit l'inférence. Pour la comparaison complète des GPU NVIDIA et AMD, voir le guide des meilleurs GPU pour LLMs locaux.
ollama run llama3.1:8b, puis vérifiez ollama ps — la colonne PROCESSOR doit afficher 100% GPU. Si elle indique CPU, consultez le journal du serveur Ollama pour les messages de détection du GPU.Radeon RX 6800M vs RX 6800 de bureau
Les recherches « RX 6800 » mènent souvent à la puce mobile, mais les deux cartes diffèrent. La RX 6800 de bureau a 16 Go de VRAM et une plus grande bande passante mémoire : elle accueille des modèles plus gros et génère plus vite. Le classement Vulkan de llama.cpp indique environ 101 tok/s pour la RX 6800 de bureau contre environ 84 tok/s pour la RX 6700 XT (Llama 2 7B Q4_0, Vulkan).
La RX 6800 de bureau figure sur la liste AMD Linux d'Ollama, contrairement à la 6800M. Tout le reste de cette page concernant Vulkan s'applique aux deux cartes.
| Caractéristique | RX 6800M (portable) | RX 6800 (bureau) |
|---|---|---|
| Puce GPU | Navi 22 (gfx1031) | Navi 21 (gfx1030) |
| VRAM | 12 Go GDDR6 | 16 Go GDDR6 |
| Bande passante mémoire | 384 Go/s | 512 Go/s |
| Liste AMD Linux d'Ollama | Non listée | Listée |
| ROCm d'Ollama sous Windows | Non listée | Non listée |
Guides associés
Réponses rapides sur la Radeon 6800M et les LLMs locaux
La Radeon 6800M prend-elle en charge ROCm officiellement ?▾
HSA_OVERRIDE_GFX_VERSION=10.3.0, mais c'est un contournement non officiel. Vulkan est la voie prise en charge pour cette carte.Combien de VRAM possède la Radeon RX 6800M ?▾
Ollama fonctionne-t-il sur la RX 6800M ?▾
La RX 6800 de bureau est-elle meilleure que la 6800M pour les LLMs locaux ?▾
La 6800M est-elle plus rapide que la RTX 3070 Mobile pour les LLMs ?▾
llama-bench sur votre machine.