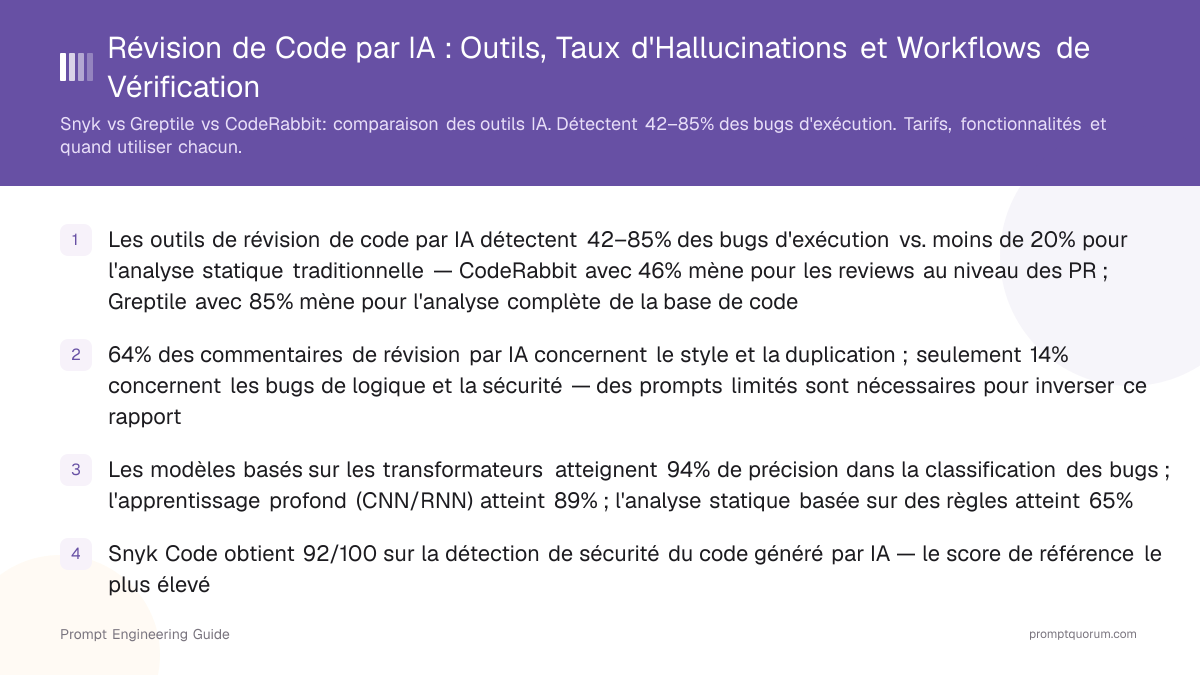
Ce que fait réellement la révision de code par IA
📍 In One Sentence
La révision de code par IA est un filtre de premier passage qui fait ressortir les bugs de logique, les problèmes de sécurité et les écarts aux standards dès l'ouverture d'une pull request, afin que les relecteurs humains consacrent leur temps à la logique et à l'architecture plutôt qu'au nommage des variables.
💬 In Plain Terms
Voyez-la comme un correcteur orthographique pour le code. Elle intercepte les problèmes évidents avant même qu'un collègue ne regarde votre pull request, de sorte que la relecture humaine puisse porter sur la pertinence de l'approche plutôt que sur un test de nullité oublié.
Les outils de révision de code par IA analysent les pull requests, détectent les bugs de logique, signalent les failles de sécurité, font appliquer les standards de codage et génèrent des suggestions de correctifs exploitables — en quelques secondes, là où la relecture manuelle par des pairs demande des heures.
La relecture de code par les pairs est la tâche la plus chronophage des workflows de développement logiciel : elle oblige les ingénieurs seniors à passer de leur propre travail à l'évaluation du code des autres. Les outils de révision de code par IA s'intègrent directement dans les pipelines CI/CD et les workflows de pull requests — GitHub, GitLab, Bitbucket et Azure DevOps — et commencent à analyser le code dès l'ouverture d'une PR, sans attendre qu'un relecteur humain se libère.
Outils de révision de code par IA : lequel utiliser
Lors d'un benchmark de juillet 2025 mené par Greptile sur 50 bugs injectés, Greptile a détecté 82%, Cursor Bugbot 58%, GitHub Copilot 54% et CodeRabbit 44% (paramètres par défaut, offres hébergées). Greptile vend l'un des outils testés et des résultats indépendants peuvent différer : lisez ces chiffres comme indicatifs, pas comme un verdict.
CodeRabbit propose des révisions gratuites sur les dépôts publics ; les dépôts privés nécessitent Essentials ($24 par utilisateur et par mois en facturation annuelle, $30 en facturation mensuelle), Team ($48 en facturation annuelle, $60 en facturation mensuelle) ou Advanced ($72), Enterprise étant sur devis. L'auto-hébergement est réservé à Enterprise, et la documentation d'auto-hébergement indique qu'il est proposé aux clients de 500+ sièges.
Greptile Starter est gratuit pour un développeur actif (50 crédits par mois). Pro n'a pas de frais par siège : les crédits coûtent $1 chacun, et une révision Base consomme 1 crédit, une révision Plus 3 et une révision Apex 10. Qodo Pro Team affiche $30 avec des crédits mutualisés pour un maximum de 30 utilisateurs et n'a pas d'offre gratuite permanente. La révision de code GitHub Copilot est en disponibilité générale sur Copilot Pro, Pro+, Max, Business et Enterprise (pas sur Copilot Free) et consomme des crédits d'IA — GitHub documente des moyennes d'environ $0.25 (Lite), $1.50 (Balanced) et $10 (Max) par révision.
Outil | Taux de détection (test éditeur) | Plateformes Git | Auto-hébergement | Prix catalogue |
|---|---|---|---|---|
| Greptile | 82% | GitHub, GitLab ; Bitbucket DC (Ent.) | Enterprise | Starter gratuit ; Pro $1 par crédit |
| Cursor Bugbot | 58% | GitHub, GitLab, Bitbucket, Azure DevOps | Git auto-hébergé pris en charge | Facturation à l'usage |
| GitHub Copilot | 54% | GitHub | Non | Inclus dans les offres payantes ; facturation en crédits d'IA |
| CodeRabbit | 44% | GitHub, GitLab | Enterprise (500+ sièges) | $24 par utilisateur et par mois (annuel) |
| Qodo | Non testé | GitHub, GitLab, Bitbucket, Azure | Enterprise (sur site) | Pro Team à partir de $30 (mutualisé) |
| Snyk Code | Non testé | Via les intégrations SCM | Non précisé | Gratuit ; Team à partir de $25 (10 devs) |
| SAST traditionnel | Non testé | Variable | Variable | Variable |
🔍 Provenance
Taux de détection : benchmark réalisé par Greptile, juillet 2025, non mesuré par PromptQuorum. Les prix catalogue proviennent des pages tarifaires des éditeurs ; les offres changent souvent, confirmez donc avant tout achat.
CodeRabbit vs Greptile : tarifs, plateformes et détection comparés
CodeRabbit facture par siège et révise gratuitement les dépôts publics ; Greptile Pro facture chaque révision via des crédits prépayés, sans frais par siège. Lors du benchmark de juillet 2025 mené par Greptile lui-même, Greptile a détecté 82% des bugs injectés et CodeRabbit 44%.
Cet écart provient d'un test réalisé par l'éditeur avec les paramètres par défaut : il ne permet pas de prédire les résultats sur votre code. Le modèle de coût compte autant : une équipe qui ouvre peu de pull requests par développeur paie généralement moins avec des crédits, une équipe qui en ouvre beaucoup paie généralement moins avec des sièges.
Qodo se situe entre les deux : Pro Team affiche $30 avec des crédits mutualisés pour des équipes d'un maximum de 30 utilisateurs (la page tarifaire ne précise pas si ce prix est par siège), un essai de 14 jours et pas d'offre gratuite permanente. Sa page tarifaire affiche les logos GitHub, GitLab, Bitbucket et Azure.
Critère | CodeRabbit | Greptile |
|---|---|---|
| Taux de détection (test Greptile) | 44% | 82% |
| Offre gratuite | Dépôts publics, gratuit | Starter : 1 dév., 50 crédits/mois |
| Prix d'entrée payant | $24/utilisateur/mois (annuel) | $1 par crédit, sans frais par siège |
| Essai | 14 jours (offres payantes) | 14 jours (Pro) |
| Plateformes Git | GitHub, GitLab | GitHub, GitLab ; Bitbucket DC (Ent.) |
| Auto-hébergement | Enterprise (500+ sièges) | Enterprise |
| Fournisseur LLM personnel | Documenté (auto-hébergé) | Non précisé |
Alternatives à Greptile : CodeRabbit, Qodo, Cursor Bugbot, Copilot et Graphite
Les alternatives les plus proches de Greptile sont CodeRabbit, Qodo, Cursor Bugbot, GitHub Copilot code review et Graphite Agent. Choisissez selon la plateforme Git, selon le modèle tarifaire (sièges, crédits ou usage) et selon le déploiement (cloud ou auto-hébergé), pas selon un seul benchmark.
- CodeRabbit — tarification par siège, gratuit sur les dépôts publics, auto-hébergement avec Enterprise. A détecté 44% lors du test de Greptile.
- Qodo — Pro Team à partir de $30 avec crédits mutualisés, essai de 14 jours ; GitHub, GitLab, Bitbucket et Azure ; Enterprise ajoute le SaaS mono-locataire et le déploiement sur site ou isolé du réseau. Absent du test de Greptile.
- Cursor Bugbot — facturation à l'usage ; GitHub, GitLab, Bitbucket et Azure DevOps Services, y compris GitHub, GitLab et Bitbucket Data Center auto-hébergés. A détecté 58% lors du test de Greptile.
- GitHub Copilot code review — inclus dans Copilot Pro, Pro+, Max, Business et Enterprise, facturé en crédits d'IA (environ $0.25 à $10 par révision selon le niveau d'effort). A détecté 54% lors du test de Greptile.
- Graphite Agent — le relecteur IA de Graphite (le nom Diamond est obsolète). Cursor a annoncé le rachat de Graphite le 19 décembre 2025.
Snyk et SonarQube analysent les vulnérabilités ; les relecteurs IA lisent la pull request
Snyk Code est un scanner de sécurité, pas un relecteur général de pull requests : il signale des vulnérabilités comme les injections et les identifiants codés en dur dans l'IDE, les pull requests et la CI, tandis que CodeRabbit, Greptile ou Qodo commentent la logique, les cas limites et la conception dans le diff. La plupart des équipes utilisent un outil de chaque type.
Offres Snyk Code (snyk.io/plans) : Free couvre 100 tests Snyk Code par mois ; Team démarre à $25 par mois pour un maximum de 10 développeurs (1,000 tests par mois, tarif forfaitaire) ; Enterprise fonctionne par crédits, à raison de 1 crédit par contributeur actif et par jour. La page des offres ne mentionne ni résumés de pull requests par IA ni révision de code par IA parmi les fonctionnalités des offres.
SonarQube relève principalement de l'analyse statique à base de règles : il applique des règles fixes de qualité et de sécurité et fait respecter des quality gates, ce qui est déterministe et reproductible. Un relecteur LLM ajoute des commentaires contextuels, mais ses résultats peuvent varier d'une exécution à l'autre : utilisez donc le moteur de règles comme barrière de merge et le relecteur IA comme lecteur supplémentaire.
Options auto-hébergées, sur site et avec votre propre LLM
L'auto-hébergement est une fonctionnalité des offres Enterprise chez les trois éditeurs qui le documentent — CodeRabbit, Greptile et Qodo — et aucun ne le propose dans une offre en libre-service. Pour un code qui ne doit jamais quitter votre infrastructure, exécutez un modèle open-weight en local — voir Meilleurs LLM locaux pour la révision de code.
- CodeRabbit — Enterprise uniquement ; la documentation indique qu'il est proposé aux clients de 500+ sièges et qu'il s'exécute sous forme d'image de conteneur avec GitHub Enterprise Server, GitLab auto-hébergé, Azure DevOps ou Bitbucket Data Center. CodeRabbit auto-hébergé envoie toujours les prompts de révision et le code source au fournisseur de LLM que vous configurez, et la documentation indique que vous pouvez connecter votre propre fournisseur ou compte LLM.
- Greptile — Enterprise uniquement (« self-host in your own infrastructure ») ; GitHub Enterprise, GitLab Self-Managed, Bitbucket Data Center, Gitea et Perforce.
- Qodo — Enterprise ajoute le SaaS mono-locataire et le déploiement sur site ou isolé du réseau.
- CodeRabbit CLI — révise les modifications locales non commitées avant qu'une pull request n'existe. Elle s'authentifie auprès du backend de CodeRabbit et la page de documentation que nous avons consultée n'indique pas si le code analysé reste sur votre machine : elle ne remplace donc pas une révision entièrement locale.
Pourquoi le rapport signal-bruit pose-t-il problème dans la révision de code par IA ?
Les outils de révision de code par IA commentent les problèmes de style de manière bien plus fiable qu'ils ne détectent les bugs d'exécution critiques (44–82% dans le test réalisé par les éditeurs ci-dessus) — ce qui crée un problème de volume de commentaires pouvant entraîner l'effondrement de l'adoption par les développeurs.
Les guides sectoriels rapportent couramment que les relecteurs IA produisent beaucoup de commentaires de style, de duplication et de couverture de tests par rapport aux constats de logique et de sécurité. Nous n'avons pas pu vérifier de jeu de données public qui chiffre ce rapport ; mesurez-le donc vous-même : la part des commentaires de l'IA auxquels vos développeurs donnent suite est le chiffre qui compte. Les outils dont les commentaires sont surtout ignorés apprennent aux ingénieurs à ignorer tous les retours, y compris les constats critiques.
Une cause probable tient aux données d'entraînement : les modèles voient bien plus de variations de style que d'erreurs de logique dans les bases de code sur lesquelles ils apprennent ; ils font donc ressortir ce qui est fréquent, pas ce qui compte le plus.
Un prompt engineering qui demande au modèle de privilégier la logique et la sécurité plutôt que le style est le principal levier pour modifier ce mélange ; ajustez le prompt, puis mesurez à nouveau le taux d'action.
En une phrase : les outils de révision de code par IA peuvent générer surtout des commentaires de style — des prompts ciblés et un taux d'action suivi gardent visibles les constats de logique et de sécurité.
⚠️ Avertissement
Les équipes qui déploient la révision de code par IA sans cibler les prompts risquent un effondrement de l'adoption par les développeurs. Les ingénieurs se mettent à ignorer TOUS les commentaires — y compris les constats de sécurité critiques — lorsque la plupart des commentaires sont du bruit. Configurez toujours des priorités de révision explicites avant le déploiement auprès de l'équipe.
Comment rédiger des prompts pour la révision de code par IA
Des prompts ciblés et riches en contexte — précisant le langage, le framework, les priorités de révision et le format de sortie — réduisent les faux positifs et améliorent la qualité du signal ; des prompts vagues comme « révise ce code » produisent une sortie générique et très bruyante.
Le prompt engineering est la pratique qui consiste à structurer les instructions données à l'IA pour contraindre et orienter la sortie du modèle. Pour la révision de code, la variable la plus déterminante est un périmètre explicite : lorsque vous indiquez précisément au modèle quelles classes de problèmes privilégier, il produit moins de commentaires de style et davantage de constats de logique et de sécurité.
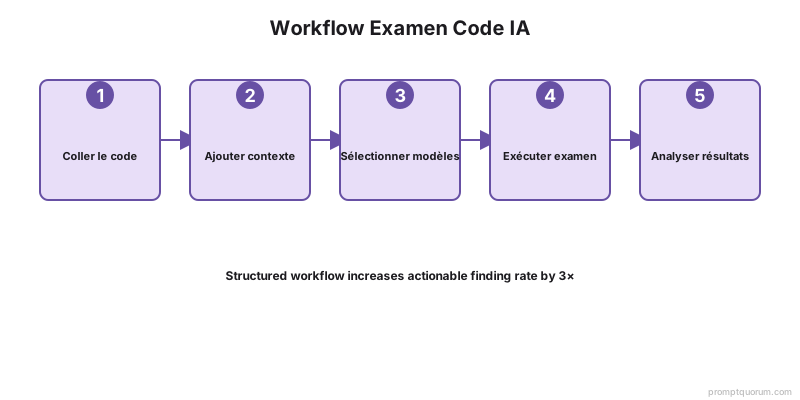
Qu'est-ce que le framework de prompts de révision de code ?
Utilisez cette structure pour toute demande de révision de code par IA :
En termes simples : le framework est un modèle en cinq parties (rôle, périmètre, contexte, format de sortie, consigne anti-bruit) qui transforme des demandes de révision de code vagues en prompts structurés produisant des résultats plus ciblés, en limitant explicitement ce sur quoi l'IA doit se concentrer.
- Rôle — « Tu es un ingénieur logiciel senior spécialisé dans la sécurité de langage/framework. »
- Périmètre — « Révise uniquement : (1) les bugs de logique, (2) les cas limites manquants, (3) les failles de sécurité, (4) les régressions de performance. Ne commente PAS le style, le nommage ni la mise en forme. »
- Contexte — « Langage : TypeScript. Framework : Next.js 14. Ce endpoint traite des données d'utilisateurs authentifiés — considère toutes les entrées comme non fiables. »
- Format de sortie — « Pour chaque problème : indique la gravité (Critique / Élevée / Moyenne), cite la ligne concernée, explique le risque et fournis un extrait de code corrigé. »
- Consigne anti-bruit — « Si tu ne trouves rien dans une catégorie, indique 'Aucun problème trouvé' — n'ajoute pas de commentaires de remplissage. »
🔍 Astuce
La ligne la plus efficace à ajouter à n'importe quel prompt de révision de code par IA est : « Ne commente PAS le style, le nommage ni la mise en forme. » Cette seule contrainte réduit le bruit des commentaires et oblige le modèle à se concentrer sur les bugs de logique et les problèmes de sécurité — les constats qui empêchent réellement les incidents en production.
Quelle est la différence entre un mauvais et un bon prompt de révision de code ?
Mauvais prompt
Révise ce code.
À quoi ressemble un bon prompt de révision de code ?
Bon prompt
Tu es un ingénieur TypeScript senior spécialisé dans la sécurité. Révise la route d'API Next.js suivante pour : (1) les risques de contournement d'authentification, (2) les vecteurs d'injection SQL ou NoSQL, (3) la validation d'entrée manquante, (4) les promesses rejetées non gérées. Ne commente pas le style ni le nommage des variables. Pour chaque problème trouvé : indique la gravité (Critique / Élevée / Moyenne), cite la ligne, explique pourquoi il est exploitable et fournis une version corrigée. Si aucun problème n'existe dans une catégorie, écris 'Aucun problème trouvé.'
Le prompt structuré produit un rapport de sécurité prêt pour le triage. Par exemple, le prompt ouvert peut renvoyer une douzaine de commentaires sur le nommage des variables et un constat de sécurité noyé que l'ingénieur ne lit jamais.
Comment le Chain-of-Thought améliore-t-il la révision de logique complexe ?
Le prompting Chain-of-Thought (CoT) — demander au modèle de suivre le flux de données dans chaque fonction avant de formuler ses constats — fait ressortir des bugs de logique que la révision en une seule étape manque, car le modèle doit modéliser explicitement le chemin d'exécution au lieu de le comparer à des signatures d'erreurs courantes.
Utilisez cette extension pour toute fonction à logique conditionnelle complexe : « Avant d'identifier les bugs : suis les données d'entrée dans chaque branche de cette fonction, pas à pas. Identifie chaque chemin où une valeur nulle, une chaîne vide ou un type inattendu pourrait se propager. Puis liste chaque chemin qui aboutit à un état non géré. »
Comment réaliser une révision de code par IA axée sur la sécurité ?
Les outils SAST (Static Application Security Testing) assistés par IA, entraînés sur des jeux de données de vulnérabilités réelles, ont obtenu 84–92 sur 100 sur du code généré par IA dans une comparaison tierce de 2025 (non mesurée par PromptQuorum).
L'analyse statique à base de règles applique des motifs fixes, tandis que les outils assistés par IA raisonnent aussi sur l'interaction entre les chemins de code. Les deux sont complémentaires, c'est pourquoi de nombreuses équipes utilisent un moteur de règles comme barrière de merge et, à ses côtés, un relecteur IA ou un scanner.
Trois outils axés sur la sécurité, notés dans une comparaison tierce de 2025 portant sur du code généré par IA (sanj.dev ; non mesurée par PromptQuorum) :
Outil | Score (tiers) | Faux positifs | Idéal pour |
|---|---|---|---|
| Snyk Code + DeepCode AI | 92/100 | Volume le plus faible | Équipes qui livrent chaque jour avec intégration IDE |
| Semgrep Enterprise | 87/100 | Faibles | Policy-as-code ; packs de règles YAML personnalisés |
| GitHub Advanced Security (CodeQL) | 84/100 | Moyens | Organisations centrées sur GitHub ; couverture sémantique approfondie |
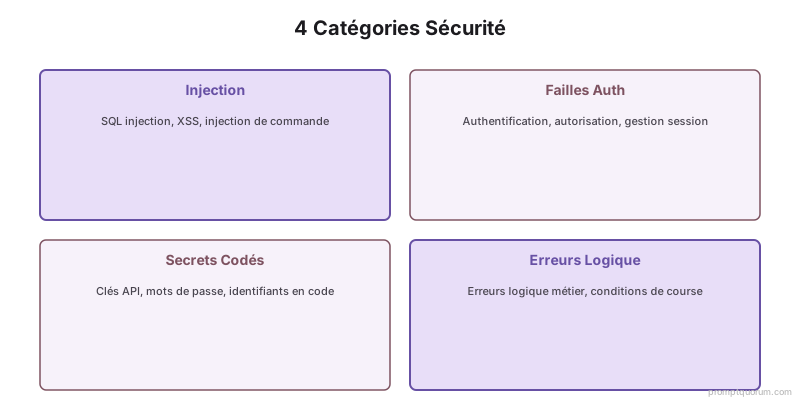
Snyk Code détecte en temps réel les injections SQL, le cross-site scripting (XSS), les paramètres cryptographiques par défaut faibles et les identifiants codés en dur pendant que les développeurs écrivent le code — avant même l'ouverture d'une PR. CodeQL réalise une analyse sémantique à l'aide d'un arbre syntaxique abstrait (AST), ce qui lui permet de détecter des chaînes de vulnérabilités complexes en plusieurs étapes que les outils de reconnaissance de motifs manquent.
Qu'est-ce que le triage de bugs par IA ?
Le triage de bugs assisté par IA classe les bugs par gravité, prédit leur impact en production et oriente les tickets vers le bon ingénieur, ce qui réduit le temps que les ingénieurs passent à débattre des priorités.
Le triage de bugs par IA est l'étape qui suit la détection. Dans un article de Khaleefulla, Sudeep et Savithri (IJERT), les auteurs rapportent plus de 85% de précision dans la classification des bugs, 82% de précision dans la prédiction des priorités et une réduction de 65% du temps de triage moyen pour leur système. Ce sont les résultats des auteurs eux-mêmes, non mesurés par PromptQuorum.
Le gain provient surtout d'une classification et d'un routage plus rapides plutôt que de corrections plus rapides. Les conventions de gravité diffèrent d'un projet à l'autre : la précision rapportée pour un système peut donc ne pas se transposer au vôtre ; faites un pilote sur votre propre backlog avant de vous y fier.
🔍 Le saviez-vous
Le gain de temps du triage par IA ne vient pas de corrections plus rapides, mais d'une classification et d'un routage plus rapides. Les ingénieurs passent moins de temps à débattre des priorités et davantage à résoudre les problèmes qui comptent.
Pourquoi la taille de la fenêtre de contexte détermine-t-elle la couverture de la base de code ?
La fenêtre de contexte d'un modèle détermine la quantité de code qu'il peut analyser simultanément — la différence entre réviser un seul fichier, un diff de PR complet ou un dépôt entier détermine quels bugs sont détectables.
Les modèles frontier du cloud offrent désormais des fenêtres de contexte d'environ 1M tokens, et les modèles open-weight comme Llama 4 Scout atteignent 10M tokens en local, sans qu'aucun code ne quitte votre infrastructure. Les chiffres en lignes de code sont des estimations à environ 10–13 tokens par ligne ; consultez la documentation de chaque éditeur pour connaître sa limite actuelle.
Classe de modèle | Fenêtre de contexte | Lignes de code (estimation) | Cas d'usage |
|---|---|---|---|
| Modèles frontier du cloud | Environ 1M tokens | ~75,000–100,000 lignes | Révision de PR sur un projet entier |
| Llama 4 Scout (local, Meta) | 10M tokens | ~750,000–1,000,000 lignes | Plus grand contexte, entièrement privé |
Comment les réglementations régionales affectent-elles la révision de code par IA ?
Les entreprises européennes qui envoient du code source à des API d'IA externes peuvent avoir besoin d'une analyse d'impact relative à la protection des données (AIPD) au titre de l'article 35 du RGPD avant le déploiement, en particulier lorsque le code ou les données qu'il touche impliquent le traitement de données personnelles. Le RGPD et le règlement européen sur l'IA peuvent s'appliquer en même temps à la révision de code assistée par IA lorsque des données personnelles sont traitées : impliquez donc votre délégué à la protection des données avant le déploiement. Ce sont des informations générales, pas un avis juridique ; confirmez les exigences auprès de votre délégué à la protection des données ou de votre conseil juridique.
Pour les équipes de l'UE, CodeRabbit propose un déploiement auto-hébergé dans son offre Enterprise (500+ sièges selon sa documentation), même si l'agent auto-hébergé envoie toujours les prompts et le code au fournisseur de LLM que vous configurez. Les modèles open-weight, dont ceux de Mistral AI (France), peuvent être exécutés en local via Ollama pour les équipes qui doivent garder leur code hors des clouds tiers.
Les équipes en Chine peuvent utiliser des modèles open-weight comme Qwen3 (Alibaba) et DeepSeek comme modèles de révision de code déployables en local ; tous deux prennent en charge les commentaires de code et la documentation en chinois, ce qui compte pour les bases de code multilingues. Les équipes au Japon soumises aux lignes directrices de gouvernance des données du METI peuvent exécuter en local, via Ollama, des workflows de révision basés sur Llama 4 Scout ou Llama 3.3 — Llama 4 Scout nécessite environ 55 GB de VRAM pour l'inférence — afin que le code n'atteigne pas d'API externes.
Lectures complémentaires
- Écrire un meilleur code avec l'IA — comment structurer des prompts de génération de code qui produisent un code facile à réviser
- Qu'est-ce que le prompt engineering ? — techniques fondamentales pour rédiger des instructions structurées pour l'IA
- Limites de l'IA — ce que les LLM ne savent pas faire — la raison architecturale pour laquelle la révision de code par IA produit des faux positifs et manque des bugs dépendants du contexte
- Chain-of-Thought Prompting — la technique de raisonnement utilisée pour suivre les chemins d'exécution et détecter les bugs de logique complexes
- Injection de prompt et sécurité — vulnérabilités de sécurité dans les workflows de développement assistés par IA, y compris la manipulation de la révision de code
- RAG expliqué — comment les outils qui indexent toute la base de code, comme Greptile, utilisent la récupération pour dépasser les limites de contexte des modèles
- Meilleurs LLM locaux pour la révision de code — alternatives locales pour la révision de code privé
- Meilleurs LLM locaux pour le code — Kimi K2.6, Qwen 3.6, Devstral classés pour les tâches de programmation
- Constrained Prompting — la technique derrière la consigne « ne commente PAS le style »
Comment utiliser l'IA pour la révision de code
- 1Présentez à l'IA l'architecture, les conventions de nommage et les contraintes de votre base de code avant de lui demander de réviser du code. Fournissez un court document de contexte : 'Ceci est une application Next.js. Nous utilisons le mode strict de TypeScript, aucun type `any`, tous les composants doivent avoir du JSDoc, tous les endpoints d'API doivent avoir une limitation de débit.' Sans cela, l'IA formule des commentaires génériques qui passent à côté des problèmes propres au projet.
- 2Demandez à l'IA de vérifier des catégories de bugs précises : sécurité, performance, logique, cohérence. Au lieu de 'révise ce code', demandez : 'Révise les vulnérabilités de sécurité (entrées, authentification, exposition de données), puis vérifie si ce motif correspond à notre gestion d'erreurs établie.' Des questions précises produisent des retours plus ciblés et plus utiles.
- 3Utilisez le prompting Chain-of-Thought (CoT) : demandez au modèle de suivre l'exécution avant de formuler ses retours. Pour les fonctions complexes, demandez 'Suis l'exécution pour l'entrée X, puis identifie les erreurs de logique.' Cela rend le raisonnement de l'IA transparent et permet de repérer des bugs subtils que les humains pourraient manquer.
- 4Utilisez la révision de code multi-modèles pour les changements à haut risque (authentification, paiements, infrastructure). Soumettez le même code à trois modèles de fournisseurs différents. Lorsque les trois signalent le même problème, c'est un signal fort. Lorsqu'un seul modèle détecte quelque chose, enquêtez avec soin.
- 5Traitez l'IA comme un filtre de premier passage, pas comme l'arbitre final. L'IA excelle à repérer les bugs évidents (retours manquants, types incompatibles, motifs d'injection SQL) mais peut manquer des problèmes propres au contexte (implications de performance, problèmes de passage à l'échelle, conventions d'équipe). Faites toujours relire par un humain les retours issus de l'IA.
Erreurs courantes dans la révision de code par IA
❌ Déployer la révision par IA avec les paramètres par défaut et sans personnaliser les prompts.
Why it hurts: La révision par IA par défaut peut produire surtout des commentaires de style. Les développeurs se mettent à ignorer tous les commentaires. Les constats de sécurité critiques sont noyés.
Fix: Utilisez le framework de prompts en 5 parties. Excluez explicitement le style et le nommage. Limitez le périmètre à la logique, à la sécurité et à la performance.
❌ Utiliser la révision de code par IA comme unique niveau de relecture.
Why it hurts: Les relecteurs IA ont détecté 44–82% des bugs injectés dans le benchmark de juillet 2025 de Greptile — pas 100%. Les problèmes dépendants du contexte (implications de passage à l'échelle, conventions d'équipe, erreurs de logique métier) exigent un jugement humain.
Fix: L'IA est le filtre de premier passage. Les relecteurs humains se concentrent sur l'architecture, la logique métier et les bugs que l'IA manque.
❌ Réviser uniquement les diffs de PR sans contexte de la base de code.
Why it hurts: Les bugs causés par des interactions entre fichiers sont invisibles pour les outils qui ne voient que les lignes modifiées. Une modification de fonction qui casse un appelant dans un autre fichier ne sera pas détectée.
Fix: Consultez la documentation de chaque éditeur pour savoir quelle part du contexte du dépôt il utilise. Privilégiez les outils qui indexent tout le dépôt pour les changements à haut risque et réservez la révision centrée sur le diff aux PR à faible risque.
❌ Ne pas mesurer le taux d'action des développeurs sur les commentaires de l'IA.
Why it hurts: Sans suivre le pourcentage de commentaires de l'IA auxquels les développeurs donnent suite, vous ne pouvez pas savoir si l'outil apporte de la valeur ou du bruit. Les équipes supposent que la révision par IA fonctionne alors qu'elle peut déjà avoir échoué.
Fix: Suivez le taux d'action chaque mois. Sous 40%, resserrez le périmètre du prompt. Sous 20%, l'outil ne produit que du bruit — reconfigurez-le ou remplacez-le.
FAQ sur la révision de code par IA
Quel est l'outil de révision de code par IA le plus précis en 2026 ?
Aucun outil n'est le plus précis dans tous les tests. Lors d'un benchmark de juillet 2025 mené par Greptile sur 50 bugs issus de cinq dépôts open source, Greptile a détecté 82%, Cursor Bugbot 58%, GitHub Copilot 54% et CodeRabbit 44% (paramètres par défaut, offres hébergées). Comme Greptile vend l'un des outils testés et que des résultats indépendants peuvent différer, utilisez ces chiffres comme point de départ et menez un essai de deux semaines sur vos propres pull requests. Pour l'analyse de sécurité, Snyk Code est une catégorie à part : un scanner qui complète un relecteur de pull requests.
CodeRabbit vs Greptile : lequel choisir, et CodeRabbit vaut-il le coup ?
Choisissez Greptile si le taux de détection de bugs injectés le plus élevé est votre priorité et que vous pouvez budgéter par révision : il a détecté 82% contre 44% pour CodeRabbit lors du test de juillet 2025 mené par Greptile lui-même, et l'offre Pro n'a pas de frais par siège (crédits prépayés à $1 chacun ; une révision Base consomme 1 crédit). Choisissez CodeRabbit si vous préférez une tarification par siège ($24 par utilisateur et par mois sur Essentials avec facturation annuelle, $30 en facturation mensuelle) et des révisions gratuites sur les dépôts publics. Les deux proposent un essai de 14 jours et réservent l'auto-hébergement à l'offre Enterprise. L'intérêt de CodeRabbit dépend du volume : un prix par siège fixe est plus facile à prévoir pour les équipes qui ouvrent beaucoup de pull requests, tandis que les équipes à faible volume peuvent payer moins par révision.
CodeRabbit et Greptile sont-ils gratuits ?
En partie. CodeRabbit propose des révisions gratuites sur les dépôts publics ; les dépôts privés nécessitent une offre payante (Essentials à partir de $24 par utilisateur et par mois en facturation annuelle) avec un essai de 14 jours. Greptile Starter est gratuit pour un développeur actif avec 50 crédits par mois ; Pro utilise des crédits prépayés à $1 chacun avec un essai de 14 jours, et les projets open source non commerciaux éligibles peuvent demander un accès gratuit.
Greptile prend-il en charge Bitbucket ?
La page tarifaire de Greptile cite Bitbucket Data Center parmi les plateformes des déploiements Enterprise auto-hébergés, aux côtés de GitHub Enterprise, GitLab Self-Managed et Gitea. Elle ne mentionne pas explicitement Bitbucket Cloud et les sources tierces ne sont pas d'accord entre elles : confirmez donc la prise en charge de Bitbucket Cloud auprès de Greptile avant de vous engager. Qodo (logos GitHub, GitLab, Bitbucket et Azure sur sa page tarifaire) et Cursor Bugbot (GitHub, GitLab, Bitbucket et Azure DevOps Services, selon la documentation de Cursor) indiquent prendre en charge Bitbucket.
Quelles sont les meilleures alternatives à Greptile ?
Les alternatives les plus proches sont CodeRabbit, Qodo, Cursor Bugbot, GitHub Copilot code review et Graphite Agent (Cursor a annoncé le rachat de Graphite le 19 décembre 2025). Lors du test de juillet 2025 mené par Greptile, Bugbot a détecté 58%, Copilot 54% et CodeRabbit 44% ; Qodo n'a pas été testé. Choisissez selon la plateforme Git (Bitbucket : Qodo ou Bugbot), selon le modèle tarifaire (sièges, crédits ou usage) et selon le déploiement (l'auto-hébergement est une fonctionnalité Enterprise chez CodeRabbit, Greptile et Qodo).
Quels outils de révision de code par IA proposent l'auto-hébergement ou un déploiement on-prem, et puis-je utiliser ma propre clé LLM ?
CodeRabbit (offre Enterprise ; sa documentation indique qu'elle est proposée aux clients de 500+ sièges et qu'elle prend en charge GitHub Enterprise Server, GitLab auto-hébergé, Azure DevOps et Bitbucket Data Center), Greptile (Enterprise) et Qodo (Enterprise : SaaS mono-locataire, sur site et isolé du réseau) documentent l'auto-hébergement. CodeRabbit auto-hébergé envoie toujours les prompts et le code source au fournisseur de LLM que vous configurez, et sa documentation indique que vous pouvez connecter votre propre fournisseur ou compte LLM. La CLI de CodeRabbit révise les modifications locales avant une pull request, mais s'authentifie auprès du backend de CodeRabbit. Pour un code qui ne doit jamais quitter votre infrastructure, exécutez un modèle open-weight en local.
Snyk est-il un outil de révision de code par IA ?
Snyk Code est un scanner de sécurité assisté par IA qui analyse le code dans l'IDE, les pull requests et la CI. La page des offres de Snyk mentionne l'analyse en temps réel et les intégrations avec les gestionnaires de code source, mais ni résumés de pull requests par IA ni révision de code générale. L'offre Free couvre 100 tests Snyk Code par mois, Team démarre à $25 par mois pour un maximum de 10 développeurs, et Enterprise fonctionne par crédits. Associez-le à un relecteur de pull requests comme CodeRabbit ou Greptile ; SonarQube relève lui aussi principalement de l'analyse statique à base de règles plutôt que d'un relecteur LLM.
Dans quelle mesure la révision de code par IA réduit-elle le temps de révision ?
Un guide sectoriel tiers (DigitalApplied, 2025) indique 40% de temps de révision en moins et 62% de bugs en production en moins ; PromptQuorum n'a pas mesuré ces chiffres. Dans l'article de Khaleefulla et al. (IJERT), les auteurs rapportent une réduction de 65% du temps de triage moyen pour leur système de triage par IA. Quel que soit l'outil, mesurez avant et après l'ajustement du périmètre du prompt la part de commentaires de l'IA auxquels vos développeurs donnent suite.
Comment la révision de code par IA se compare-t-elle à l'analyse statique traditionnelle (SAST) ?
Le SAST à base de règles applique des signatures de vulnérabilités fixes et tend à produire de nombreux faux positifs, tandis que les outils assistés par IA ajoutent un raisonnement contextuel : ils évaluent l'interaction entre les chemins de code au lieu de comparer le code à des signatures. Dans une comparaison tierce de 2025, Snyk Code, Semgrep Enterprise et CodeQL ont obtenu 84–92/100 sur du code généré par IA (non mesuré par PromptQuorum). Les deux approches sont complémentaires.
La révision de code par IA est-elle conforme au RGPD pour les équipes européennes ?
Pas automatiquement. L'envoi à des API d'IA externes de code source qui touche au traitement de données personnelles peut nécessiter une analyse d'impact relative à la protection des données (AIPD) au titre de l'article 35 du RGPD ; consultez votre délégué à la protection des données. Le RGPD et le règlement européen sur l'IA peuvent s'appliquer en même temps. Pour des exigences strictes, utilisez l'auto-hébergement (CodeRabbit Enterprise, proposé aux clients de 500+ sièges, envoie toujours le code au fournisseur de LLM que vous configurez) ou exécutez des modèles open-weight en local via Ollama afin qu'aucun code ne quitte votre infrastructure.
Le prompting Chain-of-Thought améliore-t-il la qualité de la révision de code par IA ?
Oui — pour une logique complexe comportant plusieurs branches conditionnelles, le prompting Chain-of-Thought (CoT) demande au modèle de suivre le flux de données dans chaque chemin d'exécution avant de formuler ses constats. Cela fait ressortir des bugs de logique que la simple reconnaissance de motifs manque, car le modèle doit modéliser explicitement chaque chemin qu'une valeur nulle ou un type d'entrée inattendu peut emprunter dans la fonction — au lieu de comparer le code à des modèles d'erreurs courantes. Le CoT est surtout utile pour les fonctions sensibles du point de vue de la sécurité et pour la gestion d'état complexe ; il ajoute de la latence et n'est pas nécessaire pour de simples fonctions utilitaires.
Quelle part des commentaires de révision de code par IA est réellement utile ?
Nous n'avons pas pu confirmer de chiffre public vérifié, et cette part varie selon l'outil, le prompt et la base de code : mesurez-la donc, en comptant sur un mois la part des commentaires de l'IA auxquels vos développeurs donnent suite. Si la plupart des commentaires sont ignorés, resserrez le périmètre — excluez explicitement les commentaires de style et demandez uniquement des constats de logique, de sécurité et de performance — puis mesurez à nouveau.
Quel modèle d'IA est le meilleur pour la révision de code ?
Il n'existe pas de meilleur modèle unique. Soumettez le même changement à haut risque à deux ou trois modèles de fournisseurs différents et considérez les problèmes signalés par plus d'un modèle comme très fiables. Les modèles diffèrent par la fenêtre de contexte (les modèles frontier du cloud offrent environ 1M tokens, soit à peu près 75,000–100,000 lignes de code ; Llama 4 Scout prend en charge 10M tokens en local), par leur capacité à respecter une consigne de périmètre et par le coût par révision. Testez les candidats sur vos propres anciennes pull requests contenant des bugs connus avant de standardiser.
Comment réduire les faux positifs dans la révision de code par IA ?
Trois techniques : (1) délimiter explicitement le prompt — « révise uniquement les bugs de logique, les failles de sécurité et les régressions de performance ; ne commente PAS le style ni le nommage » ; (2) ajouter une consigne anti-bruit — « si tu ne trouves rien dans une catégorie, écris Aucun problème trouvé, n'ajoute pas de commentaires de remplissage » ; (3) utiliser le Chain-of-Thought pour les fonctions complexes — demander au modèle de suivre les chemins d'exécution avant de produire ses constats. Suivez la part de commentaires auxquels les développeurs donnent suite et resserrez le périmètre si elle tombe sous 40%.
Comment intégrer la révision de code par IA à notre pipeline CI/CD ?
La plupart des outils s'installent comme une application ou un bot GitHub ou GitLab qui révise automatiquement chaque pull request ; la prise en charge des plateformes varie, consultez donc le tableau comparatif ci-dessus. Exécutez la révision par IA en parallèle des autres vérifications (lint, tests unitaires) et ne bloquez les merges que pour les constats de sécurité critiques, en laissant les autres constats sous forme de commentaires consultatifs à la discrétion des développeurs.
La révision de code par IA peut-elle détecter les failles de sécurité mieux que les outils SAST dédiés ?
Dans les comparaisons tierces, les outils SAST assistés par IA (Snyk Code, Semgrep Enterprise, CodeQL) ont obtenu 84–92/100 sur du code généré par IA dans une comparaison tierce de 2025 (non mesuré par PromptQuorum), et l'analyse statique à base de règles reste utile comme barrière de merge rapide. Le SAST traditionnel reste plus rapide pour vérifier en volume de grandes bases de code, car l'IA demande plus de calcul par PR. Bonne pratique : utilisez un SAST léger et du lint pour la rapidité, et complétez par une révision par IA pour l'analyse de sécurité approfondie des changements à haut risque (authentification, paiements, infrastructure).
Puis-je exécuter la révision de code par IA en local pour un code entièrement privé ?
Oui. Devstral Small 24B (Mistral AI, 16 GB de RAM) et Llama 4 Scout (~55 GB de VRAM, contexte de 10M) fonctionnent entièrement sur site via Ollama. L'inférence s'exécute sur votre matériel : le code n'est donc pas envoyé à un relecteur cloud ; cela peut supprimer l'étape de traitement par un tiers qu'une AIPD devrait sinon couvrir, mais vérifiez avec votre équipe sécurité le comportement de téléchargement et de mise à jour des modèles. La qualité est inférieure à celle des modèles frontier du cloud pour l'analyse de sécurité complexe, mais suffisante pour la plupart des révisions au niveau des PR.
Quel est le meilleur outil de révision de code par IA pour les petites équipes (moins de 10 développeurs) ?
GitHub Copilot Code Review est l'option la plus simple à adopter si votre équipe paie déjà une offre Copilot qui l'inclut (Pro, Pro+, Max, Business ou Enterprise) ; l'usage est facturé en crédits d'IA. CodeRabbit révise gratuitement les dépôts publics, Greptile Starter est gratuit pour un développeur actif, Snyk Code Free couvre 100 tests par mois, et Qodo propose un essai de 14 jours mais pas d'offre gratuite permanente. Promptfoo (gratuit, open source) peut automatiser des assertions de révision de code dans la CI/CD. Pour les équipes de moins de 10 personnes, évitez de souscrire des offres annuelles tant que le volume de révisions ne justifie pas le coût.
Sources et lectures complémentaires
- Greptile, 2025. "AI code review bug catch benchmark" — évaluation réalisée par l'éditeur de cinq outils sur 50 bugs injectés issus de cinq dépôts open source (juillet 2025) ; source des taux de détection de 82% / 58% / 54% / 44%
- Tarifs de CodeRabbit — offres, prix par utilisateur, révisions gratuites sur les dépôts publics
- Documentation d'auto-hébergement de CodeRabbit — auto-hébergement Enterprise, plateformes prises en charge, offre à partir de 500+ sièges, option de fournisseur LLM personnel
- Documentation de la CLI CodeRabbit — révision locale des modifications non commitées
- Tarifs de Greptile — Starter, crédits Pro, auto-hébergement Enterprise, plateformes prises en charge
- Tarifs de Qodo — offres Pro Team et Enterprise, essai, options sur site
- Offres Snyk — limites de Snyk Code Free, Team et Enterprise
- Documentation de Cursor Bugbot — facturation à l'usage et plateformes Git prises en charge
- GitHub Docs : Copilot code review — offres incluant la révision de code et facturation en crédits d'IA
- Graphite, 2025. "Effective prompt engineering for AI code reviews" — guide technique sur les prompts ciblés pour réduire les faux positifs et améliorer le signal
- Sanjay, 2025. "Best AI Code Security Tools 2025: Snyk vs Semgrep vs CodeQL" — benchmark tiers de trois outils SAST sur du code généré par IA (source des scores 92 / 87 / 84)
- Khaleefulla, Sudeep et Savithri. "Automated Bug Categorization and Task Assignment System Using Artificial Intelligence" (IJERT) — résultats des auteurs eux-mêmes : plus de 85% de précision de classification, 82% de précision de priorité, temps de triage réduit de 65%
- DigitalApplied, 2025. "AI Code Review Automation: Complete Guide" — chiffres sectoriels : 40% de temps gagné, 62% de bugs en production en moins
- Remarque : les taux de détection sont ceux annoncés par les éditeurs et n'ont pas été mesurés par PromptQuorum ; les prix sont les prix catalogue des pages d'éditeurs ci-dessus. La révision de code par IA est un marché en évolution rapide — vérifiez les tarifs et la prise en charge des plateformes actuels sur les sites des éditeurs avant tout achat.