重要なポイント
- Q4_K_M 量化:Llama 3.3 70B は ~40GB RAM が必要。Qwen3 72B は ~43GB RAM が必要です。
- 最も安価な新品ハードウェア:Apple Mac mini M5 Pro(64GB、$1,699、2026年9月22日発売)は70B向けの最も安価な新品フルGPUオプションです。基本モデルのMac mini M6($899)は最大32GBまでで、70Bモデルは実行できません。
- 最も容易なコンシューマーハードウェア:Apple Mac Studio M2 Ultra(64GB統合メモリ)または M5 Max MacBook Pro(64GB)-- 完全GPU加速、レイヤーオフロード不要。
- NVIDIA オプション:RTX 4090(24GB VRAM)+ 32GB システムRAM、Ollama のレイヤーオフロード機能で大ほどんどの70Bモデルに対応、ただし20~30%のレイヤーはCPU上で実行。
- CPU専用70B:64GB RAMで可能ですが、1~3 tok/sec 生成 -- バッチタスクではかろうじて使用可能、対話的チャットには不適切。
- 2026年8月時点でも、ローカル70Bモデルは GPT-4(2023年)の品質に相当し、クラウドコストなしでそのクオリティティア に到達できる唯一のコンシューマーアクセス可能なパスです。
📍 一文で説明
ローカルで70Bパラメータモデルを実行するには、Q4_K_M量子化で40〜48GBのRAMが必要で、64GB統合メモリを持つApple Silicon Mac、64GB DDR5を搭載したワークステーション、またはレイヤーオフロードを使用した24GB NVIDIA GPUと32GBシステムRAMの組み合わせで実現可能です。
💬 簡潔に説明
70Bモデルは自宅で現実的に動かせる中でも最大級のサイズで、大量のメモリ(約40〜48GB)が必要です。最も簡単な方法は、CPUとGPUでメモリを共有できる十分な統合メモリを持つMacを使うことです。PCの場合、通常は大きなグラフィックカードに加えて、カードに収まらない部分をオフロードするための追加のシステムRAMが必要になります。
70B ローカルLLM を実際に実行できるハードウェアとは
Q4_K_M 量化の70Bモデルは、推論エンジンがアクセス可能なメモリ約40~43GBが必要です。 これはGPU VRAM、統合システムメモリ(Apple Silicon)、システムRAM、またはレイヤーオフロード経由の組み合わせから提供できます。
ハードウェア | 70B実行可能? | 速度(70B Q4) | 注釈 |
|---|---|---|---|
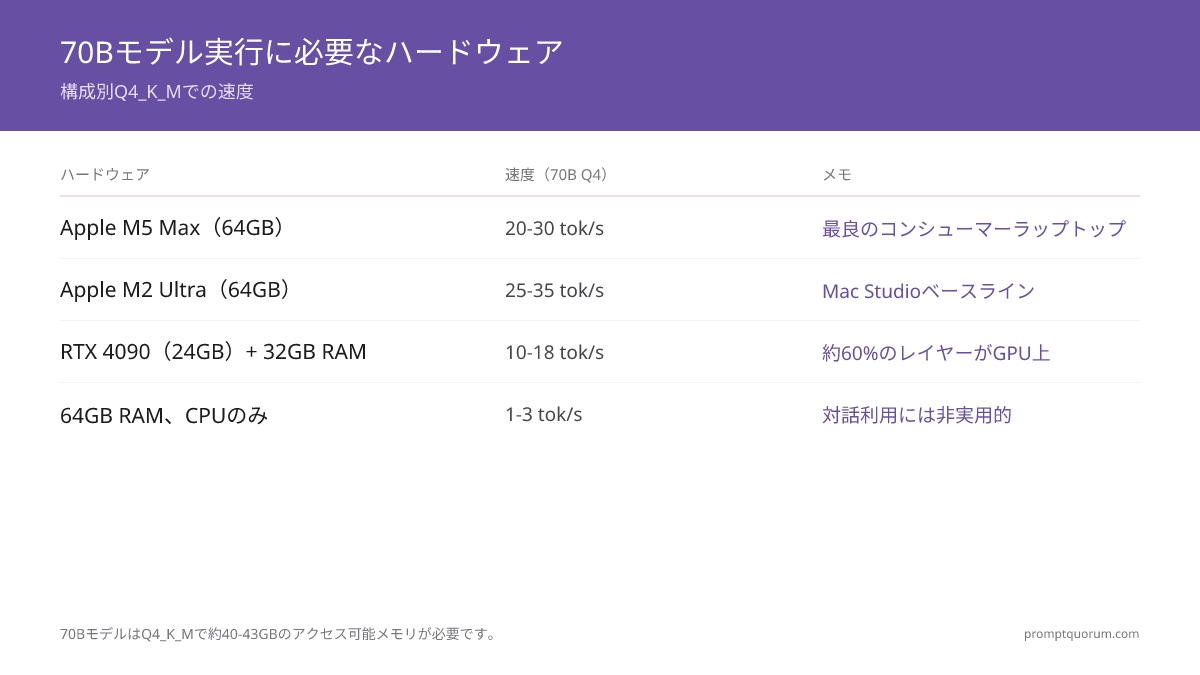
| Apple M5 Max(64GB統合) | はい -- フルGPU | 20~30 tok/sec | 最高のコンシューマーノートパック オプション |
| Apple Mac mini M5 Pro(64GB) | はい -- フルGPU | ベンチマーク未実施 | 新発売、2026年9月22日、$1,699 -- 最も安価な新品オプション |
| Apple Mac mini M6(最大32GB) | いいえ -- 最大32GB | 実行不可 | 新発売、2026年9月22日、$899 -- 70Bにはメモリ不足 |
| Apple M2 Ultra(64GB統合) | はい -- フルGPU | 25~35 tok/sec | Mac Studio ベースラインconfig |
| Apple M2 Ultra(192GB統合) | はい -- フルGPU | 30~40 tok/sec | Q8_0を実行でき余裕がある |
| NVIDIA RTX 4090(24GB)+ 32GB RAM | はい -- オフロード使用 | 10~18 tok/sec | ~60% のレイヤーはGPU上、~40% はCPU上 |
| NVIDIA RTX 4080(16GB)+ 32GB RAM | 部分的オフロードのみ | 5~10 tok/sec | ~35% のレイヤーのみGPU上 |
| 64GB RAM、CPU専用 | はい -- CPU専用 | 1~3 tok/sec | 対話的使用には不実用的 |
注意点:量化レベルを理解する
Q4_K_M 量化を使用してください -- これはほとんどのコンシューマーハードウェアで最適です。 FP16 や Q8_0 のような高い精度が必要な場合、より多くの RAM が必要になります。
量化レベル:FP16(140GB)> Q8_0(70GB)> Q5_K_M(50GB)> Q4_K_M(40GB)> Q3_K_S(30GB)
より低い量化(Q3_K_S、Q2_K)は品質の喪失が大きくなります。特に数学的推論とコード生成では著しい低下が見られます。
各量化レベルで70Bモデルには どれだけの RAM が必要ですか?
量化 | RAM 必要量 | 品質 | 実用的? |
|---|---|---|---|
| FP16(フル精度) | ~140GB | 参照品質 | いいえ -- サーバー専用 |
| Q8_0 | ~70GB | ほぼ無損失 | Mac Ultra 192GB のみ |
| Q5_K_M | ~50GB | 最小限の喪失 | Mac Ultra 64GB、逼迫状態 |
| Q4_K_M | ~40~43GB | 低喪失 -- 推奨 | はい -- 最も実用的なオプション |
| Q3_K_S | ~30GB | 適度な喪失 | はい -- 32GB マシン可能 |
| Q2_K | ~22GB | 高い喪失 | 推奨されない |
Apple Silicon が70Bモデルのための最高のコンシューマーオプションである理由
Apple Silicon は統合メモリを使用します -- CPU と GPU は同じ物理メモリプールを共有します。 64GB の統合メモリを持つ M5 Max MacBook Pro は、70Bモデルを Q4_K_M で完全にGPU上で実行し、20~30 tok/sec を達成でき、レイヤーオフロードのオーバーヘッドがありません。
NVIDIA ハードウェアでは、GPU とシステムRAMは分離しています。24GB VRAM の GPU は Q4_K_M 70B モデルの約60%しか保持できません。残りのレイヤーはCPU上で実行され、メモリ帯域幅のボトルネックが生じ、速度が 10~18 tok/sec に低下します。
2026年8月時点でも、中古 Mac Studio M2 Ultra(64GB、約2,000ドル)が引き続き使用可能な速度での70Bローカル推論への最も安価な中古パスです。Appleは2026年8月にM5 MaxとM5 Ultraチップを搭載した新しいMac Studioラインナップを発表しました:新しいMac Studio M5 Max(64GB、$2,499)は完全GPUの新品オプションであり、Mac Studio M5 Ultra(256GBまたは512GB、$5,499から)は統合メモリ帯域幅を1.2TB/秒に倍増させ、70BモデルをQ8_0またはFP16で品質を落とさず余裕を持って実行できます。
Appleは2026年8月25日にMac miniを刷新し、2026年9月22日に発売され、これにより再び最も安価な新品オプションが変わります。 Mac mini M5 Pro($1,699から)は最大64GB統合メモリ、307GB/秒帯域幅、Thunderbolt 5に対応 -- 70BモデルをQ4_K_Mで完全にGPU上で実行するのに十分で、Mac Studio M5 Maxより$800安価です。一方、基本モデルのMac mini M6($899から)は別物です:最大32GB統合メモリ、170GB/秒帯域幅までで、70Bモデルに必要な40GB以上には遠く及ばないため、どの量化レベルでも70Bモデルを実行できません。両チップともまだ独立したベンチマークは存在せず、2026年9月22日に発売予定です。
実践Tips:Apple Silicon で70Bを選ぶ場合
- 64GB は下限です。複数のモデルやタブを開く場合は、より多いメモリを考慮してください。
- 192GB M2 Ultra や新しい256GB以上のM5 Ultraは Q8_0 で動作でき、最高品質が必要な場合に理想的です。
- メモリ帯域幅は Apple Silicon で優れているため、複数のモデルをシーケンシャルロードしても速度低下がほとんどありません。
NVIDIA DGX Spark:70Bモデル向けの128GB統合メモリ
NVIDIA DGX Spark($4,699)は2025年10月に発売されたコンパクトなデスクトップAIコンピューターで、128GBのLPDDR5x統合メモリを備えたGB10 Grace Blackwell Superchipをベースにしています。 統合メモリアーキテクチャにより、GPUとCPUは同じ128GBプールを共有します -- Apple Siliconに似ていますが、CUDAアクセラレーションを備えています。
128GB統合メモリにより、DGX SparkはQ8_0(70GB -- ほぼ無損失品質)でLlama 3.3 70BとQwen3 72Bを実行します。Q8_0での70B推論速度は約18~28 tok/secです。
NVIDIAは2026年2月、メモリ供給の制約を理由にDGX Spark Founders Editionの価格を$3,999から$4,699に引き上げました -- これはRTX 50シリーズGPUの価格も定価を大きく上回らせた、同じDRAM不足によるものです。
仕様 | 値 |
|---|---|
| メモリ | 128GB統合LPDDR5x |
| Q8_0での70B | 可能 -- ほぼ無損失品質 |
| 70B推論速度 | 18~28 tok/sec |
| 最大モデルサイズ | FP4で約200Bパラメータ |
| 価格 | $4,699(NVIDIA直販 / Amazon) |
| Ollamaコマンド | ollama run llama3.3:70b |
NVIDIA GPU + レイヤーオフロードはどのように70Bモデルで機能しますか?
Ollama と llama.cpp はモデルを GPU VRAM とシステムRAM に分割することをサポートします。VRAM に読み込まれたレイヤーは GPU 速度で実行され、システムRAM のレイヤーは CPU 速度で実行されます:
# Ollama は自動的に VRAM に収まるだけ多くのレイヤーをオフロードします
# レイヤーを明示的に制御するには:
ollama run llama3.3:70b

# GPU上にあるレイヤー数を確認:
ollama ps
# 出力は以下を示します:llama3.3:70b  ...  23/80 GPU layers

# llama.cpp 直接:
./llama-cli -m llama-3.3-70b-q4_k_m.gguf \
  -ngl 40   # オフロードするレイヤー数
  --ctx-size 4096
注意点:レイヤーオフロード設定
- デフォルトでは、Ollama はモデルが VRAM に完全に適合しない場合、CPU 専用推論にフォールバックします。これは遅くなります。
- OLLAMA_GPU_LAYERS=999 を設定して、VRAM に収まるだけ多くのレイヤーをオフロードします。
- llama.cpp では -ngl フラグを使用して、オフロードするレイヤー数を指定します。実験を通じて最適な設定を見つけてください。
- CPU + GPU のハイブリッド実行は、完全な GPU 実行よりも 30~50% 遅くなります。これを心に留めておいてください。
CPU 専用70B推論は実用的ですか?
ハイコアカウント CPU(AMD Threadripper、Intel Xeon)を備えた 64GB RAM 上の 70B モデルは 1~3 トークン/秒 を生成します。 2 tok/sec では、200語の応答は約75秒かかります。
これは対話的チャットには不実用的ですが、バッチ処理(文書の要約、レポート生成、ファイルの一晩処理)には使用可能です。対話的な使用には、8+ tok/sec を実現できるマシン、つまり Apple Silicon または NVIDIA GPU オフロードが最小限の実用的なハードウェアが必要です。
実践Tips:ハードウェア選定ガイド
- 予算が ¥370,000 未満の場合:中古 Mac Studio M2 Ultra(64GB)を探してください。
- 予算が ¥520,000 の場合:新しい M5 Max MacBook Pro(64GB)を検討してください。ポータビリティが必要な場合。
- 予算が ¥600,000 の場合:RTX 4090(中古)+ 良質なワークステーションビルドは可能ですが、Apple と比較して遅い(10~18 vs 25+ tok/sec)。
- 複数のモデルを並行実行する予定の場合:Apple Silicon(統合メモリ)の方が優れています。レイヤーオフロードは複雑になります。
どの70B モデルをローカルで実行すべきですか?
モデル | MMLU | HumanEval | 最適用途 |
|---|---|---|---|
| Llama 3.3 70B | 82% | 88% | 一般英語タスク、指示遵行 |
| Qwen3 72B | 84% | 87% | コーディング、多言語(29言語) |
| Mistral Large 123B | 84% | 80% | 80GB以上が必要 -- ワークステーション専用 |
コンシューマーハードウェアで70Bモデルを実行する場合の一般的な過ちは何ですか?
24GB未満の VRAM を備えた GPU を購入し、完全な70B パフォーマンスを期待する
RTX 4070 Ti(12GB VRAM)は Q4_K_M 70B モデルの約30% しか VRAM に保持できません。残りの70% は CPU 上で実行され、3~5 tok/sec という結果が得られます -- CPU 専用推論ほぼ並のレベルです。70B モデルの場合、24GB VRAM(RTX 4090)が有用な GPU 加速の実用的な最小値です。これ以下の場合は、代わりに 34B モデルの実行を検討してください。
Ollama でレイヤーオフロードを使用しない
デフォルトでは、70B モデルが VRAM に完全に適合しない場合、Ollama は CPU 専用推論にフォールバックします。GPU レイヤーを OLLAMA_GPU_LAYERS=999 で明示的に設定してください -- Ollama は VRAM に収まるだけ多くのレイヤーをオフロードし、残りを CPU で実行します。これは完全な CPU 推論よりもはるかに高速です。
Q4_K_M を使用すべき時に Q3_K_S を使用できた
32~40GB RAM のマシンでは、70B モデルの Q4_K_M は厳しすぎる可能性があります(OS 用に十分なヘッドルームがありません)。Q3_K_S は RAM を ~30GB に削減し、品質をやや失います。モデルをロードした後、ollama ps を実行してください -- スワップ使用が表示される場合は、Q3_K_S にドロップしてください。
基本モデルのMac mini M6を購入し、70Bモデルが実行できると期待する
Mac mini M6($899)は最大32GB統合メモリまでで、Q4_K_M量化の70Bモデルに必要な40GB以上には遠く及びません。どの量化レベルでも70Bモデルを実行できません。Mac miniで70Bを実行するには、Mac mini M5 Pro($1,699、64GB統合メモリ)が必要なグレードです -- 購入前に「M5 Pro」と64GBを確認し、基本のM6ではないことを確認してください。
コンシューマーハードウェアで70Bモデルを実行することについてのよくある質問
70Bモデルを実用的に実行できる最も安いハードウェアは何ですか?
Mac mini M5 Pro($1,699、64GB統合メモリ、2026年9月22日発売)は、これまで最も安価だった新品オプション、Mac Studio M5 Max(64GB、$2,499)より$800安い、最も安価な新品の70B対応ハードウェアになる見込みです。中古 Mac Studio M2 Ultra(64GB 統合メモリ)(約2,000ドル)は実績のある25+ tok/secでの、引き続き最も安い中古パスです。Mac mini M5 Proについては独立したベンチマークはまだありません。NVIDIA RTX 4090 デスクトップビルド(24GB VRAM + 32GB RAM)は3,000~4,000ドルかかりますが、レイヤーオフロードのため推論が遅くなります。Mac mini M5 Proと基本モデルのMac mini M6($899)を混同しないでください -- M6は最大32GB統合メモリまでで、70Bモデルを実行できません。
Mac mini M6 は70Bモデルを実行できますか?
いいえ。Mac mini M6($899から)は最大32GB統合メモリと170GB/秒の帯域幅までで、Q4_K_M量化の70Bモデルに必要な40GB以上には遠く及びません。Mac miniで70Bを実行するには、代わりにMac mini M5 Pro($1,699から、64GB統合メモリ、307GB/秒帯域幅、Thunderbolt 5)を注文してください。両機種とも2026年9月22日発売で、いずれのチップについても独立したベンチマークはまだ存在しません。
2つの GPU で70Bモデルを実行できますか?
はい -- llama.cpp と Ollama は NVIDIA ハードウェアでマルチ GPU 推論をサポートしています。2つの RTX 4090s(合計48GB VRAM)は Q4_K_M 70B モデルを完全に VRAM に適合させることができます。Ollama は複数の GPU が存在する場合、自動的にマルチ GPU 処理を行います。llama.cpp では tensor parallelism(--tensor-split)がレイヤーをどのように分配するかを制御します。
70B ローカル品質は GPT-5.5 とどう比較されますか?
MMLU と HumanEval ベンチマークでは、Llama 3.3 70B(82%, 88%)と Qwen3 72B(84%, 87%)は GPT-4(2023年)スコアに一致またはやや上回ります。GPT-5.5(2024年)は推論が多いタスクではより高いスコアを示します。一般的な指示遵行、要約、コード生成では、70B ローカルモデルはほとんどのタスクで GPT-5.5 と同等です。
Ollama は70Bモデルを自動的に実行できますか?
はい。ollama run llama3.3:70b を実行すると、自動 GPU レイヤーオフロード機能でモデルをダウンロードして実行します。Ollama は利用可能な VRAM とシステムRAM を検出し、GPU にできるだけ多くのレイヤーをオフロードして、残りを CPU で実行します。基本的な使用には手動設定が不要です。
70Bモデルを実行するのに どれだけの電力を使用しますか?
Mac Studio M2 Ultra が 70B 推論を実行している場合、約 30~50 W を消費します。NVIDIA RTX 4090 デスクトップは負荷時に 350~450 W を消費します。¥25/kWh で、RTX 4090 での継続的な 70B 推論の電力コストは時間あたり約 ¥7.5~10.5 です。Apple Silicon はこのワークロードで 7~10 倍エネルギー効率が優れています。
70Bモデルは日常的なタスクに対して13Bモデルの価値があるのですか?
複雑な推論、長いドキュメント分析、微妙な作成には、はい -- 品質の違いは目立ちます。単純な要約、Q&A、分類では、13B または 7B モデルでも実質的に同じ出力を生成します。70B ハードウェアに投資する前に、PromptQuorum で両方を特定のユースケースで実行して、品質差を量化してください。
日本語で70Bモデルを使用する場合、どのモデルが推奨されますか?
Qwen3 72B は日本語を含む29言語にネイティブに対応しており、70B クラスでの最適な選択肢です。Llama 3.3 70B は日本語をサポートしていますが、英語にはやや劣ります。日本語はトークン化が英語より多くのトークンを必要とします -- 同じコンテンツでも日本語の方が多くのトークンを消費します。
日本で組織として70Bモデルを使用する場合、法的な制限はありますか?
2026年8月時点でも、個人使用向けのオープンウェイト LLM(Llama、Qwen など)に対する直接的な METI 規制はありません。ただし、組織として機密データを処理する場合は、データ保護とプライバシー要件を確認してください。日本国内のデータ保護については、デジタル庁のガイドラインと個人情報保護法(APPI)を参照してください。
Ollama をインストールして70Bモデルを実行する最初のステップは何ですか?
ollama.com/download から Ollama をダウンロードしてインストールしてください。その後、ollama run llama3.3:70b を実行してください。Ollama はモデルをダウンロードし、自動 GPU レイヤーオフロードでそれを実行します。初回ダウンロードは 15~30 分かかる可能性があります(モデルサイズと接続速度による)。ollama ps でステータスを確認してください。
Apple SiliconとNVIDIA GPUで70Bモデルを実行する場合、なぜ速度に違いがあるのですか?
Apple Siliconは統合メモリを使用します。CPU と GPU は同じ物理メモリプールを共有するため、メモリ帯域幅の制限がありません。NVIDIA GPUは独立したVRAMを持つため、24GBのVRAMには70Bモデルの約60%しか格納できず、残りのレイヤーはCPU上で実行され、メモリ帯域幅のボトルネックが生じます。
RTX 4090で70Bモデルを完全に実行できますか?
直接ではありません。RTX 4090は24GB VRAMで、Q4_K_Mで量化された70Bモデルには約40~43GBが必要です。Ollamaまたはllama.cppのレイヤーオフロード機能を使用して、約60%のレイヤーをGPU上で実行し、残りの40%をシステムRAM上で実行できます。これにより10~18 tok/secが得られます。
「レイヤーオフロード」とは正確には何ですか?
レイヤーオフロード(層オフロード)は、LLMの計算レイヤーを GPU VRAM とシステムRAMに分割する手法です。VRAMに格納されたレイヤーはGPU速度で実行され、システムRAMのレイヤーはCPU速度で実行されます。Ollamaで自動的に処理されます:OLLAMA_GPU_LAYERS=999 を設定すると、VRAMに収まるだけ多くのレイヤーをオフロードします。
CPU専用で70Bモデルを実行することは実際に可能ですか?
はい、64GB RAMを備えたハイコアCPU(AMD Threadripper、Intel Xeon)では可能ですが、1~3 tok/secしか生成しません。200語の応答は約75秒かかります。バッチ処理(文書の要約、レポート生成)には使用できますが、対話的なチャットには不適切です。対話的な使用には最低8+ tok/secの処理速度が必要です。
70Bモデルの質は GPT-5.5 と比較してどうですか?
Llama 3.3 70B(MMLU 82%、HumanEval 88%)と Qwen3 72B(MMLU 84%、HumanEval 87%)は、ベンチマークスコアで GPT-4(2023年)を一致または僅かに上回ります。GPT-5.5(2024年)は推論の多い作業ではスコアが高くなりますが、一般的な指示遵行、要約、コード生成では、70Bのローカルモデルはほとんどのタスクで GPT-5.5 と同等です。
2026年8月時点での最も費用対効果の高い70B セットアップは何ですか?
2026年9月22日発売のMac mini M5 Pro(64GB統合メモリ、$1,699)は、これまで最も安価だった新品フルGPUオプション、Mac Studio M5 Max(64GB、$2,499)より$800安い、最も安価な新品70B対応ハードウェアになる見込みです。中古 Mac Studio M2 Ultra(64GB統合メモリ)で約2,000ドル、実績のある25+ tok/secで動作することは引き続き最も費用対効果の高い中古の選択肢です。Mac mini M5 Proについては独立したベンチマークはまだありません。NVIDIA RTX 4090デスクトップ構成(24GB VRAM + 32GB RAM)は3,000~4,000ドルかかりますが、レイヤーオフロードのため速度が低下します。Mac mini M5 Proと基本モデルのMac mini M6($899)を混同しないでください -- M6は最大32GB統合メモリまでで、70Bモデルを実行できません。
70Bモデルを実行する場合、電力消費はどのくらいですか?
Mac Studio M2 Ultra は70B推論で約30~50W消費します。NVIDIA RTX 4090 デスクトップは負荷時に350~450W消費します。1kWh あたり0.15ドルで、RTX 4090での継続的な70B推論は時間あたり約0.05~0.07ドルのコストがかかります。Apple Siliconはこのワークロードで7~10倍エネルギー効率が優れています。
日本で70Bモデルを実行する場合、METI規制を遵守する必要がありますか?
2026年8月時点でも、Open-Weight LLM(Llama 3.3、Qwen3など)の個人使用に対する直接的な METI 規制はありません。ただし、組織として機密データを処理する場合は、データ保護とプライバシー要件を確認してください。日本国内の機械学習規制については、デジタル庁のガイドラインを参照してください。
出典
- llama.cpp GPU オフロードドキュメント -- github.com/ggerganov/llama.cpp/blob/master/docs/backend/CUDA.md
- Ollama モデルライブラリ -- ollama.com/library/llama3.3
- Apple M5 Max 推論ベンチマーク -- github.com/ggerganov/llama.cpp/discussions(コミュニティベンチマークスレッド)
- Meta Llama 3.3 モデルカード -- huggingface.co/meta-llama/Llama-3.3-70B-Instruct
- NVIDIA RTX 4090 公式仕様 -- nvidia.com/en-us/geforce/graphics-cards/40-series/rtx-40-series