VRAM計算式
VRAM = 十億パラメータ × パラメータあたりバイト数 + KVキャッシュ + オーバーヘッド
パラメータあたりバイト数(Q4は実際のGGUFファイルと一致、他は計算による推定):Q4は約0.6バイト、Q5は約0.7バイト、Q8は約1.05バイト。
例:Llama-3.3 70B Q4 = 70 × 0.6 = 42 GB(実際のLlama-3.3-70B Q4_K_M GGUFは42.52 GB)
Q4: 理論値の0.5バイトではなく、実際のGGUFファイルサイズから算出すると約0.6バイト/パラメータ(Q4_K_Mなど実際の形式には若干のオーバーヘッドがある)。
Q8: 実際のGGUFファイルサイズから算出すると約1.05バイト/パラメータ、ほぼ完全精度。
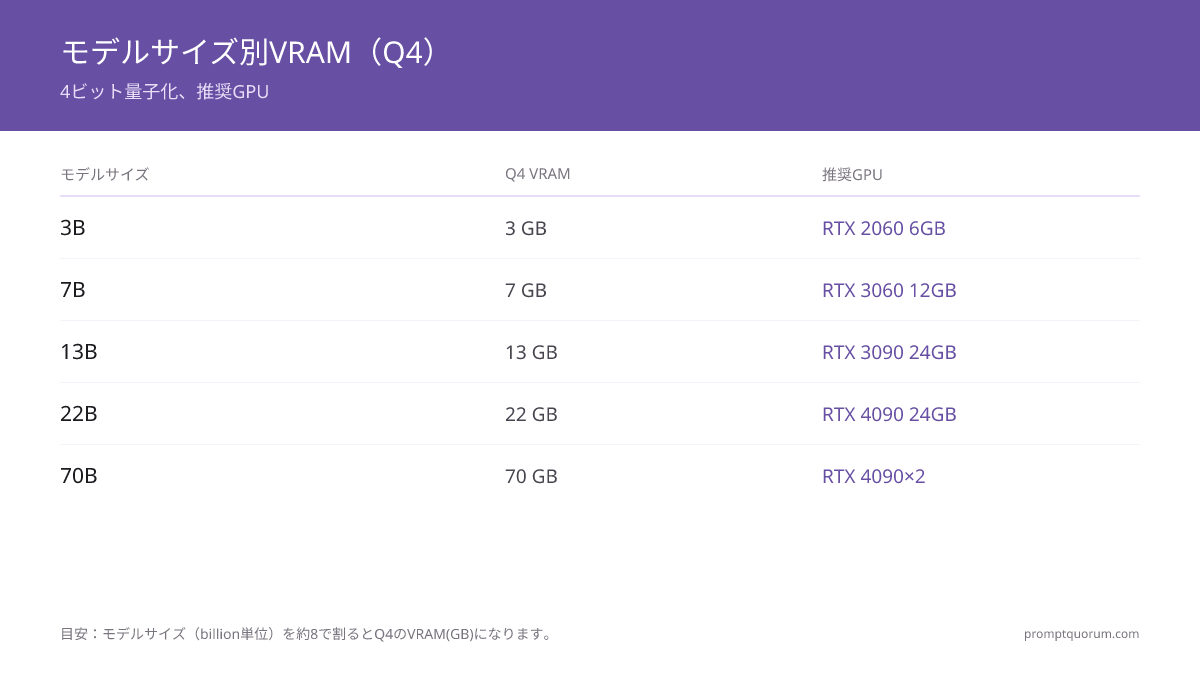
モデルサイズ別VRAM
モデルサイズ | FP32 | Q8 | Q5 | Q4 | 推奨GPU |
|---|---|---|---|---|---|
| 7B | 28 GB | 7 GB | 5 GB | 4 GB | RTX 4060 (8GB)、RTX 3060 (12GB) |
| 13B | 52 GB | 14 GB | 9 GB | 8 GB | RTX 3060 (12GB)、RTX 4070 (12GB) |
| 70B | 280 GB | 74 GB | 50 GB | 42 GB | デュアルRTX 4090 |
| Qwen 3.6 35B-A3B (3B有効 / 35B総パラメータ, MoE)* | ~140 GB | ~37 GB | ~25 GB | ~21 GB | RTX 5090 32 GB、またはRTX 4090/3090 24 GB(ぎりぎり、Q4) |
| DeepSeek-V4.1-Flash-1017 (763B総パラメータ, MoE)* | ~3.1 TB | ~800 GB | ~530 GB | ~460 GB | マルチGPUサーバー、または512 GBユニファイドメモリ(Q4のみ) |
| Llama 4 Scout (17B有効 / 109B総パラメータ, MoE)† | 436 GB | 114 GB | 76 GB | 55 GB | 2× RTX 4090 (48 GB) — 24 GBには1.78ビット時のみ収まる(参考値、PromptQuorumによる測定ではありません) |
| gpt-oss:20b (3.6B有効 / 21B総パラメータ, MoE)* | 84 GB | 22 GB | 15 GB | 12 GB | RTX 5070 12 GB または16 GBのGPU |
| Kimi K2.6 (32B有効 / 1T総パラメータ, MoE)* | ~4 TB | ~1 TB | ~700 GB | ~600 GB | マルチGPUサーバー(Q4で~600 GB) |
数値は重みのみのサイズです。Q4の数値は実際のGGUFファイルサイズ3件と一致し、他の量子化レベルとMoE行は計算による推定値です(例:Llama-2-7B Q4_K_M = 4.08 GB、Mistral-Small-24B Q4_K_M = 14.33 GB、Llama-3.3-70B Q4_K_M = 42.52 GB)。コンテキスト/KVキャッシュ用に1-2 GBの余裕を追加してください。* MoE行: 総パラメータから算出(Q4で10億あたり約0.6 GB)。すべてのエキスパートがメモリに常駐し、アクティブパラメータは速度にのみ影響します。数値は概算です。† Llama 4 Scoutは109Bパラメータすべてを常駐させるため、トークンあたり17Bしか有効でなくてもQ4で~55 GB必要です。 出典: Llama-2-7B GGUF, Mistral-Small-24B GGUF, Llama-3.3-70B GGUF.

量子化
量子化はモデル重みを低精度に圧縮します。Q4が標準。
VRAMはモデルサイズを決定しますが、プロンプトの設計が出力品質を決定します。Chain-of-ThoughtやFew-Shotプロンプティングなどのテクニックは、小さなモデルと大きなモデルの品質差を縮めることができます。お使いのハードウェアがサポートするモデルから最大限を引き出すには、プロンプトエンジニアリング完全ツールキットをご覧ください。VRAM が 12–16 GB あり、このツールキットを試す具体的なコーディングワークロードを探しているなら、GitHub Copilot をローカル LLM で置き換えるで Continue.dev + Ollama + Qwen3-Coder のスタックがちょうどこれらの VRAM 帯にフィットする様子を解説しています。

バッチサイズ
シングルユーザー推論はbatch=1です。
オーバーヘッド
KVキャッシュ、アクティベーション、ランタイムが追加メモリを消費。
地域的背景
日本 (METI): ローカルLLM推論は主権データ管理として重要。
一般的な間違い
VRAM ≠ モデルサイズ。常に5 GB以上の余地が必要。
VRAM計算機
モデルサイズと量子化を選択してVRAM要件を推定します。
人気モデル
ベースモデル
6.50 GB
コンテキストOH
1.50 GB
バッチOH
0.00 GB
システムOH
1.00 GB
最低VRAM
9.00 GB
推奨(25%安全マージン込み)
11.25 GB
👉 最低でも以下のVRAMを持つGPUを選択してください: 11.25 GB VRAM
対応GPU
RTX 3060 (12 GB)
0.8 GB余裕
RTX 4060 Ti (16 GB)
4.8 GB余裕
RTX 4070 Ti Super (16 GB)
4.8 GB余裕
RTX 4080 Super (16 GB)
4.8 GB余裕
RTX 4090 (24 GB)
12.8 GB余裕
RTX 5090 (32 GB)
20.8 GB余裕
Mac Mini M6 (32 GB) (−8 GB macOS = 24 GB)
12.8 GB余裕
Mac Mini M5 Pro (64 GB) (−8 GB macOS = 56 GB)
44.8 GB余裕
Mac Studio M5 Max (128 GB) (−8 GB macOS = 120 GB)
108.8 GB余裕
Mac Studio M5 Ultra (96 GB+) (−8 GB macOS = 88 GB)
76.8 GB余裕
💡 実践的なヒント:
- GPU購入時は常に「安全マージン込み」の値を使用してください
- Q4は25%サイズ削減で90〜95%の品質を提供します。余裕があればQ5がより良い
- コンテキストオーバーヘッドは会話の長さと共に増加します。通常の使用には1〜3 GBを見込んでください
- バッチサイズはマルチユーザーAPIで重要です。シングルユーザーチャットはバッチオーバーヘッドを無視できます
📋 この設定を共有:
RTX 4060は7B Q4に十分?
十分です。7BはQ4で約4 GBの重みなので、RTX 4060の8 GBなら余裕があります。
70B用に24 GBは?
不十分です。Q4でも約42 GB必要です。
6GB GPUでMistral Smallを実行できますか?
いいえ。Mistral Smallは22-24Bモデルで、Q4でも重みだけで約13-14GBのVRAMが必要です。6GBや8GBのGPUではOOMになります。余裕を持って16GBを、または6-8GBのカードなら7B-8Bモデルを使ってください。
7BモデルのファインチューニングにはどのくらいのVRAMが必要ですか?
LoRA用: 12-16GB。フルファインチューニング: 28GB以上。ファインチューニングはオプティマイザー状態(モデルVRAMの2-4倍)が必要です。
13Bモデルに12GBで十分ですか?
十分すぎるほどです。13BモデルはQ4で約8GBしか必要とせず、12GBなら実際に余裕があります。Q5(約9GB)でも快適で、Q8(約14GB)でぎりぎりになります。
70Bモデルに24GBが必要ですか?
いいえ、ただしそれに近い量が必要です。70Bモデルは重みだけでQ4で約42GB必要です。Q5以上では50GB以上必要になります。Q4以上の70Bモデルには24GBでは不十分です。4ビット未満の量子化なら品質が低下しますが収まります。
バッチサイズを増やすと単一推論のVRAMが減りますか?
いいえ。単一推論は常にbatch=1 VRAMを使用します。バッチサイズはスループット(マルチユーザーシナリオ)にのみ役立ちます。
精度に最適な量子化は何ですか?
Q8は通常ほぼ無損失で、Q5・Q4はやや品質が下がることがあります(モデルやタスクによります)。ほとんどの場合、Q4がスイートスポットです。
VRAMの一部をCPU RAMにオフロードできますか?
はい、一部のレイヤーをシステムRAMにオフロードできます。Llama.cppとOllamaがサポートしています。パフォーマンスは大きく低下することがあります(オフロードするレイヤー数によりますが、30-50%以上の低下も)。
ローカルLLM実行の最小VRAMは?
3B Q4なら4GB VRAM。実用的な最小値は8GB VRAM + 7B Q4。6GB以下では、ほとんどの7Bモデルでは不十分です。
Apple Silicon VRAMはGPU VRAMと同じですか?
Apple Siliconは共有メモリを使用します。Unified Memoryは一部のみGPUメモリとして利用でき、macOSが一部を予約します。MacBook Pro M3 18GBは13Bモデル Q4(~7GB) + オーバーヘッドを実行できます。
異なる量子化レベルで7Bには何GBのVRAMが必要ですか?
7B FP32: ~28GB。7B Q8: ~7GB。7B Q5: ~5GB。7B Q4: ~5-6GB(4GBの重み + 1-2GBオーバーヘッド)。6GBはきついです、8GBが快適です。
参考資料
- NVIDIA CUDA ドキュメント
- Ollama ドキュメント