重要なポイント
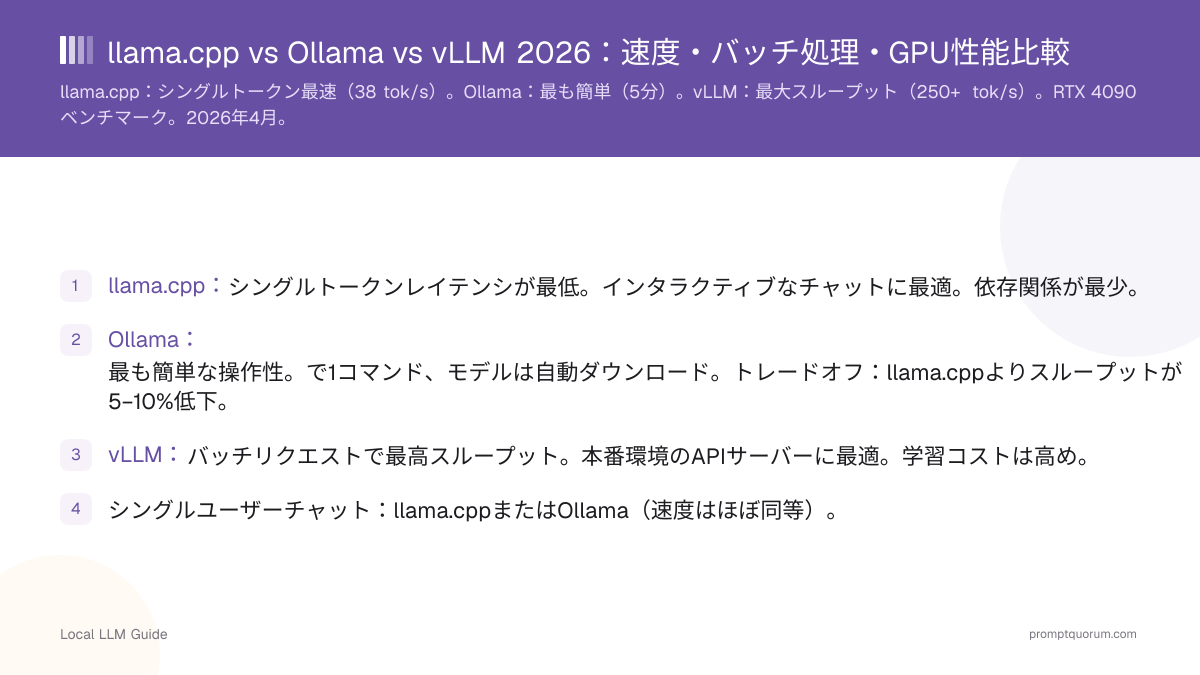
- llama.cpp: シングルトークンレイテンシが最低。インタラクティブなチャットに最適。依存関係が最少。
- Ollama: 最も簡単な操作性。で1コマンド、モデルは自動ダウンロード。トレードオフ:llama.cppよりスループットが5−10%低下。
- vLLM: バッチリクエストで最高スループット。本番環境のAPIサーバーに最適。学習コストは高め。
- シングルユーザーチャット:llama.cppまたはOllama(速度はほぼ同等)。
- マルチユーザー API:vLLM(3−5倍高いスループット)。
- カジュアルな利用:Ollama(シンプルさが最大の利点)。
- 3つとも同一のモデル出力を生成—速度とスループットのみ異なります。
- 3つとも同じマシンで同時実行可能(異なるポート)。競合しません。
📍 一文で説明
llama.cppは単一トークンの速度が最速のバックエンドで、Ollamaは最も簡単にセットアップでき、vLLMは同時ユーザー向けに最高のスループットを提供します -- 3つとも同一のモデルを実行し、同一の出力を生成しますが、速度とセットアップの複雑さのみが異なります。
💬 簡潔に説明
これらは、自分のハードウェア上でAIモデルを実行するための3つの異なるプログラムです。llama.cppは生の最速エンジンですが、手動セットアップが必要です。Ollamaはそれを1コマンドインストールでラップし、やや遅いですがはるかに簡単です。vLLMは多数のユーザーに同時対応するために構築されており(企業のチャットボットのように)、複数のリクエストを同時に処理する際に劇的に高速ですが、学習曲線はより急です。
速度ベンチマーク
llama.cppがシングルリクエストで38トークン/秒でリード;vLLMがバッチで250+トークン/秒で圧倒。 RTX 4090 24GB、Llama 3.3 70B Q4_K_M、シングルリクエスト、2026年4月計測:
バックエンド | トークン/秒 | ms/トークン | VRAM使用量 | バッチスループット |
|---|---|---|---|---|
| llama.cpp | 38 | 26 | 39 GB | N/A(バッチなし) |
| Ollama | 36 | 28 | 39 GB | N/A(シングルバッチ) |
| vLLM | 34 | 29 | 41 GB | 250+ tok/s(連続) |

RTX 3060 12GB — Llama 3.1 8B Q4_K_M
RTX 3060 12GB、Llama 3.1 8B Q4_K_M、シングルリクエスト、2026年4月計測:
バックエンド | トークン/秒 | ms/トークン | VRAM使用量 | バッチスループット |
|---|---|---|---|---|
| llama.cpp | 52 | 19 | 5.2 GB | N/A |
| Ollama | 48 | 21 | 5.4 GB | N/A |
| vLLM | 45 | 22 | 6.1 GB | 180 tok/s(batch=8) |
機能比較表
3つすべてOpenAI互換APIに対応;バッチ処理ではvLLMが優位;Ollamaはセットアップが最も簡単。
バッチ処理とスループット
vLLMは32+リクエストを並列処理;llama.cppとOllamaは1件ずつ処理。 vLLMが優位な理由:
- llama.cpp: ネイティブバッチなし、1リクエストずつ処理。レイテンシ:27ms/トークン。スループット:36トークン/秒。
- Ollama: シングルバッチのみ。2+リクエストの並列処理不可。スループットはllama.cppと同等。
- vLLM: ネイティブ継続バッチ(同時リクエストを動的処理)。32リクエストを並列処理。スループット:同一RTX 4090で250+トークン/秒。
- vLLMの優位性は同時ユーザー数に比例して拡大、0+ユーザーのAPIサーバーにはvLLM必須。
セットアップの複雑さ
Ollamaが最もシンプル(5分);vLLMはPython必要!15分);llama.cppはコンパイル必要!30分)。
llama.cpp: ソースからコンパイルまたはバイナリをDL。モデルファイルは手動管理。絀30分。
Ollama: `brew install ollama`またはインストーラーDL。`ollama run llama3.2`。約5分。
vLLM: `pip install vllm`、次に`python -m vllm.entrypoints.openai.api_server --model meta-llama/Llama-3.3-8B-Instruct`。絀15分(Python + 依存関係)。
シンプルさの勝者:Ollama。
API互换性
3つとも現在OpenAI互换APIをサポート;OllamaとvLLMが最も簡単。
llama.cpp: OpenAI互换API(`llama-server`経由、2024年末追加)。IDE拡張機能で動作。
Ollama: OpenAI互换API(`ollama serve` + クライアントライブラリ経由)。ほとんどのIDE拡張機能で動作。
vLLM: OpenAI互换API(ネイティブ `/v1/chat/completions`)。最高の互换性。
IDE連携(VS Code、Cursor)にはOllamaまたはvLLMを使用。llama.cppはスキップ可能。
使い分けガイド
llama.cpp: 最小依存関係、純粋な速度重視。カスタム推論エンジン構築に最適。MacではMetal加速で最高性能。
Ollama: オールインワンのシンプルさ。チャットUIと個人利用に最適。Mac、Linux、Windows対応。
vLLM: 本番環境のAPIサーバー。マルチユーザーデプロイと高スループット要件に最適。NVIDIA CUDA必須 — Apple Silicon(M1/M2/M3/M4)では動作しません。

推論バックエンド選択でよくある誤解
- 誤解:llama.cppが常に最速。 シングルトークンレイテンシのみ真。バッチリクエストのスループットではvLLMが7倍高速(10+同時ユーザー時)。
- 誤解:Ollamaが遅い。 Ollamaはllama.cppより5−10%遅いのみ — インタラクティブチャットでは34トークン/秒は即座に感じられるため無視できる差。
- 誤解:1つのバックエンドを選ばなければならない。 異なるポートで。3つ同時実行可能。個人チャットにOllama、APIサーバーにvLLMを使い分け可能。
- 誤解:シングルユーザーチャットにvLLMを使う。 vLLMの優位性はバッチ処理にあります。シングルユーザーのインタラクティブチャットにはOllamaのシンプルなセットアップが優れています。
地域コンテキスト & データレジデンシー
日本(METI AIガバナンス): 経济産業省(METI)の「AI原則実践のためのガバナンスガイドラインVer.1.1」(2024年)は、機密性の高い業務データの処理において、オンプレミス推論による完全なデータ管理を推奨しています。vLLMはバッチドキュメント処理に活用する日本企業の本番環境でも使われています。llama.cppとOllamaはAPPI(個人情報保護法)対応の機密データ推論に適しています。
東アジア・アジア太平洋(データレジデンシー): 日本のAPPI、韓国のPIPA、台湾のPDPAはいずれもローカル推論でオンプレミス処理要件を満たせます。中国のデータセキュリティ法(2021年)対応にはllama.cppまたはOllamaをQwen3モデルと一緒に利用する企業が多数あります。
グローバル(EU GDPR対応): 3つのバックエンドはすべてオンプレミスで動作します。データがインフラ外に出ないため、GDPR第28条に基づくDPA(データ処理契約)が不要です。
よくある質問
初心者にはどのバックエンドが向いていますか?
Ollamaです、1コマンド、モデルは自動DL、シンプルなインターフェイス。
最も速いのはどれですか?
シングルリクエスト:llama.cpp(Ollamaより約3%高速)。10同時リクエスト:vLLM(約7倍高速)。
llama.cppをOllamaの代わりに使えますか?
使えますがセットアップがより複雑。速度向上は3−5%でほとんどのユーザーには無視できる差です。
vLLMは本番環境で利用できますか?
はい。実際の本番環境で利用されています。学習コストは高いですが、高スループットには最適。
再学習なしにバックエンドを切り替えられますか?
llama.cppとOllamaはGGUF形式(直接交換可能)。vLLMはSafeTensorsを使用しモデル変換が必要。
最も安定しているのはどれですか?
Ollama(シンプルな構造、バグが少ない)。llama.cppも安定。vLLMは頻繁に更新(新機能多い一方、Breaking Changesあり)。
vLLMはMacで動作しますか?
いいえ。vLLMはNVIDIA CUDA必須。MacではMetal加速のllama.cppまたはOllamaを使用してください。
llama.cpp、Ollama、vLLMの中で最も速いのはどれですか?
シングルリクエスト:llama.cpp(RTX 4090で38 tok/s)。同時ユーザー:vLLM(連続バッチで250+ tok/s、5–7倍高速)。Ollamaはllama.cppより5–10%遅いですが、セットアップがより簡単です。
vLLMはMac Apple Siliconで動作しますか?
いいえ。vLLMはNVIDIA CUDAが必要で、Apple Siliconには対応していません。Macではllama.cpp(Metal使用)またはOllama(llama.cpp内部使用)を使用してください。
llama.cpp、Ollama、vLLMの中で最も速いのはどれですか?
シングルリクエスト時:llama.cppがOllamaより約3%高速(RTX 4090で36 vs 34トークン/秒)。10同時リクエスト時:vLLMがネイティブバッチにより約7倍高速(250+トークン/秒 vs 34トークン/秒)。
2026年時点でOllamaとllama.cppのトークン速度はどう比較されますか?
Ollamaは34〜48トークン/秒(RTX 4090)を達成し、llama.cppは36〜52トークン/秒に達します。Ollamaは抽象化のオーバーヘッドにより5〜10%遅くなりますが、インタラクティブなチャットではその差は無視できます。Ollamaは5%の速度と引き換えに、セットアップ時間を95%短縮します。
Ollama vs vLLM vs llama.cppのパフォーマンスベンチマークはどうなっていますか?
シングルリクエストベンチマーク(RTX 4090、Llama 70B Q4):llama.cpp 38トークン/秒、Ollama 36トークン/秒、vLLM 34トークン/秒。バッチスループット(10同時リクエスト):vLLM 250+トークン/秒、llama.cpp 36トークン/秒、Ollama 36トークン/秒。vLLMは本番環境で圧倒的優位、llama.cppとOllamaはシングルユーザーでは同等です。
関連記事
- Ollama vs LM Studio: どちらを選ぶ? — 最も人気のローカルLLMインターフェイス2つの並列比較
- ユースケース別ベストローカルLLMスタック(2026) — チャット、コーディング、APIサービング向け推奨構成
- Text Generation WebUI vs vLLM vs llama.cpp — AUTOMATIC1111系フロントエンドを含む詳細比較
- ベストローカルLLMフロントエンド(2026) — OpenWebUI、Chatbot UIなざ8その他の選択肢ランキング
- Ollamaのインストール方法 — macOS、Windows & Linux向、2分セットアップガイド
- ローカルLLM OpenAI互换APIガイド — ローカルモデルによるOpenAI APIのドロップイン代替
- Xinference: Llama、Qwen、ChatGLMをローカルで実行する -- XinferenceでオープンソースモデルをDeployする。