重要なポイント
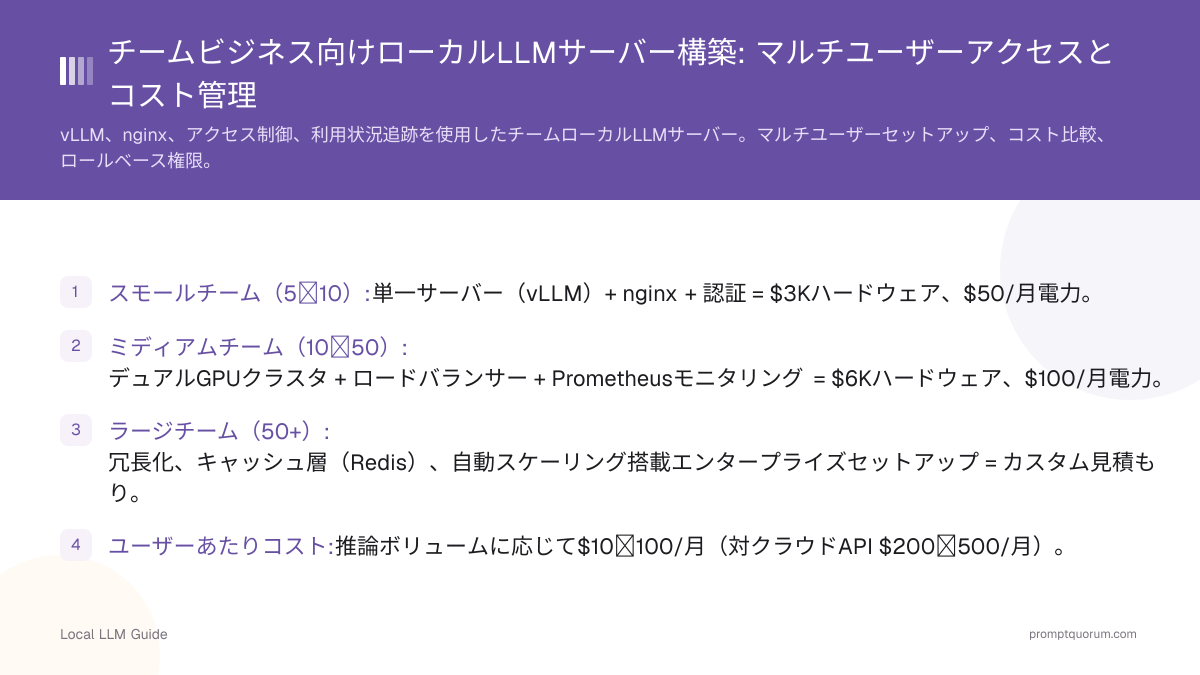
- スモールチーム(5~10): 単一サーバー(vLLM)+ nginx + 認証 = $3Kハードウェア、$50/月電力。
- ミディアムチーム(10~50): デュアルGPUクラスタ + ロードバランサー + Prometheusモニタリング = $6Kハードウェア、$100/月電力。
- ラージチーム(50+): 冗長化、キャッシュ層(Redis)、自動スケーリング搭載エンタープライズセットアップ = カスタム見積もり。
- ユーザーあたりコスト: 推論ボリュームに応じて$10~100/月(対クラウドAPI $200~500/月)。
- セットアップ時間: 単一サーバー = 1日。クラスタ = 1週間。エンタープライズ = 1か月(セキュリティ監査含む)。
- API認証: エンタープライズ向けOAuth 2.0(AD/Okta経由SSO)。SMB向け簡単トークン認証。
- 使用率トラッキング: すべてのクエリはユーザーID、タイムスタンプ、生成トークンで記録(コスト配分用)。
- 管理負担: ミニマル(自動監視)。スケーリングイベント = GPUカード追加 + 再バランス(コード変更不要)。
📍 一文で説明
5~20人のチーム向けの共有ローカルLLMサーバーは、vLLMとnginxロードバランサーで構築すると、電力代が月額約50ドルで済み、同等のクラウドAPI利用の月額1,000ドル以上と比べてはるかに安く、単一サーバーなら1日、冗長化クラスターでも最大1週間でセットアップできます。
💬 簡潔に説明
チームメンバー全員が個別にAIサブスクリプションを支払う代わりに、企業は全員が接続する共有AIサーバーを1台運用できます -- 社内ファイルサーバーのようなものです。初期費用(ハードウェア購入)は高くなりますが、同じ利用量に対してクラウドAIプロバイダーに支払うよりも月々のコストははるかに安くなります。特に定期利用者が数人以上いる場合に効果的です。
どのアーキテクチャ: 単一サーバー対マルチGPUクラスタ?
単一vLLMサーバー(5~10ユーザー):
- 1× RTX 4090 + 64GB RAM + 1TB SSD。
- 10同時ユーザー処理(ユーザーあたり5 tok/s)。
- シンプルセットアップ、単一障害点。最高ローカルLLMスタックを参照。
- コスト: $2,500ハードウェア + $50/月電力。
デュアルGPUクラスタ(10~50ユーザー):
- 2× vLLMインスタンス(GPU当たり1つ)+ nginxロードバランサー。
- 20同時ユーザー処理(ユーザーあたり10 tok/s)。
- 自動フェイルオーバー(GPU 0ダウン時もGPU 1は稼働)。詳細はエンタープライズローカルLLMスケーリングを参照。
- コスト: $5,000ハードウェア + $100/月電力。
Redisキャッシングレイヤー(オプション):
- 一般的なプロンプト(システムメッセージ、テンプレート)をキャッシュ。
- 繰り返しクエリで30%遅延削減。
- コスト: $1K追加ハードウェア。
ユーザー認証とアクセス制御をセットアップするにはどうすればよいですか?
シンプル認証(SMB < 50ユーザー): ユーザーあたりAPIキー。ユーザーがリクエストヘッダーで`Authorization: Bearer $API_KEY`を送信します。コンプライアンスについてはエンタープライズローカルLLMコンプライアンスを参照。
エンタープライズ認証: OAuth 2.0 + SAML 2.0とOkta/Azure AD統合。SSO ログイン、自動グループ割り当て。
レート制限: ユーザーあたりトークンクォータ(例: 100Kトークン/日)。1つのチームがサーバーを圧倒するのを防ぐ。
監査証跡: すべてのAPIコールをユーザーID、IP、リクエストサイズ、レスポンスサイズ、タイムスタンプで記録。
コスト配分と使用率測定を追跡するにはどうすればよいですか?
トラッキング: ユーザーあたり/日生成トークン。チーム全体で合計コストを計算。プライベートローカルLLM機密データ用を参照。
配分: サーバーコストを比例配分(例: Aliceが40%のトークン生成なら40%の請求)。
ショーバックレポート: ユーザー別月別レポート: 使用トークン、推定クラウドAPI コスト、内部コスト、節約額。
ツール: Prometheus + カスタム課金サービス。またはオープンソース: Metered.io(クラウドベース課金追跡)。
チームサイズの成長に応じてローカルLLMサーバーをスケーリングするにはどうすればよいですか?
5~10ユーザー: 1× RTX 4090。全員同時推論で飽和。許容可能なレイテンシースパイク。
10~30ユーザー: 2× RTX 4090(デュアルGPUマシン)。nginxロードバランサーが負荷分散。20同時 = 快適。
30~100ユーザー: 3~4× GPUクラスタ(別マシン)+ 専用ロードバランサー。Kubernetesオプション。
100+ユーザー: エンタープライズアーキテクチャ(クラウドフェイルオーバー、キャッシュレイヤー、APIゲートウェイ)= ハイブリッド検討(ローカル + クラウドバースト)。
パフォーマンスを監視し、問題をトラブルシューティングするにはどうすればよいですか?
Prometheusメトリクス: vLLMはリクエスト遅延、トークン/秒、キュー長をエクスポート。15秒ごとにスクレイプ。
Grafanaダッシュボード: キュー深度、遅延パーセンタイル(p50, p99)、GPU使用率を可視化。
アラート: 遅延 > 2秒またはキュー > 10リクエストでオンコール技術者に通知。
ログ: vLLM + nginxログをELK Stackに集約。ユーザー、タイムスタンプ、エラーで検索。
ボトルネック識別: GPU飽和(>90%使用)かつ遅延 > 1秒ならGPU追加。CPU飽和ならCPUアップグレード。
一般的なセットアップミス
- 単一障害点(1つのGPU、フェイルオーバーなし)。GPUダウン時、チームはアクセス不可。デュアルGPU最小化。
- レート制限なし。1ユーザーが1M トークン推論実行、全員ブロック。トークンクォータを実装。
- 監査ログなし。誰が何にアクセスしたか追跡不可。コンプライアンスチームに必須。
よくある質問
新しいハードウェアなしでより多くのユーザーを追加できますか?
GPU当たり20~30まで。それ以上はGPUカード追加、ロードバランサー再バランス。1× RTX 4090は同時ユーザーあたり約5 tok/s処理。
モデル更新(新Llama 3バリアント)をどのように処理しますか?
別マシンでダウンロード、テスト、スワップイン。vLLMはゼロダウンタイムのモデルホットスワップをサポート。
チームデプロイにKubernetesを使うべきですか?
50ユーザー未満では不要。Docker + docker-composeがシンプル。Kubernetesは複雑さ追加するだけ。
トークンに基づいてユーザーに請求できますか?
はい、ショーバックレポート経由。ただし最初にポリシー決定: 共有コスト対部門別チャージバック。
ユーザーが誤ってサーバーデータを削除した場合は?
バックアップ。外部ストレージへ毎日入出力ログバックアップ。RAID-6冗長性。
Slack/Teamsと統合して簡単アクセスできますか?
はい。Slack ボットがvLLM APIを呼び出してチャネルに返す。人気統合: Slack用OpenAI APIラッパー。
チームローカルLLMサーバーはクラウドAPIと比べていくらかかりますか?
単一サーバー: $2,500ハードウェア + $50/月電力($600/年)対クラウドAPI $1,000+/月($12,000+/年)。回収期間: アクティブなチームで2~3か月。
チームLLMサーバーのユーザー認証をセットアップするにはどうすればよいですか?
エンタープライズ向けOAuth 2.0 + SSO(Active Directory / Okta)。SMB向け簡単なトークン認証。すべてのクエリはユーザーID、タイムスタンプ、生成トークン数で記録されます。
チームセットアップでGPUがダウンした場合はどうなりますか?
ロードバランサー付きデュアルGPUクラスタを使用: GPU 0がダウンすると、すべてのリクエストは自動的にGPU 1にルーティングされます。ダウンタイムなし。単一サーバーセットアップでは、RAID ストレージがデータを保護しますが、GPU フェイルオーバーは冗長性が必要です。
チームセットアップでモデル更新をどのように処理しますか?
別のマシンで新しいモデルをダウンロード、テスト、スワップイン。vLLMはゼロダウンタイムでのモデルホットスワップをサポートします。
チームサーバーのユーザーデータとログをバックアップするにはどうすればよいですか?
すべての入出力ログを外部ストレージに毎日バックアップします。RAID 6冗長性を使用します(2台の同時ドライブ障害に耐えます)。毎月リカバリーをテストしてバックアップの有効性を確保します。
請求用ユーザー使用量を測定・追跡するにはどうすればよいですか?
各APIリクエストにはユーザーID、IP、リクエストサイズ、レスポンスサイズが含まれます。Prometheusは15秒ごとに遅延、トークン/秒、キュー長のメトリクスをスクレイプします。ユーザー/日ごとに集計して比例配分コスト配分を行います。
ソース
- vLLM公式ドキュメント — マルチユーザーセットアップとレート制限
- Prometheus ドキュメント — メトリクス収集とアラート
- Kubernetes ベストプラクティス — 大規模デプロイのコンテナオーケストレーション