重要なポイント
- macOS(Apple Silicon): GPU コスト0円、Ollama 無料、Llama 3.1 8B をスムーズに実行。カジュアル/非技術ユーザー向けベスト。
- Windows(NVIDIA GPU): GPU 加速の業界標準。CUDA エコシステムは成熟。モデルサイズに応じて150–1,600ドルの GPU。
- Linux(NVIDIA または AMD GPU): 最小オーバーヘッド(Windows より10–20%少ない電力)、24/7サーバーに最適。Windows と同じ GPU コスト。
- 推論速度: 3つの OS すべては同じ GPU で同じ出力速度を生成。ソフトウェア設定の難易度が異なります。
- 設定の複雑さ: macOS最も簡単(Ollama ワンクリック)、Windows 中程度(NVIDIA ドライバ必須)、Linux はコマンドライン慣れが必要。
- 推論コスト: Linux < Windows = macOS(GPU 加速の場合は同じ、CPU のみ の場合は macOS が安い)。
- エコシステム: NVIDIA CUDA は Windows/Linux で利用可能(Mac ネイティブではない)。AMD ROCm は Linux/Windows 上。Apple Metal は macOS のみ。
- ベストチョイス: ノートパソコン/カジュアル使用は Mac;デスクトップゲーム + LLM は Windows;サーバーは Linux。
OS 別のハードウェアコストは?
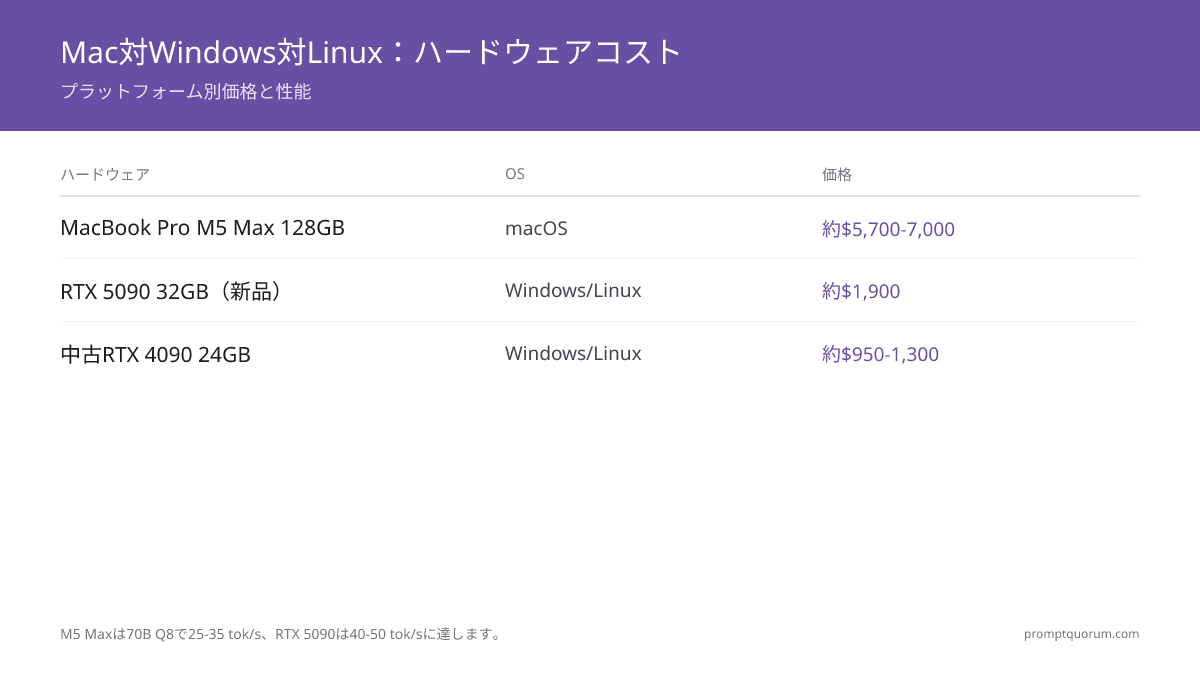
macOS(Apple M5世代 — 2026年3月出荷): MacBook Pro M5 Pro 64GB(2,499–3,199ドル)は70B Q4を15–20トークン/秒で実行。MacBook Pro M5 Max 128GB(3,499–4,999ドル)は70B Q8を25–35トークン/秒で実行。MacBook Air M5 32GB(1,099–1,299ドル)は8Bを問題なく処理。アップグレード時の追加費用: Mac を既に所有していれば0ドル;新規購入なら1,099ドル以上。
Windows(NVIDIA GPU 必須 — 2026年4月): RTX 5060 Ti 16GB 新品(450–500ドル)は70B Q4を20–40トークン/秒で実行。RTX 5090 32GB 新品(2,000ドル)は70Bを40–50トークン/秒で実行(分割なしで70Bを実行できる初のコンシューマー単一GPU)。中古RTX 4070(350ドル)、RTX 4090(1,000–1,400ドル)はまだ入手可能。追加費用: 350–2,000ドル。
Linux(NVIDIA または AMD GPU): ベアメタルサーバー(300–1,000ドル)または古いマシン再利用 + RTX 5060 Ti/5090(450–2,000ドル)。Windows と同じ GPU コスト。追加費用: 150–2,600ドル。
Mac デスクトップ刷新(2026年8月25日): Apple は Mac mini M6(147,000円、統合メモリ最大32GB、帯域幅170GB/s)と Mac mini M5 Pro(278,000円、最大64GB、帯域幅307GB/s)を発表。どちらも2026年9月22日出荷開始。Mac Studio も刷新: M5 Max(409,000円、最大128GB)と M5 Ultra(899,000円、96GBから、256GBまたは512GBまで構成可能 — 512GB構成は2026年10月下旬出荷、価格は1,635,000円を大きく上回る見込み)。旧世代の Mac mini M4(98,000円から)と Mac mini M4 Pro(最大376,000円、最大64GB)は現在は旧世代モデル。RTX 5090 は引き続き70Bモデル向け初の単一GPUコンシューマーソリューション。
💡ヒント: 💡 プロのコツ: M5 Max 128GB vs RTX 5090 : M5 Max は1.3–1.5倍遅い(25–35 vs 40–50トークン/秒)ですが、400ドル安く、メモリ4倍(128GB vs 32GB)あり、静寂(GPU ファンノイズなし)。
セットアップと複雑さは?
macOS: Ollama ダウンロード(1分)、アプリ実行、Llama 3.1 8B 選択(5分)= 合計6分、ターミナルコマンド0。非技術ユーザー向けベスト。
Windows: NVIDIA ドライバインストール(5-10分)、Ollama または LM Studio ダウンロード(5分)、モデル選択(5分)= GUI で15-20分(ターミナル不要)。
Linux(Ubuntu): SSH、CUDA/cuDNN インストール(20-40分)、Ollama/vLLM インストール(10分)、systemd 設定(10-20分)= 40-70分。ターミナル慣れが必要。
長期保守: macOS(自動更新)、Windows(四半期ドライバ更新)、Linux(システムチューニング、時々の依存関係問題)。
💬 簡潔に説明
macOS セットアップは携帯電話の充電器を差し込むようなもの(1つのケーブル、動作)。Windows は組み立て家具のような感じ(説明書が重要)。Linux はパーツからPC を組み立てるようなもの(何をしているか知る必要があります)。
🛠️実践: 🛠️ ベストプラクティス: macOS Sequoia をリリース初日にインストールしない;Metal ドライバ修正を2週間待つ。GPU サポートはポイントリリースで壊れることがあります。
推論速度はどう比較されますか?
macOS(Apple M5世代 — 2026年3月出荷): M5 Pro(64GB)はLlama 3.3 70B Q4を15–20トークン/秒で実行。M5 Max(128GB、614GB/s帯域幅)は70B Q8を25–35トークン/秒で実行 — M4 Max 比4倍改善(M4 Max は70B に向いていなかった)。
Windows + RTX 5090(32GB、2026年4月): Llama 3.3 70B = 40–50トークン/秒、8B = 180+ トークン/秒。RTX 5090 は分割なしで70B を処理できる初のコンシューマー GPU。
Windows + RTX 5060 Ti(16GB、2026年4月): Llama 3.3 70B は適合しない(最小24GB必要)。13B–24B モデルを20–40トークン/秒で実行。予算内の RTX 4070 相当ユーザー向けグッド。
Linux + RTX 5090 または RTX 5060 Ti: OS オーバーヘッド低により1–5%Windows より高速。Linux 上の RTX 5090 は70B で42–53トークン/秒に達します。
M5 Max vs RTX 5090 トレード・オフ: RTX 5090 は1.3–1.5倍高速ですが、500ドル高く、デスクトップ必要、450W 消費。M5 Max は静寂、ターンキー、メモリ4倍(128GB vs 32GB)。
📍 一文で説明
GPU ハードウェアが推論速度を決定(RTX 5090 40–50トークン/秒 vs M5 Max 25–35トークン/秒)、OS ではない。
🔍洞察: 🔍 M5 ゲームチェンジャー: Apple の Fusion Architecture(2つの3nmダイボンド)はM4 比LLM プロンプト処理4倍高速で、RTX 5090 とのスピードギャップ大幅短縮。
⚠️注意: ⚠️ 警告: Windows 上の AMD ROCm は未成熟。AMD GPU は Linux を選択;Windows サポートは3–6ヶ月遅れ。
OS ごとにサポートされるツール・フレームワークは?
Ollama(推論エンジン): macOS ✓、Windows ✓、Linux ✓。 3つすべてで同一機能。
LM Studio(GUI): macOS ✓、Windows ✓。Linux は Docker 経由のみ(ネイティブ GUI なし)。
vLLM(API サーバー): macOS(限定、Apple Metal のみ)、Windows ✓(CUDA)、Linux ✓(CUDA/ROCm)。Linux で最適。
NVIDIA CUDA ツールキット: Windows ✓、Linux ✓。macOS ✗(2026年4月以降非サポート、Apple Metal のみ)。
PyTorch(深層学習フレームワーク): macOS ✓(Apple Metal バックエンド、遅い)、Windows ✓(CUDA)、Linux ✓(CUDA/ROCm)。NVIDIA での Linux/Windows で最速。
ファインチューニングサポート: macOS(遅い CPU のみ、またはクラウド経由);Windows ✓(CUDA 加速);Linux ✓✓(ベストサポート)。
📌補足: 📌 重要ポイント: CUDA は Windows/Linux でのみネイティブ動作。macOS ユーザーは Apple Metal API を使用必須で、これより新く、ライブラリ少ない。
3年間の総保有コストは?
| セットアップ | 1年目 | 2–3年目 | 3年合計 |
|---|---|---|---|
| MacBook Air M5(32GB、既存) | ¥0 | ¥3,300 | ¥3,300 |
| MacBook Pro M5 Pro 64GB | ¥408,000 | ¥5,000 | ¥413,000 |
| MacBook Pro M5 Max 128GB | ¥572,000 | ¥5,000 | ¥577,000 |
| Mac mini M6 32GB | ¥147,000 | ¥2,500 | ¥149,500 |
| Mac mini M5 Pro 64GB | ¥278,000 | ¥3,300 | ¥281,300 |
| Mac Studio M5 Max 128GB | ¥409,000 | ¥5,000 | ¥414,000 |
| Windows + RTX 5060 Ti 16GB | ¥269,500 | ¥13,000 | ¥282,500 |
| Windows + RTX 5090 32GB | ¥409,500 | ¥19,500 | ¥429,000 |
| Linux + RTX 5060 Ti 16GB | ¥122,750 | ¥9,800 | ¥132,500 |
| Linux + RTX 5090 32GB | ¥229,000 | ¥16,500 | ¥245,500 |
よくある質問
macOS で Llama 3.3 70B を実行できますか?
はい — MacBook Pro M5 Pro(64GB)は70B Q4を15–20トークン/秒で実行。M5 Max(128GB)は70B Q8を25–35トークン/秒で実行。Mac mini M5 Pro(64GB、2026年9月22日出荷開始)は同じチップを採用しており、同程度の性能が見込めます。Mac Studio M5 Max(最大128GB)と M5 Ultra(最大512GB)はより大きなモデルに対応。Mac mini M6(最大32GB)は70Bを収容できません。32GB以下の構成も同様です。
NVIDIA の代わりに AMD GPU を使用できますか?
Windows: 限定(ROCm サポート改善中ですが3–6ヶ月遅れ)。Linux: RX 7000シリーズに優秀な ROCm サポート。AMD は2026年4月時点で同等 NVIDIA より10–20%遅い。AMD on Linux: Ollama 開始前に HSA_OVERRIDE_GFX_VERSION を設定。
初心者にとって Linux は設定が難しいですか?
はい。macOS: Ollama.app は6分でインストール、ターミナルなし。Windows: NVIDIA ドライバインストールで15–20分。Linux: ターミナル(apt、pip、systemctl)が必要で40–70分。コマンドラインに不安がある場合: macOS または Windows から開始。
プロジェクト途中で OS を切り替えられますか?
はい。モデルはポータブル — GGUF ファイルはすべての OS で動作。ファインチューンアダプタ(LoRA)もポータブル。フレームワークコードはマイナーパス更新が必要な場合あり。Ollama モデルストレージ位置は OS で異なりますが、モデルの重みは同じ。
macOS は電力をより少なく使用しますか?
持続的な LLM 推論下の Apple Silicon M5 Max は約30–40W を消費。RTX 5090 は負荷時に約450W を消費。3年間で1日4時間のアクティブ使用: M5 Max 約$15 電気代 vs RTX 5090 約$180。macOS は電力コストで勝利、Linux/Windows は推論速度で勝利。
OS の中でモデルのファインチューニングに最適なのはどれですか?
Linux > Windows > macOS。Linux は最高の CUDA および DeepSpeed サポート。macOS M5 は MLX(Apple ML フレームワーク)経由で約2時間で7B をファインチューン可能 — 小さいデータセット向け実用的。本番ファインチューニング: Linux with RTX 4090 以上。
70B モデルの場合、MacBook Pro M5 Max は RTX 5090 より優れていますか?
RTX 5090 は1.3–1.5倍高速(40–50トークン/秒 vs 25–35トークン/秒)。ただし M5 Max はメモリ4倍(128GB vs 32GB)で、70B を Q8(より高い品質)で有効にしますが、RTX 5090 は Q4 に限定。M5 Max は静寂でターンキー。RTX 5090 はデスクトップ構築と冷却が必要。品質+利便性向けM5 Max を選択。生スピード向け RTX 5090 を選択。
新しい Mac mini M6、Mac mini M5 Pro、Mac Studio のどれをローカル LLM 用に購入すべきですか?
Apple は2026年8月25日に Mac mini と Mac Studio ラインナップの刷新を発表し、2026年9月22日から出荷開始(Mac Studio M5 Ultra の512GB構成は2026年10月下旬出荷)。8B~13Bモデル向け: Mac mini M6(147,000円、最大32GB)が最も安い選択肢。70Bモデル向け: Mac mini M5 Pro(278,000円、最大64GB、帯域幅307GB/s)は70Bを収容できる最も安い Apple マシン — MacBook Pro M5 Pro と同じチップを採用しており、これは70B Q4を15–20トークン/秒で実行。128GB以上のワークロード向け: Mac Studio M5 Max(409,000円)または M5 Ultra(899,000円から、最大512GB)でさらに拡張可能。旧世代の Mac mini M4 Pro(最大376,000円、最大64GB)は現在は旧世代モデル — 新しい M5 Pro mini より安い割引がある場合のみ購入を検討。
OS 選択時に回避すべき一般的な誤りは何ですか?
- macOS は大きなモデルを実行できないと思う。M4 Max は70B を実行できますが遅い。本格的な仕事の場合、macOS は8B-13B モデルに限定。
- LLM 用に Windows PC をわざわざ購入する(Mac を考慮せずに)。Mac を持っている場合は使用;GPU コストが決定を支配。
- Linux はサーバーのみと考える。Linux はホームサーバー/ミニPC に優秀で、最低保有コスト。
- NVIDIA 市場優位を忘れる。CUDA は標準;AMD と Apple Metal は小さいエコシステムでチュートリアル/ライブラリ少ない。
- OS が推論速度に影響すると信じる。macOS on Apple Silicon と Windows on RTX 4090 は異なる速度 — OS ではなくハードウェアのため。
⚠️注意: ⚠️ 「最適 OS」で最初に最適化しない。 既に所有しているハードウェアで最適化。無料の Mac は500ドルの Windows + 350ドル GPU に勝ります。
関連読書
- ノートパソコン上のローカル LLM : 最適モデルとセットアップ — GPU なしで MacBook Air で Llama モデルを実行する方法。
- ローカル LLM 向け GPU vs CPU vs Apple Silicon — GPU を購入するタイミングと飛ばすタイミング。
- ローカル LLM 向けベスト ミニPC — 24/7 推論用コンパクト Linux サーバー。
- ローカル LLM ハードウェアガイド 2026 — RTX、Mac、Linux ハードウェアの完全分析。
- Ollama のインストール方法 — 3つの OS すべてのセットアップ ステップバイステップ ガイド。
- NVIDIA CUDA vs AMD ROCm : ローカル LLM 向け GPU ドライバ — どの GPU ドライバを選択するか。
地域別の考慮事項
日本(APPI): Apple Silicon Mac はローカルで個人データを処理(クラウド同期不要)。Windows および Linux はクラウドバックアップ前にユーザーの明示的同意が必要。METI は日本国内ローカル推論を奨励しており、Apple Silicon はこれに最適。
APAC(アジア太平洋): オンプレミス LLM は地域データ主権規制で優先。PDPA(タイ)、PDP (フィリピン)は個人データローカル保持を奨励。
世界中: 電力コスト大幅変動。欧州レート(0.20–0.30ドル/kWh)と中国レート(0.08–0.12ドル/kWh)は GPU への長期 ROI に影響。
ソース
- Ollama GitHub ドキュメント — Ollama 公式ドキュメント(2026年4月)
- LM Studio システム要件 — LM Studio ハードウェアおよび OS 要件(2026年4月)
- NVIDIA CUDA ツールキット ドキュメント — Windows および Linux 向け公式 CUDA セットアップガイド