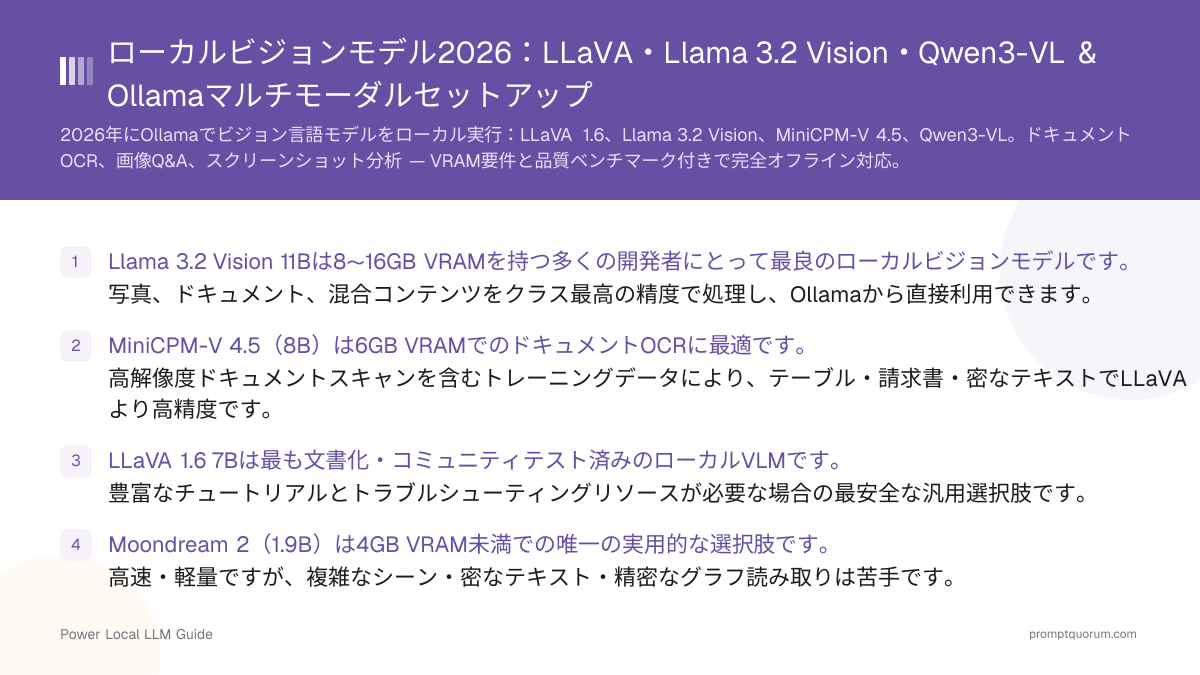
基本情報
- VLMの機能: 画像+テキスト入力 → テキスト出力。画像生成器ではなく、画像を*理解する*モデルです。
- Ollamaサポート: Gemma 4、Qwen3.8、Qwen3.5、Qwen3-VL、Llama 3.2 Vision、MiniCPM-V、LLaVA、Moondreamは公式Ollamaライブラリにあります。InternVL、PaliGemma 2、SmolVLMはコミュニティビルドが必要です。
- 最小の実用モデル: Moondream 2(1.8B、1.7GBダウンロード)、Qwen3-VL 2B(1.9GB)、Qwen3.5 0.8B(1.2〜1.3GB)。
- 最大の実用ローカルモデル: Qwen3.5 122B(81GB)は128GBのMac、Llama 3.2 Vision 90B(55GB)は96GB以上のMac(Apple M-Series)またはマルチGPU向け。Qwen3-VL 235Bは143GBが必要。
- 画像入力形式: JPEG、PNG、WebP。最大解像度はモデルによって異なります(通常1024×1024〜4096×4096)。
- 音声と動画: Gemma 4 E2B、E4B、12Bは音声入力にも対応。すべてのGemma 4サイズとQwen3.8は動画をフレームとして処理します。
- OCR精度: Qwen3.8 27B ≈ Qwen3-VL 8B ≈ Qwen3.5 9B > Gemma 4 > MiniCPM-V > LLaVA 1.6 13B > LLaVA 1.6 7B > Moondream 2。
- マルチモーダル = 低速: ビジョンモデルはLLMにビジョンエンコーダーを追加するため、同サイズのテキストのみモデルより〜30〜60%遅くなります。
ビジョン言語モデル(VLM)とは?
ビジョン言語モデル(VLM)は画像とテキスト入力を同時に処理してテキスト出力を生成するニューラルネットワークです。標準的なアーキテクチャは、ビジョンエンコーダー(通常CLIPまたはSigLIP)と言語デコーダー(LLM)を投影層で接続し、画像特徴をLLMが理解するトークン空間にマッピングします。
- 画像生成器との違い: Stable Diffusion、FLUX、DALL-E 3はテキストから画像を生成します。VLMは画像からテキストへのモデルで、画像を説明・分析・回答します。
- OCRツールとの違い: 従来のOCR(Tesseract)はパターン認識でテキストを抽出します。VLMはコンテキストを理解し、テーブルの意味を説明したり、グラフに関する質問に答えたりできます。
- ローカル実行の理由: プライベートドキュメント(医療記録・法的スキャン・財務諸表)、独自スクリーンショット、または画像をクラウドAPIに送信することにコンプライアンス上の懸念があるワークフロー。
- できないこと: 画像生成、スクリーンショット内のコード実行、インターネットアクセス。VLMは画像に見えるものに基づいてテキスト出力のみを生成します。
利用可能なローカルビジョンモデル — 比較表
Ollamaまたは直接推論で利用可能な主要ローカルビジョンモデルの比較(2026年10月23日確認)。VRAM列はOllamaのダウンロードサイズ(特に記載がなければ4ビット量子化)で、コンテキスト用に1〜2GBを追加してください。*Llama 3.2 Visionは最近のOllamaバージョンでロードに失敗するとの報告があります(下記のLlama 3.2 Visionに関する注記を参照)。
📍 一文で説明
8GB VRAMならGemma 4 E4BまたはQwen3-VL 8B、24GBならGemma 4 26B/31BまたはQwen3.8 27B — すべてOllama経由でローカル実行可能。
💬 簡潔に説明
Gemma 4が総合最良。Qwen3-VL・Qwen3.5・Qwen3.8がドキュメントOCRと多言語テキストをリード。MoondreamとQwen3.5 2Bは4GB未満の軽量オプション。
モデル | パラメータ | VRAM (Q4) | 画像タイプ | 品質 | Ollama対応? |
|---|---|---|---|---|---|
| Moondream 2 | 1.8B | 〜2GB | シンプルな写真 | 基本的 | 対応 |
| SmolVLM 2.2B | 2.2B | 〜2GB | シンプルな写真・キャプション | 基本的+ | コミュニティ |
| Qwen3.5 2B | 2B | 2.7〜3.1GB | 写真・ドキュメント・OCR | 良好 | 対応 |
| PaliGemma 2 3B | 3B | 〜3GB | 写真・ドキュメント | 良好 | コミュニティ |
| Qwen3-VL 4B | 4B | 3.3GB | 写真・ドキュメント・OCR | 良好 | 対応 |
| Gemma 4 E2B | 実効2.3B | 4.6〜7.5GB | 写真・ドキュメント・音声 | 良好 | 対応 |
| LLaVA 1.6 7B | 7B | 〜6GB | 写真・ドキュメント・グラフ | 良好 | 対応 |
| MiniCPM-V | 8B | 〜6GB(5.5GBプル) | 写真・ドキュメント・OCR | 非常に良好 | 対応 |
| Qwen3-VL 8B | 8B | 〜6.2GB | 写真・ドキュメント・OCR・多言語 | 優秀 | 対応 |
| Qwen3.5 9B | 9B | 6.6〜7.6GB | 写真・ドキュメント・OCR・多言語 | 優秀 | 対応 |
| Gemma 4 E4B | 実効4.5B | 6.6〜9.5GB | 写真・ドキュメント・音声 | 非常に良好 | 対応 |
| Gemma 4 12B | 12B | 7.7〜8.0GB | 写真・ドキュメント・音声 | 優秀 | 対応 |
| InternVL 2.5 8B | 8B | 〜8GB | ドキュメント・グラフ・UI・コード | 優秀(UI/グラフ) | コミュニティ |
| Llama 3.2 Vision 11B | 11B | 〜8GB(7.8GBプル) | 写真・ドキュメント | 優秀* | 対応* |
| LLaVA 1.6 13B | 13B | 〜10GB | 写真・ドキュメント・グラフ | 非常に良好 | 対応 |
| Gemma 4 26B A4B | 26B(4Bアクティブ) | 16〜19GB | 写真・ドキュメント・複雑 | 優秀 | 対応 |
| Qwen3.8 27B | 27B | 18GB | 写真・ドキュメント・動画・OCR | オープンソース最高 | 対応 |
| Gemma 4 31B | 31B | 19〜20GB | 写真・ドキュメント・複雑 | 優秀 | 対応 |
| Qwen3-VL 32B | 32B | 21GB | 写真・ドキュメント・OCR・複雑 | 優秀 | 対応 |
| Llama 3.2 Vision 90B | 90B | 55GB | 写真・ドキュメント・複雑 | 非常に良好* | 対応* |
| Qwen3.5 122B | 122B | 81GB | 写真・ドキュメント・複雑 | ローカル最高 | 対応 |

参考例:請求書抽出の比較
構造化ドキュメント抽出タスクにおけるローカルビジョンモデルの精度の参考比較:1枚のサンプル請求書から5フィールド(ベンダー名、日付、合計、税額、行項目数)を抽出。これはPromptQuorumのベンチマークではありません。デバイス、ランタイムのバージョン、モデルタグ、量子化、プロンプト、実行回数は記録されていないため、印は目安であり再現できません。*付きの行は、お使いのOllamaバージョンでモデルが読み込めることを前提としています。
モデル | ベンダー | 日付 | 合計 | 税額 | 行項目 | スコア |
|---|---|---|---|---|---|---|
| Moondream 2 | ✓ | ✓ | ✗ | ✗ | ✗ | 2/5 |
| LLaVA 1.6 7B | ✓ | ✓ | ✓ | ✗ | ✓ | 4/5 |
| MiniCPM-V | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| Qwen3-VL 8B | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| Llama 3.2 Vision 11B* | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| GPT-5.5 Vision | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
📌補足: 単一のテスト請求書による結果です。精度はドキュメント品質・フォント・レイアウトの複雑さによって異なります。抽出した数値は必ず元のドキュメントと照合してください。
マルチ画像サポート
1回のリクエストで複数の画像を受け付けないローカルVLMもあります。マルチ画像サポートは複数ページのPDF処理や視覚的な比較タスクに重要です。
- MiniCPM-Vは1プロンプトで最大4枚の画像を受け付け、Qwen3-VLは最大8枚に対応。LLaVAとMoondreamは1リクエストにつき1枚のみです。
- マルチ画像が重要な場面: 複数ページのPDFの全ページを送信して完全なドキュメント抽出、2つの商品写真を並べて比較、1つのプロンプトでビフォー・アフターのスクリーンショットを分析。
機能 | Moondream | LLaVA 7B | MiniCPM-V | Qwen3-VL | LLaVA 13B | Llama 3.2 Vision | InternVL |
|---|---|---|---|---|---|---|---|
| マルチ画像入力 | 非対応 | 非対応 | 対応(最大4枚) | 対応(最大8枚) | 非対応 | 対応(複数ページ) | 対応 |
Ollamaセットアップ — ステップバイステップ
Ollamaはローカルビジョンモデルを実行する最も簡単な方法です。インストール後、単一のpullコマンドでビジョンモデルが利用可能になります。
- ステップ1 — Ollamaをインストール: macOS・Linux・Windows用をollama.comからダウンロード。インストールは2分以内。
- ステップ2 — ビジョンモデルをダウンロード: 8GBカードには
ollama pull gemma4:e4b(6.6〜9.5GBダウンロード)、OCRにはollama pull qwen3-vl:8b(6.2GB)、VRAMが少ない場合はollama pull moondream(1.8B、1.7GB)。 - ステップ3 — CLIで使用:
ollama run gemma4:e4b "What is in this image? /path/to/photo.jpg"— 画像パスはプロンプト内に記述します。ollama runに--imageフラグはありません。 - ステップ4 — HTTP APIで使用:
http://localhost:11434/api/generateにPOSTし、images配列にBase64エンコードされた画像を含める。formatフィールドにJSONスキーマを追加すると構造化出力を得られます。 - ステップ5 — Pythonの例: Base64エンコーディングで
requestsライブラリを使用 — 以下のコードブロックを参照。
import base64
import requests

def ask_vision_model(image_path: str, prompt: str, model: str = "gemma4:e4b") -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")

    response = requests.post(
        "http://localhost:11434/api/generate",
        json={
            "model": model,
            "prompt": prompt,
            "images": [image_b64],
            "stream": False,
        },
    )
    return response.json()["response"]

# 使用例
result = ask_vision_model("invoice.png", "この請求書からすべての行項目と合計金額を抽出してください。")
print(result)
ユースケース1:ドキュメントOCRと抽出
VLMは半構造化ドキュメントで従来のOCRを上回ります — レイアウトとテキストが同様に重要な請求書・レシート・契約書・テーブルなど。
- うまく機能するもの: スキャンした請求書・PDFスクリーンショット・手書きのブロック体メモ・明確な境界線のあるテーブル・名刺。
- うまく機能しないもの: 手書きの草書体・150DPI未満のスキャン・高圧縮JPEG・重なり合うテキスト。
- OCRに最適なモデル: Qwen3-VL 8BとQwen3.5 9B(6〜8GBクラス)、Qwen3.8 27B(18GB、モデルカードによるとOmniDocBench 1.5で91.1)、混合ドキュメントタイプにはGemma 4。
- OCR向けプロンプトエンジニアリング: 「このドキュメントのすべてのテキストを改行を保持して正確に抽出してください。」または「この請求書の内容をJSONで返してください(フィールド:ベンダー、日付、行項目[]、合計)。」
- 従来のOCRとの比較: VLMは低速ですが意味的に強力です。クリーンなドキュメントの純粋なテキスト抽出にはTesseractが高速です。構造化データ抽出が必要な場合はVLMを使用。
ユースケース2:画像Q&Aと説明
一般的なシーン理解・商品説明・視覚的Q&Aには、Gemma 4(8GBならE4B、24GBなら26Bまたは31B)が推奨されるローカルモデルです。 自然で詳細な説明を生成し、写真の内容に関する微妙な質問にも対応します。
- シーン説明: 「この写真には何がありますか?」— オブジェクト・人物・活動・設定・雰囲気。
- 商品カタログ化: プロンプトテンプレートで商品写真を処理:「この商品を説明してください:色・形・素材・状態。」クラウドAPIなしでECインベントリに有用。
- アクセシビリティ: 大規模に画像のaltテキストを生成。
- 最適なモデル: Gemma 4 12BまたはGemma 4 26B A4B(一般的な写真Q&A)。Qwen3.5 4BまたはLLaVA 1.6 7B(速度が精度より重要な大量処理)。
- 速度の考慮: 速度はモデル・GPU・説明の長さによって異なります — 数千枚のバッチを始める前に、自分のハードウェアで20枚程度のサンプルをベンチマークしてください。
ユースケース3:スクリーンショットとUI分析
アプリケーションのスクリーンショット・エラーメッセージ・ダッシュボードの分析には、InternVL 2.5が最強のローカルモデルです。
- 開発者ワークフロー: エラーメッセージのスクリーンショットをモデルに送る:「このスクリーンショットの何が問題で、どう修正しますか?」
- バグレポート生成: 構造化プロンプトを使ってスクリーンショットから自動的にバグレポートの説明を生成。
- ダッシュボードモニタリング: モニタリングダッシュボードのスクリーンショットを分析して異常を検出。
- アクセシビリティテスト: UI変更前後のスクリーンショットを比較して視覚的アクセシビリティを確認。
- 最適なモデル: InternVL 2.5 8B(コミュニティビルド、UIに強い)、Gemma 4とQwen3-VL(公式Ollamaサポート、エージェントワークフロー向けのツール呼び出し対応)。
ユースケース4:グラフとチャートの読み取り
棒グラフ・折れ線グラフ・テーブルからデータを抽出することは可能ですが、慎重なプロンプティングが必要です。 すべてのローカルVLMはグラフ読み取りで写真説明より弱く、抽出した数値は必ずソースデータと照合してください。
- 機能するもの: 軸ラベルの読み取り・傾向の特定・相対的なバーの高さの比較・明確なフォントのテーブル値の読み取り。
- 信頼性が低いもの: 連続グラフからの精密な数値抽出・ラベルなしの円グラフのパーセンテージ。
- プロンプト戦略: 「この折れ線グラフに示されている傾向を説明してください」は「2026年3月の正確な値は?」より効果的。
- グラフに最適なモデル: InternVL 2.5(強力なグラフ理解)、Gemma 4とQwen3-VL(明確にラベルされたグラフに良好)。
- 制限の注意: 2026年時点で、視覚的に複雑なグラフから精密な数値を確実に抽出できるローカルVLMはありません。
ユースケース5:動画フレーム分析
ローカルビジョンモデルは個別フレームを処理することで動画を分析できます — ffmpegでフレームを抽出し、ビジョンモデルで処理し、テキストLLMでフレーム全体をサマリー。リアルタイムではなく、モデルとハードウェアに応じて1フレームあたり0.5〜3秒かかります。
- フレーム抽出:
ffmpeg -i video.mp4 -vf fps=1 frames/frame_%04d.jpg(1fpsで抽出) - フレームごとの分析: 一貫したプロンプトで各フレームをビジョンモデルに送信(例:「このフレームで起きていることを1文で説明してください」)。
- クロスフレームのサマリー: すべてのフレーム説明を収集してテキストLLMにサマリープロンプトと共に渡す。
- ユースケース: セキュリティカメラレビュー(異常なアクティビティのフレームにフラグ)、講義録画分析(スライドごとのノート生成)、製造品質検査(欠陥のあるフレームにフラグ)。
- 動画フレームに最適なモデル: Gemma 4またはQwen3.8(品質 — どちらも動画をフレームとしてネイティブに受け付けます)、Qwen3.5 4BまたはLLaVA 1.6 7B(速度・高フレームスループット)。
- 速度の現実: 1フレーム/秒の抽出と1フレームあたり〜1〜3秒の推論では、10分の動画(600フレーム)の処理にモデルとGPUに応じて約10〜30分かかります。
import base64
import subprocess
import os
import requests

def extract_frames(video_path: str, output_dir: str, fps: int = 1) -> list[str]:
    os.makedirs(output_dir, exist_ok=True)
    subprocess.run([
        "ffmpeg", "-i", video_path,
        "-vf", f"fps={fps}",
        f"{output_dir}/frame_%04d.jpg",
        "-y"
    ], check=True)
    return sorted([
        os.path.join(output_dir, f)
        for f in os.listdir(output_dir)
        if f.endswith(".jpg")
    ])

def analyze_frame(image_path: str, model: str = "gemma4:e4b") -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")
    response = requests.post(
        "http://localhost:11434/api/generate",
        json={
            "model": model,
            "prompt": "Describe what is happening in this frame in one sentence.",
            "images": [image_b64],
            "stream": False,
        },
    )
    return response.json()["response"]

frames = extract_frames("lecture.mp4", "frames/", fps=1)
descriptions = [analyze_frame(f) for f in frames]
print("\n".join(f"[{i+1}s] {d}" for i, d in enumerate(descriptions)))
VRAMとパフォーマンスの現実
ローカルビジョンモデルはベースLLMにビジョンエンコーダーを追加するため、テキストのみのモデルと比べてVRAM要件と推論時間の両方が増加します。
モデル | VRAM (Q4) | トークン/秒 (RTX 4070) | トークン/秒 (M5 Pro 36GB) | 本番対応? |
|---|---|---|---|---|
| Moondream 2 (1.8B) | 〜2GB | 〜25〜35 | 〜30〜40 | はい — 単純なタスクに |
| LLaVA 1.6 7B | 〜6GB | 〜15〜20 | 〜18〜25 | はい — 汎用 |
| MiniCPM-V (8B) | 〜6GB | 〜12〜18 | 〜15〜20 | はい — OCRとドキュメント |
| Llama 3.2 Vision 11B | 〜8GB | 〜10〜14 | 〜12〜16 | まずOllamaのロード問題を確認 |
| LLaVA 1.6 13B | 〜10GB | 〜8〜12 | 〜10〜14 | はい — 12GB GPUで |
| Llama 3.2 Vision 90B | 55GB | N/A(マルチGPUまたはM-Max) | N/A(M5 Max 128GB+が必要) | ハイエンドApple Siliconのみ |
📌補足: トークン/秒の範囲は目安の推定値であり、新たな測定ではありません。Gemma 4、Qwen3.5、Qwen3.8では再計測していません。評価速度を表示するollama run <model> --verboseで、ご自身のハードウェアでベンチマークしてください。
📌補足: ビジョンモデルのトークン生成速度は、ビジョンエンコーダーが最初の画像トークンで大きな計算オーバーヘッドを追加するため、同サイズのテキストのみモデルより遅くなります。
📌補足: Apple Siliconのユニファイドメモリにより、ディスクリートGPU VRAMに収まらない大きなモデル(128GBのMacでLlama 3.2 Vision 90Bは55GB、Qwen3.5 122Bは81GB)を実行できます。NVIDIA GPUと比べて若干遅いですが、VRAM制限がありません。
ローカルVLM vs GPT-5.5 Vision比較
ローカルVLMは構造化ドキュメントでのギャップを大幅に縮めましたが、複雑で曖昧なタスクではGPT-5.5 Visionに後れを取っています。以下の比較は編集部の見立てであり、PromptQuorumのベンチマークではありません。
- 構造化ドキュメント(請求書・フォーム): 編集部の見立てであり、測定したベンチマークではありません。優れたローカルモデルは、きれいで形式が整ったドキュメントではGPT-5.5 Visionに近い結果を出します。出力を検証すれば本番利用にも十分です。
- 複雑なシーン・曖昧な画像: 珍しいコンテキスト、難しい照明、曖昧な内容の画像では、ローカルモデルはGPT-5.5 Visionに明確に劣ります(編集部の見立てで、測定値ではありません)。
- 手書き認識: ローカルモデルは特に草書体で著しく弱い。GPT-5.5 Visionは手書きを大幅に良く処理。
- グラフデータ抽出: 両方で信頼性が低いが、GPT-5.5は正確な数値でより精確。
- コスト: GPT-5.5 Vision:1枚あたり$0.01〜$0.03 vs ローカルは$0。月10,000枚 = $100〜$300の節約。
- プライバシー: ローカルモデルは既定でデバイス上で画像を処理する — クラウド機能や接続型ツールを有効にしない限り、画像はクラウドAPIに送信されない。GPT-5.5は画像をOpenAIサーバーに送信。
- 速度: ローカルモデル10〜20トークン/秒 vs GPT-5.5 30〜80トークン/秒、ただしローカルはバッチ処理でネットワーク遅延なし。
📌補足: クリーンな入力での請求書・フォーム処理なら、ローカルVLM(Gemma 4、Qwen3-VL 8B、Qwen3.8 27B)がGPT-5.5 Visionをゼロコストで代替できます。手書きや複雑なシーン分析にはGPT-5.5が依然として優位です。
LLaVA詳細解説
LLaVA(Large Language and Vision Assistant)は基盤となるオープンソースVLMアーキテクチャです。 2023年にウィスコンシン大学マディソン校とMicrosoft Researchによって公開されました。
- アーキテクチャ: CLIP ViT-L/14ビジョンエンコーダー + Llama-2またはMistralテキストデコーダー、シンプルな線形投影層で接続。
- LLaVA 1.5 vs 1.6: バージョン1.6(2024年初頭)は動的パッチングによる高解像度入力サポートを追加し、OCRとグラフ読み取り精度を大幅に向上。
- トレーニング: LLaVA-Instruct-150Kでインストラクションチューニング — 画像キャプションと物体検出アノテーションから生成された視覚的会話データセット。
- 強み: 幅広い一般知識・充実したドキュメント・大きなコミュニティ・豊富なOllama統合。
- 弱み: Qwen3-VLやMiniCPM-VよりOCRが弱く、InternVL 2.5よりUI分析が劣り、Gemma 4とQwen3ファミリーに全体的に上回られている。
- それでも推奨される理由: すべてのローカルVLMの中で最大のコミュニティ・最多のチュートリアル・最多のプロンプト例を持つ。問題が発生した時にサポートが見つけやすい。
- 詳細レビュー: LLaVAレビュー(2026) — Apache-2.0とベースモデルライセンスの微妙な違い、実際のOllamaコマンドを含むPromptQuorumの専用レビュー。
Qwen3-VL・Qwen3.5・Qwen3.8 — 最高の多言語OCR性能
Qwenファミリーは、2026年のドキュメントOCRと多言語テキストで最強のオープン選択肢です。 Qwen3-VL(2Bから235Bのサイズ)は専用のビジョンライン、Qwen3.5(0.8Bから122B)はベースモデルにビジョンを統合、Qwen3.8 27B(2026年8月、Apache 2.0)は最新で、OmniDocBench 1.5で91.1と報告されています。
- アーキテクチャ: 4096×4096までの動的解像度サポート — LLaVA 1.6(672×672)やLlama 3.2 Vision(1120×1120)より大幅に高い。高DPIスキャンをダウンサンプリングなしで読み取り可能。
- 多言語OCR: 中国語・日本語・韓国語・英語のOCRでクラス最高。大規模な多言語ドキュメントコーパスを含むトレーニングデータが、非英語ドキュメントでLLaVAやLlama 3.2 Visionに対して大きな優位性をもたらす。
- どのサイズを選ぶか: Qwen3-VL 8Bは6.2GBのダウンロードで8GBカード向け。Qwen3.5 9Bは6.6〜7.6GB。Qwen3.8 27Bは18GBで24GBカードが必要。Qwen3-VL 32Bは21GB。OllamaにQwen3-VLの72Bバリアントはありません。
- Qwen3-VL 4B: 3.3GBのダウンロード(256Kコンテキスト)。VRAM約4〜6GBのカード向けで、2B(1.9GB)と8B(6.2GB)の中間にあたります。
- Ollamaインストール:
ollama pull qwen3-vl:8b、ollama pull qwen3.5:9b、またはollama pull qwen3.8— いずれもOllamaモデルライブラリにあります。 - マルチ画像サポート: 1リクエストで最大8枚 — この比較で最高のマルチ画像容量。
- モデルページ: OllamaのQwen3-VL、Hugging FaceのQwen3.8-27B
ビジョンモデルの選び方
VRAMを最初の基準にしたローカルビジョンモデル選択のデシジョンツリー:
📍 一文で説明
まずVRAMで選択(2→4→8→24GB)、次にユースケースで絞り込む(OCR・UI・一般Q&A・最高品質)。
💬 簡潔に説明
4GB未満:Qwen3.5 2BまたはMoondream。8GB:写真にはGemma 4 E4B、ドキュメントにはQwen3-VL 8B。24GB:Gemma 4 26B/31BまたはQwen3.8 27B。64GB以上:Qwen3.5 122B。
- 4GB未満のVRAM: Qwen3.5 2B(2.7〜3.1GB)、Qwen3-VL 2B(1.9GB)、Moondream 2(1.7GB)が実用的な選択肢。PaliGemma 2(3B)とSmolVLM(2.2B)はコミュニティビルドの代替です。密なテキストOCRにはいずれも不向き。
- 6〜8GBのVRAM: 一般的な写真Q&AにはGemma 4 E4B、ドキュメントOCRと多言語テキストにはQwen3-VL 8BまたはQwen3.5 9B、コミュニティサポートが重要ならLLaVA 1.6 7B。
- 12〜16GBのVRAM: Gemma 4 12B(7.7〜8.0GBダウンロード)が明確な推奨 — サイズの割に高いビジョンスコア、音声入力、256Kコンテキストウィンドウを備えます。LLaVA 1.6 13BとInternVL 2.5 8B(UIとコードのスクリーンショット)も収まります。
- 24GBのVRAM: Gemma 4 26B A4B(16〜19GB)、Gemma 4 31B(19〜20GB)、Qwen3.8 27B(18GB)、Qwen3-VL 32B(21GB) — クラウド級のビジョン品質に最も近いローカルオプション。
- 96GB以上のユニファイドメモリ(Apple M-Max/Ultra、マルチGPU): 最大級のローカルモデルとしてQwen3.5 122B(81GB、128GBのMacが必要)またはLlama 3.2 Vision 90B(55GB)。どちらも高メモリのハードウェアが必要で、24GBクラスのモデルよりトークンあたりが低速です。
- 数値は必ず検証: モデルに関わらず、グラフやテーブルから抽出した数値は必ずソースデータと照合。ローカルVLMは視覚的グラフから精密な数値を幻覚することがあります。
よくある質問
llama3.2-visionが「unknown model architecture: mllama」で失敗するのはなぜですか?
最近のOllamaバージョンのllama3.2-visionでこのエラーが出るとの報告があります(GitHub issue #16490と#16547、2026年半ばに起票。後者は重複として閉じられ、修正は未確認)。報告ではOllamaの更新やモデルの再プルでは解決しませんでした。Llama 3.2 Visionに留まる必要がなければ、Ollamaライブラリで積極的にメンテナンスされているGemma 4またはQwen3-VLに切り替えてください。どうしても必要な場合は、まだロードできるOllamaバージョンに固定します。
3Bパラメータ未満で最良の小型ビジョン言語モデルは?
Ollamaで最強の小型オプションはQwen3.5 2B(2.7〜3.1GBダウンロード)とQwen3-VL 2B(1.9GB)で、最軽量はMoondream 2(1.8B、1.7GB)です。Gemma 4 E2B(実効パラメータ2.3B、4.6〜7.5GBダウンロード)は音声入力を追加します。8Bクラスと比べると、OCRと複雑なシーンの理解は弱くなります。
ライブのカメラ・マイク入力を扱えるローカルモデルは?
Gemma 4 E2B、E4B、12Bは画像と音声の両方を受け付けるため、見て聞けるローカルアシスタントの基盤に向いています。ただしモデル単体はライブシステムではありません。キャプチャループ(フレーム取得、音声のチャンク化)、音声認識または音声入力の経路、音声で返答するための音声合成が別途必要です。構築前に、お使いのランタイムのバージョンが実際にモデルへ音声を渡すか確認してください。
スクリーンショットやドキュメントから信頼できる構造化出力を得るには?
OllamaのformatフィールドにJSONスキーマを渡し、temperatureを0に設定し、画像に見えるフィールドだけを求めます。これにより返答は指定キーを持つ有効なJSONに制約されますが、値が正しくなるわけではありません。数値や日付は元データと照合し、失敗はログに残してください。スキーマへの追従は、2Bモデルより8B以上の大きなモデルの方が安定しています。
完全にデバイス上で動くGPT-4Vの代替は?
24GB GPUではGemma 4 31B(19〜20GB)、Qwen3.8 27B(18GB)、Qwen3-VL 32B(21GB)が最も近く、8GBのマシンはGemma 4 E4BとQwen3-VL 8Bがカバーします。いずれもOllama経由でオフライン動作します。クリーンなドキュメントと写真ではクラウドモデルに匹敵しますが、手書き・曖昧なシーン・複雑なインフォグラフィックスでは劣ります。
LLaVAやLlama 3.2 VisionはOllamaなしで使えますか?
はい。llama.cpp(ビジョンサポート付き)、transformersライブラリ(適切なモデルカード使用)、またはLM Studio(ビジョンモデルのGUI付き)を使って直接実行できます。Ollamaはシンプルさのために推奨されます。
Llama 3.2 VisionはPDF入力を直接サポートしていますか?
PDFを直接受け付けるローカルVLMはありません。まずPDFページを画像に変換(pdf2image、pypdfium2等)し、各ページを別個の画像リクエストとして送信する必要があります。
ローカルビジョンモデルはGPT-5.5 Visionとどう比較されますか?
GPT-5.5 Visionは曖昧なシーン・手書き・複雑なインフォグラフィックスで依然として大幅に優れています。Gemma 4とQwen3-VLは構造化ドキュメントでGPT-5.5に近づきますが、曖昧な画像での推論には後れを取ります。コスト・プライバシー・速度の詳細な比較は上記を参照してください。
ローカルVLMはどの画像解像度をサポートしていますか?
LLaVA 1.6は動的パッチングで最大672×672。MiniCPM-Vは最大1344×1344 (≈1.8 MP) — 高DPIドキュメントスキャンでLLaVAを上回る理由の一つ。Llama 3.2 Visionは最大1120×1120。Gemma 4とQwen3-VLは可変のアスペクト比と解像度を受け付けます。最良のOCR結果のためにドキュメント画像は150+ DPIで送信してください。
ローカルビジョンモデルを独自の画像でファインチューニングできますか?
はい、ただしVLMのファインチューニングはテキストのみのLLMより資源集約的です。LLaVAのファインチューニングはオリジナルのトレーニングコードベースを使って文書化されています。MiniCPM-VはHugging Faceの公式スクリプトでファインチューニングをサポート。ほとんどのユースケースにはプロンプトエンジニアリングだけで十分です。
8GB VRAMに最適なローカルビジョンモデルは?
一般使用にはGemma 4 E4B(6.6〜9.5GBダウンロード)、ドキュメントOCRや多言語テキストが主な用途ならQwen3-VL 8B(6.2GB)。両方ともOllamaで単一コマンドで利用可能です。Qwen3.5 9B(6.6〜7.6GB)が3つ目の選択肢です。
LLaVA vs MiniCPM-V — OCRにはどちらが優れていますか?
MiniCPM-VはドキュメントOCR、特に密なテーブルと高DPIスキャンでLLaVAより精確ですが、OCRではQwen3-VL 8Bの方がどちらよりも強力な選択です。LLaVA 1.6はより文書化されていてコミュニティサポートが充実しています。なお、Ollamaのminicpm-vページは今もMiniCPM-V 2.6(5.5GB)を説明しており、新しいMiniCPM-VのリリースにはHugging Faceまたはllama.cppのビルドが必要です。
ローカルビジョンモデルは手書きを読めますか?
活字体の手書き(ブロック体):Gemma 4、Qwen3-VL、MiniCPM-Vで中程度の精度で認識可能。草書体:すべてのローカルモデルで信頼性が低い。GPT-5.5 Visionは草書体で大幅に優れています。草書体ドキュメントの本番手書きOCRにはクラウドAPIが依然として推奨されます。
Ollama以外に、llama.cppやvLLMで動くローカルビジョンモデルは?
いくつかあります。llama.cppのマルチモーダル文書には、すぐ使えるGGUFビルドとしてGemma 3、Gemma 4(E2B、E4B、26B A4B、31B)、InternVL 2.5と3、Moondream 2、SmolVLMなどが載っており、llama-serverはOpenAI互換APIで提供できます。vLLMの対応モデル一覧には、Gemma 4、Qwen3-VL、Qwen3.5、MiniCPM-V、InternVL、LLaVA-NeXTが載っています。対応状況はモデルとバージョンごとに異なるため、採用前に両ページで実際に使うモデルを確認してください(確認日:2026年10月23日)。ダウンロード、量子化、APIを1つのツールで扱えるため、最も手軽なのは引き続きOllamaです。
ビジョンモデルでは、量子化によってVRAM使用量と品質はどれくらい変わりますか?
量子化で主に変わるのはメモリ量です。Ollamaでは、Gemma 4 E4Bはq4_K_Mで6.6GB、q8_0で9.0GB、bf16で16GB、Gemma 4 31Bは20GB、34GB、63GBです。デフォルトのタグは通常q4_K_Mのサイズに近く、上の表のVRAM列が4ビットの値になっているのはそのためです。GoogleのQAT版はやや小さく、gemma4:e4b-it-qatは6.1GBです。精度を上げるとメモリと速度を消費します。結果が良くなるかどうかはモデルとタスク次第で、当サイトでは測定していないため、自分の画像サンプルでq4_K_Mとq8_0を比較してください。コンテキスト用に1〜2GBを加えてください。
Apple SiliconのMacでは、どのローカルビジョンモデルを動かすべきですか?
OllamaはApple Silicon向けのMLXビルドを公開しています:gemma4:e4b-mlx(9.5GB)、gemma4:12b-mlx(7.7GB)、gemma4:26b-mlx(18GB)、gemma4:31b-mlx(19GB)、qwen3.8:27b-mlx(18GB)。ユニファイドメモリには重みに加えてmacOSとコンテキストも収める必要があります。目安として(当サイトの容量の目安であり、ベンチマークではありません):まずmacOS分として8GBを差し引きます。16GBのMac(使用可能は約8GB)ならQwen3-VL 8B(6.2GB)、24GB(使用可能は約16GB)ならGemma 4 E4BまたはGemma 4 12B、32GB(使用可能は約24GB)なら18GBの26B A4Bビルド、Gemma 4 31B、Qwen3.8 27Bが候補ですが、コンテキスト用に残るのは約4〜6GBです。
VRAM 16GB、RAM 32GB、VRAM 2GBのGPUでは、どのローカルビジョンモデルが最適ですか?
VRAM 2GB:Moondream 2(1.7GB)またはQwen3-VL 2B(1.9GB)。単純な画像向けです。約4GB:Qwen3-VL 4B(3.3GB)。VRAM 16GB:Gemma 4 12B(7.7〜8.0GB)で、長いコンテキスト用の余裕もあります。Gemma 4 26B A4Bのダウンロード(16〜19GB)は完全には収まらず、Ollamaが一部のレイヤーをシステムRAMに移すため遅くなります。VRAM 24〜32GB(例:RTX 5090):Gemma 4 31B、Qwen3.8 27B、Qwen3-VL 32B。GPUなしでRAM 32GBの場合はCPUで動作します。8Bクラス(Qwen3-VL 8B、Gemma 4 E4B)にとどめ、GPUよりかなり遅くなることを見込んでください。
Gemma 5や、Gemma 4・Qwen3.8より新しいビジョンモデルはありますか?
2026年10月23日に確認した情報源には見当たりませんでした。Ollamaにgemma5のページはなく、gemma4のページにはE2B、E4B、12B、26B、31Bのビルドが並び、Qwen3.8 27Bは本ガイドで扱う最新のQwenモデルです。新モデルは頻繁に登場するため、採用前にOllamaライブラリのビジョンモデル一覧を確認し、未公開モデルに関する情報は未確認として扱ってください。
参考資料
- Hugging FaceのGemma 4モデルカード — GoogleのApache 2.0ライセンス、サイズ別の対応モダリティ、MMMU Proの結果。
- OllamaのGemma 4 — タグ、ダウンロードサイズ、コンテキストウィンドウ。
- Hugging FaceのQwen3.8-27B — Apache 2.0ライセンス、262Kコンテキスト、OmniDocBench 1.5の結果。
- OllamaのQwen3.5とOllamaのQwen3-VL — サイズとダウンロードサイズ。
- OllamaのLlama 3.2 VisionとOllama issue #16547 — リストと、報告されているmllamaロードエラー。
- LLaVAプロジェクトページ — LLaVA 1.5・1.6モデルカード、アーキテクチャの詳細、トレーニングデータセットの説明。
- OllamaのMiniCPM-VとHugging FaceのOpenBMB — モデルカードとOCRベンチマーク。
- OllamaのMoondreamとGitHubのMoondream — モデルダウンロードと推論スクリプト。
- Hugging FaceのInternVL 2.5 — OpenGVLabモデルカード、ドキュメントとUIタスクのベンチマーク。
- Ollamaドキュメント — ビジョンモデルサポート、構造化出力、APIリファレンス、モデルライブラリ。
- Hugging FaceのPaliGemma 2 — GoogleのPaliGemma 2 3Bモデルカード。
- Hugging FaceのSmolVLM — HuggingFaceのSmolVLMモデルカードと推論手順。
- llama.cppのマルチモーダル文書 — 対応ビジョンモデルとllama-serverの使い方。
- vLLMの対応モデル — vLLMで提供できるマルチモーダルアーキテクチャ。
- OllamaのGemma 4タグ — q4_K_M、q8_0、bf16、QAT、MLXビルドのサイズ。