クイックファクト
- iPadアプリ: PocketPal AI(無料、MIT)、Locally AI(無料+有料オプション、MLX)、Google AI Edge Gallery(無料、Apache 2.0)。LLM Farm(無料、MIT、iOS専用)は2025年8月にApp Storeから削除され、現在はソースからビルドする必要があります。
- Androidの方法: PocketPal AIまたはGoogle AI Edge Gallery(アプリ、ターミナル不要)、あるいはTermux + Ollama(CLI)。
- リモート接続: あらゆるタブレットブラウザ → ホームマシンのローカルIPでOpen WebUIまたはシンプルなチャットUI。OllamaにはネイティブなiPadOSビルドがないため、iPadユーザーもこの方法でOllamaを利用します。
- オンデバイスの最低要件: iPad Air M4(12GB)で3B〜4Bモデル;iPad Pro M5(12GB / 16GB)で7B〜8Bモデル。
- Androidオンデバイスの最低要件: RAM 8GBデバイス(Samsung Galaxy Tab S10+、OnePlus Pad 2)。
- 最適オンデバイスモデル: ほとんどのタブレットにPhi-4 Mini(3.8B、2.7GB);非常に制約があるデバイスにはQwen3 1.7B。
- リモート接続速度: タブレットのハードウェアではなく、Wi-Fi品質とホームマシンの生成速度に依存します。
2つのモード:オンデバイスvsリモート接続
最も重要な判断はどのアプリを使うかではなく、タブレットで推論するかホームの高性能マシンで推論するかです。 各モードには異なるハードウェア要件と性能上限があります。
📍 一文で説明
タブレットでのAI実行には2つの実用的なモードがあります:オンデバイス推論(タブレットチップでモデル実行、3B〜7Bに限定)またはリモート接続(OllamaとOpen WebUIで大型モデルを実行するホームMac・PCのブラウザ表示端末としてタブレットを使用)。
💬 簡潔に説明
オンデバイスモード:モデルがタブレット上に存在し、オフラインで動作します。小型モデル(3B、高性能iPad Proなら7B)に限定され、クラウドAIより低速です。リモートモード:ホームのMacまたはPCがOllamaと70Bモデルを実行し、タブレットはブラウザでチャットを表示するだけ。タブレット画面で70Bの品質を得られ、タブレットにモデル保存不要、ホームマシンは電源オンで同じWi-Fiに接続している必要があります。オフライン利用が特に必要でない限りリモート接続を選んでください。
項目 | オンデバイス | リモート接続 |
|---|---|---|
| モデルサイズ上限 | 3B〜8B(iPad Pro M5);3B〜4B(ほとんどのタブレット) | 無制限 — ホームマシンがどのモデルも実行可能 |
| オフライン利用 | 可能 — Wi-Fi不要で動作 | 不可 — ホームWi-Fi必須 |
| 生成速度 | 中程度(iPad Pro M5で12〜30トークン/秒) | ホームマシン次第(最大40+トークン/秒) |
| タブレット上のストレージ | モデルあたり2〜10GB | なし — モデルはホームマシン上 |
| セットアップの複雑さ | 低(アプリ+モデルファイルのダウンロード) | 低〜中(ホームマシンにOllama+Open WebUI必要) |
| 最適な用途 | 旅行、オフライン利用、3Bモデルのタスク | 品質優先利用、70Bモデル、利便性 |

💡ヒント: Ollamaを実行できるMacまたはPCがすでにある場合は、リモート接続から始めてください。タブレットにモデルファイルを保存したり、モバイルアプリの制限に対処したりすることなく、すぐに高品質を得られます。後でオフライン利用が必要になった場合にオンデバイス機能を追加してください。
iPad:オンデバイス推論
iPad Pro M5は7B〜8Bモデルに最も適したiPadです。 AppleはM5 iPad Proのベースメモリを従来のM4 iPad Proベースモデルの8GBから12GBに引き上げ(1TB/2TBストレージモデルは16GB)、メモリ帯域幅を120GB/sから153GB/sに向上させました — Apple SiliconでのLLM推論はメモリ帯域幅に律速されるため、これは直接的な生成速度の向上につながります。iPad Air M4(12GB、M3 Airの8GBから増加)は、3B〜4Bモデルを「適切」ではなく「快適」に実行できるようになりました。iPad Air M3(8GB)とその他の8GB iPadは、Q4で1B〜3Bモデルに限られます。8GB RAM iPhoneもLLM Farm経由で小型モデルを実行できます。
- PocketPal AI(無料、オープンソースMIT、iOS + Android):llama.cpp経由でGGUFモデルを実行し、アプリ内でHugging Faceからモデルをダウンロードするかファイルをインポートでき、お使いのタブレットのトークン/秒を自分で測れるベンチマーク機能を内蔵しています。最終アップストリーム更新:2026-10-19。PocketPal AIレビューを参照。
- Locally AI(無料、有料オプションあり、クローズドソース、iPhone/iPad/Mac):Apple Silicon向けに作られたAppleのMLXフレームワークでオープンモデルを実行します。最終App Store更新:2026-10-15。Locally AIレビューを参照。
- Google AI Edge Gallery(無料、Apache 2.0、iOS + Android):LiteRT-LMランタイム上でGemmaモデルを動かすGoogleのオンデバイスアプリ。最終アップストリーム更新:2026-10-23。Google AI Edge Galleryレビューを参照。Gemma 4(E2BとE4B)、Googleの最新の小型オンデバイスモデルも動かせます。
- LLM Farm(無料、MIT、iOS専用):Appleが2025年8月にApp Storeの掲載を削除し、プロジェクトのREADMEもApp StoreとTestFlightの両方を「一時的に利用不可」としています — 唯一の方法はXcodeでソースからビルドすることです。最終アップストリーム更新:2026-01-30で180日以上前のため、メンテナンスされていない可能性があります。利用前にリポジトリを確認してください。LLM Farmレビューを参照。
- モデルのインポート: PocketPal AIでは、アプリ内でHugging FaceからGGUFモデルをダウンロードするか、Apple Filesで転送したGGUFファイルをインポートします。モデルはアプリのローカルストレージに保存 — iCloudではありません。
- iPadのRAM管理: iOSはバックグラウンドアプリのRAMを積極的に管理します。12GB iPadで7Bモデルを実行する前に他のすべてのアプリを閉じてください — 別のアプリがメモリを必要とするとiOSがモデルを削除します。16GB iPad Pro M5(1TB/2TBモデル)ではほとんど問題になりません。
- 生成速度の目安(概算値でありPromptQuorumのベンチマークではありません — お使いのデバイスの実測にはPocketPal AIの内蔵ベンチマークを使用してください): iPad Pro M5(12GB / 16GB):Phi-4 Mini 約25トークン/秒、Llama 3.2 3B 約38トークン/秒、Gemma 3 4B 約23トークン/秒 — メモリ帯域幅の向上に応じ、前世代M4より約25〜30%高速。iPad Air M4(12GB):3B〜4Bモデル 約15〜20トークン/秒;7Bモデル 約7〜10トークン/秒(依然リアルタイムチャットには低速)。
- エントリーモデルおよびRAM 8GB以下のiPad: Q4で1B〜3Bモデルを使うか、iPadをリモート接続の表示端末として扱ってください。モデルが空きRAMに収まらない場合、iPadOSは緩やかに遅くなるのではなくアプリを終了します。

⚠️注意: 12GB iPad Airでリアルタイムチャット用に7Bモデルを実行しようとしないでください。毎秒7〜10トークンでは、各レスポンスに依然10〜20秒かかります。プロンプトを送信して待つ要約タスクには使えますが、会話型利用には苛立たしい速度です。iPad Airでは3B〜4Bモデルを使用し、7B以上には16GB iPad Pro M5へのアップグレードまたはリモート接続に切り替えてください。
Android:オンデバイス推論
Androidのオンデバイス推論はTermux + Ollamaを使用します — TermuxはAndroidでOllamaをネイティブ実行するLinuxターミナルエミュレーターです。 iPadのアプリ体験より技術的ですが、完全なOllamaエコシステムへのアクセスが可能です。
- Termuxより簡単な代替手段: PocketPal AI(Google Play、無料、MIT;最終アップストリーム更新2026-10-19)とGoogle AI Edge Gallery(無料、Apache 2.0;最終アップストリーム更新2026-10-23)は、ターミナルなしでオンデバイスモデルを実行できます。特にOllamaが必要でない限り、まずこれらのどちらかから始めてください。PocketPal AIレビューを参照。
- 3B以上のモデルに対応するデバイス: RAM 8GB最低限(Samsung Galaxy Tab S10+、OnePlus Pad 2、Xiaomi Pad 7 Pro)。6GBデバイスはQwen3 1.7Bのみ実行可能。
- Pixel Tabletはオンデバイスに非推奨: Pixel Tablet(2023年モデル、8GB Tensor G2)は推奨リストから除外 — Tensor G2はSnapdragon 8 Gen 3 / Dimensity 9300よりLLM推論が大幅に低速で、Phi-4 Miniで4〜7トークン/秒(会話型利用には低速すぎる)。Pixel Tabletユーザーはホームマシンへのリモート接続を使用してください。
- Snapdragon 8 Gen 3とDimensity 9300は2026年のオンデバイス推論で最速のAndroidチップです。生成速度:1.7Bモデルで約15〜25トークン/秒;3Bモデルで約8〜12トークン/秒。
- モデルストレージ: Androidは統合メモリを持たないため、ほとんどのTermux設定ではGPUアクセラレーションなしでシステムRAM上でモデルが実行されます。GPUアクセラレーションにはTermux:NVIDIAまたは特定のVulkanビルドが必要;セットアップがより複雑です。
- 代替アプリ: MNN LLM(Alibaba製、無料、選択されたモデルのオンデバイス推論Androidアプリ)はセットアップが簡単ですが、Ollamaよりモデル選択が限定的です。AI RunnerとllamafileもさまざまなサポートのAndroidビルドがあります。LLM FarmにAndroid版は存在しません — iOS専用アプリであり、PocketPal AIが最も近いAndroidの代替手段です。
- その他のブランド(Huawei MatePad、Xiaomi Pad、Galaxy Tab Aシリーズ): 決め手はブランドではなくRAMとチップです。設定でタブレットのRAMを確認してください:6GB未満なら1B〜1.7Bモデルにとどめるかリモート接続を使用;8GB以上ならモデル表の8GBの行に従ってください。
- ハードウェア互換性表付きの日本向けXperia設定ガイドについては、<a href="/ja/prompt-bites/run-local-llm-on-xperia-japan" class="text-primary hover:underline">XperiaでローカルLLMを動かす方法</a>をご覧ください。
- 1F-DroidからTermuxをインストールします(Play Store版は不可 — 古く、必要なパッケージが不足しています)。
- 2Termuxで:
pkg update && pkg upgrade - 3TermuxのパッケージリポジトリからOllamaをインストール:
pkg install ollama(Goでソースからビルドする古いガイドは、もう不要です)。 - 4モデルをプル:
ollama pull phi4-miniまたはollama pull qwen3:1.7b。 - 5サーバーを起動:
ollama serve(このTermuxセッションを維持してください)。 - 6Termux経由でチャット:
ollama run phi4-mini— またはブラウザを開いてhttp://localhost:11434にアクセスしてAPIを利用。GUIのためにローカルOllamaエンドポイントに接続するAndroidチャットアプリをインストール。

💡ヒント: Termux:Widgetアドオンをインストールし、「ollama serve」を実行するショートカットを作成してください — Termuxを手動で開かずにAndroidのホーム画面からOllamaサーバーを起動できます。Ollamaが起動したら、localhost:11434に接続するよう設定されたチャットアプリを開いてください。
ホームマシンへのリモート接続
ほとんどのタブレットユーザーに最もシンプルなセットアップ:ホームのMacまたはPCでOllamaとOpen WebUIを実行し、同じWi-FiネットワークのタブレットブラウザからチャットUIにアクセスする方法です。 タブレットは自宅でOllamaを実行するより高性能なマシンのタッチスクリーンインターフェースになります — ホームマシン選択時のハードウェアサイジングにはラップトップガイドを参照してください。
📍 一文で説明
OllamaとOpen WebUIを実行するホームマシンへのリモート接続により、どのタブレットでもブラウザ経由で70Bモデルへのフルアクセスが可能 — タブレットにモデル保存なし、アプリインストールなし、モデル品質への妥協なし。
💬 簡潔に説明
MacまたはPCで:Ollamaをインストール、モデルをプル、Open WebUIをインストール(Docker一行コマンド)、ローカルネットワークIPにバインドして実行。タブレットで:SafariまたはChromeを開き、http://[Mac-IP]:3000 に移動すると、フルAIチャットインターフェースが使えます。モデルはMac上で実行;タブレットはチャットを表示するだけ。どのタブレット、OS、画面サイズでも機能します。
- 1ホームマシン上で: Ollamaをインストール(macOSでは
brew install ollama、Windowsではollama.comからダウンロード)。モデルをプル:ollama pull llama3.3:70b(または任意のモデル)。ネットワークバインドでOllamaを起動:OLLAMA_HOST=0.0.0.0:11434 ollama serve。 - 2Open WebUIをインストール(最もタブレット向けのチャットUI):
docker run -d -p 3000:8080 -e OLLAMA_BASE_URL=http://host.docker.internal:11434 --name open-webui ghcr.io/open-webui/open-webui:main。Open WebUIは`http://[マシンIP]:3000`でアクセス可能になります。 - 3ホームマシンのローカルIPを確認: macOSでは、システム設定 → ネットワーク → 現在のネットワーク → IPアドレス。Windowsでは、コマンドプロンプトで
ipconfigを実行してIPv4アドレスを確認。IPをメモ(通常192.168.x.x)。 - 4タブレット上で: Safari(iPad)またはChrome(Android)を開く。`http://[マシンIP]:3000`に移動。Open WebUIでアカウントを作成(ローカルのみ、クラウドなし)。ドロップダウンからモデルを選択。チャット開始。
- 5セキュリティ: このセットアップはローカルネットワーク限定です。Open WebUI認証を追加せずにポート3000をインターネットに公開しないでください(組み込みの管理者アカウントシステムがあります)。接続はプレーンHTTP — 公共Wi-Fiで機密情報を送信しないでください。

💡ヒント: ホームマシンのOpen WebUI URLをタブレットのホーム画面にブックマーク追加してください(Safariでは:共有 → ホーム画面に追加;Chromeでは:三点メニュー → ホーム画面に追加)。ネイティブアプリのような感覚になります。iPadでは、SafariのフルスクリーンWebアプリはブラウザのクロームを隠し、アプリのような体験が得られます。
デバイス別モデル推奨
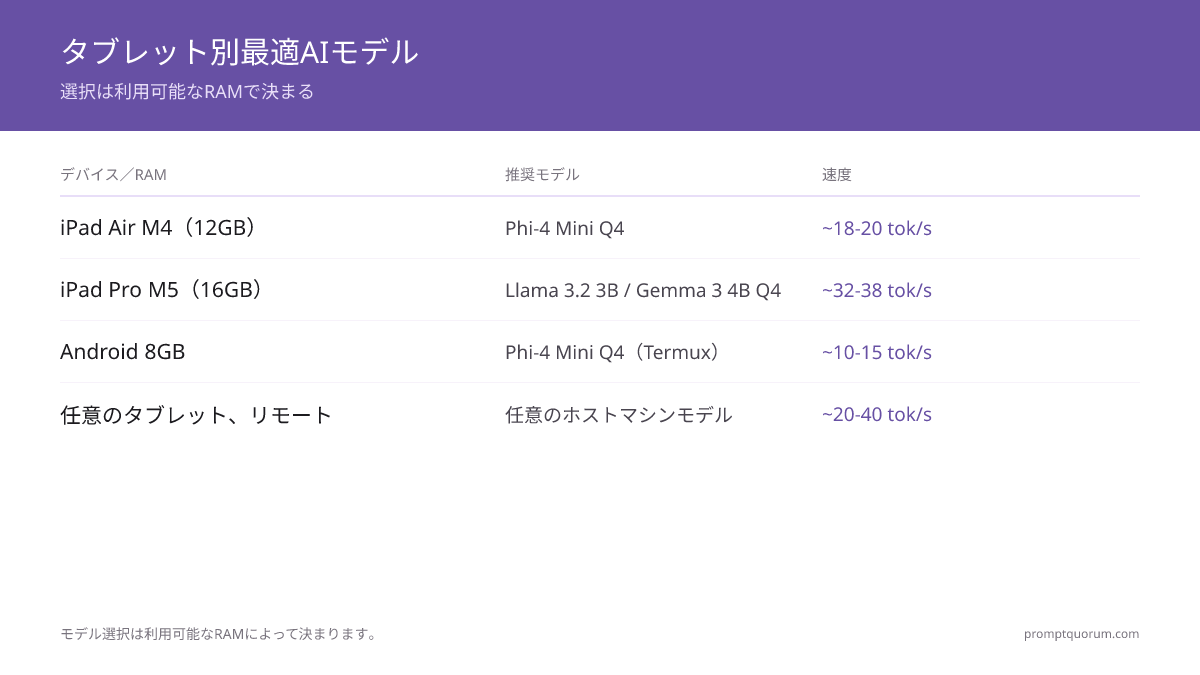
モデルの選択は好みではなく、利用可能なRAMによって決まります。 以下の表は、デバイスのRAMをリアルタイム速度(8トークン/秒以上)で実行できる最大モデルにマッピングしています。モデル層について詳しくはモバイルLLMモデルベスト2026を参照。すべてのハードウェア層のモデル全体像はベストローカルLLM 2026を参照。
デバイス / RAM | 推奨モデル | 速度 | 最適な用途 |
|---|---|---|---|
| iPad Air M4(12GB) | Phi-4 Mini Q4 / Llama 3.2 3B Q4 | 約18〜20トークン/秒 | 文章作成補助、要約 |
| iPad Air M3 / その他8GB iPad | Llama 3.2 3B Q4 / Qwen3 1.7B | 約10〜18トークン/秒(概算) | 軽い下書き、要約 |
| iPad Pro M5(12GB / 16GB) | Llama 3.2 3B / Gemma 3 4B Q4 | 約32〜38 / 約20〜23トークン/秒 | 本格的LLMワークステーション、RAG、フィクション執筆 |
| Android 8GB(Tab S10+) | Phi-4 Mini Q4(Termux+Ollama) | 約10〜15トークン/秒 | Termuxに慣れたパワーユーザー |
| Android 6GB | Qwen3 1.7B Q4 | 約15〜20トークン/秒 | 軽いチャット、翻訳、シンプルなタスク |
| Pixel Tablet(8GB) | リモート接続のみ | N/A | Tensor G2はオンデバイスに低速すぎる |
| iPad mini 7(A17 Pro、8GB) | Llama 3.2 3B Q4 / Qwen3 1.7B | 未計測 | 軽い下書き、要約 |
| iPad A16(6GB)/ iPad 第10世代(4GB) | Qwen3 1.7B Q4以下 | 未計測 | 短い質問。それ以上はリモート |
| Galaxy Tab S11 Ultra(12GB / 16GB) | Gemma 4 E4B / Phi-4 Mini Q4 | 未計測 | マルチタスク(16GB構成) |
| リモート経由の全タブレット | ホームマシン上の任意モデル | 約20〜40トークン/秒 | 品質優先利用、70Bモデル |

💡ヒント: ほとんどの日常タスク(文章草稿、質問回答、内容要約)では、タブレット上のPhi-4 Mini(3.8B)は十分に実用的です。70Bモデルと比較して劣る点:複雑な多段階推論、ニュアンスのある創作、長文書分析。これらのタスクには大型モデルを実行するホームマシンへのリモート接続を使用してください。
タブレット向けローカルAIフロントエンド
タブレットで使用するチャットインターフェースは使いやすさに大きく影響します。 モバイル向けに設計されたものもあれば、デスクトップファーストでタブレットでは使いにくいものもあります。
- Open WebUI(ブラウザ): 一般的なチャットに最適なモバイル対応WebUI。SafariまたはChromeの任意のローカルIP:ポートで動作。タブレットのアスペクト比にきれいに適応。リモート接続セットアップに推奨。
- PocketPal AI(iPad・Androidアプリ): 無料、オープンソース、GGUFモデルをインポートでき、ベンチマーク機能を内蔵。両プラットフォームで最も柔軟なオンデバイスオプション。
- Locally AI(iPadアプリ): MLX上に構築されたAppleらしいすっきりしたインターフェース。iPadで技術に詳しくないユーザーにとって最もシンプルな初回体験。
- Google AI Edge Gallery(iPad・Androidアプリ): GoogleのGemmaに特化したアプリ。Googleの小型モデルをオンデバイスで試す最も簡単な方法。
- RisuAI(ブラウザ、モバイル対応): ロールプレイとキャラクターカードフィクションの最高モバイル体験。リモートOllamaインスタンスに接続可能。iPad Safariでアプリに近い品質のインターフェースで動作。
- SillyTavern(ブラウザ): リモートOllamaインスタンスに接続したiPad Safariで動作。モバイル最適化されていないが機能的。一部の拡張機能はモバイルSafariで動作しません。
- Termux CLI(Android): コマンドラインのみ。スクリプト化されたタスクに使えますが、コンパニオンアプリなしでの会話型利用には実用的でありません。
💡ヒント: iPadでのロールプレイとキャラクターカードフィクションには、Llama 3.3 70Bを実行するリモートOllamaインスタンスに接続したRisuAIが2026年における有力な組み合わせです。RisuAIのモバイルインターフェースはタッチ操作向けに設計されており、リモート接続によりタブレットに収まるどのモデルよりも大幅に優れたキャラクターボイスを生み出す70Bモデルにアクセスできます。
日本・東アジアユーザーのための活用ポイント
日本のユーザーにとって、タブレットでのローカルAI実行には規制面での追加的な意義があります。経済産業省(METI)は2024年のAIガバナンスガイドラインで、企業データを処理するAIシステムにおけるローカル推論アーキテクチャを推奨しています。 タブレット上またはホームマシンへのリモート接続でのローカル推論は、クラウドAPIへのデータ送信なしにこれらの要件を満たします。
- METI AIガバナンス2024: 経済産業省のガイドラインは、機密性の高い業務データを扱うシステムにローカル推論を推奨します。iPad Pro M5やAndroidタブレットのローカルモデルは、顧客データを海外クラウドに送信せずに動作します。
- 東アジアのデータ主権: 日本、マレーシア、シンガポール、韓国はデータローカリゼーション要件を強化しています。タブレットのローカル推論またはローカルネットワークリモート接続はデータを国境内に保持します。
- エンタープライズセキュリティ: 日本の企業セキュリティ標準(ISMS、ISO 27001)はデータ処理の文書化を求める場合があります。タブレット上または自社ネットワーク内で実行されるローカルモデルは、データの流れを説明しやすくなることがありますが、ISMSやISO 27001への適合を保証するものではありません。
💡ヒント: METI AIガバナンスへのコンプライアンスを検討している日本企業の場合:iPad Pro M5とOllamaを使ったローカル推論のプルーフオブコンセプトをCISO・法務部門とともに実施することをお勧めします。オープンソースライセンス(Meta、Alibaba)とローカルネットワークアーキテクチャにより、規制当局への文書化が簡素化されます。
よくある失敗
- App StoreでLLM Farmを探す。 Appleは2025年8月に削除しました。PocketPal AIまたはLocally AIを使うか、LLM Farmをソースからビルドしてください。
- 8GBタブレットで7Bモデルを実行する。 毎秒5〜8トークンでは会話型利用には低速すぎます。8GBデバイスのオンデバイスチャットには3Bモデルを使用;7B以上の品質にはリモート接続を使用してください。
- AndroidでPlay Store版Termuxを使用する。 Play Store版のTermuxは古く、Ollamaに必要なパッケージが不足しています。常にF-DroidからTermuxをインストールしてください。
- 認証なしにOpen WebUIをインターネットに公開する。 Open WebUIにはデフォルトでパスワードがありません。ホームネットワーク外に公開すると、URLを見つけた誰もがモデルにアクセスできます。管理者アカウントシステムを有効にしてファイアウォールを使用してください。
- 8GB iPad でオンデバイス前に他のアプリを閉じない。 iOSはバックグラウンドアプリのRAMを削除します。8GB iPadの3Bモデルは約3.5GBを使用;iOSが別のアプリのためにそのメモリを回収するとモデルがクラッシュします。推論前にすべての他のアプリを閉じてください。
- モバイルブラウザでデスクトップ品質のUIを期待する。 SillyTavernなどはデスクトップファーストです。ブラウザでのモバイル体験は機能的ですが洗練されていません。モバイルファーストUXにはRisuAIまたはOpen WebUIを好んでください。
- ブラウザに
ipad.localと入力する。 Safariに入力するのは、自宅マシンのIPアドレスまたはホスト名です(例:192.168.1.20:3000、my-mac.local:3000)。タブレット自身の名前ではありません。ipad.localのような名前はタブレットを指し、Ollamaが動いているマシンを指しません。
参考資料
- LLM Farm(iOS)ドキュメントとGitHub — github.com/guinmoon
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai
- Locally AI — App Storeの掲載ページ
- Google AI Edge Gallery — github.com/google-ai-edge/gallery
- TermuxのOllamaパッケージ — Termux(TermuxはF-Droidからインストール)
- Termux向けOllama ARMビルド — Ollamaドキュメント
- Open WebUIドキュメント — docs.openwebui.com
- Apple M5チップのiPad Pro向け仕様、RAM容量、メモリ帯域幅 — Apple Newsroom、2025年10月
- Apple M4チップのiPad Air向け仕様とRAM — Apple Newsroom、2026年3月
- Gemma 4のモデル概要とメモリ要件 — Google AI for Developers
- Samsung Galaxy Tab S11 Ultraのチップ・RAM構成 — GSMArena
よくある質問
iPadでAIを実行できますか?
はい、iPad Pro M5(ベース12GB / 1TB・2TBモデルは16GB)とiPad Air M4(12GB)で可能です。iPad Pro M5はPocketPal AIまたはLocally AIでPhi-4 MiniとLlama 3.2 3Bをリアルタイム速度で実行し、メモリ帯域幅の向上(153GB/s対120GB/s)により前世代のM4 iPad Proより約25〜30%高速です。iPad Air M4は3B〜4Bモデルを快適に実行します。iPadで7B以上のモデルには、Ollamaを実行するホームMacまたはPCへのリモート接続を推奨します — iPadはチャットを表示し、ホームマシンが推論を処理します。
iPadでOllamaは動作しますか?
いいえ — OllamaはサポートされているiPadOSビルドを持たないため、AndroidのTermuxのようにiPadへ直接インストールすることはできません。「iPadでOllamaを実行する」とは、MacまたはPCでOllamaを動かし、iPadのブラウザから(ホームマシンのローカルIPでOpen WebUI経由で)接続することを意味します — iPadは推論エンジンではなく表示端末です。iPadで真のオンデバイス推論を行うには、代わりにPocketPal AI(llama.cpp経由のGGUFモデル)やLocally AI(MLXモデル)などのオンデバイスアプリを使用してください。
AndroidタブレットでAIを実行できますか?
はい、PocketPal AIまたはTermux + Ollamaを使用してRAM 8GB以上のデバイスで可能です。Samsung Galaxy Tab S10+(RAM 12GB)はPhi-4 Miniを約10〜15トークン/秒で実行します。RAM 6GBデバイスはQwen3 1.7Bを実行できます。セットアップにはF-DroidからのTermuxといくつかのターミナルコマンドへの慣れが必要です。ほとんどのAndroidタブレットユーザーにはホームマシンへのリモート接続の方が簡単なルートです。
タブレットのオンデバイスAIはインターネットなしで動作しますか?
はい。モデルをダウンロードしてアプリをインストールすれば、iPadのオンデバイス推論(PocketPal AI、Locally AI)とAndroid(Termux + Ollama)はインターネット接続なしで動作します。これがリモート接続に対するオンデバイスの主な利点の一つです — リモート接続アプローチにはホームWi-Fiが必要です。
iPadに最適なAIアプリは何ですか?
オンデバイス推論には:PocketPal AI(オープンソース、任意のGGUFモデルをインポート可能)またはLocally AI(最もシンプルなUI、MLX)。LLM FarmはApp Storeではもう入手できません。ホームOllamaサーバーへのリモート接続には:Open WebUI in Safari(一般チャットに最適)、RisuAI in Safari(ロールプレイとキャラクターフィクションに最適)。最適な選択は、オンデバイス機能、オフライン利用、または最高のインターフェース品質が欲しいかどうかによって異なります。
AndroidでTermux + Ollamaを使うのは安全ですか?
はい。Termuxは何百万人もの開発者が使用する確立されたAndroidターミナルエミュレーターです。Termux内のOllamaはローカル専用APIを提供します(デフォルトでlocalhost:11434)— バインドアドレスを明示的に変更しない限り、ネットワーク上の他のデバイスからはアクセスできません。モデルファイルはTermuxのプライベートストレージに保存され、共有Androidストレージには保存されません。
タブレットでChatGPT品質のレスポンスをローカルで得られますか?
ほぼ、ただし適切なセットアップが必要です。フロンティアクラウドモデル級の品質には一般に70B以上のモデルが必要です。タブレット上では:iPad Pro M5(12GB / 16GB)は70Bモデルを実行できません — 3B〜8Bモデルのみ。リモート接続経由:ホームマシンに24GB GPU(RTX 4090)または64GB統合メモリ(Mac M5 Max)があればLlama 3.3 70Bを実行でき、タブレットはブラウザのOpen WebUI経由でその品質にアクセスできます。これがタブレットでクラウドAI品質に最も近い方法です。
ラップトップのカバーを閉じてもホームOllamaサーバーを動かし続けるには?
macOSの場合:カバーを閉じた時のスリープポリシーを設定:システム設定 → バッテリー → 「電源アダプタ接続時にPower Napを有効にする」を無効にし、Amphetamineなどのツールを使用して電源接続時のスリープを防ぐ。Windowsの場合:電源オプション → プラン設定の変更 → 電源接続時のスリープを「しない」に設定。または、プライマリラップトップではなく常時稼働マシン(ミニPC、NAS、または廃棄予定の古いラップトップ)でOllamaを実行する。
タブレットでAIを実行するとバッテリーが早く消耗しますか?
はい — オンデバイス推論はCPU/GPU集約的で、ブラウジングよりはるかに速くバッテリーを消耗します。消耗率はデバイスとモデルによって異なります。長時間使用する場合は、タブレットを充電しながら使用してください。ホームマシンへのリモート接続は、タブレットのバッテリー消費が大幅に少なくなります — タブレットはウェブページを表示するだけです。
AI推論中にタブレットはサーマルスロットリングしますか?
はい、特にiPad Air M4とアクティブ冷却のないAndroidタブレットでは。iPad Pro M5はiPad Airより熱的なヘッドルームが大きく、多くのAndroidタブレットは持続的な推論でより早くスロットリングします。緩和策:より短い生成チャンク(レスポンスあたり200〜400トークン)を使用、タブレットを硬い面に置く、同時に他のCPU集約型アプリを実行しない。
AIタブレット利用に最適なキーボードは何ですか?
iPad Pro M5用Apple Magic Keyboard(トラックパッド付き)が最も洗練されたセットアップです — Safari + Open WebUIでフルキーボードショートカットが動作し、トラックパッドで長いレスポンスのテキスト選択が可能。Logitech Combo Touchは予算代替品。Android:Termuxではどのbluetoothキーボードも動作しますが体験はより粗い(ターミナルのみ)。文章作業には、iPad Pro + Magic Keyboardがタブレットを執筆ファーストのAIワークステーションに変えます。
SillyTavernをiPadで実行できますか?
はい、リモート接続経由で可能です。SillyTavernはホームのMacまたはPCで動作し、iPad Safariがローカルipで接続します。モバイルUIは機能的ですが洗練されてはいません — 一部の拡張機能(正規表現ツール、グループチャットパネル)は動作しますが窮屈に感じます。ロールプレイに限れば、RisuAIの方がSillyTavernよりモバイルUIが優れています。どちらもホームマシン上の同じOllamaバックエンドに接続できます。
タブレットで長文RAGを処理できますか?
オンデバイスでは無理です — タブレットで1,000件以上のドキュメントを埋め込むのは非現実的です。リモート接続なら可能です — RAGパイプラインはホームマシンが処理し、タブレットはチャットインターフェースを表示します。ホームマシンで動作するAnythingLLMにタブレットのブラウザからアクセスすれば、タブレット側の制限なしにあらゆる規模のドキュメントコレクションを扱えます。タブレットでRAGを使いたい学生や知識労働者には、リモート接続の方が通常は実用的な選択肢です。
タブレットAIで外部ディスプレイを使えますか?
iPad Pro M5では可能です(Stage Manager+外部ディスプレイでマルチウィンドウ環境になり、外部モニターにOpen WebUI、iPad画面にメモや資料を表示)。Galaxy Tab S10 UltraはDeXモードで外部ディスプレイに対応し、同様のマルチモニターAIワークフローが可能です。DeXモードのないAndroidタブレットは画面をミラーリングするだけで、有用性は低くなります。iPad Pro+外部モニター+Magic Keyboardは、2026年にタブレットが本格的なAIワークステーションに最も近づく構成です。
ローカルAIはスマートフォンよりタブレットの方が優れていますか?
入力中心の用途(下書き、RAG、長い会話)では、はい — キーボード対応と画面サイズが重要です。素早いチャット、音声クエリ、外出先での利用には、普段持ち歩いているスマートフォンの方が適しています。iPad Pro M5は、ローカルAIでフラッグシップスマートフォンを上回る可能性が最も高いタブレットで、ミッドレンジのタブレットとスマートフォンはほぼ同等です。ほとんどの読者は、ローカルAIのためだけにタブレットを買うべきではありません — 他の理由でタブレットが欲しい場合に購入し、AI機能はおまけと考えてください。
タブレットでローカルAIが遅いのはなぜですか?
原因は通常、次の4つのいずれかです:モデルが空きRAMに対して大きすぎる(システムがスワップするかアプリを終了する)、生成速度がチップの速度ではなくメモリ帯域幅に制限されている、タブレットがサーマルスロットリングしている、またはバックグラウンドアプリがメモリを使っている。対処法:より小さなモデルまたはQ4量子化に切り替える、他のアプリを閉じる、タブレットを冷やして充電したままにする、PocketPal AIの内蔵ベンチマークで実際の速度を測る。3Bモデルでも遅すぎる場合は、ホームマシンへのリモート接続を使用してください。
ローカルLLMを実行できるタブレットは?(iPad Air M3、エントリーモデルのiPad、Galaxy Tab A、Huawei MatePad、Xiaomi Pad)
決め手はブランドではなくRAMとチップです。iPad Air M3(8GB)は1B〜3Bモデルを扱えます。エントリーモデルのiPadやRAM 6GB未満の低価格Androidタブレットは1B〜1.7Bモデルしか収まらないため、リモート接続の方が適しています。RAM 8GB以上のHuawei MatePadとXiaomi Padは、アプリストアでの提供状況次第で、他のAndroidタブレットと同じアプリを実行できます。タブレットの設定でRAMを確認し、上のモデル表に従ってください。
iPad用のOllamaアプリはありますか?
iPadOS向けの公式Ollamaアプリはありません。MacまたはPC上のOllamaサーバーに接続するサードパーティ製のiPadクライアントは存在し — 例えばGetOAIやLLLM — ただしチャットを表示するだけで、モデルは引き続きホームマシンで動作します。インストール前に各App Storeの掲載内容を確認してください。ブラウザ経由(SafariでOpen WebUI)ならアプリは一切不要です。
ターミナルなしでAndroidタブレットでローカルLLMを実行できますか?
はい。PocketPal AI(無料、オープンソース、Google Play)とGoogle AI Edge Gallery(無料、Apache 2.0)は、Termuxなしでモデルをオンデバイスでダウンロード・実行します。Termux + Ollamaが必要なのは、Ollamaのエコシステムやローカルapiエンドポイントを特に使いたい場合だけです。
iPad 第9・第10・第11世代、iPad mini、iPad Air 5などの旧型・エントリーモデルでローカルLLMは動きますか?
RAM容量で決まります。iPad 第9世代(3GB)・第10世代(4GB)とiPad mini 6(4GB)は、端末内チャットには容量が足りません。リモート接続をお使いください。iPad 第11世代(A16、6GB)は、Q4の1B〜1.7Bモデルまで扱えます。iPad mini 7(A17 Pro、8GB)、iPad Air 5、iPad Air M3(8GB)は、前述の8GBの制約の範囲でQ4の3Bモデルを扱えます。AppleはこれらのモデルのRAMを一律には公表していません。数値は広く報じられているもので、Apple公式の確認値ではありません。
Galaxy Tab S11 UltraやGalaxy Tab S9 FEでローカルLLMは動きますか?
Galaxy Tab S11 Ultra(Dimensity 9400+、構成により12GBまたは16GB)は8GBの目安を上回り、Tab S10+と同じアプリ(PocketPal AI、Google AI Edge Gallery、Termux + Ollama)が使えます。3B〜4Bモデルには、より余裕があります。Galaxy Tab S9 FEには6GBと8GBの構成があります。6GB版はQwen3 1.7Bまで、8GB版はモデル表の8GBの行に従ってください。Exynos 1380はミドルレンジのチップのため、フラッグシップのタブレットより速度は落ちる見込みです。
Gemma 4はタブレットで動きますか?
はい、小型のGemma 4が動きます。GoogleはGemma 4のE2BとE4Bを端末内実行向けのサイズとしており、4ビット量子化ではウェイト用のメモリとして約2.9GB(E2B)と約4.5GB(E4B)を示しています。8GBのタブレットにはE2B、12GB以上にはE4Bが向いています。iPadとAndroidで動かすアプリはGoogle AI Edge Galleryです(Google AI Edge Galleryレビューを参照)。PromptQuorumはGemma 4のタブレットでの速度を計測していません。
iPadで無料で使えるローカルLLMアプリはどれですか?
PocketPal AI(無料、MIT)、Google AI Edge Gallery(無料、Apache 2.0)、Locally AI(無料、有料オプションあり)は、無料で端末内実行ができます。MacやPCのOllamaにSafariのOpen WebUIでつなぐ方法も無料です。LLM Farmも無料ですが、ソースからのビルドが必要です。
LLM Farmは今でもiPadにインストールできますか?
App Storeからはできません。AppleはLLM Farmを2025年8月に削除し、プロジェクトのREADMEもApp StoreとTestFlightの両方を一時的に利用不可としています。方法は、Xcodeでソースからビルドすることだけです。最終アップストリーム更新は2026年1月30日のため、保守が止まっている可能性があります。iPadでインストールできる代替は、PocketPal AIとLocally AIです。