6 GB VRAMに最適なローカルLLMは?
Hans Kuepper 著 · PromptQuorum創設者 · オープンウェイト/オープンソースAIの発見エンジン
重要なポイント
- ✓Qwen3.5 4B Q4_K_M(3.3 GB)は6 GB VRAMに最適:GPUに全体が載り、コンテキスト用の余裕も残ります
- ✓Qwen3 8B Q4_K_M(5.2 GB)は高性能ですが、コンテキスト用に1 GB未満しか残らないため、プロンプトは短く保ってください
- ✓6 GBに収まらないもの:Qwen3.5 9B(6.6 GB)、Ministral 3 8B(6.0 GB)、Gemma 4 E4B(6.1 GB以上)はコンテキスト以前に上限を超えます
クイック回答
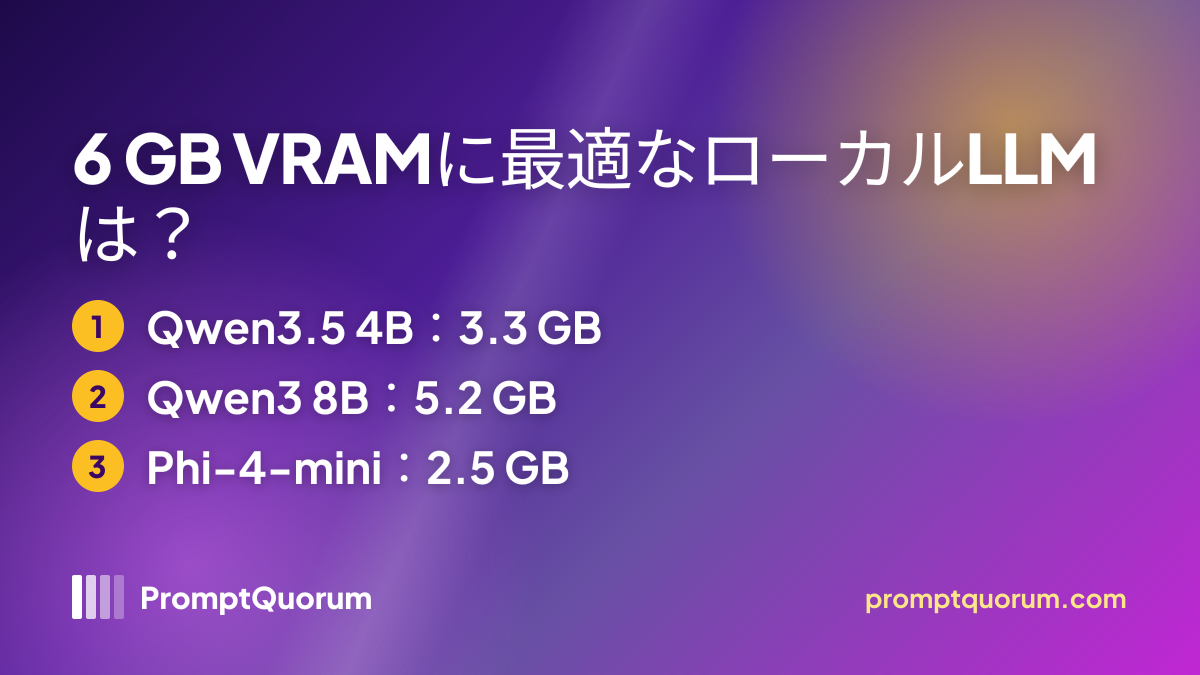
6 GB VRAMにはQwen3.5 4B Q4_K_Mが最適です。ダウンロードは3.3 GBで、コンテキスト用に約2.7 GBが残ります。Qwen3 8B Q4_K_M(5.2 GB)は高性能ですが余裕が少なく、Phi-4-mini(2.5 GB)は最も軽量な選択肢です。
- ▸Qwen3.5 4B Q4_K_M:6 GBに最適(3.3 GB、テキストと画像入力)
- ▸Qwen3 8B Q4_K_M:高性能だが余裕が少ない(5.2 GB、短いコンテキストのみ)
- ▸Phi-4-mini Q4_K_M:最軽量(2.5 GB、コンテキストの余裕が最大)
6 GB VRAM向けトップ3モデル
6 GB VRAMでは、ファイルサイズが約4 GB以下のモデルを選ぶと、コンテキストキャッシュとデスクトップ表示もカードに収まります。以下のサイズはOllamaライブラリのダウンロードサイズです。コンテキストウィンドウには別途メモリが必要で、Windowsは表示用にVRAMの一部を確保します。
Qwen3.5 4Bは2026年にリリースされ、テキストと画像の入力、ツール呼び出し、既定で有効な思考モード(回答の前にトークンが増えます)に対応します。PromptQuorumは6 GBカードでこれらのモデルを計測していないため、生成速度はお使いのGPUによります。一般にファイルが小さいほど速く生成できます。
| モデル | サイズ | Ollamaタグ | 最適な用途 |
|---|---|---|---|
| Qwen3.5 4B Q4_K_M | 3.3 GB | qwen3.5:4b | チャット、コーディング、画像 |
| Qwen3 8B Q4_K_M | 5.2 GB | qwen3:8b | 最高品質、短いコンテキスト |
| Phi-4-mini Q4_K_M | 2.5 GB | phi4-mini | 軽量、長いコンテキスト |
6 GBのGPUと収まるモデル
6 GBの代表的なカードは、GTX 1060 6 GB、GTX 1660 Super、RTX 2060(6 GB版)、RTX 3050 6 GB、RTX 3060 Laptop、RTX 4050 Laptopです。OllamaはCUDA経由でいずれも動作します。GTX 1060のような古いカードも動きますが、Tensorコアがないため生成は遅くなります。
モデルが収まらない場合、Ollamaは一部のレイヤーをシステムRAMとCPUに移します。動作はしますが生成速度は大きく落ちるため、6 GBカードでのQwen3 8Bは無料のアップグレードではなくトレードオフです。ollama psでGPU/CPUの割合を確認できます。
Apple Siliconは別のケースです。Macはユニファイドメモリを CPUとGPUで共有し、macOSは既定で16 GBのマシンではその約3分の2をGPUに使わせるため、ただしmacOS自体に少なくとも8 GBが必要なため、16 GBのMacBookでモデルに使えるのは約8 GBで、6 GBのGPUよりわずかに多い程度です。16 GB RAMノートPC向けベストローカルLLMをご覧ください。
6 GBから8 GBにすると、Qwen3 8B Q4_K_Mをコンテキストの余裕を持って動かせます。12 GBの選択肢と14BモデルはRTX 3060 12 GB向けベストOllamaモデルを、VRAMの詳しい基準はローカルLLMに必要なVRAMをご覧ください。
6 GB VRAM向けベストコーディングモデル
6 GB VRAMでのコーディングはQwen3.5 4B Q4_K_Mが出発点で、コード補完にはコード特化のQwen2.5-Coder 7B Q4_K_M(4.7 GB)も選択肢です。Qwen3.5 4BのモデルカードはLiveCodeBench v6で55.8と報告しています(開発元の数値、思考モード)。Qwen2.5-Coderは2024年のファミリーでコンテキストは32Kのため、7Bのファイルでは長いプロンプトの余裕がほとんどありません。
LM Studioは同じGGUFファイルを読み込めます。Aiderやエディタのプラグインは、ローカルAPI経由でOllamaモデルを使えます。コードのプロンプトは長く、コンテキストが切り詰められると誤った回答になるため、既定値より大きくしてください(例:Ollamaのプロンプトで/set parameter num_ctx 8192)。
| モデル | サイズ | 用途 |
|---|---|---|
| Qwen3.5 4B Q4_K_M | 3.3 GB | コーディング+チャット、ツール呼び出し |
| Qwen2.5-Coder 7B Q4_K_M | 4.7 GB | コード補完、短いコンテキスト |
| Qwen2.5-Coder 3B Q4_K_M | 1.9 GB | 高速オートコンプリート |
関連ガイド
- ▸2 GBのRAMでRAGは実行できますか? -- RAG on low RAM
- ▸6 GB VRAM向けベスト量子化 -- Q4_K_MとQ5_K_Mの比較
- ▸16 GB RAMノートPC向けベストローカルLLM -- ノートPC向け
6 GB VRAMモデルに関するよくある質問
6 GB VRAMでローカルLLMは十分に使えますか?▾
Qwen3 8Bは6 GB VRAMに収まりますか?▾
/set parameter num_ctx 2048で上限を設けるか、Qwen3.5 4B(3.3 GB)を使ってください。ollama psで100% GPUか確認できます。Ministral 8B、Gemma 4、Qwen3.5 9Bは6 GBに収まりますか?▾
gemma4:e2b-it-qat、4.3 GB)は収まります。6 GB VRAMに最適なコーディングモデルは?▾
ollama_chat/プレフィックスでOllamaモデルを使えます。6 GB VRAMのGPUはどれですか?▾
VRAMではなく6 GBのシステムRAMしかない場合は?▾
qwen3.5:2b、1.9 GB)のような1〜2Bモデルを使い、コンテキストは短く保ってください。