Ollamaで128Kコンテキストに対応するモデルは?
クイック回答
Llama 3.1 8BはOllamaで128Kコンテキストに対応。Qwen3-30B-A3B(Mixture of Expertsモデル)は256Kコンテキストに到達。注意:フルコンテキストの実行はVRAMを大幅に増加させます——128Kウィンドウはデフォルトの4Kウィンドウの3〜4倍のVRAMが必要です。
- ▸Llama 3.1 8B:128Kコンテキスト、フルコンテキストで~16 GB VRAM
- ▸Qwen3-30B-A3B:256Kコンテキスト、フルコンテキストで24+ GB VRAM
- ▸通常使用時はVRAMを節約するため--num-ctx 4096を設定
重要なポイント
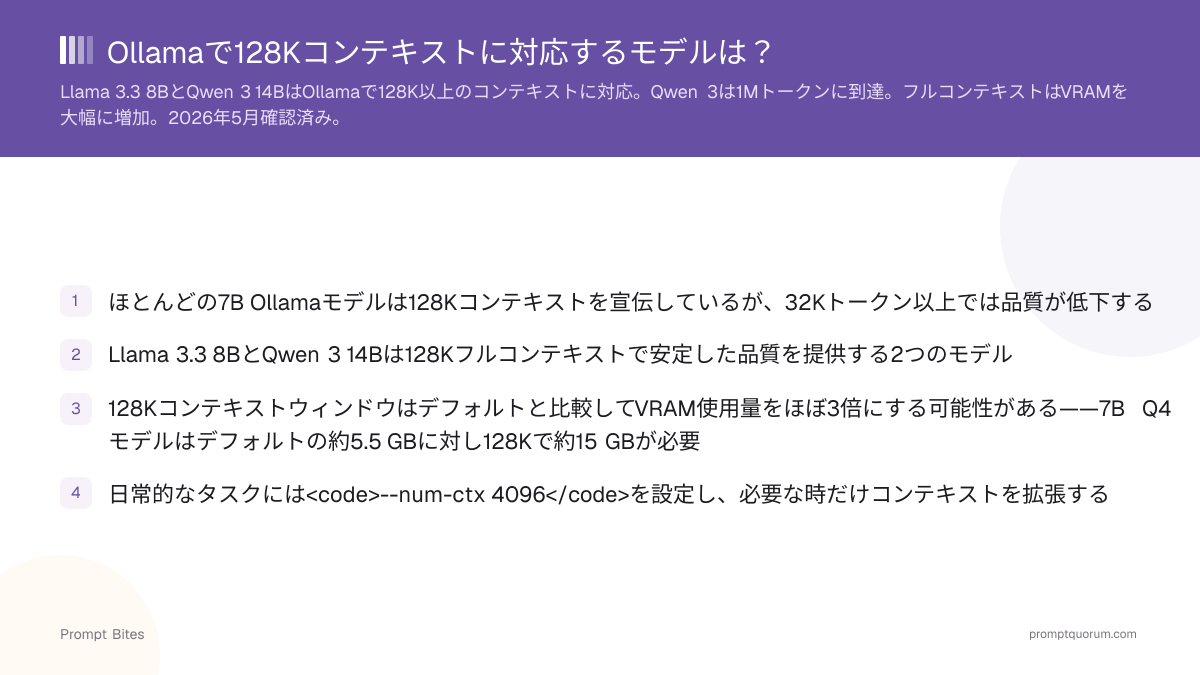
- ✓ほとんどの7B Ollamaモデルは128Kコンテキストを宣伝しているが、32Kトークン以上では品質が低下する
- ✓Llama 3.1 8BとQwen3-30B-A3BはOllamaで128K以上のコンテキストを安定して提供する2つのモデル
- ✓128Kコンテキストウィンドウはデフォルトと比較してVRAM使用量をほぼ3倍にする可能性がある——7B Q4モデルはデフォルトの約5.5 GBに対し128Kで約15 GBが必要
- ✓日常的なタスクには<code>--num-ctx 4096</code>を設定し、必要な時だけコンテキストを拡張する
実際に128Kに到達するモデル
ほとんどのOllamaモデルは128Kコンテキストを宣伝していますが、その長さで有用な出力品質を実現するものは少数です。問題は「ロスト・イン・ザ・ミドル」効果:標準的な文書長で訓練されたモデルは、長いコンテキストの深い部分にある情報に注目するのが困難です。
Ollamaで128K以上のコンテキストを安定して提供するモデルは2つ:Llama 3.1 8B(128Kでネイティブ訓練)とQwen3-30B-A3B(Ollama公式ライブラリで256Kコンテキストウィンドウを持つMixture of Expertsモデルで、トークンごとに300億パラメータのうち約30億のみを活性化)。Qwen3の小型の高密度モデルはOllamaでデフォルト40Kコンテキストウィンドウとなり、他の7Bクラスモデルの大部分も32Kトークン以上では出力品質が著しく低下します。
20,000語以上の文書を扱うタスクにはLlama 3.1 8Bから始めてください。最大のコンテキストウィンドウが必要で20+ GB VRAMがある場合は、Qwen3-30B-A3Bが優れた選択肢です。
📍 一文で説明
Ollamaで128K以上のコンテキストを安定して提供する2つのモデルは、Llama 3.1 8B(128K、ネイティブ訓練)とQwen3-30B-A3B(256K、Mixture of Experts)です。
💬 簡潔に説明
Llama 3.1 8Bは最初から128Kトークンのコンテキストを扱えるよう訓練されているため、その長さでも出力品質が安定しています。Qwen3-30B-A3BはMixture of Expertsモデルで、トークンごとに300億パラメータのうち約30億のみを活性化し、Ollamaでは256Kコンテキストウィンドウとして提供されています。他の7Bクラスモデルの大部分は128Kを宣伝していますが、32Kトークンを超えると出力品質が目に見えて低下します。
長いコンテキストのVRAMコスト
コンテキストウィンドウを拡張するとVRAM使用量が大幅に増加します。KV-Cache(コンテキスト内のすべてのトークンのアテンション状態を保存)は、128Kコンテキストではモデルの重みと同量のVRAMを使用することがあります。
下の表はQ4_K_Mの7BモデルにおけるKV-CacheのVRAMスケーリングを示します。これらの数値はGrouped Query Attention(GQA)を使用するモデルを想定しています——GQAを使用しないモデルはKV-Cacheの使用量が大幅に多くなります。
日常的なタスクでVRAMを節約するには、Ollamaの起動時に--num-ctx 4096を設定してください。特定のタスクで必要な場合にのみ32Kや128Kに拡張します。モデル選択やRAM分割を含む長文コンテキストLLMの完全ガイドは、長文コンテキストローカルLLMガイドをご覧ください。
| コンテキスト長 | KV-Cache (7B) | 合計VRAM (7B Q4) |
|---|---|---|
| 4K(デフォルト) | ~0.5 GB | ~5.5 GB |
| 16K | ~1.5 GB | ~6.5 GB |
| 32K | ~3 GB | ~8 GB |
| 128K | ~10 GB | ~15 GB |
関連ガイド
- ▸長文コンテキストローカルLLMガイド -- モデル選択とRAM分割
- ▸Qwen 3 は Ollama で動かせますか? -- セットアップとVRAM要件
- ▸OllamaでVisionに対応しているモデルは? -- Ollamaのマルチモーダルモデル
長文コンテキストモデルに関するよくある質問
Ollamaで128Kコンテキストを有効にするには?▾
--num-ctx 131072を追加します:ollama run llama3.1:8b --num-ctx 131072。このフラグがない場合、OllamaのModelfile仕様ではnum_ctxのデフォルトは2048ですが、VRAM階層別のランタイムデフォルト(24 GiB未満は4K、24〜48 GiBは32K、それ以上は256K)でもモデルの最大能力に届かないことがあります。確実に使うにはnum_ctxを明示的に設定してください。