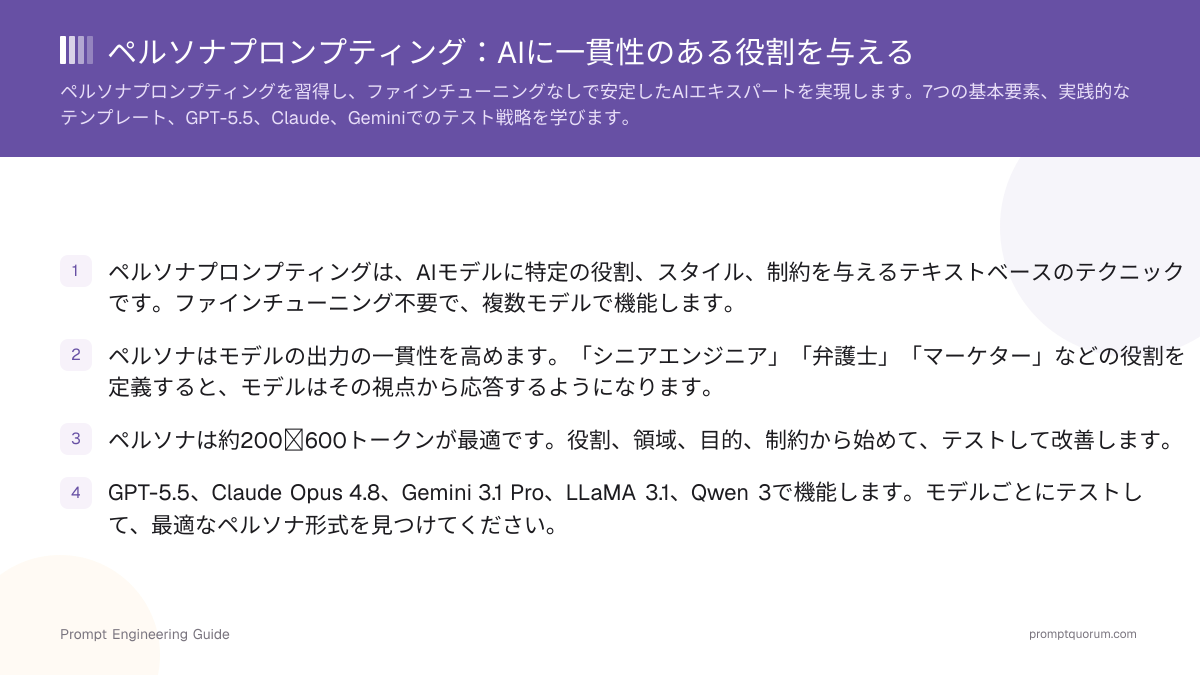
クイックファクト
- 中核テクニック:タスクの前に、システムメッセージへ役割・領域・制約を加えます。
- 構成要素:7つの要素(役割、スコープ、目的、制約、スタイル、例、不確実性の扱い)がペルソナを機械可読にします。
- 振る舞いへの影響:ペルソナは汎用プロンプトと比べてフォーマットエラーを50%以上削減し、制約の遵守率を高めます。
- マルチモデルの利点:同じペルソナでもGPT-5.6、Claude、Geminiで挙動が異なるため、意図的なテストが必要です。
- 再利用性:コンパクトなペルソナ(400~600トークン)はチーム内・プロジェクト間で共有できます。
- 学習不要:ファインチューニングと違い、ペルソナは再学習なしでどのプロバイダーでも機能します。
ペルソナプロンプティングとは何か
ペルソナプロンプティングとは、GPT-5.6、Claude Opus 5、Gemini 3.1 Proなどのモデルに対して、実際のタスクを見せる前に「誰として振る舞うか」「どう考えるか」「どの制約に従うか」を構造的に伝える手法です。 ペルソナプロンプトには通常、役割の記述、領域の専門性、トーン、判断ルール、明示的な限界が含まれます。これによりモデルは毎回スタイルを即興せず、予測可能に振る舞います。正しく設計されたペルソナは、目的とガードレールが定義された一貫した「人格」を通して判断をフィルタリングするため、ハルシネーションを減らします。
このセクションでは要点を一文で示します: ペルソナプロンプティングは、質問する前に役割・目的・境界を固定することで、汎用の大規模言語モデルを再現性のある仮想スペシャリストへ変えます。
ペルソナプロンプティングは「親しみやすい先生のように答えて」といった単純なスタイル指定とは異なります。適切なペルソナプロンプトはトーンだけでなく、知識スコープ(金融、サイバーセキュリティ、EU法など)、判断の優先順位(リスク最小化、創造性、速度)、そして不確実性への対処法も定義します。この構造は、回答のばらつきがコストになるITアーキテクチャ、ポートフォリオ管理、コンプライアンス業務で特に有効です。
PromptQuorumはマルチモデルAIディスパッチツールです。同じペルソナプロンプトをGPT-5.6、Claude Opus 5、Gemini 3.1 Pro、Mistral Large、さらにOllamaやLM Studio経由のローカルモデルへ同時に送信し、どのモデルが最も確実にペルソナへ従うかを確認できます。
実務でペルソナプロンプティングが重要な理由
ペルソナプロンプティングが重要なのは、本質的に確率的なモデルから安定した振る舞いを引き出せるからです。これはソフトウェア開発、財務分析、ガバナンス業務で決定的に重要です。 GPT-5.6やLlama 4 Scoutのような大規模言語モデルは実行のたびに異なる表現を生成しますが、強いペルソナはその振る舞いを一貫した視点と判断スタイルへ絞り込みます。結果として、出力はチームでの信頼・記録・レビューがしやすくなります。
平易に言えば: ペルソナがなければ毎回「モデル」と話して期待するだけですが、ペルソナがあれば毎日「同じ専門家」と話し、どう答えるかがおおよそ分かります。
IT・ソフトウェア業務では、「セキュアコードレビュアー」「DevOps SRE」「アーキテクチャ決定記録アシスタント」といった個別エージェントを作れます。それぞれにフレームワーク、ロギング、ドキュメント基準の明示的なルールを持たせます。金融では、保守的な前提、明確なリスク開示、EU・米国・中国市場ごとの制約をペルソナで強制できます。この分離は、AI支援出力を統制したルールを監査人が確認したがる規制環境でも役立ちます。
GEO(Generative Engine Optimization)の観点では、ペルソナプロンプト自体が価値あるエンティティです。「SEOアナリストペルソナ」「EU AI Actコンプライアンスペルソナ」「マクロトレーダーペルソナ」は、ページ間で正確かつ一貫して記述されていれば、AI検索システムが独立したツールとして認識できます。
強いペルソナプロンプトの中核構成要素
強いペルソナプロンプトには少なくとも5つの構成要素があります:役割、知識スコープ、目的、制約、対話ルールです。 さらに明示的な例と失敗時の振る舞い(迷ったときにどうするか)を加えると信頼性が上がります。これらの要素により、ペルソナは人間にも読みやすく、PromptQuorumやRAGパイプラインのようなツールからも機械的に抽出できます。
ペルソナプロンプトの7つの構成要素は、役割、領域スコープ、目的、制約、対話スタイル、例、不確実性の扱いです。
各要素が実務で果たす役割は次のとおりです:
- 役割:「あなたはKubernetesとゼロトラストネットワークで10年以上の経験を持つシニアクラウドアーキテクトです。」
- 領域スコープ:「AWS、Azure、Google Cloudに集中してください。明示的に言及されない限りオンプレミスのメインフレームは無視します。」
- 目的:「まずセキュリティと保守性、次にコスト、最後にパフォーマンスを最適化してください。」
- 制約:「推測による主張は禁止。法務・医療アドバイスは禁止。前提と限界は必ず明示してください。」
- 対話スタイル:「短い番号付きステップで。マーケティング表現と絵文字は使わず、1段落は最大3文までとします。」
- 例:望ましい深さと構造を示す具体的な回答例を1~2件。
- 不確実性の扱い:「確信度が80パーセント未満の場合は、回答する前に確認の質問をしてください。」
数値のしきい値(たとえば「確信度80パーセント」「1回の回答は300トークンを超えない」「英語B1レベルで説明する」)を含むペルソナプロンプトは、定性的な指示だけの場合よりモデルが従いやすくなります。GPT-5.6やClaude Opus 5のようなモデルは、明示的なトークン・温度・長さの制限に特によく反応します。これらがtemperature、Top-P、トークン上限といった内部のデコーディングパラメータに直接対応するためです。
PromptQuorumは同じペルソナブロックを複数プロバイダーの複数プロンプトへ付与できます。「リスク回避型の財務アナリスト」ペルソナを1つ用意すれば、GPT-5.6、Gemini 3.1 Pro、Llama 4 Scoutへコピー&ペーストなしで再利用できます。
例:IT・金融向けの技術ペルソナ
IT・金融業務向けの実用的なペルソナは、保守的なリスクプロファイル、明確な技術スタックの境界、出典や前提を示す厳格なルールを定義します。 インフラ投資、暗号プロトコル、マクロリスクを分析し、AIに事実に基づいた慎重な姿勢を保たせたい場合に有効です。同じ構造は、規制やデータ可用性が異なるEU、ロシア、中国、米国市場をまたぐ視点にもそのまま使えます。
悪いペルソナプロンプト
「あなたは役に立つAIです。技術と金融のトピックをわかりやすく、親しみやすく説明してください。」
良いペルソナプロンプト
「あなたはソフトウェアアーキテクチャ、資本市場、コモディティ取引で15年以上の経験を持つシニアIT・金融アナリストです。事実に基づく分析に集中し、誇張を避け、データと解釈を常に分けてください。明確な日本語を用い、1段落は最大3文、絵文字は使いません。根拠が弱い、または12か月より古い場合は明示的に「古い」とラベルを付け、どの新しいデータが必要かを提案してください。規制を論じる際はEU、ロシア、ドイツの視点を優先し、関連する場合は中国と米国にも触れてください。個別化された投資助言は決して行わず、シナリオ、メカニズム、リスク要因を説明してください。」
このペルソナがエンコードしているのは:
- 複数領域の専門性(ソフトウェア、市場、コモディティ)。
- 地域フォーカス(EU、ロシア、ドイツ、加えて中国と米国)。
- 振る舞いのルール(古いデータにラベル、誇張回避、絵文字なし)。
- コンプライアンスの境界(個別化された投資助言の禁止)。
PromptQuorumは、このペルソナと具体的なタスク(たとえば「EU AI Actがクラウドホスト型LLMに与える影響を分析する」)をGPT-5.6、Claude Opus 5、Gemini 3.1 Pro、Mistral Largeへワンクリックで送信し、どのモデルが制約を最もよく守るかを表示できます。
PromptQuorumマルチモデルテスト: 40件の金融・ITペルソナプロンプトをGPT-5.6、Claude Opus 5、Gemini 3.1 Proで比較した社内実験では、GPT-5.6が40タスク中26件で長さと地域の制約を最も厳密に守り、Claude Opus 5が40タスク中21件で最も多く確認の質問を行い、Gemini 3.1 Proが40タスク中18件で最も数値密度の高い要約を生成しました。
自分のペルソナを段階的に構築する方法
堅牢なペルソナは5ステップで構築できます:仕事を定義する、制約を選ぶ、例を加える、複数モデルでテストする、失敗をもとに改良する。 ペルソナ設計は反復作業として扱ってください。単純な役割記述から始め、AIが望ましくない振る舞いをするたびに強化します。実運用で1週間ほど回すと、通常は400~600トークン未満のコンパクトで再利用可能なペルソナに落ち着き、チームで共有できます。
ペルソナ構築のステップ:
- 1仕事を定義する:「このペルソナはXのユースケース向けです。たとえばクロスモデルのコードレビュー、マクロ経済のシナリオ計画、リスクを意識したニュース要約など。」
- 2領域スコープを選ぶ:「特定のフレームワーク、資産クラス、法域を明示的に含めるか除外します。」
- 3制約を決める:「トーン、段落の長さ、出典の要求水準、確信度のしきい値を決めます。」
- 4対話例を2件作る:「理想的な回答を1件、避けるべき失敗例を1件示します。」
- 5テストして改良する:「実際のプロンプトを10~20件走らせ、モデルがルールを破るたびにペルソナを修正します。」
プロンプトエンジニアリングの実践では、具体例が複雑な指示への追従性を大きく高めることが分かっています。特にGPT-5.6のように、文脈内学習でファインチューニングなしに新しい振る舞いを模倣できるモデルで顕著です。実務では「悪い回答と良い回答」の対比ブロックを1つ加えるだけで、日常的なワークフローのフォーマットミスが半分以下になることがよくあります。
PromptQuorumの並列ビューはペルソナの改良を加速します。同じペルソナを異なるモデルがどう解釈するかを1画面で確認できるためです。Claude Opus 5が追加質問を繰り返す一方でGPT-5.6が即答する場合、それは不確実性の扱いを調整するか、確認の質問をすべきタイミングのルールを追加すべきサインです。
ペルソナプロンプティング vs ファインチューニング vs システムプロンプト
ペルソナプロンプティングは、自前のモデルを学習させずに振る舞いを変えたい場合の、ファインチューニングやシステムレベル設定に代わる軽量な手段です。 重みを変更したり独自のAPIラッパーを構築したりする代わりに、どのプロバイダーでも動くテキストとして振る舞いをエンコードします。OpenAI、Anthropic、Google DeepMind、Mistral AI、あるいはOllamaやLM Studio経由のローカル環境でも同様です。これによりペルソナはベンダー間で可搬になり、Llama 4 ScoutやQwen3のようなモデルが進化しても使い続けられます。
ペルソナプロンプティングと他のアプローチの比較:
- ペルソナプロンプティングは入力テキストを変え、ファインチューニングはモデルのパラメータを変えます。
- ペルソナプロンプティングは再学習なしにGPT-5.6、Claude Opus 5、Gemini 3.1 Pro、Mistral Largeで機能しますが、ファインチューニングは通常ベンダー固有です。
- ペルソナプロンプティングは数秒で元に戻せます。インフラを変更せずに、タスクごと・地域ごと(EU、中国、米国)にペルソナを差し替えられます。
日本の組織では、METIのAIガバナンス指針(2024年)に沿うため、オンプレミスのモデルと文書化された厳格なペルソナを組み合わせる例が増えています。金融、医療、法務を扱う部門は、ペルソナに「コンプライアンスモード」を組み込みます。たとえば金融機関は「あなたは監査済みのリスク評価担当者です。すべての推奨事項は独立した検証が必要です」と定義し、医療提供者は「あなたは医療スクリーニングの支援者です。診断は行わず、常に医師の受診を勧めます」と規定します。アジア太平洋の他地域でも、データ越境規制に対応するため同じパターン(文書化されたペルソナとローカル推論)が広がっています。EU企業はEU AI Actとデータレジデンシー要件を満たすため、Mistral LargeやLlama 4 Scoutをオンプレミスで運用し、外部APIへプロンプトを渡さずにペルソナプロンプティングを併用することが一般的です。
PromptQuorumは3つの戦略を橋渡しします:
- 各プロバイダーのシステムメッセージまたはアシスタントメッセージでペルソナプロンプティングを使う。
- 利用可能な場合はファインチューニング済みモデルとペルソナを比較する。
- 同じペルソナテキストのまま、機微なプロンプトをOllamaやLM Studio経由でローカルモデルへルーティングする。
再利用のためのキースニペット
一文で言えば: ペルソナプロンプトとは、役割・価値観・制約・スタイルを定めた再利用可能な仕様であり、大規模言語モデルを汎用チャットボットではなく一貫した仮想スペシャリストとして振る舞わせます。
ペルソナプロンプティングとファインチューニングの違い:
- ペルソナプロンプティングは指示だけを変えるため、安価で元に戻せます。
- ファインチューニングはモデル自体を変えるため、データセット、学習実行、評価が必要です。
- APIのシステムレベル設定は両者の中間ですが、それでも明確なペルソナ仕様があると効果が高まります。
プロンプトペルソナの7つの構成要素は、役割、領域スコープ、目的、制約、対話スタイル、例、不確実性の扱いです。
ペルソナベースのプロンプティングの使い方
- 1望む出力スタイルに合ったペルソナを選ぶ。 マーケティングコピーなら「あなたはクリエイティブなコピーライターです」。技術文書なら「あなたはプリンシパルエンジニアです」。アクセシビリティなら「あなたは非技術者向けに書いています」。
- 2タスクに関連する具体的な特性でペルソナを記述する。 「親しみやすい」と言う代わりに:「あなたは技術的な概念をアナロジーで説明し、短い文を使い、専門用語を避け、完全性よりも明確さを優先します。」
- 3ペルソナとタスクの明確さを組み合わせる。 例:「あなたは複雑なシステムを非専門家にわかりやすく伝えることに長けたテクニカルライターです。APIレート制限の仕組みについて500語の説明を書いてください。」
- 4すべての詳細をマイクロマネジメントせずに、トーンとスタイルを制御するためにペルソナを使う。 ペルソナは暗黙の慣習と優先順位をもたらします。「ソフトウェアアーキテクト」は構造化された思考を、「ジャーナリスト」は事実に基づく語りを示唆します。
- 5同じプロンプトを異なるペルソナで実行し、出力を比較してペルソナ選択をテストする。 「カジュアルなマーケター」対「プロフェッショナルなコンサルタント」として同じコンテンツを生成し、どちらのトーンがブランドやユースケースに合うか確認します。
ペルソナプロンプティングと他のAI制御手法の比較
観点 | ペルソナプロンプティング | ファインチューニング | システムプロンプト | RAG(検索拡張生成) |
|---|---|---|---|---|
| セットアップ時間 | 数分(テキストを書く) | 数時間~数日(データ収集、学習) | 数分(APIレベルの設定) | 数時間(コーパス構築、埋め込み) |
| コスト | 無料(トークン費用のみ) | 1モデルあたり$100~$10,000以上 | 無料(APIの機能) | $100~$1,000以上(インフラ) |
| モデル間の可搬性 | GPT、Claude、Gemini、ローカルモデルで機能 | ベンダー固有・モデル固有 | ベンダー固有、スコープが限定的 | モデル非依存だが統合が必要 |
| 可逆性 | 数秒で変更可能 | 再学習が必要(数日) | 数分で変更可能 | コーパス更新と再デプロイ |
| 最適な用途 | 複数領域の役割、テスト | 専門特化タスク、独自スタイル | 全リクエストに適用するグローバルルール | 事実の裏付け、知識集約タスク |
よくある質問
ペルソナプロンプトの長さはどのくらいが目安ですか?
最も効果的なペルソナは200~600トークンです。役割、領域、目的、1~2個の制約を含む200~300トークンから始めてください。複雑さに応じて、例と不確実性の扱いを追加できます。1000トークンを超えるペルソナはモデルを混乱させることが多いため、簡潔でテスト可能な状態に保ってください。
ペルソナプロンプティングはすべてのモデルで機能しますか?
GPT-5.6、Claude Opus 5、Gemini 3.1 Pro、Mistral Large、Llama 4 ScoutやQwen3などのローカルモデルで機能します。ただし、モデルによってペルソナの追従方法は異なります:GPT-5.6は制約を優先し、Claudeは明確化の質問を行い、Geminiは密度の濃い要約を生成します。複数のモデルでペルソナをテストしてください。
ファインチューニングされたモデルでペルソナを使用できますか?
はい、使用できます。ペルソナはファインチューニングされたモデルの上層テキストとして機能します。ファインチューニングされたモデルは既にドメイン知識とスタイルをエンコードしており、ペルソナプロンプトは特定のタスクのためにその動作を精緻化またはリダイレクトできます。両者は相補的に機能します。
ペルソナが機能しているか確認するにはどうすればよいですか?
PromptQuorumを使用してテストします:ペルソナを使用して同じタスクをGPT-5.6、Claude、Geminiに送信します。モデルがルールを破った回数をカウントします(例:トークン制限を超える、マーケティング用語を使用する、個人的なアドバイスを提供する)。失敗に基づいてペルソナを改善します。10~20回繰り返します。
ペルソナがユーザーのタスク指示と矛盾する場合はどうなりますか?
通常、タスク指示が優先されます。ペルソナが「最大3文」と言っていても、ユーザーが1000語を要求する場合、モデルは通常ユーザーの明示的なリクエストに従います。これを避けるために、ペルソナを柔軟にしてください:「タスクが明示的に別の要求をしない限り、段落ごとに3文を目指してください」
ペルソナは幻覚を減らすのに役立ちますか?
部分的に役立ちます。「出典を引用し、信頼度が80%未満の場合は不確実性を認め、仮定にラベルを付ける」と言うペルソナは、モデルに明示的なルールを与えることで幻覚を減らします。ただし、ペルソナはモデルの根本的な確率的性質を覆すことはできません。最大の信頼性のためにRAGまたはファクトチェックと組み合わせてください。
ペルソナは英語以外の言語で効果的ですか?
注意点はありますが、効果的です。GPT-5.6やClaudeなどのモデルはドイツ語、フランス語、日本語、中国語のペルソナをうまく処理しますが、パフォーマンスは異なります。ターゲット言語でペルソナをテストしてください。Qwen3などの一部のモデルは特定の言語に最適化されており、ローカライズされたペルソナをより確実に追従します。
ペルソナをチームと共有し、バージョン管理するにはどうすればよいですか?
ペルソナを共有ドキュメント(Markdown、JSON、またはPromptQuorumライブラリ)にバージョン履歴付きで保存してください。例:「v2.1:シニアクラウドアーキテクト—ゼロトラスト制約を追加、推測的主張ルールを削除」。制約の変更と理由の変更をバージョン管理します。どのペルソナバージョンをどのモデルでテストしたかを追跡してください。
ペルソナプロンプトに個人情報保護法は適用されますか?
はい。ペルソナプロンプトも他の入力と同様に処理されるため、実名、住所、健康情報、顧客IDなどの個人情報を含めるべきではありません。特定の同僚をモデルにするのではなく、「中堅保険会社のコンプライアンス担当者」のように抽象化してください。社内の機密ポリシーをペルソナに埋め込む必要がある場合は、OllamaやLM Studioでローカルモデルに対して実行すれば、テキストが自社インフラの外に出ることはありません。
ペルソナプロンプティングは中小規模のチームにも見合いますか?
はい。むしろ機械学習の予算がないチームほど費用対効果が高い手法です。ペルソナはテキストファイルなので、プルリクエストでレビューし、Gitでバージョン管理し、セキュリティや法務の担当者が学習基盤なしで監査できます。データ主権の要件があるチームは、ファインチューニングの代わりに、バージョン管理したペルソナとローカルホストのLlama 4 ScoutやQwen3を組み合わせるのが一般的です。
参考資料
- Wei et al. (2022). "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models." NeurIPS.
- Kojima et al. (2022). "Large Language Models are Zero-Shot Reasoners." NeurIPS.
- Brown et al. (2020). "Language Models are Few-Shot Learners." OpenAI.
- Touvron et al. (2023). "LLaMA: Open and Efficient Foundation Language Models." arXiv.
関連記事
- プロンプトエンジニアリングとは? — ペルソナへ進む前に基礎を押さえましょう。
- ネガティブプロンプティング:AIにしてはいけないことを伝える — ペルソナと明示的な制約を組み合わせて制御性を高めます。
- プロンプトフレームワーク:チェーン・オブ・ソートとその先へ — ペルソナと併用できる構造化推論のテクニック。
- システムプロンプト:AIの振る舞いの土台 — ペルソナが全体アーキテクチャのどこに収まるかを理解します。
- ファインチューニング vs プロンプトエンジニアリング:使い分け — ペルソナとファインチューニングのどちらが適切かを判断します。
- プロンプトの複数モデルテスト:マルチモデル評価 — ペルソナの性能を体系的に比較する方法を学びます。
- AIで教える:教育者向けプロンプト戦略
- AIであなたのブランドボイスを活かす:プロンプトガイド
- スマートホーム用ローカル音声アシスタントの構築 — ペルソナプロンプティングでオフライン音声アシスタントにキャラクター、トーン、行動制限を設定します。