温度とTop-Pとは何か?
📍 In One Sentence
温度はモデルの確率分布の鋭さを制御し、値を下げると決定的な出力に、上げるとランダム性が増します。一方 Top-P は、確率の合計が p になる最小のトークン集合にサンプリングを限定します。
💬 In Plain Terms
温度は創造性のつまみです。0 まで下げれば一貫した予測可能な答えになり、上げれば意外性のある答えになります。Top-P は同じ発想の別のレバーで、確率をならすのではなく、可能性の低い単語の裾野をそもそも候補から外します。
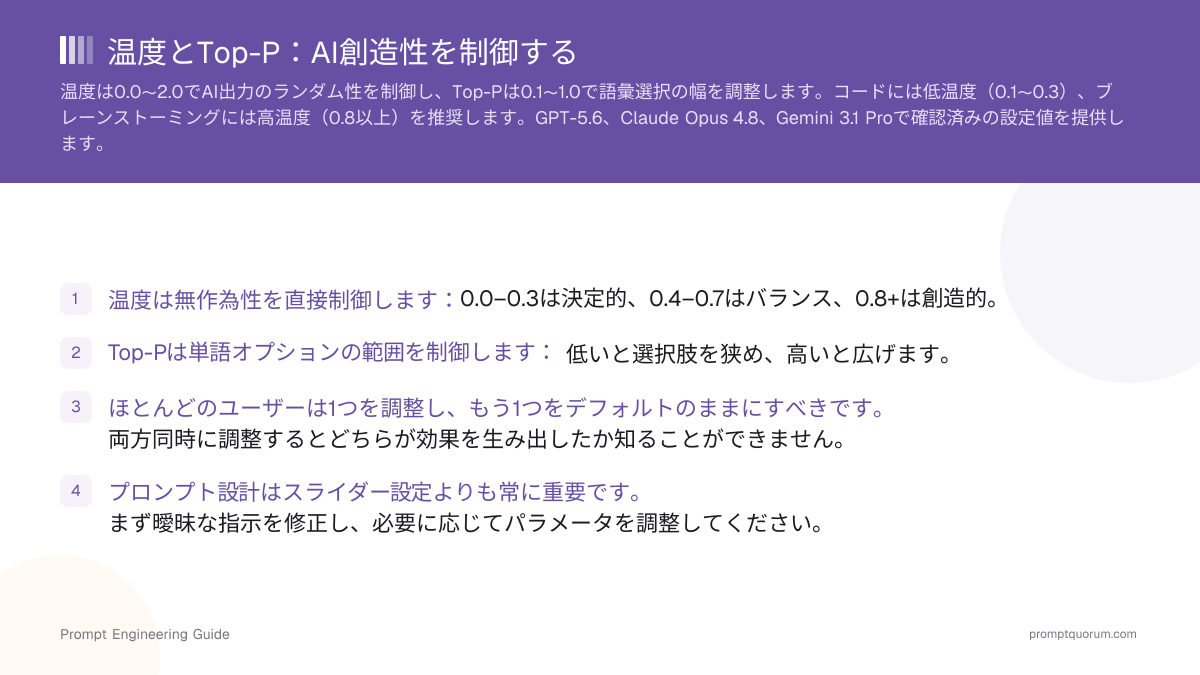
温度はモデルの出力をより無作為(高い)またはより決定的(低い)にするノブです。 温度0.0では、モデルは常に最も可能性の高い次の単語を選ぶため、実行を繰り返してもほぼ同じ出力になります。ただし浮動小数点演算やハードウェアの差異により、一部のトークンが変わることはあります。温度1.0以上では、モデルはより危険な選択肢を考慮し、驚くべき多様なテキストを生成します。
Top-P(核サンプリング)は、各ステップでモデルが考慮する可能性のある単語オプションの数を制御します。 「どの程度無作為か」ではなく、「どの程度の妥当な選択肢があるか」と考えてください。Top-P 0.1では、モデルはわずかな累積確率10%に達するまで最もよい選択肢だけを考慮します。Top-P 0.9では、はるかに広い範囲の可能な単語を考慮します。
簡潔に言えば:温度は「どの程度冒険的か」を制御し、Top-Pは「どの程度の選択肢を考慮するか」を制御します。どちらも出力の多様性に影響しますが、異なる方法で機能します。
🔍 ローカルモデルで動作
温度およびTop-P設定は、すべてのローカルLLMツールで利用可能です。同じパラメータ、同じ効果です。
プロンプト構造+温度設定
悪いプロンプト「秋について何か創造的なことを書いてください。」
良いプロンプト「詩人になったつもりで、秋についての100語の比喩的な描写を書いてください。温度:0.9、Top-P:0.95。」
数学的表記
温度範囲:T ∈ 0.0, 2.0
温度付きソフトマックス:softmax(logit_i / T) = exp(logit_i / T) / Σ(exp(logit_j / T))
Top-pサンプリング:Σ P(token_i) が ≥ p になるまで累積し、その集合からサンプリングする
AIの動作をどのように変えるか
温度の効果:
温度範囲 | ビヘイビア | 最適な用途 |
|---|---|---|
| 低い(0.0–0.3) | フォーカスされた、反復的で、非常に安定 | 毎回同じ答えが必要なタスク; ループのリスク |
| 中程度(0.4–0.7) | バランスの取れた安定性と多様性 | ほとんどの一般的なタスク; 推奨される開始点 |
| 高い(0.8–1.0+) | 創造的、多様、驚くべき | ブレーンストーミングと変動; 幻覚のリスク |
Top-Pの効果: 低い(0.1–0.3)は非常に狭いオプションセットと非常に保守的な出力を作成します。中程度(0.5–0.7)は多様性と安定性のバランスを取ります。高い(0.8–1.0)はオプションセットを広げ、高温度に似た創造性を促進します。重要: 多くのプロバイダーはこれらの設定をリンクまたは制限しています。OpenAIのGPTモデルは、温度が明示的に設定されている場合、しばしばTop-Pを無視します。一方、Anthropicの現行モデルでは両方のパラメータが既定値に完全に固定されています(後述)。常にあなたのプロバイダーのドキュメンテーションをチェックしてください—同じ数字はすべてのモデル間で同じ意味ではありません。
すべてのモデルが温度値を受け付けるわけではありません
📍 In One Sentence
複数のフロンティアモデルは既定値以外の温度・Top-Pをエラーで拒否するようになったため、まずパラメータが残っているかを確認してください。
💬 In Plain Terms
最新のモデルの一部では、つまみ自体がなくなっています。リクエストが失敗した場合、設定は無視されたのではなく拒否されています。
温度やTop-Pの値をまったく受け付けないフロンティアモデルが増えています。調整された出力ではなく、エラーが返ります。 推論モードのモデルは、内部で下書きと検証を何度も繰り返して回答を組み立てるため、その工程の較正を保つ目的でプロバイダーがサンプリングパラメータを固定しています。調整に時間をかける前に、呼び出すモデルにつまみが残っているかを確認してください。
Anthropic: Claude Opus 5、Claude Sonnet 5、Claude Fable 5.1(およびClaude Opus 4.7と4.8)では、既定値以外のtemperature、top_p、top_kはすべてのリクエストで400エラーになります。思考が有効なときだけではありません。それ以前のClaudeモデルでは、この制限は思考が有効な間だけ適用され、その場合のtop_pは0.95〜1.0の範囲で受け付けられます。
OpenAI: 推論モードのGPT-5ファミリーは、既定値以外を「Unsupported value: temperature does not support 0.2 with this model. Only the default (1) value is supported.」というエラーで拒否します。推論を使わないエンドポイントは、引き続き0〜2の全範囲を受け付けます。
Google: Geminiは引き続きgenerationConfig経由でtemperatureとtopPを公開しているため、本ガイドの数値範囲はGeminiモデルにそのまま当てはまります。
ローカルモデル: Ollama、LM Studio、llama.cppはどのモデルでも両方のパラメータを公開しており、プロバイダー側のロックはありません。同じプロンプトで0.2と0.9の違いを体感したいなら、ローカルモデルが最も安価な検証環境です。
パラメータが固定されている場合は、プロンプトで制御します。温度を下げたい場面では、出力形式を厳密に指定して唯一の確定的な回答を求めます。温度を上げたい場面では、明確に異なる複数の案を明示的に要求します。プロバイダーが推論の強度を指定できる場合は、それが温度に代わる設定です。
⚠️ 拒否は「効果なし」ではありません
拒否されたリクエストは「設定が効かなかった」と誤読されがちです。400エラーはパラメータが拒否されたという意味であり、指定した値での実行自体が行われていません。
温度対Top-P:両方が必要ですか?
両方の設定は無作為性を制御しますが、ほとんどのユーザーは1つだけを調整し、もう1つを妥当なデフォルトのままにするべきです。 両方同時に変更すると、どちらが望みの効果を生み出したか知ることができません。数千のプロンプト調整の経験から:Top-Pをデフォルト(例:0.9–1.0)に保ち、温度だけを調整してください。特定のモデルが別の方法を推奨していない限り。
戦略 | 温度 | Top-P | いつ使用するか |
|---|---|---|---|
| 決定的モード | 0.0–0.2 | 1.0(デフォルト) | コード、データ抽出、ミッションクリティカルな出力 |
| バランスの取れたデフォルト | 0.5–0.7 | 0.9–1.0 | ほとんどの一般的なタスク、要約、説明 |
| クリエイティブ/ブレーンストーミング | 0.8–1.0 | 0.9–1.0 | アイデーション、マーケティングコピー、変動、ストーリーテリング |
| 高安定性生産 | 0.0–0.3 | 0.95 | ヘルスケア、金融、法律、安全クリティカル |
ユースケース別の推奨設定
- コーディング、リファクタリング、バグ修正: 温度0.1–0.3、Top-P 0.95。構文は正確でなければならず、創造性は邪魔です。低い設定は幻覚関数名やロジックエラーを防ぎます。
- 要約と説明: 温度0.4–0.6、Top-P 0.9。明確さと一貫性が必要ですが、フレーズの変動は問題ありません。低い温度は要約を機械的に見せることができます。
- アイデーのブレーンストーミング、マーケティングコピー、創造的なバリエーション: 温度0.7–1.0、Top-P 1.0。高い設定は予期しない組み合わせと新しいフレーズングを促進します。より多くの出力をフィルタリングする必要がありますが、より野性的なアイデアが得られます。
- データ抽出と構造化出力: 温度0.0–0.2、Top-P 0.95。フォーマットは正確でなければなりません。高い無作為性はパース不可能やフィールド欠落を招きます。
- 長編成執筆(エッセイ、ブログ投稿): 温度0.6–0.8、Top-P 0.9–1.0。ここから始めて、フィードバックに基づいて調整します。出力が平凡に見える場合は温度を上げ、逸脱または幻覚が見える場合は下げます。
- 事実ベースのQ&A(基盤なし): 温度0.3–0.5、Top-P 0.9。中程度の設定は幻覚を減らしながら、反応を自然に保ちます。
プロンプトとパラメータがどのように一緒に機能するか
プロンプト設計はスライダー設定よりも常に重要です。 温度0.2での曖昧な指示は相変わらず悪い答えを生成します—ただ一貫した悪い答えです。明確でよく構成されたプロンプトは完璧な設定の悪いプロンプトよりも良い結果を生成します。プロンプト構造の基礎については、基礎:プロンプトエンジニアリングとは何か?を参照してください。
正しいワークフローは次のとおりです:(1)まず明確なタスク、コンテキスト、制約、出力フォーマットでプロンプトを設計します(基礎:すべてのプロンプトが必要とする5つの基本要素を参照)。(2)ターゲット温度/Top-Pでテストします。(3)プロンプトが堅実になった後、より多くまたはより少ない変動が必要な場合のみスライダーを調整します。
同じプロンプトが異なる温度では非常に異なるスタイルを生成します。温度0.2では、出力は安全で直接的です。温度0.8では、出力は創造的で詩的です。どちらが「良い」わけではありません—これはあなたのブランド声とユースケースに依存します。ほとんどのタスクでは、最初にプロンプトを修正することは、温度でまったく動く必要性を排除します。
プロンプトの例
生産性向上アプリ用の短くてインパクトのあるプロダクトスローガンを書いてください。10語未満に保ってください。
温度0.2の場合:
"より短い時間でより多く実行してください。"
温度0.8の場合:
"カオスから明確性へ:瞬間がモメンタムに変わるところ。"
より高い創造性がリスクになる場合
より高い温度とTop-Pは幻覚、トピック外のタンジェント、スタイルドリフトを増加させます—特に事実的なタスクの場合。 保守的に(温度0.0–0.5):本番に行くコード(幻覚APIは システムを破壊)、健康と医学的アドバイス(誤った情報は害を及ぼす)、金融と法務(精度は必須)、および安全クリティカルな決定(エラーは結果をもたらす)。
事実ベースのタスクでは、低い温度をテクニック:RAG説明:実データでAI回答を根拠するまたは明示的なソース制約と組み合わせることを検討してエラーをさらに減らします。また、基礎:AI幻覚:なぜAIが物を発明するのかを参照して、なぜ高い温度が矛盾を増幅するかについてのより深いコンテキスト。
PromptQuorumが温度とTop-Pの調整を支援する方法
通常、温度とTop-Pの設定をテストすることは、複数のモデル全体で同じプロンプトを何度も実行し、出力を手動で記録して比較することを意味します—時間がかかり、追跡が困難です。PromptQuorumはこのワークフローを効率化します。
マルチモデル比較: 1つのプロンプトを異なる温度/Top-P設定でパラメータを受け付ける25以上のモデル(Gemini 3.1 Pro、推論を使わないGPT-5.6のエンドポイント、Mistral、ローカルOllamaモデル)に送信します。どのモデルが高温度でも安定しているか、ターゲット設定で最適な創造的出力を提供するかをすぐに確認できます。
フレームワークベースの構造: PromptQuorumのフレームワークは、スライダーに触れる前に、指示、フォーマット、制約が適切に構成されていることを確認します。これにより、温度/Top-Pの効果が他の変数から分離されます。悪いプロンプトとパラメータ調整を混ぜていません。
コンセンサスと採点: Quorum分析で幻覚リスク、スタイル一貫性、関連性をスコアリングしながら、すべての出力を並べて表示します。タスクの創造性と信頼性のトレードオフに最適なモデル+設定の組み合わせを選択します。
自動温度推奨: PromptQuorumはタスク説明とプロンプト構造を分析し、ユースケース(コーディング、要約、ブレーンストーミング等)に基づいて最適な温度範囲を提案します。アプリとChromeエクステンションの両方で利用でき、PromptQuorumは標準デフォルトを超えた温度値を提案し、特定のタスクと使用しているモデルに合わせています。「0.2または0.7を使用すべきか?」と推測する代わりに、ツールはタスク分析に基づいて具体的な値を推奨します—手動のトライアルアンドエラーをスキップするのに役立ちます。
ローカルLLMワークフロー: スクリプトを書かずにOllamaまたはLM Studioでさまざまな温度/Top-P組み合わせをテストして、ワークフローのベストプリセットを保存します。
クイックスタートレシピ
タスクの出発点として使用してください:
- 安全な事実モード: 温度0.2、Top-P 0.95 | 最適な用途:Q&A、要約、データ抽出、事実ベースのタスク | 出力:信頼できる、一貫性のある、最小限の幻覚
- デフォルトバランスモード: 温度0.5、Top-P 0.9 | 最適な用途:ほとんどの一般的なタスク、説明、一般的な執筆 | 出力:自然、安定、しかし変動あり
- 創造的ブレーンストーミングモード: 温度0.8、Top-P 1.0 | 最適な用途:アイデーション、マーケティングコピー、ストーリーテリング、バリエーション | 出力:多様、驚くべき、フィルタリング対象のオプションが多くあります
- 短答モード: 温度0.3、Top-P 0.95(基礎:より速いAI回答:速度のためにプロンプトする方法とペアリング)| 最適な用途:直接的な回答、迅速な決定、簡潔な出力 | 出力:速い、直接的、最小限の詳細
- 実験モード: 温度1.0、Top-P 1.0 | 最適な用途:モデルの動作を探索、制限を理解、研究 | 出力:予測不可能、最大限の変動
温度とTop-Pでの一般的なミステイク
- 両方を最大に上げて信頼性を期待します。 高い温度+高いTop-P=最大無作為性。ブレーンストーミングまたは実験をしているときだけこれをしてください。
- 同時に両方のノブを変更します。 どちらの設定が役立つまたは傷つけたかはわかりません。1つを変更し、観察し、必要に応じてもう1つを変更します。
- スライダーで悪いプロンプトを修正しようとしてください。 曖昧な指示はあらゆる温度で依然として悪い出力を生成します。最初にプロンプトを修正してください。
- どのモデルにも温度のつまみがまだあると思い込む。 Anthropicの現行Claudeモデルと OpenAIの推論モデルは既定値以外を明確に拒否します。受け付けるモデル同士でも同じ数値の意味は異なり、Gemini 3.1 Proの温度0.7はローカルのLlamaビルドの0.7とは別物です。実際に呼び出すモデルをそのままテストしてください。
- 十分な実行をテストしません。 温度0.5での1つの出力は外れ値かもしれません。典型的な動作を見るために少なくとも3~5回実行してください。
- 温度を0に設定し、完璧な正確性を期待します。 低い温度は無作為性を減らしますが、幻覚を排除しません。幻覚は無作為なサンプリングからではなく、トレーニングデータギャップから来ます。
- プロバイダーが無視するため完全に無視します。 一部のモデルはそうしますが、そうではないものもあります。ドキュメントをチェックして、無効になっているノブを調整するための時間を無駄にしないでください。
タスクに合わせて温度とTop-Pを設定する方法
- 1パラメータではなくプロンプトから始める: 指示が明確になるまで書いて調整してください。パラメータは曖昧なプロンプトを修正できません — サンプリング分布に影響するだけで、モデルのタスク理解には影響しません。
- 2タスクの種類を特定する: 事実に基づく分析タスク(法律分析、コードレビュー、データ抽出)→ 温度0.0〜0.3に設定。創造的または生成的なタスク(ブレーンストーミング、コピーライティング、ストーリーのアイデア)→ 温度0.7〜1.0に設定。
- 3Top-Pはデフォルト(0.9〜1.0)のままにする: 特定の理由がある場合のみTop-Pを調整してください。温度とTop-Pを同時に変更すると、どちらの設定が出力を変えたのか診断が難しくなります。
- 4目標温度で3〜5回のテストプロンプトを実行する: 出力の一貫性を評価します。事実に基づくタスクで出力のばらつきが大きすぎる場合は温度を下げ、創造的なタスクで出力が単調に感じる場合は温度を上げます。
- 5ユースケースごとに調整済みの設定を記録する: 特定のワークフローに適した温度が見つかったら、システムプロンプトテンプレートに記録し、セッション間で一貫して適用されるようにします。
まず温度またはTop-Pを調整すべきですか?
温度。より明らかな効果があります。タスクが温度を実行するかについて感覚を得るまでTop-Pをデフォルト(0.9–1.0)に保ち、必要に応じてのみTop-Pを微調整します。
1つのモデルがなぜ温度設定を無視しますか?
多くの場合、無視しているのではなく拒否しています。Anthropicの現行Claudeモデルと OpenAIの推論モデルは、温度やTop-Pが既定値と異なると400エラーを返します。古い構成では、一方を明示的に設定するともう一方が黙って制限されることもあります。プロバイダーのドキュメントを確認し、失敗したリクエストは「効果がなかった設定」ではなく「拒否」として読んでください。
保証された正確性のために温度を0に設定できますか?
いいえ。温度0.0は「常に最も可能性の高い単語を選ぶ」を意味し、これはほぼ決定的ですが、常に正確とは限りません。幻覚は無作為なサンプリングではなく、トレーニングデータギャップとタスク曖昧性についてです。より良い信頼性のために低い温度を明確なプロンプトとグラウンドと組み合わせます。
なぜ低い温度でまだ幻覚が見られますか?
モデルのトレーニングデータにギャップがあるか、タスクが曖昧な場合、幻覚は発生します—無作為サンプリングだけではなく。低温設定は幻覚に関して一貫性がありますが、それらを排除しません。RAGまたは明示的なソース制約を使用してそれらを減らします。
GPT-5.6、Claude Opus 5、Gemini 3.1 Proで推奨設定が異なりますか?
「わずかに」どころではありません。3つのうち1つはもう設定自体を受け付けません。Claude Opus 5(Claude Sonnet 5とClaude Fable 5.1も同様)は、既定値以外の温度やTop-Pを一切拒否します。Gemini 3.1 ProはgenerationConfig経由で両方を公開しており、0.5〜0.7では素直に動作します。GPT-5.6は推論を使わないエンドポイントでは全範囲を受け付けますが、推論モードでは既定値以外を拒否します。実際に呼び出すモデルとモードをそのままテストしてください。
設定を公平に比較するのに何回実行が必要ですか?
典型的な動作を見るために、設定あたり少なくとも3~5。出力分散が高い高い温度で作業する場合はさらに多く。PromptQuorumのマルチラン機能はこれをすべてのモデルで自動的に処理します。
モデルが温度パラメータを拒否する場合はどうすればよいですか?
代わりにプロンプトで制御します。温度を下げたい場面では、出力形式を厳密に指定して唯一の確定的な回答を求めます。温度を上げたい場面では、明確に異なる複数の案を明示的に要求します。プロバイダーが推論の強度を指定できる場合は、それが温度に代わる設定です。Anthropicの現行Claudeモデルと OpenAIの推論モデルは、値を黙って無視するのではなくエラーを返します。
OpenAI. "API reference: Chat Completions" – temperatureとtop_pの公式なパラメータ範囲と既定値
Holtzman et al., 2020. "The Curious Case of Neural Text Degeneration" – 核サンプリング(Top-P)とテキスト品質への影響に関する研究
Anthropic. "Thinking" – 既定値以外のtemperature、top_p、top_kを拒否するClaudeモデルの一覧
Google. "Gemini API: Text generation" – temperatureを含むGeminiの生成設定