- 所有M系列芯片使用统一内存(GPU+CPU共享同一RAM池)。
- Apple于2026年8月25日更新后,M6(Mac mini)以及M5 Pro/M5 Max/M5 Ultra(Mac mini和Mac Studio)是2026年的推荐配置;M4及更早型号仍可用但不面向未来。
- Metal是Apple的GPU编程框架;集成在macOS中,无需外部库。
- 框架选择(Ollama、MLX、llama.cpp)影响速度0-25%但不改变模型适配。
- Mac mini M6是最便宜入口(899美元起,16GB,最高32GB),空闲时近乎无声(Apple标称5 dBA)。
- 年度电费估算(示意值,24小时全天候、0.15美元/kWh,非实测):Mac mini M6(~35美元)对比台式RTX 4090(~400美元)——约10倍差异。
Apple Silicon为何适合本地LLM
Apple Silicon在本地LLM推理中表现突出,原因很简单:统一内存。当您购买具有64GB RAM的Mac时,扣除macOS所需的8GB后,约56GB可供LLM模型使用。离散GPU(如RTX 4090)拥有24GB VRAM(独立于系统RAM)——大于24GB的模型在不采用复杂多GPU设置的情况下根本无法适配。
- 统一内存:扣除macOS所需约8GB后的RAM可用(视芯片总计16-512GB)。RTX 4090:仅限离散VRAM(24GB硬限制)。
- Metal加速:无CUDA依赖或专有驱动的GPU推理。
- 功耗效率:负载时20-100W对比台式GPU的300W+。支持无风扇或近乎无声操作。
- 静音:MacBook Air无风扇;Apple标称Mac mini空闲时为5 dBA。
- 无驱动管理:Metal在macOS上开箱即用。无CUDA版本冲突,无NVIDIA驱动更新。
- 硬件成本:M5 Pro Mac mini(1,699美元起)配64GB对比相当模型容量的双GPU设置(4,000美元+)。
Apple Silicon芯片完整对比
芯片 | 最大内存 | 内存带宽 | GPU核心 | LLM最优点 | 发布日期 |
|---|---|---|---|---|---|
| M1 | 16 GB | 68 GB/s | 8 | 7B Q4 | 2020年11月 |
| M1 Pro | 32 GB | 200 GB/s | 16 | 13B Q4 | 2021年10月 |
| M1 Max | 64 GB | 400 GB/s | 32 | 32B Q4 | 2021年10月 |
| M1 Ultra | 128 GB | 800 GB/s | 64 | 70B Q4 | 2022年3月 |
| M2 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | 2022年6月 |
| M2 Pro | 32 GB | 200 GB/s | 19 | 13B Q4 | 2023年1月 |
| M2 Max | 96 GB | 400 GB/s | 38 | 34–70B Q4 | 2023年1月 |
| M2 Ultra | 192 GB | 800 GB/s | 76 | 70B+ Q4 | 2023年6月 |
| M3 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | 2023年10月 |
| M3 Pro | 36 GB | 150 GB/s | 18 | 13–32B Q4 | 2023年10月 |
| M3 Max | 128 GB | 400 GB/s | 40 | 70B Q4 | 2023年10月 |
| M4 | 32 GB | 120 GB/s | 10 | 13B Q4 | 2024年5月 |
| M4 Pro | 48 GB | 273 GB/s | 20 | 32B Q4 | 2024年10月 |
| M4 Max | 128 GB | 546 GB/s | 40 | 70B Q4 | 2024年10月 |
| M5(基础) | 32 GB | ~150 GB/s | 10 | 13B Q4 | 2025年10月 |
| M6(Mac mini) | 32 GB | 最高170 GB/s | 12 | 13B Q4 | 2026年8月 |
| M5 Pro | 64 GB | 307 GB/s | 最高20 | 32B Q5 | 2026年8月 |
| M5 Max | 128 GB | 460–614 GB/s | 32–40 | 70B Q5 | 2026年8月 |
| M5 Ultra | 512 GB | 1.2 TB/s | 最高80 | 120B+ Q4 / 70B FP16 | 2026年8月 |
M5 Pro最早于MacBook Pro发布(2026年3月);2026年8月25日的更新将其带入Mac mini,与全新的M6一同登场。M5 Max和M5 Ultra自2026年8月25日起首次登陆Mac Studio。四款芯片均自2026年9月22日起发售;M5 Ultra的512GB配置自2026年10月28日起可订购。M6、M5 Pro、M5 Max和M5 Ultra的数据来自Apple的Mac mini和Mac Studio规格页。
内存带宽比内存大小更重要
LLM推理受内存带宽限制,而非计算限制。这意味着令牌生成速度与带宽线性扩展,而非GPU核心数。
M5 Max在614 GB/s对比RTX 4090的1,008 GB/s看起来NVIDIA在原始带宽上赢了。但Apple Silicon用户可使用几乎全部内存(总量减去macOS所需的约8GB,无离散VRAM限制),因此可加载NVIDIA无法适配24GB的更大模型。
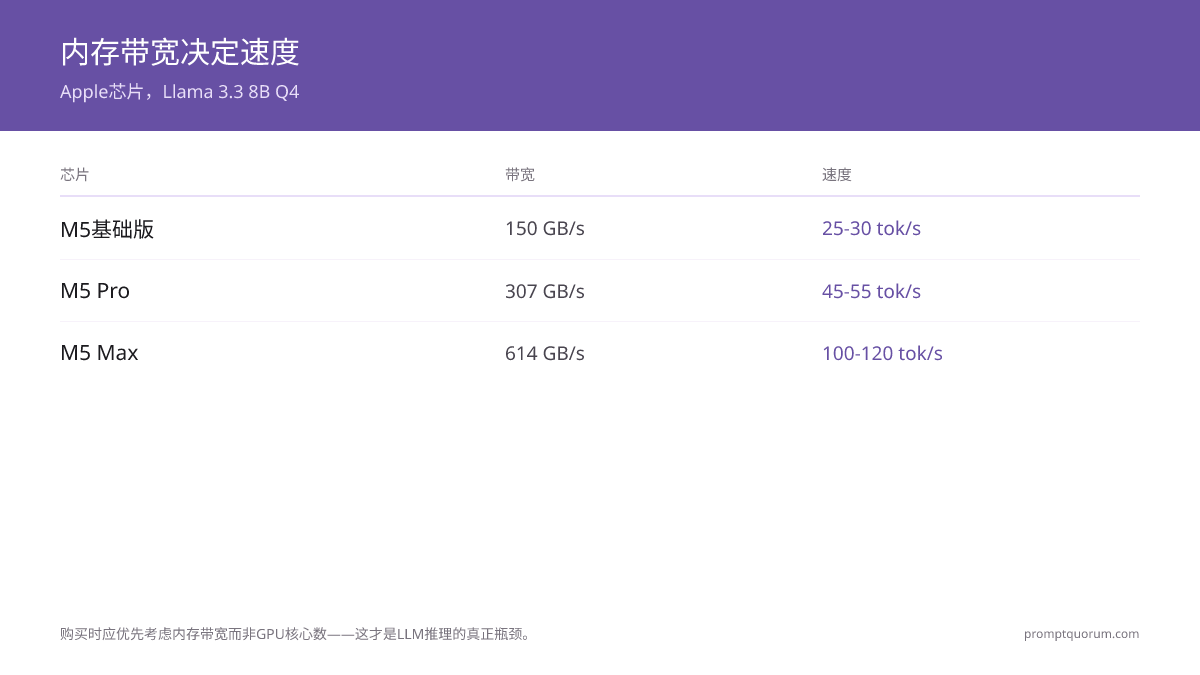
- M5基础(150 GB/s)→ Llama 3.1 8B Q4时~25-30 tok/s(估算)
- Mac mini M6(最高170 GB/s)→ 与M5基础相近,因带宽略高而稍快。Apple仅公布相对宣称(较M4 Mac mini AI性能最高提升4倍),M6的独立tok/s数据我们尚未核实。
- M5 Pro(307 GB/s)→ Llama 3.1 8B Q4时~50-60 tok/s(估算)(由于带宽翻倍为M5基础的2倍)
- M5 Max(614 GB/s)→ Llama 3.1 8B Q4时~100-120 tok/s(估算)
- M5 Ultra(1.2 TB/s,Apple规格)→ BGR报告称,用4位Qwen 3.8 27B测得约55 tok/s,M3 Ultra(约819 GB/s)约40 tok/s。带宽约高1.5倍,生成速度约高1.4倍,与受带宽限制的推理相符。
- 经验教训:购买时优先考虑带宽而非GPU核心。

32GB 还是 64GB:按用途选内存
内存容量决定你能跑多大的模型,内存带宽决定它跑多快——选机时要分开看这两件事。 32GB 可以稳妥地跑到 13B 级别,64GB 能跑到 32B 级别,128GB 才能舒服地跑 70B。如果主要用途是本地推理,先按目标模型规模定内存容量,再看芯片档位。Mac 的内存焊死在芯片上,购买后无法升级,所以这一步一次到位比事后更换整机便宜。
视频剪辑、三维渲染和本地大模型推理的瓶颈并不相同,不能用同一套标准选机。 视频剪辑主要吃媒体引擎和 GPU 核心数,三维渲染吃 GPU 核心与内存容量,而大模型推理几乎完全受内存带宽和容量限制。同一台机器可能很适合剪辑,却在跑大模型时明显吃力。三种用途都要兼顾时,先按最吃内存的那一项(通常是大模型)确定容量,再按 GPU 需求选择芯片档位。
📍 简单一句话
本地大模型选 Mac 时,32GB 对应 13B 级模型、64GB 对应 32B、128GB 对应 70B,而生成速度由内存带宽决定。
💬 简单来说
内存大小决定你能跑多大的模型,内存带宽决定它跑多快。想跑常见的中型模型,64GB 是比较稳妥的起点;只做日常问答,32GB 也够用。视频剪辑和三维渲染看重的是别的指标,不能照搬这套标准。
- 32GB — 13B 以内的模型。日常问答、写作、代码补全够用,M5 基础版或 M6 即可。
- 64GB — 32B 级别模型,约 15-20 tok/s(估算)。M5 Pro(307 GB/s)是这一档的主力选择。
- 128GB — 70B 模型,约 12-18 tok/s(估算)。需要 M5 Max(614 GB/s)。
- 带宽决定速度: M5 基础 150 GB/s、M6 170 GB/s、M5 Pro 307 GB/s、M5 Max 614 GB/s。同一个模型,带宽大致翻倍,token/s 也大致翻倍。
- M5 Ultra 的内存带宽为 1.2 TB/s(Apple 规格),BGR 报告称,在 256GB 机型上用 4 位 Qwen 3.8 27B 测得约 55 tok/s,M3 Ultra 约 40 tok/s。
功耗效率和热管理——无声优势
配置 | 功耗(空闲) | 功耗(LLM) | 噪声 | 温度 |
|---|---|---|---|---|
| Mac mini M6 | 5W | 25–35W | 近乎无声(空闲5 dBA) | 温暖 |
| MacBook Air M5 | 3W | 20–30W | 无声(无风扇) | 温暖 |
| Mac mini M5 Pro | 5W | 40–60W | 安静(风扇少转) | 凉爽 |
| Mac Studio M5 Max | 10W | 60–100W | 安静 | 凉爽 |
| Mac Studio M5 Ultra | 10W | 最高480W持续(Apple) | 安静 | 凉爽 |
| 台式RTX 4090 | 50W | 350–450W | 负载下风扇噪音明显 | 炎热 |
| 台式RTX 3060 | 30W | 170–200W | 适中 | 温暖 |
年度电费估算(0.15美元/kWh,24/7 AI服务器;示意值,非实测,实际费用取决于使用情况):Mac mini M6(~35美元/年)对比台式RTX 4090(~400美元/年)。空闲和负载功耗为PromptQuorum的估算值,并非实测值,也不是Apple规格;Apple标称最大持续功率:Mac mini为155W,Mac Studio为480W。

真实用户场景
- 1编码代理
Why it matters: M5 Pro上的Llama 3.1 8B提供50 tok/s(估算);代码补全延迟取决于模型大小和设置,PromptQuorum未实测。在MacBook Pro后台无声运行。 - 2RAG管道
Why it matters: 嵌入模型 + Llama 3.1 8B + ChromaDB完全适合36GB M5 Pro统一内存。无GPU限制。 - 3语音助手
Why it matters: Whisper Metal + Ollama Llama + Piper TTS :延迟取决于模型大小和设置,PromptQuorum未在M5 Pro上实测。安静的Mac mini适合常开设置。 - 4多模态
Why it matters: Whisper + LLaVA 7B视觉 + Llama 3.1 8B推理 = 全部适合36GB,同时处理。 - 5私密写作
Why it matters: M5 Max 128GB上的Llama 3.3 70B Q5 = 适合长文写作的高质量,模型下载后可离线运行,无按token计费的API成本,推理时提示词保留在本机。在全新Mac Studio M5 Ultra(最高512GB)上,需要更多余量的用户还可运行120B+模型。
应购买哪种Mac
- 899美元:Mac mini M6(16GB)→ 适合尝鲜,7-8B模型,带宽最高170 GB/s,2026年9月22日起发售
- 899美元起:Mac mini M6(32GB,升级需加价)→ 最高13B模型
- 1,699美元:Mac mini M5 Pro(64GB)→ 15-20 tok/s(估算)的最多32B模型
- 约2,500美元:MacBook Pro M5 Pro(48GB)→ 便携式AI工作站
- 2,499美元:Mac Studio M5 Max(128GB)→ 12-18 tok/s(估算)的70B模型,常开服务器
- 5,499美元(96GB)至22,299美元起(512GB):Mac Studio M5 Ultra → 少数支持120B+模型的消费级硬件之一,512GB配置自2026年10月28日起可订购
- 关键:内存在购买时即固定,无法升级,请按预算和要运行的模型选择最大配置。仅M5 Ultra的512GB选项就加价15,500美元(MacRumors)。价格为美国官方标价,其他地区可能不同。
入门:框架概览
- Ollama:最简单的设置、Metal自动检测、无配置。包含REST API。最适合初学者。
- MLX:Apple原生框架、在社区测试中通常比Ollama更快、Python集成、LoRA微调。学习曲线更陡。
- llama.cpp:跨平台C++、最广泛模型格式支持(GGUF)、Metal后端。最适合大型应用集成。
Mac mini M6/M5 Pro 与 Mac Studio M5 Max/M5 Ultra 更新
Apple于2026年8月25日宣布了Mac mini和Mac Studio的更新。两款设备均自2026年9月22日起发售,M5 Ultra的512GB配置自2026年10月28日起可订购。Apple自己的性能宣称会标明为宣称;独立结果则注明来源。
- Mac mini M6:起价899美元(教育优惠799美元),16GB,可选配至32GB。12核CPU、12核GPU,内存带宽最高170 GB/s。Apple宣称CPU性能较M4 Mac mini提升40%,AI性能最高提升4倍——这是Apple自己的数字,未经独立验证。
- Mac mini M5 Pro:起价1,699美元。最高18核CPU、最高20核GPU、307 GB/s内存带宽,最高64GB统一内存。
- Mac Studio M5 Max:起价2,499美元。18核CPU、32或40核GPU,最高128GB统一内存,内存带宽460-614 GB/s(视配置而定)。
- Mac Studio M5 Ultra:起价5,499美元(教育优惠5,099美元),基础配置96GB统一内存,256GB和512GB为定制选项。最高36核CPU、最高80核GPU,内存带宽1.2 TB/s。512GB选项需选36核CPU/80核GPU机型,自2026年10月28日起可订购,512GB配置的最低价格为22,299美元。
- Mac Studio支持带RDMA的Thunderbolt 5集群;Apple宣称分布式AI推理比单台系统最高快3倍——这是Apple自己的数字,未经独立验证。
- 首批独立的M5 Ultra结果(BGR,2026年9月21日;256GB机型,LM Studio,4位MLX):Qwen 3.8 27B约55 tok/s,M3 Ultra约40 tok/s;Qwen 3.5 122B A10B约80对60 tok/s。BGR称其测试中平均性能比M3 Ultra高30-40%;未说明上下文长度和运行次数。
- 前代的M4 Mac mini/M4 Pro Mac mini以及Mac Studio M4 Max/M3 Ultra现已成为上一代产品。
- M5 Ultra的512GB上限是Apple迄今在消费级Mac上推出的最大统一内存,也正是它让单台消费级Mac(512GB配置)能够本地运行120B+参数模型。
常见问题
个人做视频剪辑、三维和本地大模型,M5、M5 Pro、M5 Max 该怎么选?
按最吃资源的那一项定档。只做日常问答和写作,M5 基础版加 32GB 就够。要跑 32B 级模型或做较重的剪辑,选 M5 Pro 加 64GB——它的 307 GB/s 带宽是基础版的两倍。要跑 70B 模型或做三维渲染,才需要 M5 Max 加 128GB(614 GB/s)。注意三种用途的瓶颈不同:剪辑看媒体引擎和 GPU 核心,三维看 GPU 与容量,大模型几乎只看内存带宽和容量。
32GB 还是 64GB 更合适?
看你要跑多大的模型。32GB 能稳妥地跑 13B 以内,适合日常问答、写作和代码补全;64GB 才能跑到 32B 级别,是想认真用本地大模型的实际起点。Mac 的内存无法在购买后升级,因此如果预算允许且打算长期使用,64GB 比 32GB 更保险。如果只把本地模型当辅助工具,32GB 完全够用,把预算留给存储更划算。
Mac mini M5 Pro 64GB 能跑什么模型?
可以跑到 32B 级别的模型,速度约 15-20 tok/s(估算)。它的内存带宽为 307 GB/s,是 M5 基础版 150 GB/s 的两倍,在 Llama 3.1 8B Q4 上约 50-60 tok/s(估算)。64GB 统一内存扣除macOS所需的8GB后,约56GB可供模型使用,没有独立显卡那样的显存上限,所以能装下 24GB 显存的 NVIDIA 显卡装不下的模型。
M5 Ultra 的内存带宽是多少?
Apple 在 Mac Studio 规格页公布的 M5 Ultra 内存带宽为 1.2 TB/s;作为参考,M5 Max 为 460-614 GB/s(视配置而定)。BGR 报告称,在 256GB 机型上用 4 位 Qwen 3.8 27B 测得约 55 tok/s,同一测试中 M3 Ultra(带宽约 819 GB/s)约 40 tok/s——带宽约高 1.5 倍,生成速度约高 1.4 倍。PromptQuorum 未自行测试 M5 Ultra。512GB 配置决定它能装下多大的模型,但装得下不等于跑得快。
Apple于2026年8月25日为Mac mini和Mac Studio发布了什么?
Apple以全新M6芯片(899美元,16GB,可选配至32GB)和M5 Pro(1,699美元,最高64GB)更新了Mac mini,并以M5 Max(2,499美元,最高128GB)和M5 Ultra(5,499美元,96GB起,最高512GB)更新了Mac Studio。全部自2026年9月22日起发售;M5 Ultra的512GB配置自2026年10月28日起可订购,起价22,299美元。
M5 Pro或M5 Max哪个更适合本地LLM?
M5 Pro(64GB)提供最佳价值——运行32B模型良好且起价1,699美元。M5 Max(起价2,499美元)仅在定期需要70B模型时才值得。M5 Pro(64GB)对本指南涵盖的大多数32B级用例而言性价比很高;如果经常需要70B模型,M5 Max更值得选择。
购买Mac后可升级内存吗?
不可以。Apple Silicon内存焊接,无法升级。购买时在预算范围内选择最大内存。
M5 Pro能与RTX 4090竞争吗?
在24GB VRAM能容纳的模型上,RTX 4090通常更快,差距因模型和量化方式而异,PromptQuorum未做实测。70B模型无法完整放入RTX 4090的24GB显存(可将部分层卸载到CPU,但速度会大幅下降),而64GB的M5 Pro可以用4位量化容纳它。参见:Apple Silicon vs NVIDIA GPU for LLMs。
需要Ollama、MLX还是llama.cpp?
从Ollama(最简单)开始。如需更快推理或微调,切换至MLX。如需跨平台兼容性,使用llama.cpp。三者均可在Apple Silicon上运行。
M5 Ultra最高512GB内存会改变什么?
会。M5 Ultra(Mac Studio,96GB起5,499美元,带宽1.2 TB/s,最高512GB起价22,299美元)以FP16(未量化,无量化损失)运行70B模型,并可在单台消费级Mac(512GB配置)上运行120B+模型。我们核实的首个独立测试(BGR,2026年9月21日,256GB机型)显示,4位Qwen 3.8 27B约55 tok/s,M3 Ultra约40 tok/s。PromptQuorum未自行进行M5 Ultra基准测试。
2026年Apple Silicon对本地LLM值得投资吗?
值得,特别是32B+模型。Apple Silicon是少数能在无多GPU复杂性前提下运行70B模型的消费级硬件之一,而Mac Studio M5 Ultra是少数能容纳120B+模型的消费级硬件之一。对于适配24GB NVIDIA VRAM的8B模型,RTX 4090更快但运营成本高。Mac mini M5 Pro(1,699美元起,最高64GB)对本指南涵盖的大多数32B级用例而言性价比很高;如果经常需要70B模型,M5 Max更值得选择。
MacBook Air M5能运行本地LLM吗?
可以,但有限制。MacBook Air M5在16GB下可运行7-8B模型(macOS占用后约剩8GB),24-32GB下可运行至13B模型。无风扇设计在持续高负载下可能出现热节流。偶尔使用:没问题。持续推理:Mac mini M5 Pro更合适。
Apple M6的本地LLM性能如何?
Apple仅公布了相对宣称:AI性能比M4 Mac mini最高提升4倍,CPU快40%。在2026年8月的更新中,M6只出现在Mac mini上(899美元,16GB,最高32GB,带宽最高170 GB/s)。由于生成速度取决于内存带宽,预计接近M5基础版而非M5 Pro;M6的独立tok/s数据我们尚未核实。
32GB的M1 Mac适合什么本地LLM配置?
32GB的M1 Pro或M1 Max(带宽200 GB/s和400 GB/s)可以从容运行13B Q4模型,这也是上方芯片对比表中的最优点;64GB的M1 Max可达32B Q4。原版M1最高只有16GB,建议使用7B Q4。
本地LLM上,M3 Ultra和M5 Max相比如何?
M3 Ultra在内存容量上胜过M5 Max(最高512GB对128GB),因此能装下最大的模型。速度方面,BGR报告称在27B测试中M5 Max的MacBook Pro与M3 Ultra的Mac Studio表现相近,而M5 Ultra平均比M3 Ultra高30-40%。48GB的M5 Pro低于两者,是想要余量又不想付Ultra价格的用户的最优点。
在中国使用需要考虑什么?
本地运行LLM可以让数据留在设备上,有助于满足《数据安全法》等法规对数据处理的要求,但是否合规取决于具体场景,不构成法律意见,企业应咨询法律专业人士。另请确认Apple Silicon产品在中国大陆的采购渠道与可用性。
在中国企业中部署本地LLM有什么优势?
中国企业部署本地LLM的潜在优势:(1)数据主权——数据可保留在本地设备,减少跨境传输 (2)降低合规工作的复杂度——有助于应对《数据安全法》《个人信息保护法》等要求,但不构成合规保证 (3)成本——可减少按量计费的云API支出,实际节省取决于使用量和部署方式。
基准测试方法与新鲜度
- MacBook Pro配置的M5 Pro/Max数据基于2026年3-5月社区基准测试
- M5 Ultra:已有独立结果(BGR,2026年9月21日,256GB机型——见2026年8月更新一节)。M6以及Mac mini/Mac Studio的M5 Pro/M5 Max的tok/s数据为基于带宽的估算或社区结果;Apple自身的性能宣称均已标明
- 最后验证:2026-11-02
- 性能随框架更新改进(Ollama、MLX、llama.cpp月度发布)
- 本文按季度复核,待我们核实M6和Mac Studio M5 Max的独立结果后补充