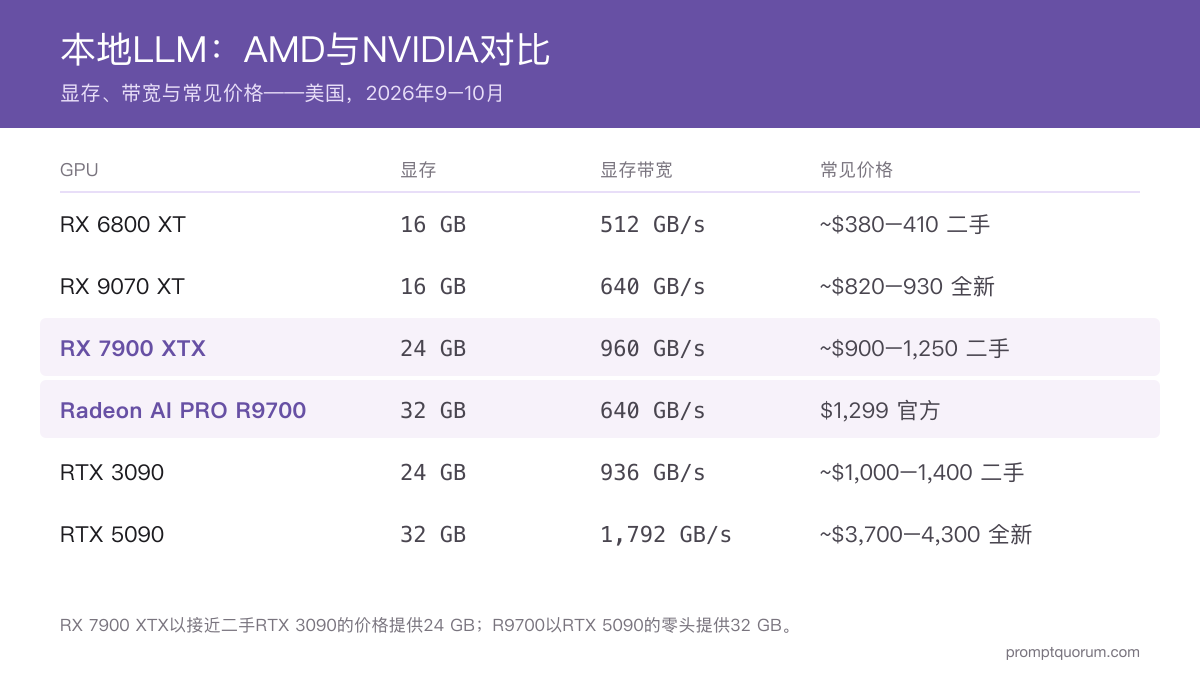
哪些AMD显卡值得买来跑本地LLM?
- RX 7900 XTX(24 GB GDDR6,960 GB/s,RDNA 3):VRAM和带宽最大的AMD消费级显卡。32B模型的Q4_K_M约20 GB,因此还有余量留给上下文。列于AMD的ROCm 7.2.1支持表,也在Ollama的Linux和Windows ROCm列表中。二手约$900–1,250。
- RX 9070 XT(16 GB GDDR6,640 GB/s,RDNA 4):较新的16 GB选择,列于AMD的ROCm 7.2.1支持表和Ollama的Linux ROCm列表。可轻松运行Q4–Q6的14B模型。全新约$820–930。
- Radeon AI PRO R9700(32 GB GDDR6,640 GB/s,RDNA 4):工作站显卡,是AMD该级别中显存最大的。可处理Q4–Q6的32B模型;两张卡(64 GB)可容纳Q4的70B模型。AMD官方定价$1,299;据报道实际售价更高。
- RX 7900 XT(20 GB GDDR6,800 GB/s,RDNA 3):可容纳Q4下约24–27B的模型。只有明显比二手7900 XTX便宜时才值得买;本次更新未重新核对其价格。
- RX 6800 XT(16 GB GDDR6,512 GB/s,RDNA 2):预算之选,二手约$380–410。带宽较低意味着生成更慢,而且AMD当前Radeon的ROCm支持表已不再列出它,需走Ollama的Linux ROCm路径或Vulkan。
- Ryzen AI Max+ 395迷你主机(最高128 GB统一内存,256 GB/s):它不是显卡,但是用AMD运行超大型混合专家(MoE)模型成本较低的方式。128 GB系统在2026年9月下旬的挂牌价约$3,300–4,350(价格追踪站)。参见本地LLM最佳AMD迷你主机。
AMD显卡在显存和价格上与NVIDIA如何比较?
GPU | 显存 | 显存带宽 | 常见价格 | 主要后端 |
|---|---|---|---|---|
| RX 6800 XT | 16 GB | 512 GB/s | 约$380–410(二手) | ROCm(Linux)、Vulkan |
| RX 9070 XT | 16 GB | 640 GB/s | 约$820–930(全新) | ROCm(Linux)、Vulkan |
| RX 7900 XT | 20 GB | 800 GB/s | 未重新核对 | ROCm、Vulkan |
| RX 7900 XTX | 24 GB | 960 GB/s | 约$900–1,250(二手) | ROCm、Vulkan |
| Radeon AI PRO R9700 | 32 GB | 640 GB/s | 官方$1,299;实售约$1,400–1,900 | ROCm(Linux)、Vulkan |
| RTX 3090 | 24 GB | 936 GB/s | 约$1,000–1,400(二手) | CUDA、Vulkan |
| RTX 4090 | 24 GB | 1,008 GB/s | 约$2,250(二手) | CUDA、Vulkan |
| RTX 5090 | 32 GB | 1,792 GB/s | 约$3,700–4,300(全新) | CUDA、Vulkan |
显存容量和带宽为厂商规格(AMD RX 7900 XTX、RX 9070 XT、Radeon AI PRO R9700)。价格是来自公开价格追踪站和评测的美国挂牌价快照(2026年9–10月),并非PromptQuorum的实测;你所在地区的价格会有差异。购买前请查看实际成交价。

LLM推理中AMD显卡的速度与NVIDIA相比如何?
生成token的速度更取决于显存带宽而非TFLOPS,在这方面AMD的高端显卡接近NVIDIA上一代旗舰。 RX 7900 XTX(960 GB/s)接近RTX 3090(936 GB/s),低于RTX 4090(1,008 GB/s)和RTX 5090(1,792 GB/s)。
提示词处理(prefill)是NVIDIA优势更明显的地方。在一项社区llama.cpp对比中(llama.cpp讨论#19890,被第三方评测转引),RTX 5090的prefill速度约为Radeon AI PRO R9700的2.6–3.4倍,同一模型的生成速度约为其1.5倍。这是开发者自行报告的数据,并非PromptQuorum的实测。
后端选择会改变结果:Vulkan与ROCm(HIP)的快慢随模型、显卡和驱动版本而互有胜负。llama.cpp可以同时编译两者,因此在定下来之前请在自己的显卡上分别测试。
实际使用中,可以预期AMD在单位带宽的生成速度上有竞争力,长提示词处理较慢,软件成熟度也稍逊一筹。
2026年配置ROCm有多难?
Vulkan只需要图形驱动;ROCm需要受支持的GPU、Linux发行版和内核。 购买前请先确认:
1. 对照AMD的支持表。 Radeon的ROCm 7.2.1支持表在Ubuntu 24.04.4、Ubuntu 22.04.5和RHEL 10.1上列出了RX 9070 XT、RX 9060 XT、RX 7900 XTX、RX 7900 XT、RX 7900 GRE、RX 7800 XT和Radeon AI PRO R9700。
2. 也查看Ollama的列表。 Ollama文档为Linux ROCm补充了RX 6800 XT、6900 XT及其他RX 6000系列,并列出Ryzen AI Max+ 395。未列出的显卡可在Linux上尝试`HSA_OVERRIDE_GFX_VERSION`;Windows不支持该变量。
3. 安装ROCm v7软件栈。 使用AMD的`amdgpu-install`工具(Linux)。Ollama在Linux上要求ROCm v7。
4. 验证识别情况。 运行`rocminfo`:你的GPU应作为agent出现(例如RX 7900 XTX为gfx1100,RX 9070 XT为gfx1201)。
5. 在Windows上, Ollama的ROCm列表涵盖RX 7000系列。包括RX 9070系列在内的其他显卡不在该列表中,请使用Vulkan后端。
ROCm的最新版本是7.14.0(2026年7月16日),它将ROCm迁移到模块化构建系统TheRock。核对时AMD的Radeon兼容性页面涵盖到7.2.1,因此请对照你要安装的版本所对应的支持表。
哪些本地LLM工具支持AMD显卡?
Ollama: 上述显卡在Linux上使用ROCm v7;在Windows上,RX 7000系列通过ROCm运行。Vulkan在安装其后端后默认启用,可用`OLLAMA_VULKAN=0`关闭。当前版本为v0.40.10(2026年10月23日),包含Linux ROCm构建。
llama.cpp: 可用HIP(ROCm)或Vulkan(`-DGGML_VULKAN=1`)为AMD编译。两个后端可以一起编译,并用`--device`按设备选择。大多数前端都基于它。
LM Studio: 通过llama.cpp运行时(Vulkan和ROCm)支持AMD显卡。当ROCm运行时识别不到显卡时,Vulkan是常用的后备方案。(本页早先版本称LM Studio仅支持NVIDIA,这是错误的。)
vLLM: 提供ROCm构建(ROCm 7.14.0版本列出了vLLM 0.23.0)。它面向服务部署和批处理;依赖它之前,请查阅vLLM文档确认你的GPU目标。
经验法则: 图省事用Ollama或LM Studio,要精细控制用llama.cpp,多用户服务用vLLM。

如何在AMD GPU硬件上运行量化LLM推理?
- 1按显存选择模型大小。 Q4_K_M文件每十亿参数约占0.6 GB(14B约9 GB,32B约20 GB;均为估算)。为上下文缓存预留2–4 GB。
- 2选择后端。 Vulkan上手最快(只需图形驱动)。在受支持的Linux环境中,ROCm(HIP)是更好的路径。
- 3安装运行时。 走ROCm路径时,先在Linux上用`amdgpu-install`安装ROCm v7,再安装Ollama(`curl -fsSL https://ollama.com/install.sh | sh`)或LM Studio。
- 4运行量化模型。 例如`ollama run qwen3:14b`,或用llama.cpp执行`llama-server -m model.gguf -ngl 99`,把所有层卸载到GPU。
- 5确认正在使用GPU。 `ollama ps`应显示100% GPU;`rocm-smi`可查看占用的显存。如果显示CPU,请重新检查ROCm安装或改用Vulkan。
本地LLM什么时候该选AMD而不是NVIDIA?
在以下情况选AMD:
- 想用更少的钱在单卡上获得32 GB:Radeon AI PRO R9700的价格约为RTX 5090的三分之一到一半。
- 已经有受支持的Radeon,或者想要一张游戏表现也好的显卡。
- 使用Linux或接受Vulkan,且你的工具(Ollama、llama.cpp、LM Studio)已支持AMD。
在以下情况选NVIDIA:
- 需要仅支持CUDA的工具、训练或微调软件栈,或最快的提示词处理。
- 在比较二手24 GB显卡:二手RTX 3090的价格与二手RX 7900 XTX相近,所以CUDA支持可能成为决定因素。
- 希望把配置时间降到最低。
📍 简单一句话
想要比NVIDIA最新显卡更便宜的24–32 GB显存时选AMD;如果依赖仅支持CUDA的工具,或不想花时间配置,就跳过。
💬 简单来说
缺的是显存,并且Linux上的ROCm或Vulkan路径适合你时,AMD很划算。如果你刚接触本地LLM、希望直接可用,请先从NVIDIA开始。
AMD Instinct还是NVIDIA数据中心GPU:哪个更适合LLM?
AMD Instinct(MI300X、MI350X)与NVIDIA的数据中心GPU竞争,面向服务器而非桌面采购。 Ollama的ROCm列表包含Instinct显卡,ROCm也是围绕它们构建的,因此支持范围比消费级Radeon更广。
MI300X每个加速器配备192 GB HBM3内存(AMD规格),适合在单台机器中运行超大模型。对于单人使用的机器,相关的AMD选择是Radeon RX或Radeon AI PRO。
服务器和云端决策请参阅企业GPU服务器选购指南和云GPU租用对比。
采用AMD时最常见的错误有哪些?
- 以为24 GB能跑70B模型:70B模型在Q4下需要约40 GB或更多,单张24 GB显卡最多约30–35B。70B请规划两张卡,或一对32 GB的R9700。
- 买了ROCm不支持的显卡:购买前先查AMD的支持表和Ollama的列表。RX 6000系列不在AMD当前Radeon支持表中。
- 跳过Vulkan:ROCm识别不到显卡时,先试Vulkan后端,再判断这块GPU是否无法使用。
- 轻信挂牌价:2026年GPU和内存价格波动明显。请比较实际成交价,而不是挂牌价。
下一步
- 本地LLM最佳预算GPU — 预算有限?LLM推理性价比最高的GPU →
- GPU vs CPU vs Apple Silicon — AMD、Apple还是CPU,哪个平台适合你的工作流? →
- 我需要多少显存? — 让GPU显存与模型大小相匹配 →
各地区的数据法规如何影响AMD与NVIDIA的选择?
改变数据保护义务的不是GPU厂商,而是推理是否在本地运行。 在本机进行推理可让提示词和文档留在自己的硬件上,从而可能降低在中国《数据安全法》和《个人信息保护法》(PIPL)、欧盟GDPR以及日本APPI下的跨境传输风险。企业部署仍需具备合法依据、留存规则和泄露应对流程;金融、医疗、法律等受监管数据请进行正式合规审查。亚太地区各市场的数据跨境规则不尽相同,部署前请逐一核实。
出口管制规则可能在部分市场限制AMD和NVIDIA的高端加速器。进口或购买前,请查看你所在国家的现行规定。
常见问题
AMD显卡适合运行本地LLM吗?
适合,但有前提。RX 7900 XTX(24 GB)和Radeon AI PRO R9700(32 GB)等AMD显卡可在Ollama、LM Studio和llama.cpp中通过ROCm或Vulkan运行量化LLM。NVIDIA CUDA的软件支持仍更广、提示词处理更快,所以AMD更适合看重每美元显存的情况。
AI和本地LLM最好的AMD显卡是哪款?
综合最佳是RX 7900 XTX:24 GB显存、960 GB/s带宽,并被AMD的ROCm 7.2.1支持表和Ollama支持。要更大的单卡显存可选32 GB的Radeon AI PRO R9700;7B–14B模型用RX 9070 XT(16 GB)就够了。
本地LLM选AMD还是NVIDIA?
想要CUDA兼容性和最少配置就买NVIDIA。想要更高的每美元显存就买AMD,尤其是32 GB的R9700对比RTX 5090。二手RX 7900 XTX与二手RTX 3090价格相近,这时取决于软件支持。
Ollama能用AMD显卡吗?
能。Ollama在Linux上要求ROCm v7驱动,并列出RX 9070 XT、RX 7900 XTX、RX 6800 XT、Radeon AI PRO R9700等。在Windows上其ROCm列表涵盖RX 7000系列,安装其后端后Vulkan默认启用。
LM Studio支持AMD显卡吗?
支持。LM Studio通过llama.cpp运行时(Vulkan或ROCm)运行AMD显卡。如果ROCm运行时识别不到显卡,请把运行时切换为Vulkan。本页早先版本曾错误地称LM Studio仅支持NVIDIA。
如何在AMD GPU硬件上运行量化LLM推理?
选一个能放进显存的量化模型(Q4_K_M每十亿参数约0.6 GB),安装Ollama或LM Studio,使用Vulkan或ROCm。在Linux上用amdgpu-install安装ROCm v7,运行模型,再用ollama ps或rocm-smi确认GPU在使用。
本地LLM选RX 9070 XT还是RX 7900 XTX?
本地LLM更推荐RX 7900 XTX:24 GB在Q4下可容纳约30–35B的模型,而RX 9070 XT的16 GB上限约为14B–24B。RX 9070 XT更新也更便宜,如果16 GB够用就选它。
$500以内最好的AMD显卡是什么?
二手约$380–410的RX 6800 XT(16 GB)是$500以内性价比最高的AMD显卡。它可运行Q4–Q8的7B–14B模型,但不在AMD当前Radeon的ROCm支持表中,需走Ollama的Linux ROCm路径或Vulkan。
Radeon AI PRO R9700值得买来做本地AI吗?
如果你需要单卡32 GB,值得。它的官方定价为$1,299,而RTX 5090约为$3,700–4,300,不过据报道实际售价更高,提示词处理也更慢。两张R9700合计64 GB,可运行Q4的70B模型。
AMD ROCm需要Linux吗?Windows能用吗?
Linux是支持更好的ROCm路径:AMD的支持表列出了Ubuntu 24.04.4、Ubuntu 22.04.5和RHEL 10.1。在Windows上,Ollama的ROCm列表涵盖RX 7000系列,其他显卡使用Vulkan后端。
跑LLM,AMD Instinct和NVIDIA GPU哪个更好?
Instinct(MI300X、MI350X)与NVIDIA的数据中心GPU竞争,面向服务器采购;MI300X配备192 GB HBM3。对单台桌面机而言,相关的AMD选择是Radeon或Radeon AI PRO,而NVIDIA的CUDA生态仍然更广。
深度学习和机器学习最好的AMD显卡是哪款?
做推理时,RX 7900 XTX(24 GB)和Radeon AI PRO R9700(32 GB)是最好的AMD选择。ROCm提供PyTorch构建(ROCm 7.14.0版本列出了PyTorch 2.12.0)。对于默认依赖CUDA的训练和研究代码,NVIDIA的生态仍然更广,购买前请确认你的框架对AMD的支持。
Ryzen AI Max+ 395迷你主机比独立AMD显卡更好吗?
取决于模型大小。Ryzen AI Max+ 395系统最高提供128 GB统一内存,但带宽只有256 GB/s,适合大型混合专家模型;而对于能放进显存的模型,独立显卡生成token更快。
来源
- Ollama GPU文档:AMD ROCm v7要求、受支持的Radeon、Radeon AI PRO、Radeon PRO、Ryzen AI和Instinct显卡、Vulkan后端
- Ollama发布页:v0.40.10,2026年10月23日
- Radeon与Ryzen上的AMD ROCm — Linux兼容性:ROCm 7.2.1支持的Radeon GPU和发行版
- ROCm发布页:ROCm 7.14.0,2026年7月16日,框架版本
- llama.cpp构建文档:HIP和Vulkan后端
- AMD产品规格:RX 7900 XTX、RX 9070 XT、Radeon AI PRO R9700
- 价格快照(美国,2026年9–10月):公开的GPU价格追踪站和第三方评测;均为挂牌价,变化很快
- AMD显卡能提供很高的每秒token速度,但速度本身并不决定回答质量。你向模型提出什么问题,与它响应得多快同样重要:上下文窗口详解介绍了如何在GPU显存限制内组织较长的请求。