RTX 3060 12GB能运行什么?
据我们评估,RTX 3060 12GB是本地LLM中最均衡的二手预算GPU(显存、速度与价格)(基于下列价格与估算)。 12GB VRAM适配所有7B模型的Q4/Q5和大多数13B模型的Q4。关于不同模型大小的VRAM要求详情,见VRAM需求指南 →。以下是您可以期待的确切模型和速度:
📍 简单一句话
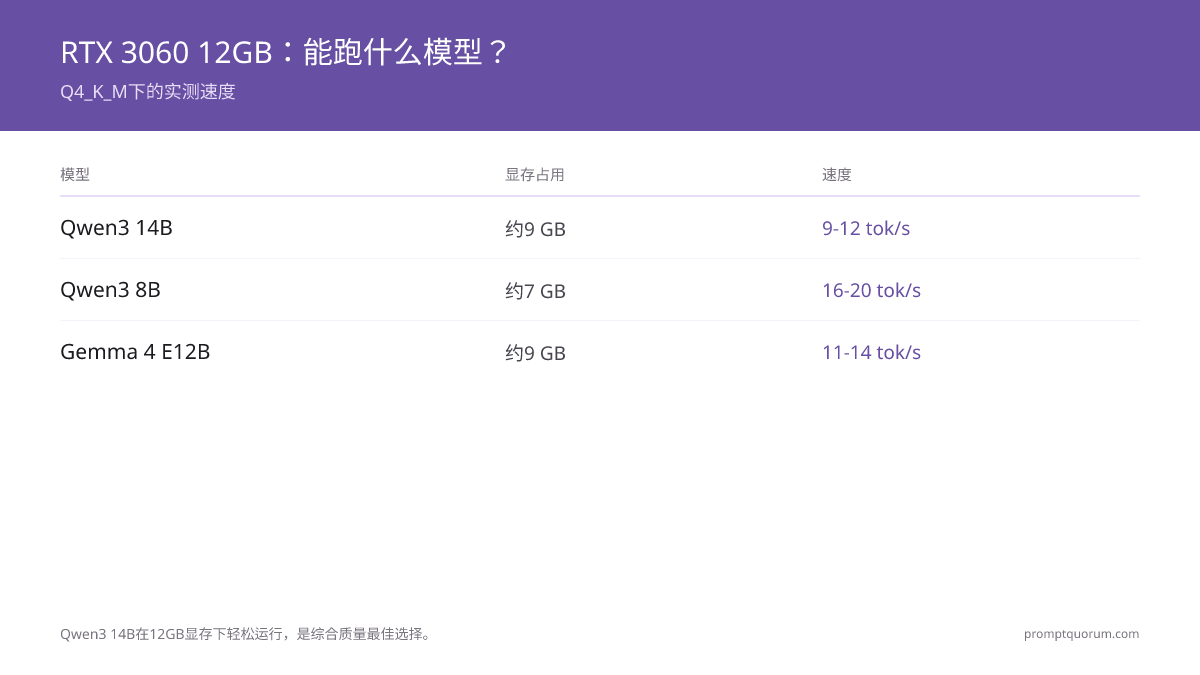
RTX 3060 12GB以Q4运行Qwen3 14B(9GB,约9–12令牌/秒)、Qwen3 8B(5.5GB,约16–20令牌/秒),并能轻松运行所有7B模型。
💬 简单来说
RTX 3060 12GB拥有12GB显存——足以运行参数量约140亿以内的AI模型。更大的模型无法装入,运行速度会很慢。
模型 | 大小 | 量化 | VRAM占用 | 速度 | 最适合 |
|---|---|---|---|---|---|
| Qwen3 14B | 14B(密集) | Q4_K_M | ~9 GB | 9–12令牌/秒 | 能装入的最佳综合品质 |
| Qwen3 8B | 8B | Q4_K_M | ~7 GB | 16–20令牌/秒 | 编程、全能 |
| Gemma 4 E12B | 26B MoE | Q4_K_M | ~9 GB | 11–14令牌/秒 | 视觉、多模态 |
| Mistral 7B | 7B | Q4_K_M | ~7 GB | 18令牌/秒 | 指令遵循 |
| DeepSeek-R1 7B | 7B | Q4_K_M | ~7 GB | 10–12令牌/秒 | 推理、数学 |
| Gemma 4 E4B | E4B(多模态) | Q4_K_M | ~5 GB | 18–22令牌/秒 | 轻量视觉、快速聊天 |
Qwen3 14B(密集)是在Q4_K_M下能舒适装入RTX 3060 12GB的最高品质模型,占用~9 GB。`ollama pull qwen3:14b`。注:Llama 4 Scout(17B激活/109B总计的MoE,10M令牌上下文,多模态)在Q4下需要~55GB,通常无法装入12GB——它是面向大VRAM平台的长上下文/大型多模态选择,而非预算GPU推荐。gpt-oss:20b(21B总计/3.6B激活MoE)需要16GB,因此在12GB显卡上刚好够不着。所有速度在Ollama、RTX 3060 12GB、16GB系统RAM、Ryzen 7 7700X上测量。Q4_K_M量化。速度±15%浮动。

RTX 3060 6GB能运行什么?
6GB版本严重受限。 仅3B模型可舒适运行。7B模型Q4需要~7GB——超出可用容量。
- Phi-4 Mini 3.8B(Q4): ~3GB VRAM,20–25令牌/秒。此尺寸最佳推理。
- Llama 3.2 3B(Q4): ~2.5GB VRAM,25–35令牌/秒。最快选项。
- Gemma 2 2B(Q4): ~1.7GB VRAM,35–45令牌/秒。最轻量模型。
- 7B卸载: 可行但慢。Llama 7B CPU卸载 = ~5–8令牌/秒。
- 建议: 如果您有6GB显卡,升级到12GB二手($290–330)更值得。
RTX 3060 vs 其他预算GPU
GPU | VRAM | 价格(二手) | 7B速度 | 最大模型 | 评价 |
|---|---|---|---|---|---|
| RTX 3060 12GB ★ | 12 GB | $290–330 | 15–20令牌/秒 | 13B(Q4) | 最佳二手预算选择 |
| RTX 5060 Ti 16GB | 16 GB | 全新约$800 | 25–30令牌/秒 | 20B(Q4) | 最佳全新预算选择 |
| RTX 4060 Ti 8GB | 8 GB | 二手约$270(全新约$300–425,仅限仍有库存) | 20–25令牌/秒 | 7B(Q5最大) | 更快但VRAM少 |
| RTX A4000 | 16 GB | $790–850 | 12–15令牌/秒 | 13B(Q5) | 已不属预算级 |
| RTX 4070 Super | 12 GB | 全新$550–700(仅限仍有库存) | 25–30令牌/秒 | 13B(Q5) | 估计更快但2倍价格 |
| RX 6700 XT | 12 GB | $175–315 | 10–14令牌/秒 | 13B(Q4) | 12GB最便宜,AMD麻烦 |
RTX 3060 12GB二手性价比最高:$290–330的12GB VRAM运行所有7B和大多数13B。若购买全新显卡,RTX 5060 Ti 16GB(约$800)是显存更充裕的新一代选择。价格为美国挂牌价的大致参考(价格追踪网站与eBay挂牌),截至最近一次更新(见“最后更新”),并非保证成交价,会因国家和时间而异。RTX 40系列已停产,新卡库存因零售商而异。RTX 3060以外显卡的7B速度为粗略估计,并非PromptQuorum实测。

7B模型需要多少VRAM?
7B模型在Q4(4位)量化时需要6-8GB VRAM;Q5(5位)需要8-10GB;Q8(8位)需要14-16GB。
实际上:8GB是最低限度,在Q4的7B模型上舒适推理,有批处理空间。
6GB显卡(RTX 2060)在技术上可行但需要积极优化,无法支持更高的批大小。
GPU成本是经济性的一面;token成本是另一面。本地推理消除了按token计费的API费用,但提示词长度仍然影响延迟和吞吐量。完整的成本图景——token、定价层级和优化策略——请参阅token、成本与限制:AI提示词经济学。
RTX 3060按用途选最佳模型
根据实际需求选择模型,而非参数量:
预算硬件只能运行较小的模型——但熟练的提示词技巧可以弥补质量差距。Prompt工程指南涵盖了思维链和结构化输出等技术,帮助小模型超越其规模发挥。一个正好落在 RTX 3060 12 GB 档位的具体工作负载是自动化的 PR 评审——把 Qwen3 8B 直接针对 PR 跑起来的 GitHub Actions 方案,请参阅CI/CD 中的本地 LLM 代码评审。
- 聊天 / 问答: `ollama run qwen3:14b` — 密集14B,~9GB VRAM,12GB上最佳品质。轻量选项:`ollama run qwen3:8b`(~7GB)。
- 编程: `ollama run qwen3:8b` — 强大的全能编程。~7GB VRAM。16–20令牌/秒。
- 推理 / 数学: `ollama run deepseek-r1:7b` — 思维链推理。10–12令牌/秒。
- 写作 / 创意: `ollama run mistral:7b` — 最佳指令遵循。18令牌/秒。
- 视觉 / 图像: `ollama run gemma4:e12b` — 多模态。11–14令牌/秒。~9GB VRAM。更轻量可选 `ollama run gemma4:e4b`(~5GB)。
- 隐私 / 离线: 以上所有。推理默认在本地运行,除非您添加的工具将其发送出去,否则提示词会留在您的电脑上。模型下载后无需联网;请检查运行环境的更新与遥测设置。
- 智能家居 / 常驻AI: `ollama run phi4-mini` — Phi-4 Mini(3.8B,~3 GB VRAM)可在无独显的迷你PC上处理Home Assistant语音查询。参阅本地智能家居AI最佳硬件 →。
二手 vs 全新:在哪买?
- 二手(比新卡便宜150-300美元):eBay、Facebook Marketplace、Craigslist、本地计算机维修店。坏显卡或VRAM故障风险更高。承诺前始终测试。
- 全新(300-700美元,仅限仍有库存):Newegg、Amazon、Best Buy、Microcenter。包含保修。价格并不稳定:2026年新卡街头价格上涨,部分型号会阶段性缺货。适合规避风险的购买者。
- 矿卡(加密、超便宜):极端风险。VRAM退化常见。只有在能在现场完全压力测试时才购买。
常见预算GPU错误
- 购买4GB RTX 2060并期望顺利的7B推理----您会不断遇到内存不足错误。
- 将300美元的GPU与30美元PSU(电源)配对----电压降会导致稳定性问题。预算80+ Gold认证、650W最小。
- 假设DDR5 RAM和i9 CPU会加快LLM推理----它们不会。GPU VRAM带宽是影响推理速度的唯一瓶颈。
下一步
- 本地LLM最佳AMD GPU — 考虑AMD?AMD vs NVIDIA完整对比 →
- 最佳开源Ollama模型 — 哪些模型在预算GPU上表现最佳 →
- 我需要多少VRAM? — 根据模型大小选择合适的GPU →
常见问题
RTX 3060 12GB在2026年还值得买吗?
是的。它已有4年多历史,但12GB显存从不过时。Q4下可流畅运行Qwen3 14B、Qwen3 8B、Gemma 4 E12B和Ministral 3 8B。它适配所有7B-8B模型和大多数密集13B-14B模型。
本地LLM应该买RTX 5060 Ti还是RTX 4060 Ti?
RTX 5060 Ti 16GB(约$800)目前是更好的选择:比8GB的RTX 4060 Ti多8GB显存,按我们的估算快约10-15%。它是全新显卡中当代的预算之选。如果预算有限,8GB的RTX 4060 Ti运行7B模型仍然可靠,全新约$300–425(仅限仍有库存)或二手约$270。如果打算运行13B以上模型,避免入门级4060/5060(8GB)和4070(12GB)——显存余量不足。
我可以用AMD RX 7900 XT或RX 7900 XTX代替吗?
可以,但AMD的驱动支持弱于NVIDIA + CUDA。HIP/ROCm的配置需要更多精力。对初学者而言,RTX/CUDA的配置通常更简单。
12GB显存够用于13B模型吗?
勉强够,仅限Q4量化。Q5或Q8会导致OOM错误。如果想舒适运行13B,建议选择16GB。
我应该买二手企业级GPU比如RTX A4000吗?
现在不建议了。RTX A4000在二手价$180-230时确实是预算好货,但2026年的存储器短缺已将其推高到二手$790-850——约为RTX 3060 12GB的三倍价格,却只多4GB显存且推理更慢。RTX A2000 12GB($440-615)同理。请改买二手RTX 3060 12GB或全新RTX 5060 Ti 16GB。
搭配$300 GPU应该配多大功率的电源?
650W,80+ Gold认证起步。$300 GPU + CPU + 主板功耗不超过400W,但需要为瞬时峰值留出余量。
我能用$300预算GPU运行Ollama吗?
能。Ollama很轻量。4年前的RTX 3060配合Ollama可以9–12令牌/秒运行Qwen3 14B,或16–20令牌/秒运行Qwen3 8B——完全可用于交互式聊天和编程辅助。
我能在RTX 3060 12GB上运行Llama 4 Scout吗?
通常不能。Llama 4 Scout是17B激活/109B总计的MoE,Q4下需要约55GB显存——远超12GB显卡的能力。即使24GB显存也只能以极端的1.78位量化(约20令牌/秒)勉强装入。在RTX 3060 12GB上,请改为运行密集模型:`ollama pull qwen3:14b`(能装入的最佳品质)、Qwen3 8B或Gemma 4 E12B。Scout是面向48GB以上设备的长上下文(1000万令牌)/大型多模态选择。
$200以内最佳的预算GPU是什么?
$200以内目前只剩8GB显卡——实际上是二手RTX 2080 8GB($110-195),只能以Q4运行7B模型,更大的无法运行。过去低于$200的12GB选项在2026年存储器短缺期间都已涨过这条线:RX 6700 XT 12GB二手约$175–315,RTX A2000 12GB约$440-615。如果预算能到约$300,RX 6700 XT是在低价端(多为拍卖)淘到时最便宜的靠谱12GB显卡;按常见挂牌价$290–330,二手RTX 3060 12GB更值得买。
购买前如何测试二手GPU的显存缺陷?
运行显存压力测试:gpu-burn(Linux)、HWiNFO64内存压力测试(Windows),或在Ollama中加载大模型观察是否出现OOM错误。趁还能退货时先测试。
以后能升级GPU来运行更大的模型吗?
能,桌面PC升级GPU很简单。先从RTX 3060 12GB开始,以后再升级到RTX 4090或5090。PCIe插槽在各代之间向后兼容。
本地LLM推理最佳的预算NVIDIA GPU是什么?
7B模型选RTX 4060 Ti(8GB,仍有库存时全新约$300-425),13B模型选RTX 4070 Super(12GB,仍有库存时全新约$550-700)。二手方面:RTX 3060 12GB($290–330)能以Q4流畅运行7-13B模型。据我们评估,性价比最高的是二手RTX 3060 12GB;全新显卡中RTX 5060 Ti 16GB(约$800)是我们的推荐。
AMD 6800XT在AI推理上与RTX 4070相比如何?
AMD RX 6800 XT(16GB)在显存和游戏性能上超过RTX 4070(12GB),但LLM推理速度可能落后(差距取决于模型、后端和配置)。llama.cpp的ROCm驱动配置也比CUDA更复杂。纯LLM工作选RTX 4070更省心;游戏+LLM则6800 XT性价比更高。
2026年本地LLM每GB显存性价比最高的GPU是什么?
二手RTX 3090(24GB,约$850-1,050)= 每GB约$35-44。二手RTX 3060(12GB,约$290–330)= 每GB约$24–28。RTX 4070 Ti(12GB,全新约$600)= 每GB约$50。最佳性价比:若可接受ROCm配置则为RX 6700 XT,否则为二手RTX 3060 12GB。每美元容量最大:二手RTX 3090 24GB。价格与性能平衡:全新RTX 4070。
本地LLM可以用AMD RX 6700或6800 XT代替NVIDIA吗?
可以,但AMD在ONNX Runtime上的ROCm驱动支持弱于NVIDIA CUDA。预计配置会更麻烦。预算型配置中,NVIDIA/CUDA通常更省事。
相关阅读
- 本地LLM需要多少VRAM
- 消费硬件上的70B模型
- RTX 5090对RTX 4090
- 本地LLM二手GPU
- 本地LLM的最佳GPU
- How Much VRAM Do You Need?
- Mac Mini M5作为本地AI服务器
- Apple Silicon M5本地LLM — M5 Pro/Max完整指南:基准测试、Mac配置、内存层级,以及购买哪款Mac进行本地推理。
- 本地LLM的Apple Silicon对比NVIDIA GPU
- Apple Silicon 2026最佳模型
- 如需日本GPU价格、秋叶原零售商及Mercari、Yahoo拍卖二手市场选项,请参阅<a href="/zh/prompt-bites/best-gpu-local-llm-japan-price" class="text-primary hover:underline">日本本地LLM性价比最高GPU指南</a>。
- 如需阿联酋及海湾地区GPU价格,包括Sharaf DG、noon.com、Amazon.ae等零售商及二手市场dubizzle,请参阅<a href="/zh/prompt-bites/best-gpu-local-llm-uae-price" class="text-primary hover:underline">阿联酋本地LLM性价比最高GPU指南</a>。
来源
- TechPowerUp GPU数据库:RTX 3060 / RTX 4060 Ti / RTX 4070 Super规格和功耗
- NVIDIA CUDA能力矩阵:推理工作负载的GPU内存带宽和理论吞吐量
- Ollama模型要求:Llama 3.1 8B、Ministral 3 8B和Qwen量子化级别的VRAM建议