关键要点
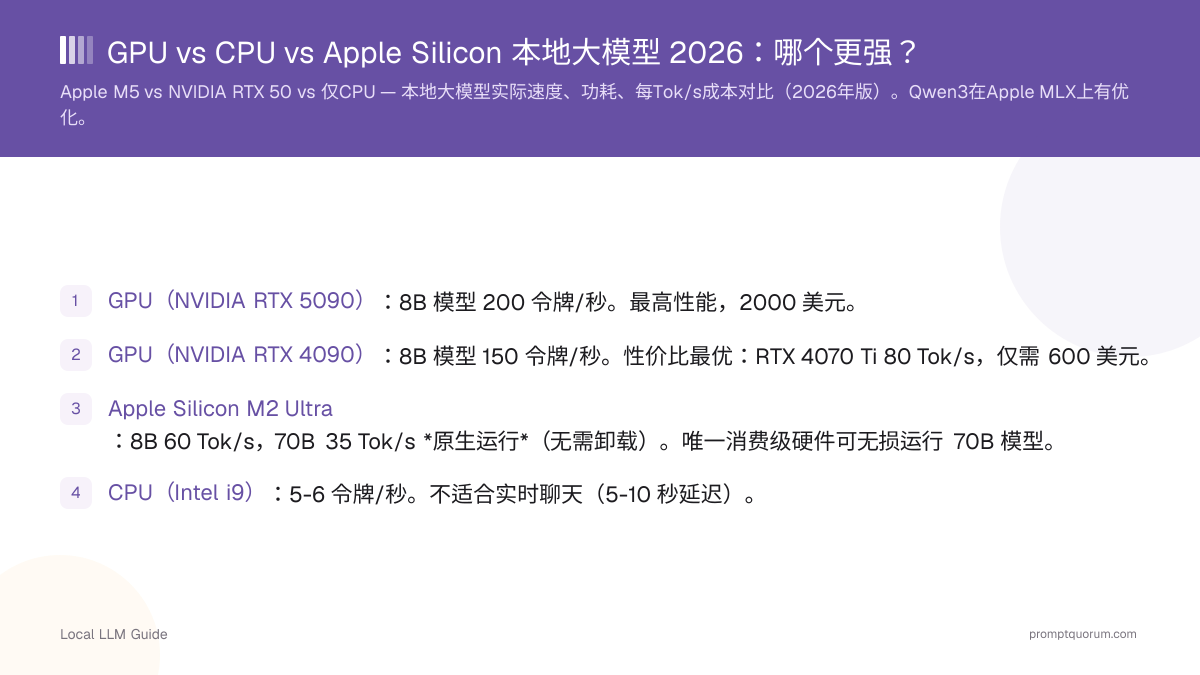
- Apple M5 Pro(64GB,约2,399美元):适合大多数用户的最佳全能之选。30B模型达40–60 tok/s,功耗低(推理时约25W),无VRAM上限。
- NVIDIA RTX 5090(32GB,2,000美元):7B–14B模型最快,达150–200 tok/s。不支持CPU offloading下加载30B以上模型。适合生产工作负载。
- NVIDIA RTX 5070(12GB,约600美元):性价比最高的GPU。8B模型达60–80 tok/s。仅限7B–8B全精度。
- Apple M5 Max(64–128GB,约3,199美元起):460–614 GB/s带宽。原生运行30B–70B。适合研究人员和重度30B+用户。
- 仅CPU(现代Ryzen/Intel):搭配高速DDR5内存,7B模型达10–20 tok/s。偶尔使用可行,不适合实时聊天。
- 结论:对大多数用户而言,64GB的Apple M5 Pro是赢家——比任何单块GPU支持更大的模型,成本低于GPU建机,功耗低10倍。仅在7B–14B需要最高速度或生产工作负载时才选择RTX 50系列。
📍 简单一句话
本地LLM:Apple M5 Pro 64GB(约$2,399)综合最佳,30B模型达40–60 tok/s;RTX 5090 32GB(约$2,000)7B–14B最快(150–200 tok/s)但不支持30B以上;RTX 5070 12GB(约$600)性价比最高GPU;仅CPU:7B约10–20 tok/s。
💬 简单来说
GPU在小模型(14B以下)上最快,因为拥有高计算带宽。Apple Silicon集成内存和计算,低功耗下适合大模型(30B+)。仅CPU是最慢的,但任何笔记本电脑都能运行。
性能对比:速度、带宽与成本
*需要CPU offloading——速度大幅下降,低位宽下质量明显下降
硬件 | Qwen3 8B | Qwen3 30B | 功耗 | 成本 |
|---|---|---|---|---|
| RTX 5090(GPU、32GB GDDR7) | 150–200 tok/s | 不可能* | 约450W | 2,000 美元 |
| RTX 5080(GPU、16GB GDDR7) | 100–130 tok/s | 不可能* | 约360W | 1,000 美元 |
| RTX 5070 Ti(GPU、16GB) | 80–100 tok/s | 不可能* | 约300W | 750 美元 |
| RTX 5070(GPU、12GB) | 60–80 tok/s | 不可能* | 约250W | 600 美元 |
| MacBook Pro M5 Pro(36–64GB,307 GB/s) | 40–60 tok/s | 20–30 tok/s | 约25W | 2,399 美元起 |
| MacBook Pro M5 Max(64–128GB,460–614 GB/s) | 60–80 tok/s | 35–50 tok/s | 约35W | 3,199 美元起 |
| Mac mini M5 base(16–32GB,200 GB/s) | 25–35 tok/s | 需卸载* | 约15W | 599 美元起 |
| Intel Core Ultra 9 / AMD Ryzen 9(CPU、DDR5) | 10–20 tok/s | 3–5 tok/s | 约65W | 已包含 |

何时选择GPU(RTX 50系列)
当你需要7B–14B模型的最高速度,或运行7×24小时生产工作负载时,选择RTX 50系列的NVIDIA GPU。
- RTX 5090(32GB GDDR7,1,792 GB/s):8B模型达150–200 tok/s。2,000美元。最适合生产管线、微调和速度敏感型应用。
- RTX 5080(16GB GDDR7):8B达100–130 tok/s。1,000美元。8B–13B速度与成本的良好平衡。
- RTX 5070 Ti / 5070(12–16GB):8B达60–100 tok/s。600–750美元。单用户聊天和编码的最佳性价比。
- CUDA生态优势:vLLM、llama.cpp、LM Studio均已原生优化。原生精度下推理最快。
- 硬性限制:没有一款RTX 50系列显卡能以全精度加载30B模型(需要20GB以上VRAM)。卸载到系统内存会造成5–10倍的速度损失。
功耗是关键权衡:RTX 5090满载450W,而M5 Pro仅25W。按0.35美元/千瓦时计算,每天使用8小时,RTX 5090每月多花约55美元电费。
何时选择Apple Silicon(M5)
当你需要运行14B–70B模型、看重能效,或以macOS为主要操作系统时,选择Apple Silicon M5。
- M5 base(16–32GB,200 GB/s):原生运行7B–8B达25–35 tok/s。599美元起(Mac mini)。良好的入门选择。
- M5 Pro(36–64GB,307 GB/s):原生运行至多30B达20–30 tok/s。约2,399美元(MacBook Pro)。最佳全能性价比。
- M5 Max(64–128GB,460–614 GB/s):原生运行30B–70B达35–50 tok/s。约3,199美元起。适合研究人员和重度70B工作负载。
- 统一内存优势:无VRAM上限。64GB的M5 Pro可原生加载30B模型;128GB的M5 Max可原生加载70B模型。
- 苹果官方数据:M5世代的LLM推理速度比M4快4倍。
- MLX框架:苹果的MLX专为Apple Silicon优化。Qwen3系列模型在MLX上运行出色。DeepSeek-R1 14B表现良好。
权衡:7B场景下无法匹敌RTX 5090的原始速度。微调更慢。没有CUDA专属工具。
何时仅CPU就够用
如果只需要偶尔的响应,并运行小模型(7B Q4),纯CPU推理是可行的。
- 搭配DDR5-5600的现代Intel Core Ultra 9 / AMD Ryzen 9:Qwen3 8B或Llama 3.2 8B达10–20 tok/s。可用于非交互式批处理任务。
- 较旧CPU / DDR4:5–8 tok/s。明显的延迟(每次响应5–8秒)使交互式聊天体验不佳。
- 零额外硬件成本:如果已有一台性能不错的台式机,llama.cpp或Ollama可立即使用。
- 功耗:CPU满载推理时功耗为65–125W——低于GPU,高于Apple Silicon。
CPU推理适用于:批量文档摘要、夜间处理、偶尔的问答。避免将仅CPU用于实时聊天、编码助手或大于8B的模型。
内存带宽:真正的瓶颈
大模型推理受内存限制,而非计算限制。 令牌生成速度取决于从内存加载模型权重的速度。内存带宽越高=令牌生成越快。
公式:推理速度 ≈ 内存带宽 ÷ 内存中的模型权重
- RTX 5090的1,792 GB/s是2026年可用的最快单卡带宽。
- M5 Max的460–614 GB/s可媲美甚至超越RTX 5080的带宽——而统一内存有128GB,对比VRAM仅16GB。
- M5 Pro的307 GB/s是甜蜜点:足够支撑30B模型的带宽,成本仅为M5 Max的一半。
- 89 GB/s的CPU DDR5比RTX 5090慢20倍,但比DDR4快4倍——对CPU推理是有意义的提升。
- 统一内存优势:无CPU↔GPU传输开销。M5 Pro可将整个30B模型保留在其64GB内存池中。
平台 | 内存带宽 | 实际速度(8B) |
|---|---|---|
| RTX 5090(GDDR7) | 1,792 GB/s | 150–200 tok/s |
| RTX 5080(GDDR7) | 960 GB/s | 100–130 tok/s |
| RTX 5070(GDDR7) | 672 GB/s | 60–80 tok/s |
| M5 Max(统一,128GB) | 460–614 GB/s | 60–80 tok/s |
| M5 Pro(统一,64GB) | 307 GB/s | 40–60 tok/s |
| M5 base(统一,32GB) | 200 GB/s | 25–35 tok/s |
| DDR5-5600 RAM(仅CPU) | 89 GB/s | 10–20 tok/s |
| DDR4-3200 RAM(仅CPU) | 51 GB/s | 5–8 tok/s |
每Tok/s成本:真实价值分析
每Tok/s成本比较硬件价值:初始成本除以持续的令牌速度。
RTX 5070在纯速度上的每Tok/s成本最优。 M5 Pro在能耗上更胜一筹:按0.15美元/千瓦时、每天使用8小时计算,M5 Pro每月约1.10美元,而RTX 5090约16.50美元。
如果你已经拥有搭载M5 Pro的Mac,硬件部分的每Tok/s成本实际上为0美元。
硬件 | 初始成本 | Tok/s(8B) | 每Tok/s成本 | 功耗(推理) |
|---|---|---|---|---|
| RTX 5090(32GB) | 2,000 美元 | 175 | 11.4 美元 | 450W |
| RTX 5070(12GB) | 600 美元 | 70 | 8.6 美元 | 250W |
| M5 Pro MacBook Pro(64GB) | 2,399 美元 | 50 | 48 美元 | 25W |
| M5 Max MacBook Pro(128GB) | 3,199 美元 | 70 | 46 美元 | 35W |
| CPU(现代DDR5台式机) | 已包含 | 15 | 0 美元 | 65W |
平台选择指南
基于模型大小、预算和使用场景的决策框架:
- 选择RTX 5090 / 5080:7B–14B最高速度、生产管线、微调、7×24小时服务器工作负载。
- 选择RTX 5070 / 5070 Ti:7B–13B单用户聊天和编码的最佳性价比GPU。600–750美元。
- 选择M5 Pro(64GB):适合大多数用户的最佳全能之选。原生运行30B,低功耗,macOS工作流。约2,399美元。
- 选择M5 Max(128GB):研究用途、原生运行70B模型、Apple Silicon最高性能。约3,199美元起。
- 仅CPU:零额外投资,偶尔使用7B,夜间批处理。
硬件选择常见误区
- 1"为30B以上模型选择GPU"——错误。没有RTX 50系列显卡能将30B载入VRAM。卸载到内存会造成5–10倍的速度损失。应改用M5 Pro或M5 Max。
- 2"以为M5 base(16GB)够用"——错误。它只能加载7B。14B模型需要32GB;30B需要64GB(M5 Pro)。
- 3"忽视常开GPU服务器的电费"——RTX 5090每天用8小时,按0.15美元/千瓦时计算,每年约花费200美元电费。M5 Pro约14美元/年。
- 4"为8B聊天购买RTX 5090"——600美元的RTX 5070在8B上可达70 tok/s——以30%的成本获得80%的速度。
- 5"期望CPU能胜任实时聊天"——即使20 tok/s也感觉很慢。DDR4上的5–8 tok/s对交互式使用而言完全不实用。
常见问题
本地大模型选GPU还是CPU更好?
实时推理中NVIDIA GPU更快:RTX 5070运行8B模型达60–80 tok/s,而搭配DDR5的现代CPU仅10–20 tok/s。Apple M5 Pro达40–60 tok/s,同样超越CPU,并额外具备原生运行30B模型的能力。
Apple Silicon能运行本地大模型吗?
可以。Apple M5系列根据芯片等级不同,运行7B模型可达25–80 tok/s。M5 Pro(64GB)原生运行30B模型达20–30 tok/s——这是任何消费级GPU都无法比拟的。M5 Max(128GB)原生运行70B模型达35–50 tok/s。
本地大模型最低需要多少GPU VRAM?
12GB VRAM(RTX 5070)可流畅运行采用Q4–Q8量化的7B–8B模型。16GB(RTX 5080)可处理13B模型。没有单块消费级GPU能完整加载30B——此时应改用64GB的Apple M5 Pro。
GPU比CPU快多少倍?
RTX 5090在8B模型上比搭配DDR5的现代CPU快8–15倍(175 tok/s对比15 tok/s)。差距来自内存带宽:1,792 GB/s(GDDR7)对比89 GB/s(DDR5)。307 GB/s的Apple M5 Pro介于两者之间,达40–60 tok/s。
仅为本地大模型购买GPU值得吗?
3年摊销后,RTX 5070(600美元)对于每天使用2小时以上的重度用户而言,成本低于OpenAI API费用。70 tok/s足以支撑实时聊天和编码辅助。如果需要30B以上的模型,尽管初始成本更高,M5 Pro性价比更高。
什么是内存带宽,为什么对大模型很重要?
大模型推理受内存限制。令牌速度≈内存带宽÷模型权重。RTX 5090:1,792 GB/s。M5 Max:460–614 GB/s。M5 Pro:307 GB/s。CPU DDR5:89 GB/s。这就是为什么拥有统一内存的Apple Silicon能在原始带宽低于顶级GPU的情况下,依然高效运行大模型。
2026年本地大模型最好的Apple Silicon芯片是什么?
M5 Pro(64GB,307 GB/s)是大多数用户的最佳全能之选——约2,399美元即可原生运行30B模型达20–30 tok/s。M5 Max(128GB,460–614 GB/s)用于70B模型,达35–50 tok/s(约3,199美元起)。超出7B的任何场景都应避免使用M5 base(16GB)。
Apple Silicon能运行30B和70B模型吗?
M5 Pro(64GB)原生运行30B模型达20–30 tok/s。M5 Max(128GB)原生运行70B模型达35–50 tok/s。这些是无需CPU offloading的真实吞吐量数据——没有消费级GPU能在30B以上模型上与之匹敌。
花2,000美元买RTX 5090值得吗?
仅当你的工作流需要7B–14B模型的最高速度,或运行生产推理管线时才值得。对大多数人而言,RTX 5070(600美元)能以30%的成本提供80%的速度。对30B以上模型而言,无论预算多少,M5 Pro都是更好的选择。
GPU和Apple Silicon的功耗对比如何?
RTX 5090在推理负载下功耗约450W。M5 Pro约25W。按每天8小时、0.15美元/千瓦时计算,相当于每年200美元(RTX 5090)对比14美元(M5 Pro)。对家庭用户及支付商业电价的用户而言,M5 Pro的能效带来了显著的成本优势。
Intel MacBook Pro(i9、16GB内存)的LLM推理速度如何?
比Apple Silicon慢,也比现代DDR5台式机慢。Intel MacBook Pro没有面向llama.cpp的统一内存GPU路径——推理仅在CPU上通过DDR4运行,其双通道带宽约为38–45 GB/s,而现代DDR5台式机CPU可达89 GB/s。按照上文的"内存带宽÷模型大小"公式计算,一个量化后的7B模型(Q4下约4.5 GB)理论速度约为8–10 tok/s,考虑到CPU计算开销后,实际速度约为4–7 tok/s。总共16GB的内存也将你限制在Q4下约7B–8B的模型规模,还要为操作系统预留空间——不要指望在没有严重内存交换和显著速度损失的情况下运行13B以上的模型。
pp tok/s和tg tok/s有什么区别?
pp tok/s(提示词处理)衡量模型摄取你输入提示词的速度——即"预填充"阶段,该阶段受计算能力限制,在GPU等并行硬件上扩展性良好。tg tok/s(token生成)衡量模型生成每个新输出token的速度——即"解码"阶段,该阶段受内存带宽限制(参见上文的带宽公式)。GPU通常在pp和tg之间表现出较大差距(预填充快,但生成受带宽限制);Apple Silicon的统一内存则使这两个数值更接近。比较基准测试时,务必确认你看到的是哪一个数值——同一硬件上pp和tg可能相差5到20倍。
- NVIDIA GPU 规格——RTX 50 系列 GPU 规格、VRAM、内存带宽 www.nvidia.com/en-us/geforce/
- Apple Metal 机器学习——统一内存优化 developer.apple.com/metal/
- vLLM 张量并行化文档——多 GPU 推理 docs.vllm.ai/
- llama.cpp GitHub——开源推理引擎 github.com/ggerganov/llama.cpp