TL;DR
- 16GB:仅7B模型(勉强)
- 36GB:13B轻松,34B Q4勉强
- 64GB:34B Q5轻松
- 128GB:70B Q5轻松
- 购买后无法升级——购买时选择最大配置
关键要点
- 统一内存 = CPU和GPU共享——全部可用于LLM模型。
- RTX 4070有12GB VRAM + 32GB RAM(独立)。Mac有统一内存 = 全部可用。
- 64GB Mac在macOS开销(4–8GB)后,有约56–60GB可用于LLM。
- 存在交换:macOS在模型超出空闲内存时使用SSD。可以运行但速度慢5–10倍。
- 模型大小(GB)随量化方式不同:Llama 3.1 8B为16GB FP16、5GB Q4、8.5GB Q8。
- 原则:购买最大内存——购买后无法升级。销售时内存费用占5–10%;之后更换整台Mac要花100%的钱。
📍 简单一句话
Apple Silicon本地LLM内存需求:16 GB仅支持7B(偏紧),36 GB轻松支持13B,64 GB支持70B Q3(偏紧)或34B Q5(轻松),128 GB轻松支持70B Q5——购买时选最大内存,因为后续无法升级。
💬 简单来说
Mac的统一内存在CPU、GPU和AI引擎间共享。经验法则:7B模型Q4约需5 GB;14B约需9 GB;70B Q4约需42 GB。再加8 GB给操作系统。如果模型装不下,会交换到磁盘,速度慢100倍。
统一内存如何为LLM服务
统一内存在CPU和GPU之间共享——全部可供模型使用。与独立GPU(RTX 4070有12GB VRAM + 32GB RAM分开)不同,Apple Silicon共享一个内存池。64GB Mac = 模型可用64GB。macOS和应用程序使用4–8GB,留给LLM约56–60GB。
统一内存和VRAM是一回事吗?
是的——在Apple Silicon上,统一内存实际上就是GPU的VRAM。不存在像独立显卡那样固定、分离的VRAM池。M系列芯片的CPU、GPU和神经网络引擎读写的是同一块物理内存,因此统一内存池的几乎全部——而不仅仅是一部分——都可供GPU用于运行LLM。
- 独立显卡(RTX 4070):即使PC拥有64GB独立的系统内存,12GB的VRAM也是模型权重的固定上限。
- Apple Silicon:GPU可以访问除macOS开销(4–8GB)之外的整个统一内存池——64GB的Mac能给GPU提供约56–60GB,而不是固定的12–24GB VRAM份额。
- 这就是为什么64GB的Mac能轻松运行34B模型,而配备12GB显卡的64GB PC却不能——PC上GPU可用的内存受限于显卡VRAM,而非总内存。
- "共享内存"和"统一内存"描述的是同一种架构:一个内存池,CPU和GPU都能寻址,无需手动分配VRAM。
主表:内存层级与模型大小
Model | Parameters | Q3_K | Q4_K_M | Q5_K_M | Q8 | FP16 |
|---|---|---|---|---|---|---|
| Phi-4 | 3.8B | 2.1 GB | 2.5 GB | 2.9 GB | 4.0 GB | 7.6 GB |
| Mistral Small | 7B | 3.8 GB | 4.5 GB | 5.2 GB | 7.5 GB | 14 GB |
| Llama 3.1 8B | 8B | 4.2 GB | 5.0 GB | 5.8 GB | 8.5 GB | 16 GB |
| Gemma 3 12B | 12B | 6.5 GB | 7.8 GB | 9.0 GB | 12.9 GB | 24 GB |
| Qwen3 34B | 34B | 17 GB | 20 GB | 24 GB | 36 GB | 68 GB |
| Llama 3.3 70B | 70B | 36 GB | 42 GB | 49 GB | 74 GB | 140 GB |
| Llama 3.3 405B | 405B | 200+ GB | 240 GB | 280 GB | 410 GB | 810 GB |
计算在您的Mac上是否适合时,需额外加上4–8GB的macOS开销。
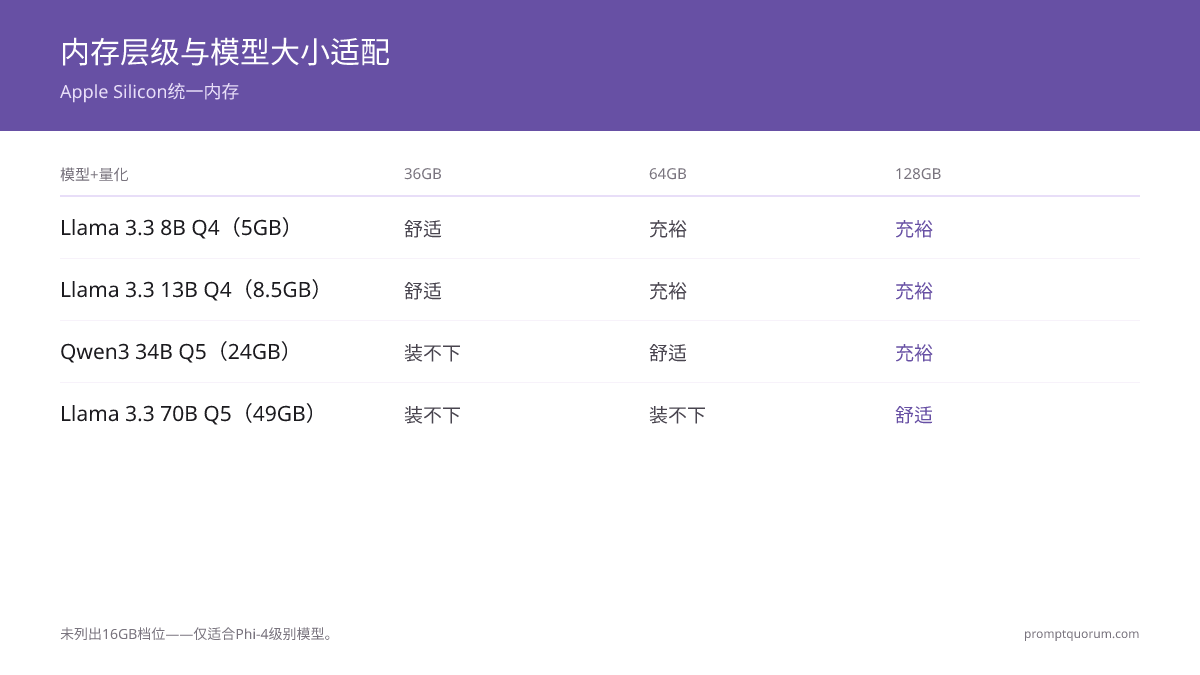
兼容性矩阵
模型 + 量化 | 16GB | 36GB | 64GB | 128GB |
|---|---|---|---|---|
| Phi-4 Q4 (2.5 GB) | ✓ 充裕 | ✓ 充裕 | ✓ 充裕 | ✓ 充裕 |
| Llama 3.1 8B Q4 (5 GB) | ⚠️ 勉强 | ✓ 舒适 | ✓ 充裕 | ✓ 充裕 |
| Llama 3.1 8B Q8 (8.5 GB) | ✗ 不适合 | ✓ 舒适 | ✓ 充裕 | ✓ 充裕 |
| Gemma 3 12B Q4 (7.8 GB) | ✗ 不适合 | ✓ 舒适 | ✓ 充裕 | ✓ 充裕 |
| Qwen3 34B Q4 (20 GB) | ✗ 不适合 | ⚠️ 勉强 | ✓ 舒适 | ✓ 充裕 |
| Qwen3 34B Q5 (24 GB) | ✗ 不适合 | ✗ 不适合 | ✓ 舒适 | ✓ 充裕 |
| Llama 3.3 70B Q3 (36 GB) | ✗ 不适合 | ✗ 不适合 | ⚠️ 勉强 | ✓ 舒适 |
| Llama 3.3 70B Q4 (42 GB) | ✗ 不适合 | ✗ 不适合 | ⚠️ 非常勉强 | ✓ 舒适 |
| Llama 3.3 70B Q5 (49 GB) | ✗ 不适合 | ✗ 不适合 | ✗ 不适合 | ✓ 舒适 |
| Llama 3.3 70B Q8 (74 GB) | ✗ 不适合 | ✗ 不适合 | ✗ 不适合 | ✓ 可以 |
✓ 充裕 = 空余4GB以上 | ✓ 舒适 = 空余2–4GB | ⚠️ 勉强 = 空余不足2GB | ✗ 不适合 = 使用交换分区或崩溃

各内存层级实际可运行的模型
- 116 GB(M5基础款、MacBook Air)
Why it matters: Llama 3.1 8B Q4可以装入(5GB模型 + 8GB系统 = 13GB)✓ 但很勉强。Llama 8B Q8不用交换分区装不下。Whisper small可以同时运行。 - 236 GB(M5 Pro入门款)
Why it matters: Llama 3.1 8B Q8轻松装入。Llama 13B Q4装入。Qwen3 34B Q4勉强装入(20GB + 8GB系统 = 28GB)。多模型:Whisper + LLaVA + TTS可同时运行 ✓ - 364 GB(M5 Pro高配)
Why it matters: Qwen3 34B Q5轻松装入(24GB)。Llama 70B Q3勉强装入。多模型堆栈有充足空间。 - 4128 GB(M5 Max)
Why it matters: 128GB最佳模型:Llama 3.3 70B Q5(49GB)——能轻松装入的最大主流模型。70B Q8也能装入(74GB),质量几乎无损。多模态:Whisper + 90B视觉模型 + 8B LLM可同时运行 ✓
多模型堆栈内存需求
堆栈用例 | 所需内存 |
|---|---|
| 仅LLM(Llama 8B Q4) | 5 GB + 系统 = 13 GB |
| LLM + STT(Llama 8B + Whisper large-v3) | 8 GB + 系统 = 16 GB |
| LLM + STT + TTS(语音助手) | 9 GB + 系统 = 17 GB |
| LLM + 视觉(Llama 8B + LLaVA 7B) | 11 GB + 系统 = 19 GB |
| 完整多模态(LLM + 视觉 + STT + TTS) | 14 GB + 系统 = 22 GB |
| LLM + RAG(Llama 8B + 嵌入向量 + ChromaDB) | 8 GB + 系统 = 16 GB |
| 重型多模态(Llama 70B Q4 + Vision 90B) | 100 GB以上 |
超过22GB的堆栈需要最低36GB的Mac。超过50GB的堆栈需要最低64GB的Mac。重型多模态堆栈只能在128GB M5 Max上运行。
上下文窗口会产生额外内存开销
KV缓存随上下文长度缩放——上下文窗口越长,模型在运行时使用的内存越多。这是一个常见的坑,可能会把本来勉强的配置推入交换分区。
- Llama 3.1 8B(8K上下文):+0.5 GB
- Llama 3.1 8B(32K上下文):+2 GB
- Llama 3.1 8B(128K上下文):+8 GB
- Llama 3.3 70B(32K上下文):+6 GB
- Llama 3.3 70B(128K上下文):+24 GB
为什么要购买最大内存
- Apple Silicon内存购买后无法升级。
- 模型规模持续增长:今天8B → 2027年主流13–34B。
- 16GB对LLM已经偏低——最低推荐36GB。
- 价格差:36GB→64GB购买时多花约1,400元,省去2年后模型超过36GB时买新Mac的费用。
- M5 Pro 36GB现在约8,000元;64GB约10,000元。2年后同款M5 Pro 64GB配置:12,000元以上。
- 获得36GB以上统一内存最省钱的方式:基础款M5 Pro Mac mini(约8,000元,36GB)是能轻松运行13B模型的最便宜Mac——比同等内存的Mac Studio或MacBook Pro都便宜。
- Apple于2026年8月25日更新了Mac mini和Mac Studio产品线,新增了超出本指南128GB上限的档位:Mac mini M6(最高32GB,约6,500元)、Mac mini M5 Pro(最高64GB,约12,200元)、Mac Studio M5 Max(最高128GB,约18,000元),以及Mac Studio M5 Ultra(256GB或512GB,起价约39,600元)。512GB配置将于2026年10月下旬上市,价格远超72,000元。对于本指南覆盖的模型规模(最高70B)而言,64–128GB仍是实用范围——256GB以上仅在运行超过70B的模型或同时运行多个大模型时才有意义。

量化对质量的影响
Q4_K_M(4位):相比FP16约1–2%质量损失。大多数用途察觉不到。最佳默认选择。
Q5_K_M(5位):约0.5–1%质量损失。可忽略不计。有多余内存时推荐使用。
Q8(8位):约0.1%质量损失。本质上无损。
Q3_K(3位):3–5%质量损失。在复杂推理上明显。仅在空间严格受限时可接受。
应该选36GB还是64GB?
预算允许就选64GB(多花约1,400元)。36GB今天可用,但随着模型增长12个月后会显得紧张。64GB在2027–2028年前都够用。
内存以后可以升级吗?
不能。Apple Silicon内存是焊接的,无法升级。购买时选择最大配置。
为什么16GB不够用?
LLM用16GB + macOS用4–8GB = 可用8–12GB。Llama 8B Q4需要5GB,没有空间留给Whisper或其他任务。太紧张了。
我真的需要128GB吗?
只有在经常运行70B模型或需要同时运行视觉 + LLM + STT时才需要。否则64GB完全足够。
48GB对本地LLM够用吗?
够用——48GB(M4 Pro和部分M5 Pro配置提供)是舒适的中间选择。可以运行所有34B模型、极限情况下的70B Q3以及完整的多模态堆栈。比36GB好;如果能负担64GB,未来的适用性值得考虑。
在本地运行Llama 3.3 70B需要多少内存?
最低48GB(Q3量化,质量损失明显)。推荐64GB(Q4量化,空间紧张)。舒适选择128GB(Q5/Q8量化,高质量)。64GB需要仔细管理内存;128GB是运行70B唯一无忧的选择。
2026年本地AI需要128GB吗?
只有在经常运行70B模型或需要同时运行视觉 + LLM + STT堆栈时才需要。日常LLM使用(8B–34B模型、RAG、代码辅助),M5 Pro 64GB是最佳选择。除非特别需要70B,128GB是2–3倍的价格跳升,收益有限。
Apple Silicon的统一内存和VRAM是一回事吗?
是的。与拥有固定、独立VRAM的独立显卡(例如RTX 4070的12GB)不同,Apple Silicon的GPU读写的是与CPU相同的物理内存。GPU几乎可以访问Mac统一内存的全部——64GB的Mac在扣除macOS开销后能给GPU约56–60GB,而不是固定的VRAM份额。
128GB统一内存能装下的最大LLM是什么?
采用Q5_K_M量化的Llama 3.3 70B(49GB)是能轻松装入的最大主流模型,留有约70GB空间给上下文和开销。Q8量化(74GB)也能装入并为macOS留出余量。即使是Q4量化,405B模型也需要240GB以上——超出任何单台Mac的统一内存,因此70B是单机的实际上限。
除了内存,本地LLM还需要多少存储空间?
内存(RAM)和磁盘存储是两回事:内存在运行时容纳模型;存储永久保存下载的模型文件。Q4量化的8B模型需要约5GB的内存和磁盘空间。70B Q5模型需要约49GB内存和约49GB磁盘空间——是同一个文件。在本地运行多个模型(例如8B、34B、70B,加上一个视觉模型)需要100–150GB的可用磁盘空间,与Mac的内存配置无关。
Mac能配置超过128GB的统一内存吗?
可以。2026年8月25日的更新新增了Mac Studio M5 Ultra,提供256GB和512GB统一内存配置,起价约39,600元。512GB档位将于2026年10月下旬上市,价格远超72,000元。这远超运行70B级模型所需的水平——本指南中16GB到128GB的档位已覆盖几乎所有本地LLM使用场景的实用范围。256GB以上只有在运行超过70B的模型或同时运行多个大模型时才有意义。目前M5 Ultra还没有独立的基准测试数据。
M5 Max上的本地LLM符合中国数据安全法规吗?
符合。所有数据在设备本地处理,不传输至境外服务器,满足《数据安全法》(2021)和《个人信息保护法》的数据不出境要求。对于处理敏感数据的国内企业,本地推理是最合规的AI部署方案,避免了数据跨境传输的合规风险。
国内企业选什么内存配置最划算?
个人开发者:M5 Pro 36GB(约7,200元)适合13B模型日常使用。团队日常使用34B模型:M5 Pro 64GB(约8,600元)。需要70B或多模态工作流的团队:M5 Max 128GB(约27,000元)。与GPT-5.5 API费用(每用户每月350–1,400元)相比,升级内存成本在3–12个月内即可收回。