显存计算公式
显存 = 十亿参数 × 每参数字节数 + KV缓存 + 开销
每参数字节数(Q4与真实GGUF文件一致,其余为计算估算):Q4约0.6字节,Q5约0.7字节,Q8约1.05字节。
示例:Llama-3.3 70B Q4 = 70 × 0.6 = 42 GB(真实的Llama-3.3-70B Q4_K_M GGUF为42.52 GB)
Q4: 根据真实GGUF文件大小推算约0.6字节/参数,而非理论上的0.5字节——Q4_K_M等真实格式带有少量开销。
Q8: 根据真实GGUF文件大小推算约1.05字节/参数,几乎完全精度。
按模型大小的显存
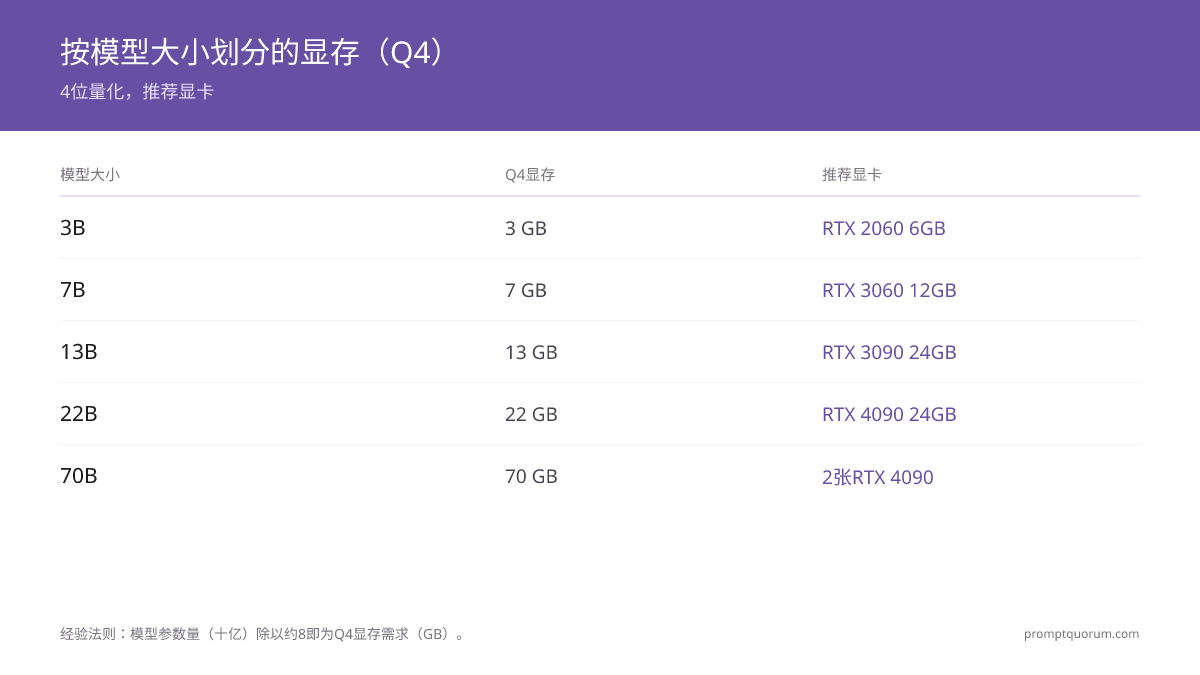
模型大小 | FP32 | Q8 | Q5 | Q4 | 推荐GPU |
|---|---|---|---|---|---|
| 7B | 28 GB | 7 GB | 5 GB | 4 GB | RTX 4060 (8GB)、RTX 3060 (12GB) |
| 13B | 52 GB | 14 GB | 9 GB | 8 GB | RTX 3060 (12GB)、RTX 4070 (12GB) |
| 70B | 280 GB | 74 GB | 50 GB | 42 GB | 双RTX 4090 |
| Qwen 3.6 35B-A3B (3B活跃 / 35B总参数, MoE)* | ~140 GB | ~37 GB | ~25 GB | ~21 GB | RTX 5090 32 GB,或 RTX 4090/3090 24 GB(较紧张,Q4) |
| DeepSeek-V4.1-Flash-1017 (763B总参数, MoE)* | ~3.1 TB | ~800 GB | ~530 GB | ~460 GB | 多GPU服务器,或 512 GB 统一内存(仅Q4) |
| Llama 4 Scout (17B活跃 / 109B总参数, MoE)† | 436 GB | 114 GB | 76 GB | 55 GB | 2× RTX 4090 (48 GB) — 仅在1.78位时才能装入24 GB(仅供参考,非PromptQuorum实测) |
| gpt-oss:20b (3.6B活跃 / 21B总参数, MoE)* | 84 GB | 22 GB | 15 GB | 12 GB | RTX 5070 12 GB 或任意 16 GB GPU |
| Kimi K2.6 (32B活跃 / 1T总参数, MoE)* | ~4 TB | ~1 TB | ~700 GB | ~600 GB | 多GPU服务器(Q4约600 GB) |
数字为纯权重大小;Q4数字与三个真实GGUF文件大小一致,其他量化级别和MoE行为计算估算值(如Llama-2-7B Q4_K_M = 4.08 GB、Mistral-Small-24B Q4_K_M = 14.33 GB、Llama-3.3-70B Q4_K_M = 42.52 GB)——请为上下文/KV缓存额外预留1-2 GB。* MoE行: 按总参数计算(Q4约每十亿0.6 GB):全部专家常驻内存,活跃参数只影响速度。数值为近似值。† Llama 4 Scout 需将全部109B参数常驻显存,因此尽管每个token仅17B活跃,Q4仍需~55 GB。 来源: Llama-2-7B GGUF, Mistral-Small-24B GGUF, Llama-3.3-70B GGUF.

量子化
量子化将权重压缩至低精度。Q4为消费级GPU标准。
VRAM决定模型大小,但提示词设计决定输出质量。思维链和少样本提示等技术可以缩小大小模型之间的质量差距。探索完整的Prompt工程工具箱,从你的硬件所支持的模型中获取更多。如果你有 12–16 GB 显存,并希望找一个具体的编码任务来检验这套工具箱,用本地 LLM 替代 GitHub Copilot正好把 Continue.dev + Ollama + Qwen3-Coder 的方案对应到这些显存档位上。

批大小
单用户推理总是batch=1。批处理仅有助吞吐量。
显存开销
KV缓存、激活、运行时开销占额外5 GB。
地区背景
中国 (CAC): 本地LLM推理用于数据主权。Qwen3 32B Q4(约20 GB)可在单张RTX 4090上运行,是常见选择。以上不构成法律建议。
常见错误
显存 ≠ 模型大小。总需要5 GB以上余地。
显存计算器
选择你的模型大小和量子化方式以估计显存需求。
热门模型
基础模型
6.50 GB
上下文开销
1.50 GB
批量开销
0.00 GB
系统开销
1.00 GB
最低VRAM
9.00 GB
推荐(含25%安全余量)
11.25 GB
👉 请选择至少具备以下VRAM的GPU: 11.25 GB VRAM
兼容GPU
RTX 3060 (12 GB)
0.8 GB余量
RTX 4060 Ti (16 GB)
4.8 GB余量
RTX 4070 Ti Super (16 GB)
4.8 GB余量
RTX 4080 Super (16 GB)
4.8 GB余量
RTX 4090 (24 GB)
12.8 GB余量
RTX 5090 (32 GB)
20.8 GB余量
Mac Mini M6 (32 GB) (−8 GB macOS = 24 GB)
12.8 GB余量
Mac Mini M5 Pro (64 GB) (−8 GB macOS = 56 GB)
44.8 GB余量
Mac Studio M5 Max (128 GB) (−8 GB macOS = 120 GB)
108.8 GB余量
Mac Studio M5 Ultra (96 GB+) (−8 GB macOS = 88 GB)
76.8 GB余量
💡 实用技巧:
- 购买GPU时始终参考"含安全余量"的数值
- Q4以减少25%大小获得90-95%质量,有余量时Q5更佳
- 上下文开销随对话长度增加,典型使用请预留1-3 GB
- 批量大小对多用户API很重要,单用户聊天可忽略批量开销
📋 分享此配置:
RTX 4060足以运行7B Q4吗?
足够。7B在Q4下权重约4 GB,RTX 4060的8 GB绰绰有余。
70B模型需要24 GB吗?
不够。仅权重在Q4下就约需42 GB。
我可以在6GB GPU上运行Mistral Small吗?
不行。Mistral Small是22-24B模型,即使在Q4下仅权重就约需13-14GB显存。6GB或8GB的GPU会出现OOM错误。建议预留16GB以获得舒适余量,或在6-8GB显卡上改用7B-8B模型。
微调7B模型需要多少显存?
LoRA: 12-16GB。全微调: 28GB以上。微调需要优化器状态(模型显存的2-4倍),而不仅仅是推理。
12GB足以运行13B模型吗?
完全足够。13B模型在Q4下仅需约8GB,因此12GB留有真正的余量。在Q5(约9GB)下依然舒适,在Q8(约14GB)下会比较紧张。
增加批大小会减少单次推理的显存吗?
不会。单次推理始终使用batch=1显存。批大小只有助于吞吐量(多用户场景)。
精度最好的量化方式是什么?
Q8通常几乎无损;Q5和Q4的质量损失略大,具体取决于模型和任务。对大多数人来说,Q4是最好的折中。
我可以将部分显存卸载到CPU RAM吗?
可以,把部分层卸载到系统内存。Llama.cpp和Ollama都支持。性能可能明显下降(视卸载的层数而定,常见为30-50%甚至更多)。
运行本地LLM的最小显存是多少?
3B Q4需要4GB显存。实用最小值是8GB显存+ 7B Q4。低于6GB的话,大多数7B模型会导致内存溢出。
Apple Silicon显存与GPU显存的工作方式相同吗?
Apple Silicon使用统一内存。统一内存只有一部分可用作GPU显存,macOS会保留一部分。MacBook Pro M3 18GB可以运行13B模型 Q4(~7GB) + 开销。
7B模型在不同量化级别需要多少显存?
7B FP32: ~28GB。7B Q8: ~7GB。7B Q5: ~5GB。7B Q4: ~5-6GB(4GB权重+ 1-2GB开销)。6GB太紧张,8GB比较舒适。
参考资源
- NVIDIA CUDA文档
- Ollama文档