关键要点
- 量化将模型权重从32位压缩到4~8位,RAM使用量减少50~75%。
- Q4_K_M是标准推荐级别----质量与RAM的最佳平衡,适用于消费级硬件。
- 7B模型示例:FP16 = 约14GB RAM、Q4_K_M = 约4.5GB、Q8_0 = 约7GB。
- Q4_K_M的MMLU基准质量损失为1~3%,与FP16相比----在大多数实际任务中难以察觉。
- GGUF是llama.cpp、Ollama和LM Studio用于存储量化模型的文件格式。
📍 简单一句话
Q4_K_M 是本地 LLM 的标准量化级别:7B 模型约占 4.5 GB,而 FP16 需要约 14 GB,在 MMLU 上的质量损失为 1–3%。
💬 简单来说
量化就是把模型内部的数字存得更粗略,从而缩小体积。Q4_K_M 是绝大多数人应该选择的级别:模型能装进普通电脑,日常使用几乎察觉不到质量差别。如果显存有富余,可以考虑 Q5_K_M 或 Q8_0。
什么是大语言模型量化及其为何重要
大型语言模型将学习到的知识存储为数十亿个数值权重。 默认情况下,这些以16位浮点数(FP16)的形式存储----每个权重两个字节。一个7B模型有70亿个权重,因此FP16文件大小约为14GB。
量化用低精度整数替换这些16位浮点数。在4位量化中,每个权重使用0.5字节而不是2字节----将内存仅对权重本身减少到约3.5GB。加上元数据开销,Q4_K_M量化的7B模型大约为4.5GB。
这对本地推理很重要,因为消费级硬件的RAM有限。不使用量化,7B模型需要16GB RAM来运行。使用Q4_K_M量化,同一模型在6GB RAM上运行,使其可在大多数现代笔记本电脑上使用。
Q4_K_M量化是什么?
Q4_K_M 是在 llama.cpp 和 Ollama 中使用的 4 位 GGUF 量化格式。"K"表示它使用 K-quants(混合精度),"M"= 中等 — 在模型大小、速度和质量损失之间取得平衡。 Q4_K_M 将大多数权重存储为 4 位,但对最敏感的层使用 6 位,与纯 4 位 Q4_0 相比,质量/大小比更优。
- Q4_K_M 为 7B 模型使用约 4.5 GB RAM — 比 FP16 少 70% — 仅有 1–3% 的质量损失
- K-quants 根据敏感度对不同权重组应用不同精度(重要权重获得更多位)
- "M"变体是标准推荐版本(较轻的"S"和较重的"L"变体也存在)
- Q4_K_M 是 6–16 GB VRAM 消费级硬件的默认选择
- 与 Ollama(`ollama run model:q4_k_m`)、LM Studio 和 llama.cpp 兼容
Q4_K_M、Q5_K_M、Q8_0等级有何区别
量化名称遵循模式:Q{bits}_{variant}。比特数是权重精度;变体影响量化的应用方式:
级别 | 位数 | RAM (7B) | 质量损失 | 使用场景 |
|---|---|---|---|---|
| Q2_K | 2 | 约2.7GB | 高 | RAM < 4GB,接受质量下降 |
| Q3_K_S | 3 | 约3.3GB | 中等 | RAM 4~5GB |
| Q4_K_M | 4 | 约4.5GB | 低 (1~3%) | 大多数用户的默认选择 |
| Q5_K_M | 5 | 约5.7GB | 最小 (<1%) | 16GB RAM,需要更高质量 |
| Q6_K | 6 | 约6.6GB | 近乎无损 | 16GB RAM,编码/数学任务 |
| Q8_0 | 8 | 约7.7GB | 可忽略不计 | 16GB+RAM,最高质量 |

交互式VRAM计算器
使用此计算器为任意模型、量化、上下文和批次大小组合计算精确的VRAM需求。选择您的配置,查看哪些GPU适配。
Popular Models
Base Model
6.50 GB
Context OH
1.50 GB
Batch OH
0.00 GB
System OH
1.00 GB
Total Minimum
9.00 GB
Recommended (with 25% safety margin)
11.25 GB
👉 Look for a GPU with at least 11.25 GB VRAM
Compatible GPUs
RTX 3060 (12 GB)
0.8 GB headroom
RTX 4060 Ti (16 GB)
4.8 GB headroom
RTX 4070 Ti Super (16 GB)
4.8 GB headroom
RTX 4080 Super (16 GB)
4.8 GB headroom
RTX 4090 (24 GB)
12.8 GB headroom
RTX 5090 (32 GB)
20.8 GB headroom
Mac Mini M6 (32 GB) (32 GB)
20.8 GB headroom
Mac Mini M5 Pro (64 GB) (64 GB)
52.8 GB headroom
Mac Studio M5 Max (128 GB) (128 GB)
116.8 GB headroom
Mac Studio M5 Ultra (96 GB+) (96 GB)
84.8 GB headroom
💡 Pro Tips:
- Always use the "with safety margin" figure when buying a GPU
- Q4 gives 90-95% quality with 25% size reduction. Q5 is better if you have room
- Context overhead grows with conversation length. Budget 1-3 GB for typical usage
- Batch size matters for multi-user APIs. Single-user chat can ignore batch overhead
📋 Share this configuration:
Q8_0量化是什么?
Q8_0是一种8位GGUF量化格式,几乎无损----相比FP16质量下降不足0.5%----而文件大小约为其一半。 每个权重以8位加一个小的逐块缩放因子存储,因此7B模型约为7.7 GB,而FP16下约为14 GB。与K-quants(Q4_K_M、Q5_K_M)不同,Q8_0对每个权重都使用统一的8位精度----它没有混合精度的"K"变体,因为8位已经几乎保留了全部信息。
- Q8_0为7B模型使用约7.7 GB RAM----比FP16少约45%----质量损失可忽略不计
- 当您拥有16 GB以上VRAM并需要最高保真度时(编码、数学、智能体),这是最佳选择
- 相比Q6_K,在通用聊天上几乎没有可测量的提升,但在质量最重要时是最稳妥的选择
- 使用 `ollama run model:q8_0` 运行,或在LM Studio中选择Q8_0 GGUF
Q4_0 vs Q4_K_M:哪种4位格式更好?
请选择Q4_K_M而非Q4_0。两者平均都是每权重4位,但Q4_K_M是一种K-quant,它将最敏感的层以6位存储,在7B模型相同的约4.5 GB占用下恢复了5~8%的质量。 Q4_0是早期llama.cpp的原始统一4位格式,如今仅为兼容旧版而存在。当Q4_K_M可用时,没有任何大小或速度上的理由去选择Q4_0。
格式 | 方法 | RAM (7B) | 质量 | 选择时机 |
|---|---|---|---|---|
| Q4_0 | 统一4位(旧版) | ~4.0 GB | 比Q4_K_M差约5~8% | 仅当Q4_K_M不可用时 |
| Q4_K_M | K-quant,混合4/6位 | ~4.5 GB | 相比FP16损失1~3% | 几乎所有人的默认选择 |
Q4_K_M 与 Q4_K_XL:标准 K-quant 和 Dynamic Upcast
Q4_K_M 是 llama.cpp 的标准 4 位 K-quant。Q4_K_XL 并非标准类型,而是 Unsloth 的「Dynamic」GGUF 变体:它保持 4 位基础,但把最敏感的层(嵌入层、注意力层和输出层)提升到更高精度。 文件大小和质量介于 Q4_K_M 与 Q5_K_M 之间——这与 Q8_K_XL 相对于 Q8_0 的做法是同一原理,只是应用在 4 位基础上。
Q4_K_XL 的具体文件大小因模型而异,也取决于 Unsloth 提升了多少层,因此下载前请查看 LM Studio 或 Hugging Face 上显示的实际大小,不要按固定数值估算。实用原则:如果 Q5_K_M 能装进你的显存,就选 Q5_K_M——它是标准格式,工具支持更广。Q4_K_XL 适用于 Q4_K_M 装得下、而 Q5_K_M 差一点装不下的情况。
格式 | 类型 | 精度 | 质量 | 适用场景 |
|---|---|---|---|---|
| Q4_K_M | llama.cpp 标准 | 4/6 位混合 | 1–3% 损失 | 绝大多数人的默认选择 |
| Q4_K_XL | Unsloth Dynamic | 4 位+敏感层更高精度 | 介于 Q4_K_M 和 Q5_K_M | Q5_K_M 差一点装不下 |
| Q5_K_M | llama.cpp 标准 | 5/6 位混合 | 低于 1% 损失 | 显存有余,使用标准工具 |
Q4_K_M vs Q4_K_S:中等与小型K-quant
Q4_K_M和Q4_K_S都是4位K-quants;区别在于有多少层保持更高精度。Q4_K_M(中等)将更多敏感层保持在6位,而Q4_K_S(小型)将更多权重压到4位,从而在7B模型上节省约0.3~0.4 GB。 在llama.cpp上的实测中,Q4_K_S在7B上使困惑度增加约+0.11,而Q4_K_M为+0.05----大约多3~5%的质量损失。仅当那几百MB决定模型能否装入VRAM时,才选择Q4_K_S。
格式 | 变体 | RAM (7B) | 质量损失 | 选择时机 |
|---|---|---|---|---|
| Q4_K_S | 小型 | ~4.1 GB | ~4~6%(小但确实存在) | 需要约0.4 GB以装入VRAM |
| Q4_K_M | 中等 | ~4.5 GB | 1~3%(均衡) | 默认----多约0.4 GB换更好质量 |
Q8_0 vs Q4_K_M:8位值得双倍VRAM吗?
对于大多数聊天和写作任务,Q4_K_M是更好的取舍----7B模型约4.5 GB,而Q8_0约7.7 GB,质量损失仅多1~3%。当您需要在编码、数学或智能体工具调用中获得最高保真度(小错误会累积)时,请选择Q8_0(需要16 GB以上VRAM)。 Q8_0相比FP16损失不足0.5%;Q4_K_M损失1~3%。这一差距在日常使用中难以察觉,但在精确数值推理上可能至关重要。
格式 | 位数 | RAM (7B) | 质量损失 | 最适合 |
|---|---|---|---|---|
| Q4_K_M | ~4 | ~4.5 GB | 1~3% | 6~16 GB VRAM,通用用途 |
| Q8_0 | 8 | ~7.7 GB | <0.5% | 16 GB以上VRAM,编码/数学/智能体 |
Q8_0 vs Q8_K_XL:标准8位与动态上采样
Q8_0是标准的llama.cpp 8位量化----每个权重8位,7B模型约7.7 GB,相比FP16损失不足0.5%。Q8_K_XL不是llama.cpp的原生类型:它是Unsloth的"Dynamic"GGUF变体,保留8位基础,但将最敏感的层(嵌入层、注意力层和输出层)上采样到16位(BF16/F16),以略大的文件大小将质量推向接近完整FP16。 Q8_K_XL面向那些想要最后零点几个百分点精度且有富余VRAM的用户。
Q8_K_XL的确切文件大小因模型而异,也取决于Unsloth上采样了多少层,因此下载前请核实工具(LM Studio或Hugging Face)中显示的大小。对于7B~8B模型,预计它会略高于Q8_0;在超大模型上差距更大。由于Q8_0对大多数用户而言已几乎无损,只有当您确实需要最高保真度且额外VRAM免费时,Q8_K_XL才值得。
格式 | 类型 | 精度 | 质量 | 选择时机 |
|---|---|---|---|---|
| Q8_0 | 标准llama.cpp | 统一8位 | 相比FP16损失<0.5% | 最高质量,标准工具链 |
| Q8_K_XL | Unsloth Dynamic GGUF | 8位 + 关键层上采样到16位 | 近乎无损(最大的8位选项) | 想要最后0.5%保真度,VRAM富余 |
GGUF格式是什么及其与量化的关系
GGUF(GPT生成统一格式)是用于本地推理存储量化LLM权重的文件格式。 由llama.cpp项目创建,取代了较旧的GGML格式。
GGUF文件包含:量化的模型权重、所有模型元数据(架构、分词器、上下文长度)和格式版本号。这种自包含设计意味着单个`.gguf`文件是运行模型所需的全部内容----无需单独的分词器文件,无需配置JSON。
截至2026年8月,GGUF是Ollama、LM Studio、Jan AI和GPT4All的标准格式。运行`ollama pull llama3.1:8b`时,Ollama内部下载GGUF文件。LM Studio显示模型文件大小时,这些就是GGUF文件大小。
量化级别是文件名的一部分:`Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf`是Llama 3.1 8B的Q4_K_M量化GGUF。

不同模型大小的量化RAM节省
模型大小 | FP16 | Q8_0 | Q4_K_M | Q3_K_S |
|---|---|---|---|---|
| 3B | 约6GB | 约3.8GB | 约2GB | 约1.6GB |
| 7B | 约14GB | 约7.7GB | 约4.5GB | 约3.3GB |
| 13B | 约26GB | 约14GB | 约8.5GB | 约6GB |
| 34B | 约68GB | 约36GB | 约22GB | 约16GB |
| 70B | 约140GB | 约70GB | 约40GB | 约30GB |

实际会损失多少质量
量化导致的质量损失通过在完全精度模型和量化版本上运行相同基准并比较分数来衡量。 截至2026年8月,既定的发现是:
量化减少了内存使用,但可能降低输出质量。设计良好的提示词可以弥补这一点:少样本示例和明确的输出约束等技术有助于量化模型保持精度。查看Prompt工程技术,了解适用于任何量化级别的方法。
- Q4_K_M对FP16:MMLU上1~3%的性能下降。在FP16上得分73%的7B模型,在Q4_K_M上得分71~72%。在实际任务中,此差异难以察觉。
- Q3_K_S对FP16:5~10%的性能下降。在复杂推理和数学任务中明显。在FP16上正确解决数学问题的模型在Q3_K_S上可能失败。
- Q2_K对FP16:15~25%的性能下降。在所有任务类型中质量损失显著。仅在RAM限制绝对时使用。
- Q8_0对FP16:性能下降不足0.5%----实际上对所有实际目的而言相同。
- K_M变体(K-Quant中等)使用混合精度方法,在相同比特数下比旧的Q4_0量化更好地保持质量。当两者都可用时,始终选择Q4_K_M而不是Q4_0。
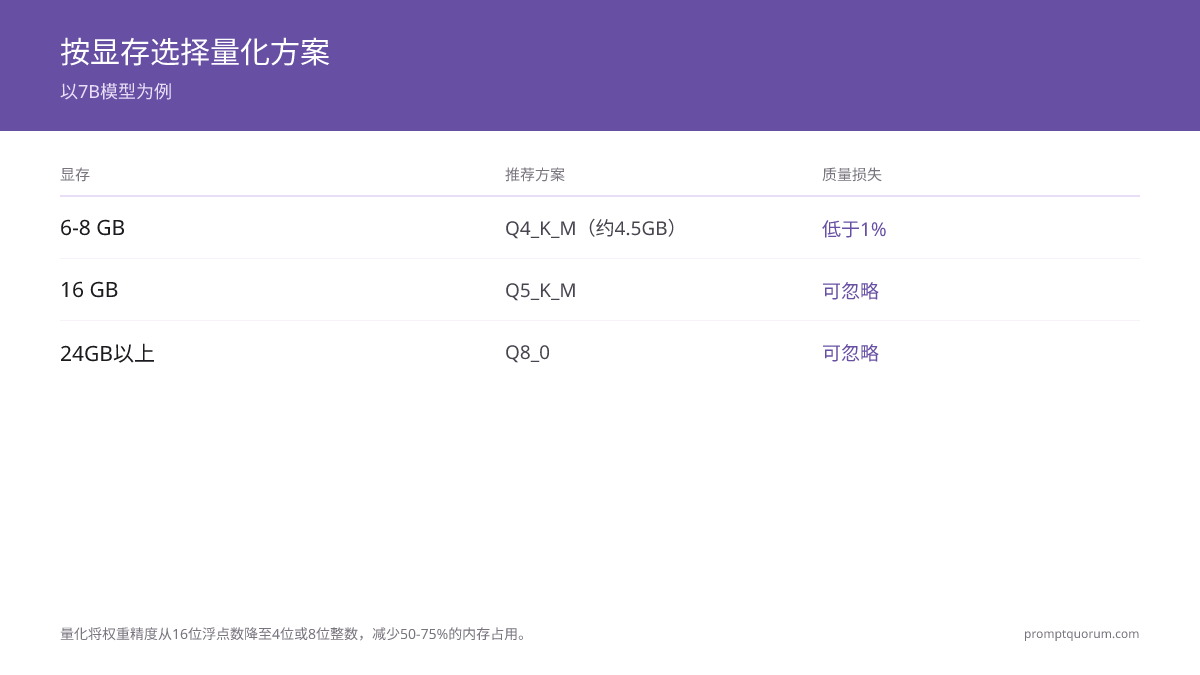
应该选择哪种量化级别
- 4~8GB RAM可用:Q4_K_M----受限硬件的最佳平衡。
- 8~16GB RAM可用:Q5_K_M或Q6_K----更好的质量和充足的RAM余量。
- 16GB+RAM可用:Q8_0----接近无损质量,没有理由使用更低的量化。
- 24GB+VRAM的GPU:Q8_0或Q6_K(适合VRAM的模型大小)。
- 批处理/夜间任务:Q4_K_M----在可用RAM上最大化吞吐量和模型大小。
- 专门用于编码或数学任务:使用Q5_K_M或更高----量化影响在精确数值和算法推理上最为明显。要查看把 Q5_K_M 的 Qwen3-Coder 与完全离线运行结合在一起的端到端隔网编码方案,请参阅无互联网的本地编码 LLM。
- 量化影响精度,温度影响随机性:温度为0.3的Q4模型比温度为1.0的全精度模型产生更确定性的输出。要独立调整这两个参数,请参阅温度和Top-p:控制AI创造力。
- 智能家居和边缘设备: Q4_K_M(VRAM 4–8 GB)是迷你PC上始终在线家庭自动化AI的最佳选择。参阅智能家居最佳本地LLM模型 →。
如何在LM Studio中选择量化
LM Studio(桌面应用)会为每个模型下载显示可用的量化变体。 搜索模型时,您会看到多个GGUF选项:Q2_K、Q3_K_S、Q4_K_M、Q5_K_M、Q6_K、Q8_0。
步骤1: 打开LM Studio → 进入"Local Models"标签。搜索模型(例如"Llama 3.1 8B")。步骤2: 每个模型都会显示可用的量化。查看文件大小以估算显存使用量。7B模型的Q4_K_M通常标为约4.5 GB。步骤3: 点击所选量化旁边的下载图标。
LM Studio的推荐默认设置:
- 如果您的GPU显存为6-8 GB(RTX 4060、RTX 3060 Ti、RTX 4060 Ti): 下载Q4_K_M变体(文件最小,质量可接受)。
- 如果您的GPU显存为12-16 GB(RTX 4070、RTX 4080): 下载Q5_K_M或Q6_K(质量更好,仍在显存范围内)。
- 如果您的GPU显存为24 GB以上(RTX 4090、RTX 5090): 下载Q8_0或FP16(最高质量,速度损失最小)。
LM Studio的"GPU offload"功能: 在聊天界面中检查"Use GPU"开关。LM Studio会自动将尽可能多的模型层移至GPU,其余部分卸载到CPU RAM。如果系统RAM充足,这样可以运行略大于GPU显存的模型(例如在拥有64 GB以上系统RAM的RTX 4090上运行Llama 3.3 70B Q4_K_M)。
卸载:将CPU RAM用作VRAM扩展
卸载将部分模型权重从GPU VRAM移至系统RAM,当模型无法完全放入VRAM时使用。 GPU继续计算最活跃的层;CPU负责其余部分。
在配备64GB系统RAM的RTX 4090(24GB VRAM)上,Llama 3.3 70B Q4_K_M(~40GB)可以通过卸载运行:~24GB在VRAM中,~16GB在系统RAM中。速度降至5-10 token/秒(而完全GPU负载下为40-50 token/秒),对许多批处理用例已足够。
ollama run llama3.3:70b
# Ollama根据可用VRAM自动管理卸载

# 使用llama.cpp进行显式GPU层卸载:
./llama-server -m llama-3.3-70b-q4_k_m.gguf --n-gpu-layers 40 --port 8080
# --n-gpu-layers控制加载到VRAM的层数
# 其余层将卸载到CPU
层分割:跨多个GPU分布模型权重
层分割将模型层分布到多个GPU,使推理可以使用超过单个GPU VRAM的模型。 两块各24GB的RTX 4090组合起来有48GB VRAM。
在两块RTX 4090上运行Llama 3.3 70B Q5_K_M(~47GB):层0-39在GPU 0上,层40-79在GPU 1上。这可提供~100 token/秒----比卸载快得多,但需要GPU之间有NVLink或PCIe-x16带宽。
# vLLM在2个GPU上的张量并行:
python -m vllm.entrypoints.openai.api_server \
  --model meta-llama/Llama-3.3-70B-Instruct \
  --tensor-parallel-size 2 \
  --port 8000

# llama.cpp显式GPU层分布:
./llama-server \
  -m llama-3.3-70b-q5_k_m.gguf \
  --n-gpu-layers 80 \
  --split-mode row \
  --main-gpu 0
KV缓存量化:降低上下文内存开销
KV缓存量化减少了推理过程中存储注意力键值对所需的内存,在处理长上下文(32K+ 令牌)时尤为重要。 虽然模型权重量化(Q4_K_M)最为常见,但KV缓存量化针对的是另一种内存瓶颈。
在推理过程中,模型为上下文中的每个令牌维护运行中的键值(KV)对。对于处理32K令牌上下文的7B模型,仅KV缓存本身根据精度不同就可能消耗8~16 GB显存。标准KV缓存使用FP16(每个值2字节);将KV缓存量化为FP8或Q8可减少50%。
如何启用KV缓存量化:
- Ollama:在兼容模型上自动启用,无需用户配置。
- LM Studio:在设置中勾选"KV cache quantization"开关(如果您的版本支持)。
- llama.cpp:启动服务器时使用 `--cache-type-k q8_0 --cache-type-v q8_0`(简写为 `-ctk q8_0 -ctv q8_0`)。把 `q8_0` 换成 `q4_0` 可以再把 KV 缓存减半。
权衡: KV缓存量化对质量影响极小(即使激进量化,下降也不足1%),因为注意力模式相比模型权重对较低精度更具鲁棒性。推荐用于在受限硬件上处理16K以上上下文的模型。
混合方法:量化 + 卸载 + 层分割组合
最强大的配置结合了三种技术。三种典型场景:
- 单RTX 4090 + 卸载:Llama 3.3 70B Q4_K_M以24GB VRAM + 16GB系统RAM运行。无需多GPU设置即可使用70B的理想选择。5-10 token/秒。
- 2× RTX 4090层分割:Llama 3.3 70B Q5_K_M完全放入VRAM(48GB合计)。无卸载减速。~100 token/秒。需要NVLink设置或足够的PCIe带宽。
- 搭载M5 Ultra的Mac Studio:96-512GB统一内存原生70B运行----无需卸载。独立的token/秒测试数据尚不存在(该芯片于2026年9月22日上市),但系统复杂度依然很低。
性能权衡:量化 vs 卸载 vs 层分割
技术 | VRAM节省 | 速度影响 | 质量影响 |
|---|---|---|---|
| 仅量化 | 最多75% | 无 | Q4_K_M损失1-3% |
| 仅卸载 | 最多60% | 高(5-10×) | 无损失 |
| 层分割 | 每GPU 50% | 低(<10%) | 无损失 |
| Q4 + 卸载 | 最多85% | 中(3-5×) | 轻微损失 |
Mac Studio M5 Ultra:无需卸载的原生70B
搭载M5 Ultra的Mac Studio(起售价$5,499,标配96GB统一内存,最高可配置512GB)以Q4原生运行Llama 3.3 70B----无需卸载,无需层分割。
苹果于2026年8月25日更新了Mac Studio产品线,推出两款芯片:M5 Max($2,499起,最高128GB统一内存,据苹果官方公布的规格,带宽最高614 GB/s)和M5 Ultra(起售价$5,499配96GB,最高512GB,据苹果官方公布的规格,带宽最高1.2 TB/s)。两者均取代了上一代M2 Ultra(最高192GB,~800 GB/s)。DDR5系统RAM卸载的带宽上限仍为~90 GB/s----这一带宽差距正是统一内存在70B级模型上优于卸载方案的原因。
M5 Max与M5 Ultra目前尚无独立的吞吐量基准测试。标准配置将于2026年9月22日上市,M5 Ultra的512GB配置则要到2026年10月下旬才会推出。PromptQuorum尚未测试过这款硬件----因此在独立测试数据出现之前,新芯片的每秒token数暂不列出。
配置 | 模型 | 速度 | 复杂度 |
|---|---|---|---|
| 1× RTX 4090 + 卸载 | Llama 3.3 70B Q4 | 5-10 token/秒 | 中 |
| 2× RTX 4090层分割 | Llama 3.3 70B Q5 | ~100 token/秒 | 高 |
| 1× RTX 5090 (32 GB) | Llama 3.3 70B Q4 | 10-12 token/秒 | 低 |
| Mac Studio M5 Ultra(96GB起) | Llama 3.3 70B Q4 | 尚未测试 | 低 |
本地LLM量化的地域背景
量化的考量因地区而异,涉及法规、主权和合规框架:
- 中国(数据安全法):中国2021年《数据安全法》要求大多数AI应用实现本地运行。量化支持在国内硬件上运行大型中文原生模型(Qwen3、百川),降低基础设施成本。Q4_K_M和Q5_K_M量化在8GB~16GB GPU上实现了符合《数据安全法》的合规部署。金融机构、医疗组织和政府部门使用量化模型来满足数据驻留要求。
- 亚太地区(跨境数据):东南亚和亚太地区各国实施严格的数据驻留框架。量化降低了部署成本,使组织能够在国内服务器上合规地运行多语言模型。新加坡、印度尼西亚和泰国的金融和医疗组织优先采用本地量化模型以避免跨境数据传输。
- 企业部署(金融/医疗/法律):银行、医院和律师事务所使用量化模型处理敏感数据。Q4_K_M和Q5_K_M量化使这些组织能够在符合GDPR、HIPAA和本地数据保护法的本地服务器上部署LLM。成本和合规性是驱动力,量化通过减少硬件投资和消除云提供商数据处理依赖来解决两者。
大语言模型量化中的常见错误
- 下载Q4_0而不是Q4_K_M----Q4_0是不具有K-Quant改进的较旧量化方法。Q4_K_M在相同RAM占用下质量好5~8%。当两者都可用时,始终选择Q4_K_M。
- 假设更高的量化始终意味着更差的质量----更高的Q数=更多位=更好的质量。Q8_0优于Q4_K_M。Q5_K_M优于Q4_K_M。Q4_K_M 70B模型在大多数任务上优于Q8_0 7B模型。
- 在加载模型前不检查RAM余量----模型大小不是唯一的RAM消费者。操作系统、浏览器和其他应用也消耗RAM。在8GB机器上,4.5GB Q4_K_M 7B模型仅为其他所有内容留下3.5GB。规则:模型文件大小 + 2GB OS开销 + 1GB余量 = 最小所需RAM。
下一步
- 我需要多少VRAM? — 将量化知识应用到你的VRAM预算 →
- 仅CPU运行LLM指南 — CPU推理的最佳量化模型 →
- Ollama上最佳开源模型 — 了解量化级别后,选择一个模型下载 →
关于大语言模型量化的常见问题
什么是 Q4_K_XL?相比 Q4_K_M 值得用吗?
Q4_K_XL 不是 llama.cpp 的标准格式,而是 Unsloth 的 Dynamic GGUF 变体。它保持 Q4_K_M 的 4 位基础,但以更高精度存储最敏感的层,因此文件大小和质量介于 Q4_K_M 与 Q5_K_M 之间。主要在 Q5_K_M 差一点装不进显存时才值得选用;如果 Q5_K_M 装得下,就选 Q5_K_M,因为它是标准格式,工具支持更广。
Q5_K_M 和 Q5_K_XL 有什么区别?
原理与 Q4、Q8 相同:Q5_K_M 是 llama.cpp 的标准 K-quant,Q5_K_XL 是 Unsloth 的 Dynamic 变体,敏感层分辨率更高,文件也相应更大。由于 Q5_K_M 的质量损失已低于 1%,实际收益很小。选择 XL 变体前,请先在工具中查看实际文件大小。
FP8 和 Q8_0 应该选哪个?
通过 llama.cpp、Ollama 或 LM Studio 在本地运行时,相关的格式是 Q8_0。FP8 主要用于当前 NVIDIA 硬件上的服务器推理,在 GGUF 生态中并不是常见的下载选项。Q8_0 相对 FP16 的质量损失已低于 0.5%,因此真正的取舍是在 Q8_0 与更小的 K-quant 之间。
Q4_0 和 Q4_1 现在还有用吗?
没有了。两者都是没有 K-quant 改进的旧格式。Q4_0 将所有权重统一量化为 4 位;Q4_1 增加了一个偏移量,但同样已被取代。在内存占用几乎相同的情况下,Q4_K_M 的质量明显更好。如果在仓库中同时看到它们,请选 Q4_K_M——Q4_0 和 Q4_1 现在只出现在较早的模型上传中。
Ollama会自动使用最佳量化吗?
是的----运行`ollama pull llama3.1:8b`时,Ollama默认下载Q4_K_M变体。要获取特定量化,请附加标签:`ollama pull llama3.1:8b-instruct-q5_K_M`。每个模型的可用量化标签列在ollama.com/library上的模型页面上。
我可以自己量化模型而不是下载预先量化的版本吗?
可以----llama.cpp包含一个`quantize`二进制文件,将GGUF文件转换为任何支持的量化级别。该过程根据模型大小需要5~30分钟。大多数用户应该从Hugging Face下载预先量化的GGUF文件,因为结果是等效的。
量化会影响模型的上下文窗口吗?
不会----量化仅影响模型权重精度,不影响上下文长度。Llama 3.1 8B模型支持128K代币,无论是量化到Q4_K_M还是在FP16下运行。但是,处理更长的上下文需要更多RAM,不管量化如何----用Q4_K_M 7B模型处理64K代币上下文可能需要10GB+RAM。
GGUF和GPTQ量化有什么区别?
GGUF(llama.cpp格式)和GPTQ是两种不同的量化方法。GGUF使用K-Quants并在CPU和GPU上运行。GPTQ仅在GPU上运行且需要PyTorch。对于Ollama、LM Studio或Jan AI的本地推理,GGUF是正确的格式。GPTQ用于AutoGPTQ和vLLM等GPU专注推理框架。
Hugging Face上不同提供者的Q4_K_M模型质量有区别吗?
量化算法在llama.cpp中是标准化的,所以同一基础模型的Q4_K_M量化无论谁创建GGUF文件都应该几乎相同。但是,一些提供者应用了额外的调整(imatrix量化)来改进质量。标记为"imat"或"importance matrix"量化的文件通常在相同比特数下质量更高。
什么是imatrix量化?
Imatrix(重要性矩阵)量化使用校准数据为不同权重分配不同的精度级别,基于其对模型输出的重要性。最影响预测的权重用更多位量化;不太重要的权重使用更少的位。结果:与均匀量化相比,相同比特数的质量更好。Qwen3 imatrix量化比标准Q4_K_M好2~4%。
Q4_K_M和Q4_K_S有什么区别?
两者都是4位量化,但K_M(中等)和K_S(小)在每个量化块的内存分配上有所不同。Q4_K_M使用更多元数据以获得更好的质量重构----通常对7B模型为4.5~5GB。Q4_K_S更激进----与K_M相比节省300~400MB,但有3~5%的质量损失。除非在极度受限硬件(<4GB RAM)上,否则使用Q4_K_M。
Q8_0和Q8_K_XL有什么区别?
Q8_0是标准的llama.cpp 8位量化----每个权重8位,7B模型约7.7 GB,相比FP16质量损失不足0.5%。Q8_K_XL不是llama.cpp的原生类型;它是Unsloth的"Dynamic"GGUF变体,保留8位基础,但将最敏感的层(嵌入层、注意力层、输出层)上采样到16位,以略大的文件大小将质量推向接近完整FP16。Q8_0对大多数用户而言已几乎无损,因此只有当您需要最后零点几个百分点的精度且有富余VRAM时,Q8_K_XL才有帮助。文件大小因模型而异----下载前请在LM Studio或Hugging Face上查看大小。
我可以在不重新下载模型的情况下切换量化级别吗?
不可以----切换量化级别需要下载不同的GGUF文件或自己重新量化基础模型。一旦模型被量化为Q4_K_M,如果没有原始FP16模型,您就无法将其转换回Q5_K_M。大多数用户从Hugging Face为其所需的量化级别下载预先量化的GGUF文件。
量化如何影响推理速度?
量化通常增加推理速度10~40%,因为加载和处理4位权重比16位浮点数更快。Q4_K_M 7B模型在消费级CPU上以约8~12 tok/s运行;相同模型在FP16下以约1~2 tok/s运行。量化对GPU性能的提升较小(快5~15%),因为GPU已经为浮点运算优化。
Ollama默认使用哪种量化级别?
Ollama默认为其库中的所有模型使用Q4_K_M。运行`ollama pull llama3.1:8b`时,您正在下载Q4_K_M变体。此默认为大多数用户很好地平衡了质量和RAM要求。要拉取不同的量化,请附加标签:`ollama pull llama3.1:8b:q5_k_m`或`ollama pull llama3.1:8b:q8_0`。
能在单块RTX 4090上运行Llama 3.3 70B吗?
可以,使用卸载。Llama 3.3 70B Q4_K_M需要~40GB----超过RTX 4090的24GB VRAM。通过CPU卸载:~24GB在VRAM中,~16GB在系统RAM中,速度5-10 token/秒。更好的选择:2× RTX 4090层分割(~100 token/秒)或搭载M5 Ultra的Mac Studio,它能在统一内存中原生容纳该模型(独立的token/秒测试数据尚不存在----该芯片于2026年9月22日上市)。
量化与卸载有什么区别?
量化降低模型权重的数值精度(FP16 → 4位),减少50-75%的内存需求,不改变模型架构。卸载在模型无法放入VRAM时将其部分移至系统RAM或CPU。量化减小总体大小;卸载使运行大于VRAM的模型成为可能,但会降低速度。
Mac Studio M5 Ultra运行70B模型需要量化吗?
不需要----搭载M5 Ultra的Mac Studio最低配备96GB统一内存(最高512GB),可原生运行Llama 3.3 70B。无需卸载。仍推荐使用Q4_K_M,因为内存带宽而非内存容量是限制因素;这款新芯片目前尚无独立的速度测试数据。
哪种技术组合最适合我的硬件?
8GB VRAM(RTX 4060 Ti):Q4_K_M用于最多7B模型。24GB VRAM(RTX 4090):7-13B原生Q4_K_M;70B需要64GB系统RAM卸载。2× 24GB VRAM:70B的Q5_K_M层分割(~100 token/秒)。Apple Silicon:直接使用统一内存,Q4_K_M优化速度。
我可以自己量化模型吗?
可以----llama.cpp包含一个`quantize`二进制文件,可将GGUF文件转换为任何支持的量化级别。
参考资料
- llama.cpp量化文档 -- github.com/ggerganov/llama.cpp/blob/master/examples/quantize/README.md
- K-Quants技术讨论 -- github.com/ggerganov/llama.cpp/pull/1684(原始K-Quant PR)
- GGUF格式规范 -- github.com/ggerganov/ggml/blob/master/docs/gguf.md
- Open LLM Leaderboard量化基准 -- huggingface.co/spaces/open-llm-leaderboard/open_llm_leaderboard
更新日志
- 2026-08-26: 半年度更新。新增"如何在LM Studio中选择量化"和"KV缓存量化"两个缺失章节以对齐英文版结构;将4个对比表格中残留的英文表头(Format/Method/Quality等)翻译为中文;修正datePublished不一致(2026-04-02 → 2026-04-04)及一处7B/8B模型对比错误;"截至2026年4月"更新为2026年8月。
- 2026-06-15: 新增逐一对决比较章节(Q4_0 vs Q4_K_M、Q4_K_M vs Q4_K_S、Q8_0 vs Q4_K_M、Q8_0 vs Q8_K_XL)以及专门的"Q8_0是什么?"解答;新增Q8_K_XL内容;事实已于2026年6月重新核实。
- 2026-05-17: 更新标题以反映决策导向的意图;内容未更改。