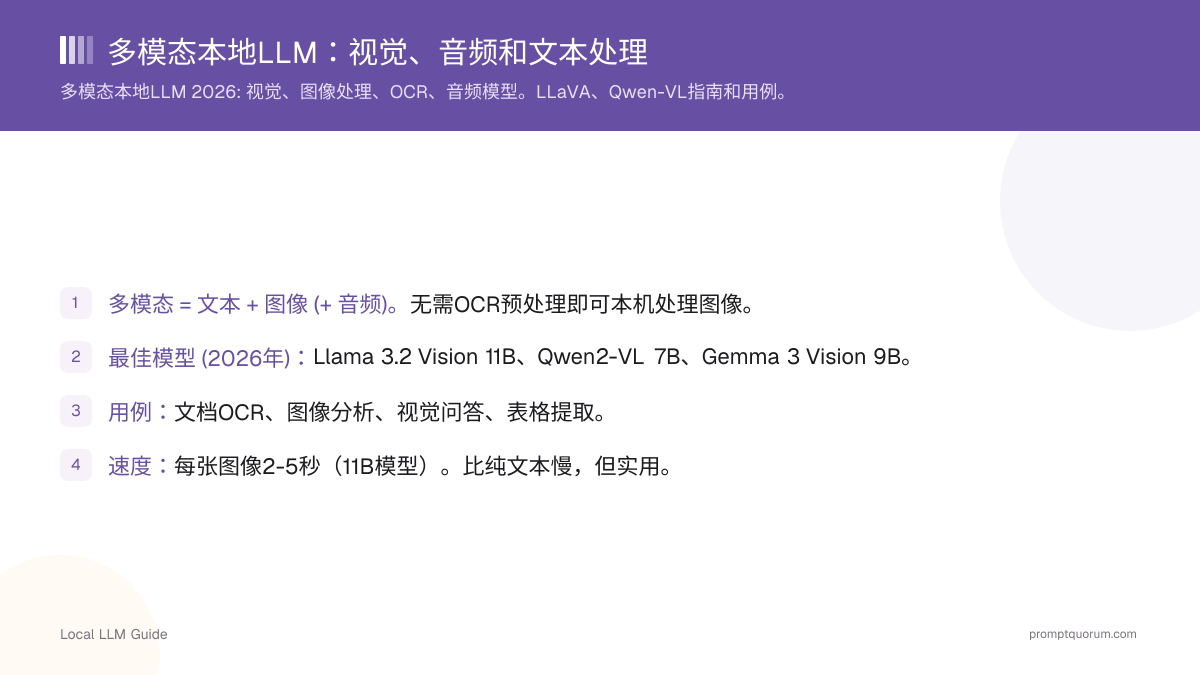
可用的多模态模型
模型 | 图像支持 | VRAM | 每张图像速度 | 最适用 |
|---|---|---|---|---|
| Llama 3.2 Vision 11B | 是 | 8 GB | 3-5秒/图像 | 通用视觉 |
| Qwen2.5-VL 7B | 是 | 6.0 GB(Ollama下载大小) | 取决于硬件 | 文档和OCR |
| Gemma 4 E2B | 是 | ~2 GB | 1-2秒/图像 | 最小硬件/边缘设备 |
| Llama 3.2 Vision 90B | 是 | 55 GB | 10+秒/图像 | 高质量 |
视觉能力
多模态模型可以:
- 图像描述: 解释图像中的内容。
- OCR (光学字符识别): 从图像提取文本(名片、文档扫描)。
- 视觉问答: 回答有关图像的问题("这辆车的品牌是什么?")。
- 表格提取: 将图像中的表格解析为结构化数据。
- 图表分析: 解读数据可视化。
- 物体检测: 识别和定位图像中的物体。
设置和使用
使用Ollama运行Llama 3.2 Vision:
python
# Pull the model
ollama pull llama3.2-vision:11b

# Use it
from ollama import Client
client = Client()

with open("image.jpg", "rb") as f:
    image_data = f.read()

response = client.generate(
  model="llama3.2-vision:11b",
  prompt="Describe this image",
  images=[image_data]  # Pass image data
)

print(response["response"])
真实世界用例
- 文档处理: 无需外部OCR服务从扫描PDF提取文本。
- 内容审核: 标记不适当的图像,无需发送到云端。
- 无障碍: 为视障用户描述图像。
- 产品分析: 分析电商产品图像(类别、状态、缺陷)。
- 研究: 分析科学图表和图解。
性能和限制
准确性: 适合文档OCR和描述,但不完美用于详细分析或小物体。
速度: 每张图像2-5秒。云模型(GPT-4 Vision)快10-50倍。
图像大小: 支持~1000×1000像素。更大的图像将被缩小采样。
限制: 复杂场景下无法匹配GPT-4 Vision准确性。权衡:隐私对质量。
常见错误
- 期望GPT-4 Vision的准确性。 本地模型准确性低20-30%。用于特定领域,不是通用视觉。
- 不准备图像。 将图像裁剪到焦点区域。去除噪声。更好的输入 = 更好的输出。
- 使用7B模型处理复杂视觉。 小模型在微妙细节上困难重重。使用11B+获得可靠视觉。
来源
- Llama 3.2 Vision Model Card -- huggingface.co/meta-llama/Llama-3.2-11B-Vision
- Qwen2.5-VL -- github.com/QwenLM/Qwen2.5-VL