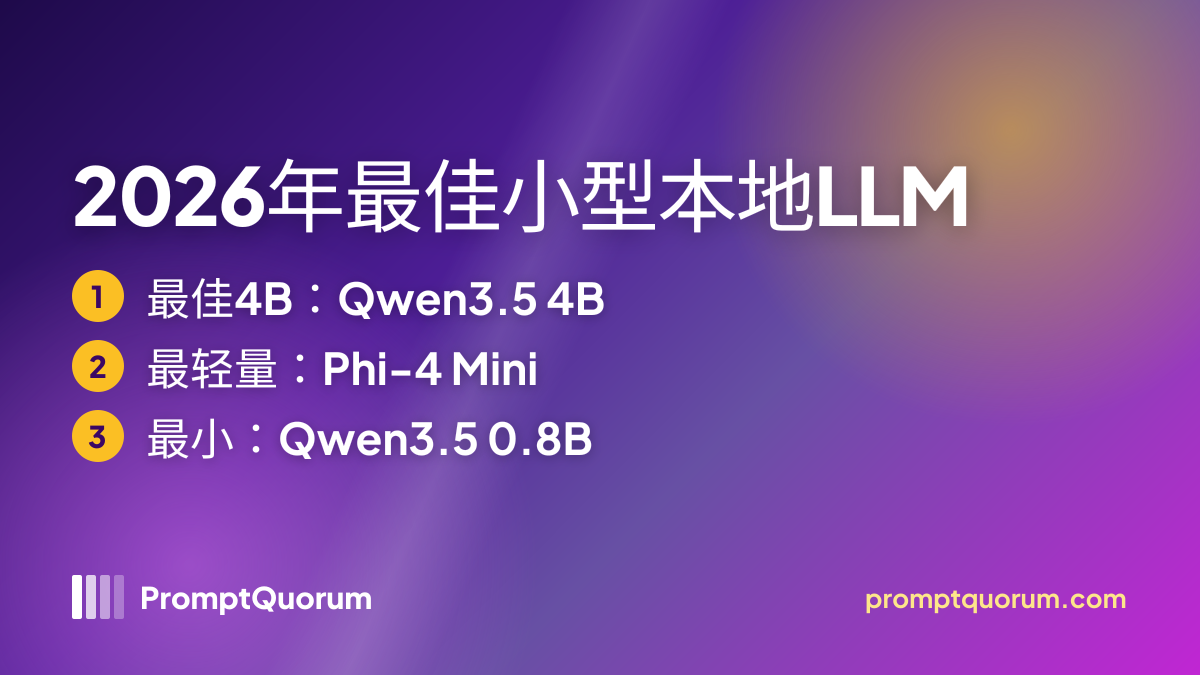
什么是“小型”本地LLM,何时该用它?
小型本地LLM通常是指参数量约40亿或更少的模型。 在4位量化下,这类模型的下载体积约为1-4 GB(Gemma 4的有效参数设计是例外,详见下文)——完全可以放进总内存只有4-8 GB的入门级笔记本。
小型模型适合摘要、简单问答、代码片段讲解、短文翻译、改写和分类。它们不适合冗长的多步推理链、大规模代码生成或连贯的长篇写作。
4B与7-9B模型之间的质量差距依然真实存在。如果你的机器有8 GB或以上内存且还有余量,Qwen3.5 9B这样的7-9B模型(Ollama下载6.6-7.6 GB)通常是更好的选择。7B模型推荐请参阅最佳入门本地LLM模型。
该选哪个小型模型?快速决策指南
- 8 GB及以上内存,追求最佳质量: Qwen3.5 4B(`ollama run qwen3.5:4b`)。
- 想用一个模型同时处理图像和文本,且有12 GB以上内存: Gemma 4 E4B(`ollama pull gemma4:e4b`)。
- 4-6 GB内存,需要英文推理或编程帮助: Phi-4 Mini 3.8B(`ollama run phi4-mini`)。
- 4 GB内存,或处理非英文文本: Qwen3.5 2B(`ollama run qwen3.5:2b`)。
- 可用内存不足3 GB,或树莓派级别设备: Qwen3.5 0.8B(`ollama run qwen3.5:0.8b`),并接受其能力上的局限。
Qwen3.5 4B -- 综合最佳小型LLM(最佳4B模型)
Qwen3.5 4B是本次对比中最强的4B级模型,其Qwen官方模型卡给出的成绩为MMLU-Pro 79.1、GPQA Diamond 76.2、LiveCodeBench v6 55.8。 它作为Qwen3.5 Small系列的一员于2026年初发布,采用Apache 2.0许可证,支持文本和图像输入、工具调用,原生上下文窗口为262,144个token。
有两点需要注意。第一,Qwen3.5模型默认开启思考模式,这能提升推理能力,但在CPU上较慢——简单任务请关闭思考。第二,模型卡并未说明主要基准分数采用哪种模式,而且Qwen的评测设置与Google、Microsoft不同,因此请把这些数字当作方向性参考,而不要逐点比较。
规格 | 数值 |
|---|---|
| MMLU-Pro | 79.1(厂商自报) |
| GPQA Diamond | 76.2(厂商自报) |
| LiveCodeBench v6 | 55.8(厂商自报) |
| 下载体积(Ollama) | 3.3-4.0 GB |
| 上下文 | 256K token |
| 许可证 | Apache 2.0 |
| Ollama命令 | ollama run qwen3.5:4b |
Gemma 4 E4B -- 最佳多模态4B级模型
据Google模型卡,Google Gemma 4 E4B在MMLU-Pro上得分69.4%,LiveCodeBench v6为52.0%,GPQA Diamond为58.6%。 “E4B”表示有效参数量为45亿;算上逐层嵌入后,模型约有80亿参数,这就是为什么尽管名为“4B”,Ollama下载体积却达到6.6-9.5 GB。它支持文本和图像输入,上下文窗口为128K,采用Apache 2.0许可证。
如果你想要Google的生态、出色的多语言表现(MMMLU 76.6%)或42.2%的Tau2智能体得分,请选E4B。如果你想以大约一半的磁盘和内存占用获得同级别的质量,请选Qwen3.5 4B。
规格 | 数值 |
|---|---|
| MMLU Pro | 69.4% |
| LiveCodeBench v6 | 52.0% |
| GPQA Diamond | 58.6% |
| 下载体积(Ollama) | 6.6-9.5 GB |
| 上下文 | 128K token |
| 许可证 | Apache 2.0 |
| Ollama命令 | ollama pull gemma4:e4b |
Phi-4 Mini 3.8B -- 最轻量的4B级模型(2.5 GB)
据其模型卡,Microsoft Phi-4 Mini在MMLU上得分67.3%,MMLU-Pro为52.8%,下载体积仅2.5 GB——是本文所列4B级模型中占用最小的。 它采用MIT许可证,上下文窗口为128K,并使用以推理为重点的精选合成数据训练。
在推理基准上它落后于Qwen3.5 4B和Gemma 4 E4B(GPQA 25.2,对比76.2和58.6),因此当内存是限制因素时(4-6 GB的机器),或者你看重宽松的MIT许可证时,再选择它。
规格 | 数值 |
|---|---|
| MMLU(5-shot) | 67.3% |
| MMLU-Pro | 52.8% |
| GPQA Diamond | 25.2% |
| 下载体积(Ollama) | 2.5 GB |
| 上下文 | 128K token |
| 许可证 | MIT |
| Ollama命令 | ollama run phi4-mini |
Qwen3.5 2B -- 4 GB机器的最佳选择
当4B模型放不下时,Qwen3.5 2B是最佳选择。 Qwen模型卡给出的MMLU-Pro成绩在非思考模式下为55.3,思考模式下为66.5,思考模式下的GPQA为51.6。它在Ollama上的下载体积为2.7-3.1 GB,支持图像输入,上下文窗口为256K,采用Apache 2.0许可证。
与0.8B模型相比,它在遵循指令方面可靠得多(非思考模式下IFEval为61.2对52.1),也是本文所列模型中我们愿意用于实际摘要和问答工作的最小模型。
规格 | 数值 |
|---|---|
| MMLU-Pro | 55.3% 非思考 / 66.5% 思考 |
| GPQA | 51.6%(思考模式) |
| 下载体积(Ollama) | 2.7-3.1 GB |
| 上下文 | 256K token |
| 许可证 | Apache 2.0 |
| Ollama命令 | ollama run qwen3.5:2b |
Gemma 4 E2B -- 边缘设备与多模态之选
据Google模型卡,Google Gemma 4 E2B在MMLU Pro上得分60.0%,LiveCodeBench v6为44.0%,GPQA Diamond为43.4%。 有效参数量为23亿(含逐层嵌入为51亿)。有效参数量并不意味着文件只有2 GB:Ollama列出的下载体积为4.6-7.5 GB,因此在达到相近水平的结果时,它比Qwen3.5 2B需要更多内存。
它的上下文窗口为128K,支持图像输入,采用Apache 2.0许可证。CPU吞吐量因硬件和量化而异(Google报告在树莓派5上解码速度约为7.6 tok/sec;独立的x86报告则在8-48 tok/sec之间)。如果你想在边缘设备上使用Google的工具链,可以选它;否则Qwen3.5 2B更轻量。
规格 | 数值 |
|---|---|
| MMLU Pro | 60.0% |
| LiveCodeBench v6 | 44.0% |
| GPQA Diamond | 43.4% |
| 下载体积(Ollama) | 4.6-7.5 GB |
| 上下文 | 128K token |
| 许可证 | Apache 2.0 |
| Ollama命令 | ollama pull gemma4:e2b |
Qwen3.5 0.8B -- 值得运行的最小模型
Qwen3.5 0.8B是本次对比中最小的模型:在Ollama上下载体积为1.2-1.3 GB,上下文窗口为256K,采用Apache 2.0许可证。其厂商自报的MMLU-Pro为29.7(非思考模式)和42.3(思考模式),GPQA为11.9——足以完成分类、关键词提取和简短改写,但不适合多步推理或长篇回答。仅在内存确实是硬性限制时(可用内存不足3 GB)、在单板计算机上,或在流水线中作为快速预过滤器时使用它。
规格 | 数值 |
|---|---|
| MMLU-Pro | 29.7% 非思考 / 42.3% 思考 |
| GPQA | 11.9%(思考模式) |
| 下载体积(Ollama) | 1.2-1.3 GB |
| 上下文 | 256K token |
| Ollama命令 | ollama run qwen3.5:0.8b |
完整对比:最佳小型本地LLM(0.8B-4B级)
模型 | MMLU-Pro | GPQA Diamond | 下载体积(Ollama) | 上下文 | 最适合 |
|---|---|---|---|---|---|
| Qwen3.5 4B | 79.1 | 76.2 | 3.3-4.0 GB | 256K | 综合最佳4B |
| Gemma 4 E4B | 69.4 | 58.6 | 6.6-9.5 GB | 128K | 多模态、Google生态 |
| Phi-4 Mini 3.8B | 52.8 | 25.2 | 2.5 GB | 128K | 最轻量的4B级,MIT |
| Qwen3.5 2B | 55.3 / 66.5 | 51.6 | 2.7-3.1 GB | 256K | 4 GB机器 |
| Gemma 4 E2B | 60.0 | 43.4 | 4.6-7.5 GB | 128K | 边缘设备 |
| Qwen3.5 0.8B | 29.7 / 42.3 | 11.9 | 1.2-1.3 GB | 256K | 最小可用 |
分数均为厂商在各自模型卡或Ollama页面上自报的数据,且评测设置各不相同;“a / b”表示非思考模式 / 思考模式。请仅作方向性参考。下载体积为Ollama列出的范围,对带视觉编码器的模型已包含该部分。
各地区的小型本地LLM
欧盟 / GDPR: 对于在受限硬件上运行AI的欧盟专业人士——外勤工作、物理隔离环境、较旧的企业笔记本——只要运行环境和应用已关闭遥测与同步,小型本地模型就可以完全在设备上完成推理,无需调用云端API。在普通企业笔记本上运行Qwen3.5 4B或Phi-4 Mini,可使所有处理的文本都留在设备上,这有助于实现GDPR第5条的数据最小化目标;但具体部署是否合规,仍取决于你的整体设置。许可证都很宽松:Phi-4 Mini为MIT,Gemma 4和Qwen3.5为Apache 2.0。这个规模上源自欧盟的选项有限;如果要求欧盟来源,请查看Mistral当前的产品线。
日本(METI): 对于小型模型层级的日语任务,Qwen3.5和Gemma 4 E4B在各自模型卡上的MMMLU得分都在76左右。在受限的机器上,可以尝试用`ollama run qwen3.5:2b`或`ollama run qwen3.5:4b`做日语摘要或翻译。小型模型的速度优势对在标配办公硬件上使用的企业很有意义,不过实际速度取决于你的CPU和量化方式。
中国: Qwen3.5(阿里巴巴,Apache 2.0)是部署中文小型模型的自然之选。对于适用中国《数据安全法》(数据安全法)的物联网和边缘部署,`ollama run qwen3.5:2b`可在约4 GB内存的Linux设备上运行,在设备本地处理文本,无需调用任何外部API;如涉及个人信息,还需结合《个人信息保护法》(PIPL)等要求,请自行单独确认你的合规义务。
运行小型本地LLM时有哪些常见错误?
- 简单任务也开着思考模式: Qwen3.5模型默认会思考,在回答前消耗大量额外token。在CPU上做聊天和信息提取时,请将其关闭(Ollama中使用`--think=false`),仅在数学和逻辑问题上保留。
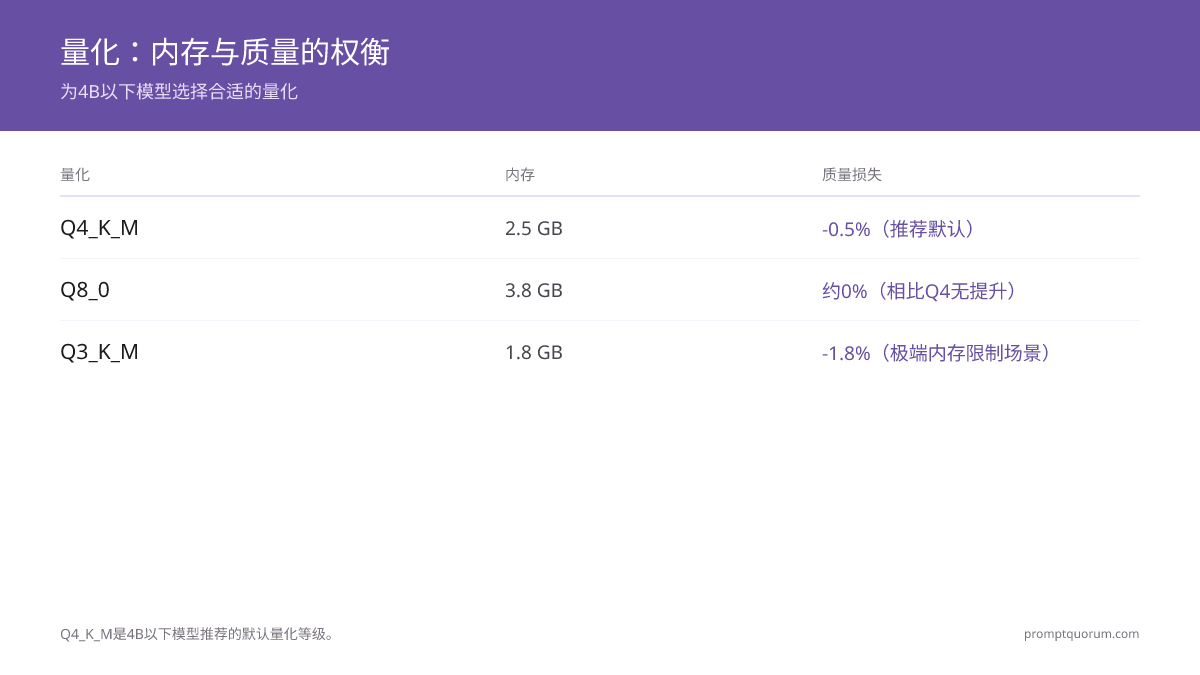
- 使用Q8_0量化而不是Q4_K_M: Q8_0所需内存几乎是Q4_K_M的两倍,而在小规模模型上带来的质量提升微乎其微。在4 GB机器上,Q8_0可能触发交换内存,使推理慢上数倍。小型模型请默认使用Q4_K_M。
- 运行基础模型而不是指令版本: 基础模型是微调之前的检查点,只会预测下一个token,不会遵循指令。问它“2+2等于几?”,它可能把这句话当成一道测验题接着往下写,而不是回答“4”。请使用本页给出的默认标签,它们都是经过指令微调的版本。
- 仅凭“E2B/E4B”的名字判断Gemma 4: 有效参数的标注低估了实际下载体积。Gemma 4 E4B在Ollama上为6.6-9.5 GB;在8 GB机器上拉取之前,请先确认列出的体积。
- 对小模型期待7B以上的质量: 小型模型适合处理简短、定义明确的任务。长推理链、长篇写作和复杂的代码生成明显弱于7-9B模型。如果输出质量不够,请升级到Qwen3.5 9B(Ollama下载6.6-7.6 GB)。
理解量化:内存与质量的权衡
关于小型本地LLM模型的常见问题
最适合在本地运行的小型LLM是哪个?
对大多数拥有8 GB及以上内存的人来说,2026年最佳小型本地LLM是Qwen3.5 4B(Apache 2.0,`ollama run qwen3.5:4b`):据Qwen自己的模型卡,它的MMLU-Pro为79.1、GPQA Diamond为76.2,领先于Gemma 4 E4B(69.4 / 58.6)和Phi-4 Mini(52.8 / 25.2)。如果只有4 GB内存,请降级到Qwen3.5 2B或Phi-4 Mini。这些都是厂商自报的数据,评测设置各不相同,因此差距只能当作方向性参考,而非精确数值。
最好的4B模型是哪个?
在厂商自报的推理基准上,Qwen3.5 4B是本次对比中最强的4B级模型,同时拥有256K上下文窗口,在Ollama上的下载体积约为3.3-4.0 GB。Gemma 4 E4B(有效参数45亿,含嵌入约80亿)是最接近的对手,如果你想用Google的生态,它是更好的选择,但其Ollama下载体积为6.6-9.5 GB。Phi-4 Mini 3.8B最轻量,仅2.5 GB且采用MIT许可证,但在推理基准上落后于前两者。
能在本地运行的最小LLM是什么?
在值得运行的模型中,Qwen3.5 0.8B是本次对比里最小的——在Ollama上下载体积为1.2-1.3 GB,拥有256K上下文窗口。它适合分类、关键词提取和简短改写,但其厂商自报的MMLU-Pro仅为29.7(非思考模式),说明遇到任何多步任务都会失败。更小的模型也存在,但在大约10亿参数以下,文本在几句话之后就无法保持连贯,因此更适合用作自动补全,而不是助手。
能产出有用结果的最小本地LLM是什么?
大约20亿参数是输出在摘要、简单问答和改写上变得可靠的门槛。Qwen3.5 2B(下载2.7-3.1 GB)是本文所列模型中我们愿意用于实际工作的最小模型;Qwen3.5 0.8B是硬件意义上的下限,而不是质量意义上的。如果你能腾出4 GB或更多内存,4B模型只需多占一点内存,连贯性就会大幅提升。
小型模型能在手机上运行吗?
可以。Qwen将Qwen3.5的0.8B和2B模型描述为面向边缘设备打造,Google也将Gemma 4 E2B和E4B定位于手机和笔记本。Ollama和LM Studio无法在iOS或Android上运行,所以手机端需要单独的应用或框架,而且实际速度在很大程度上取决于手机芯片和运行时。下载之前请先查看该应用自己的模型列表。
小型模型适合做摘要吗?
适合——摘要是它们最擅长的用途之一。本文所列的六个模型上下文窗口都在128K token或以上,所以文档长度很少成为限制;真正的限制在于模型在长输入中遵循指令的能力。Qwen3.5 4B和Gemma 4 E4B最可靠;使用0.8B模型时,请保持输入简短、输出简单。
在同样的硬件上,2B模型比7B模型快多少?
在CPU上明显更快,不过具体倍数在很大程度上取决于硬件和量化——Google自己公布的Gemma 4 E2B数据显示在树莓派5上解码速度约为7.6 tok/sec,而独立的x86 CPU报告则根据量化等级在8-48 tok/sec之间。在GPU上,速度优势会缩小,因为GPU吞吐量受模型大小的限制较小。请针对你的具体硬件查看最新的基准测试,而不要假定一个固定倍数。
小型模型支持函数调用吗?
部分支持。Qwen3.5的模型卡称该系列擅长工具调用,Gemma 4 E4B在Google的模型卡上报告Tau2智能体得分为42.2%(E2B:24.5%),因此在两者之间,工具调用场景选E4B更稳妥。在构建依赖结构化输出的流水线之前,请先查看各模型的文档,因为支持情况会因版本和运行时而异。
哪个小型模型最适合处理非英语语言?
在多语言MMMLU基准上,Qwen3.5 4B和Gemma 4 E4B实际上不相上下(模型卡上分别为76.1和76.6),两者都明显高于2B级模型。对于在4 GB机器上处理中文、日语、韩语或阿拉伯语,Qwen3.5 2B是务实的选择。更广泛的语言对比请参阅Qwen、Llama与Mistral多语言对比。
小型模型应该开启思考模式吗?
简单任务通常不需要。Qwen3.5模型默认会思考,会在回答前消耗大量额外token,在CPU上显得很慢。对于聊天、改写和信息提取,请关闭思考(在Ollama中:`ollama run qwen3.5:4b --think=false`);仅在数学、逻辑或多步问题上开启,因为这类场景下准确性比速度更重要。
Llama 3.2还值得使用吗?
本页不再将其列入排名。Llama 3.2 1B和3B(2024年)比本页每个模型都更早,而上面更新的2B-4B模型在相近体积下能力更强。如果你依赖的工具或微调模型是基于Llama 3.2构建的,它仍然有用。
4B模型需要多少内存?
4位量化的4B模型大约需要4-5 GB可用内存——Ollama列出Qwen3.5 4B为3.3-4.0 GB,Phi-4 Mini为2.5 GB——此外还要为上下文窗口和操作系统留出空间。8 GB的机器比较宽裕;4 GB则不够。Gemma 4 E4B是例外:其列出的下载体积为6.6-9.5 GB,所以需要12-16 GB的机器才能舒适使用。
我能同时运行两个小型模型吗?
可以,只要总内存允许。两个Q4_K_M的2B级模型合计大约占用6 GB——在系统精简的8 GB机器上是可行的。Ollama可以根据你的设置和可用内存同时保持多个模型加载,你也可以在不同端口上运行两个Ollama实例(OLLAMA_HOST=:11434和OLLAMA_HOST=:11435)。这对A/B测试输出很有用。
小型模型适用于RAG(检索增强生成)吗?
简单的RAG可以。Qwen3.5 4B和Phi-4 Mini能够可靠地回答基于检索到的文档片段的问题。对于需要多跳推理的大型知识库RAG,7B以上的模型表现更稳定。GPT4All的LocalDocs功能会运行一个小型模型来做文档问答,对个人文档集合效果不错。
来源
- Qwen3.5-4B、-2B和-0.8B模型卡 -- huggingface.co/Qwen/Qwen3.5-4B(基准、许可证、上下文长度)
- Ollama库:qwen3.5 -- ollama.com/library/qwen3.5(标签、下载体积、上下文)
- Google Gemma 4模型卡 -- huggingface.co/google/gemma-4-E4B-it(E2B和E4B基准、许可证)
- Ollama库:gemma4 -- ollama.com/library/gemma4(标签、下载体积、基准表)
- Microsoft Phi-4-mini-instruct模型卡 -- huggingface.co/microsoft/Phi-4-mini-instruct(MMLU、MMLU-Pro、GPQA、许可证)
- Ollama库:phi4-mini -- ollama.com/library/phi4-mini(下载体积、上下文)