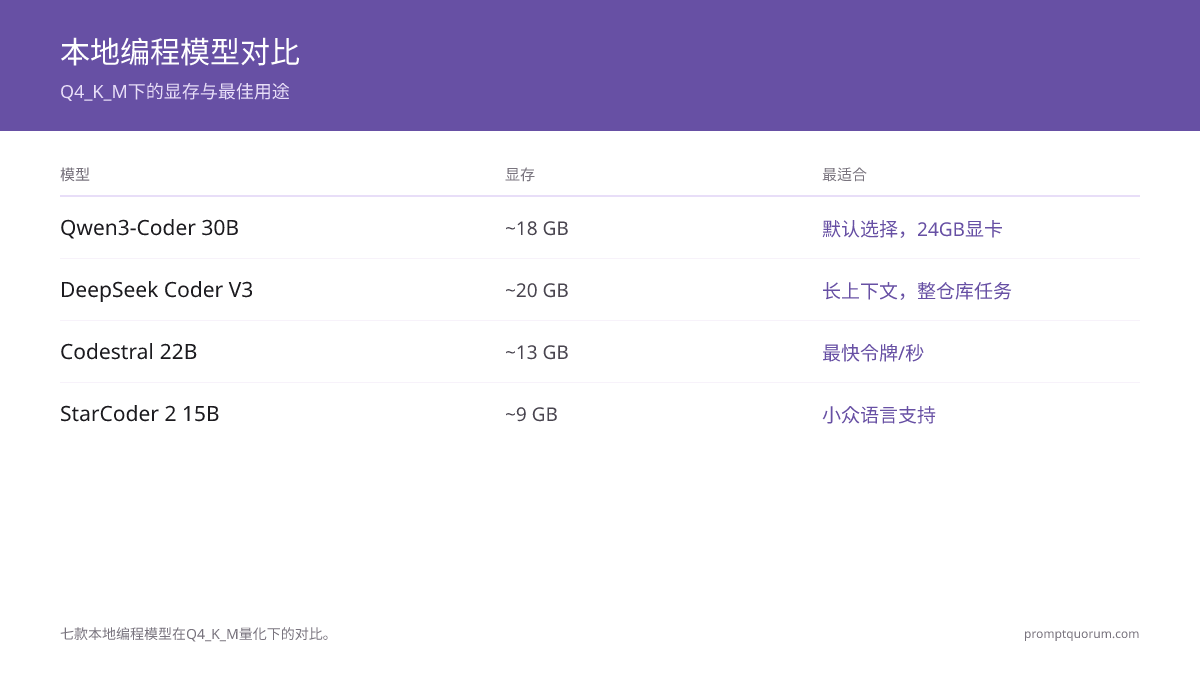
关键要点
- Qwen3-Coder 30B(阿里巴巴,Apache 2.0) 是2026年5月的默认本地编码模型 — 在开放权重模型中的供应商报告HumanEval+方向领先,支持256K令牌上下文窗口,在24GB消费级GPU上以Q4_K_M运行。
- Qwen3-Coder 7B 是最强的10B以下编码模型 — 适配8~10GB卡,在16GB MacBook上良好运行,为自动补完类工作流提供动力,其中30B过度。
- DeepSeek Coder V3 在此集合中提供最大的实用上下文窗口,在多文件推理上表现出色 — 但完整模型在Q4_K_M处需要48GB以上的VRAM;较小的MoE衍生变体在24GB卡上弥补差距。
- Codestral 22B(Mistral) 是速度选择 — 更低的活跃参数数量、快速推理、通过Mistral商业许可证的清晰商业路径。编码方向略落后于Qwen3-Coder,但在每秒令牌数上领先。
- Kimi K2.7 Code(Moonshot AI,2026年6月)是本指南中最强的智能体编码模型 — 基于Kimi K2.6打造的编码专用版本,具有256K上下文,但总参数1T/活跃参数约32B(MoE),需要约340GB,因此是服务器级选择,而非工作站选择。
- Granite Code(IBM,Apache 2.0) 为许可证清晰度和审计态势比排行榜位置更重要的企业环境而构建。34B变体是系列中最强的;8B变体是笔记本电脑选择。
- StarCoder 2(BigCode,BigCode OpenRAIL-M) 涵盖此集合中编程语言的最广泛范围,包括对小众语言(Rust、Lua、Haskell、Solidity)的强大覆盖。
- VRAM是大多数读者的约束条件。 在Q4_K_M处选择最大的模型,为上下文和工具留出2~4GB余量 — 不是排行榜分数最高的模型。
快速事实
- 甜蜜点选择(2026年5月): 24GB GPU上的Q4_K_M中的Qwen3-Coder 30B。
- 笔记本电脑/8~10GB GPU选择: Q4_K_M中的Qwen3-Coder 7B(~5GB)。
- 长上下文选择: 48GB以上VRAM上的Q4_K_M中的DeepSeek Coder V3。
- 速度选择: Q4_K_M中的22B+级别中最快的Codestral 22B。
- 企业/审计友好选择: Granite Code 34B(IBM,Apache 2.0)。
- 小众语言选择: StarCoder 2 15B(Rust、Lua、Haskell、Solidity覆盖)。
- Q4_K_M中的VRAM数学: 大约
(B中的参数)× 0.6 GB加上2~4 GB上下文开销。 - 许可证不相等。 Qwen3-Coder、DeepSeek Coder V3和Granite Code是Apache 2.0。Codestral拥有Mistral非生产许可证和单独的商业条款。Kimi K2.7 Code(Moonshot AI)采用Modified MIT许可证,大规模部署需要署名标注。StarCoder 2在BigCode OpenRAIL-M下提供。
2026年6个本地编码模型的比较
下面的所有数字都可以根据引用的模型卡进行公开验证(参见"资源"部分)。HumanEval+方向是供应商报告的;将其视为排名信号,而不是绝对精度 — 在任何生产决策之前在模型卡上重新检查。
📍 简单一句话
Qwen3-Coder 30B是默认的2026年5月选择;其余的字段在硬件适配、上下文长度、许可证态势或语言覆盖上获胜。
💬 简单来说
6个开放权重编码模型,没有对所有人都适用的明确"最佳"赢家。Qwen3-Coder在公开编码基准方向上领先;DeepSeek在上下文窗口上领先;Codestral在速度上领先;Granite在许可证清晰度上领先;StarCoder在小众语言覆盖上领先。正确的选择是其最大的约束与您最大的约束相匹配的选择。
模型 | 大小 | VRAM(Q4_K_M) | 上下文窗口 | 许可证 | 最适合 |
|---|---|---|---|---|---|
| Qwen3-Coder 30B | ~30B参数 | ~17~18 GB | 256K | Apache 2.0 | 2026年5月24GB GPU的默认选择 |
| Qwen3-Coder 7B | ~7B参数 | ~5 GB | 128K | Apache 2.0 | 笔记本电脑、8~10GB GPU、自动补完工作负载 |
| DeepSeek Coder V3 | MoE、~36B活跃(总数更大) | ~48GB+(完整);较小变体~24GB | 128K(可扩展) | Apache 2.0 | 长上下文、多文件、存储库范围推理 |
| Codestral 22B | ~22B参数 | ~13 GB | 32K | Mistral非生产(通过Mistral商业化) | 快速推理、欧盟团队商业许可证路径 |
| Kimi K2.7 Code | 1T总参数/32B活跃(MoE) | ~340GB(RAM+VRAM合计) | 256K | Modified MIT | 服务器级智能体编码、长时间任务 |
| Granite Code 34B | ~34B参数 | ~20 GB | 128K | Apache 2.0 | 企业审计、可预测的许可证态势 |
| StarCoder 2 15B | ~15B参数 | ~9 GB | 16K | BigCode OpenRAIL-M | 广泛语言覆盖(包括小众语言) |

您应该选择哪一个
正确的模型由您的约束条件决定 — VRAM、上下文窗口或许可证 — 而不是排行榜排名。 使用此快捷方式。
您的情况 | 选择 |
|---|---|
| 我有24GB GPU,想要最佳的通用本地编码模型 | Qwen3-Coder 30B |
| 我有12~16GB GPU,想要强大的日常模型 | Qwen3-Coder 7B(质量余量)或Codestral 22B(速度余量) |
| 我有8GB GPU或16GB MacBook | Qwen3-Coder 7B |
| 我有48GB以上的VRAM并从事整个存储库任务 | DeepSeek Coder V3 |
| 我在构建商业产品,许可证清晰度最重要 | Granite Code 34B(Apache 2.0)或DeepSeek Coder V3(Apache 2.0) |
| 拥有服务器级硬件(300GB以上RAM/VRAM),想要最强的智能体编码模型 | Kimi K2.7 Code |
| 我编写Rust、Lua、Haskell、Solidity或其他小众语言 | StarCoder 2 15B |
| 我的优先级是每秒令牌数,而不是绝对质量 | Codestral 22B |

Qwen3-Coder:默认本地编码选择
Qwen3-Coder是阿里巴巴的开放权重编码调整模型系列,在2026年5月是默认的本地编码模型。 它将最强的已发布HumanEval+方向与256K上下文窗口和Apache 2.0许可证配对 — 这三件事在一个模型中很少汇聚。
- 大小: 30B(头条模型)和7B(笔记本电脑和8GB GPU模型)。两者都是密集变压器(不是专家混合)。
- 上下文窗口: 30B为256K令牌;7B为128K。在不转向MoE衍生模型的情况下,此集合中最大的之一。
- 训练重点: 代码密集型多语言训练语料库,对Python、TypeScript/JavaScript、Java、C++、Go和Rust的强大覆盖。工具调用示例是后期训练混合的一部分。
- 许可证: Apache 2.0 — 无需单独许可即可商业使用,保留属性。
- Q4_K_M中的VRAM: 30B大约适配17~18GB,在24GB卡上为上下文和工具留出余量。7B大约适配5GB。
- 工具调用可靠性: 对于具有严格工具架构的工具(Cline、Continue.dev代理模式)的开放权重编码模型中最强。Cline依赖的XML格式可靠性在30B上高;在7B上不太可靠。
- 闪耀之处: 通用编码(Python、TypeScript)、大上下文任务(整个文件重构)、工具使用代理循环。
- 缺点: 7B变体对其大小来说是好的,但不能在多步推理上与30B匹配。小众语言(Lua、Haskell、Solidity)的覆盖少于StarCoder 2。
💡提示: 在24GB GPU上,在聊天/代理角色的Q4_K_M中运行Qwen3-Coder 30B,并在Q4_K_M中运行Qwen3-Coder 1.5B作为单独的自动补完过程。总VRAM:~19GB。分割使自动补完延迟保持在200毫秒以下,而较大的模型处理聊天中的非平凡工作。
DeepSeek Coder V3:长上下文重量级
DeepSeek Coder V3是当上下文长度是约束条件时要达到的模型。 它使用混合专家(MoE)架构,在中等活跃参数占用下提供强大推理,但沉重的总模型占用空间塑造硬件决策。
- 架构: MoE — 活跃参数的总参数远远更高。完整模型在磁盘和VRAM上比其活跃计数暗示的要重。
- 上下文窗口: 128K令牌,扩展技术根据量化和推理引擎进一步推动可用上下文。
- 训练重点: 代码和推理。在Python、TypeScript、C++和Go上强大。多步骤规划和思维链样式推理是值得注意的优势。
- 许可证: Apache 2.0 — 允许商业使用。
- Q4_K_M中的VRAM: 完整V3在舒适推理下需要48GB以上。蒸馏和较小的MoE衍生变体针对24GB卡;在下载前在模型卡上验证变体。
- 工具调用可靠性: 在允许OpenAI风格工具调用的工具上强大;在2026年5月Cline的严格XML架构上略弱于Qwen3-Coder。
- 闪耀之处: 整个存储库推理、长上下文任务、多步骤代理计划。
- 缺点: 硬件栏是此指南中任何模型中最高的。在24GB卡上,较小的衍生变体是唯一可行的选择,在长上下文任务上落后于完整模型。
⚠️警告: DeepSeek Coder V3在此指南中拥有最高的硬件栏 — 完整模型在Q4_K_M处需要48GB以上的VRAM。社区24GB目标衍生物存在且可用,但它们放弃了长上下文推理,这是选择DeepSeek而不是Qwen3-Coder的主要原因。在决定之前将变体与您的硬件匹配。
Codestral 22B:具有清晰商业路径的速度选择
Codestral是Mistral的编码调整模型。 在已发布的编码方向上略落后于Qwen3-Coder,但在每秒令牌数上获胜,并通过Mistral提供清晰的商业许可路径。
- 大小: 22B(头条)。在Q4_K_M时舒适地适配16GB GPU,具有上下文余量。
- 上下文窗口: 32K令牌。比Qwen3-Coder和DeepSeek更小;足以进行单文件和大多数多文件编辑,但在整个存储库工作中有限制。
- 训练重点: 广泛的多语言代码覆盖,在Python、TypeScript、Java、C++和Bash上表现强大。
- 许可证: 默认为Mistral非生产许可证;商业使用需要Mistral商业许可证(付费)。这在此集合中是不寻常的,是出船的商业产品的最重要事实。
- Q4_K_M中的VRAM: ~13GB — 在16GB GPU上舒适,在24GB上充足。
- 推理速度: 在同量化下比Qwen3-Coder 30B快,比DeepSeek Coder V3快很多。质量对速度的权衡在六个中最清晰。
- 闪耀之处: 16~24GB卡上的实时自动补完、Mistral商业关系重要的欧盟团队工作流、聊天中的快速迭代。
- 缺点: 32K上下文在此集合中StarCoder 2之后最小。许可证故事比Apache 2.0更复杂 — 在集成之前阅读Mistral非生产条款。
📌注: Codestral的许可证是此集合中唯一最大的"陷阱"。Mistral非生产对个人使用、评估和内部R&D是可以的。对于商业产品,您必须协商Mistral商业许可证或选择不同的模型 — Apache 2.0替代品(Qwen3-Coder、DeepSeek Coder V3、Granite Code)在没有许可证管理开销的情况下涵盖相同的使用案例。
Kimi K2.7 Code:服务器级智能体选择
Kimi K2.7 Code是本指南中最强的智能体编码模型 — 也是唯一无法在单张消费级GPU上运行的模型。 Moonshot AI于2026年6月将其作为基于Kimi K2.6打造的编码专用版本发布。它是一个总参数1万亿的混合专家(MoE)模型,活跃参数约320亿,公开的最小量化版本约为340GB,因此应规划服务器级硬件,而非工作站。
- 大小: 只有一个规格 — 总参数1T,每个token约32B处于活跃状态(MoE)。没有小型变体,因此没有笔记本电脑方案。
- 上下文窗口: 256K令牌,延续自Kimi K2.6。
- 训练重点: 编码专用且面向智能体任务。Moonshot报告称推理token比K2.6减少约30%,长时间任务表现更强——这种差异体现在多步骤任务上,而非单函数补全。
- 许可证: Modified MIT — 允许商业使用,但大规模部署需要署名标注。在产品中集成前请阅读修改条款。
- 内存占用: 同架构K2.6公开的最小量化版本约340GB,需要约350GB的RAM+VRAM总量才能获得可用速度。INT4是实用的本地格式。这需要多GPU服务器或非常大的统一内存机器,而不是24GB显卡。
- 工具调用可靠性: 其设计重点是长时间的智能体工具使用,这正是它与本指南中密集编码模型的区别所在。如果您的工作负载是内联补全而非多步骤智能体循环,额外的硬件投入回报有限。
- 闪耀之处: 已经拥有推理硬件并运行长时间智能体编码任务的团队——全仓库重构、多文件迁移、持续的工具循环。
- 缺点: 硬件门槛使其对几乎所有个人开发者都不适用。如果您在单台机器上工作,Qwen3-Coder 30B是更好的默认选择,日常编码上的差距远小于10倍硬件成本所暗示的程度。
💡提示: Kimi K2.7 Code与这里的小模型并非二选一关系。对于拥有相应硬件的团队,现实的做法是在每台开发者机器上运行Qwen3-Coder 30B用于内联补全和日常聊天,同时在共享服务器上保留Kimi K2.7 Code用于长时间的智能体任务——例如全仓库重构和迁移,此时其256K上下文和更低的推理token成本才能真正物有所值。
Granite Code:企业/审计友好选择
IBM的Granite代码系列为许可证可预测性和审计态势比排行榜位置更重要的企业环境而构建。 Apache 2.0、透明的训练数据文档和测量的发布节奏使其在这六个中最容易在采购审查中防守。
- 大小: 34B(头条)和8B(笔记本电脑/8GB GPU)。密集变压器,不是MoE。
- 上下文窗口: 128K令牌。
- 训练重点: 代码密集多语言,刻意记录训练语料库 — 比代码质量更适合采购的定位选择。
- 许可证: Apache 2.0 — 与Qwen3-Coder和DeepSeek Coder V3相同的态势。
- Q4_K_M中的VRAM: 34B约20GB,8B约5GB。
- 编码方向: 在大多数公开基准上落后于Qwen3-Coder 30B;在Python和Java上与Codestral竞争,在TypeScript上落后。
- 闪耀之处: 采购驱动的选择、企业审计背景、模型卡的数据出处文档本身就是可交付成果的规管产业部署。
- 缺点: 绝对编码能力低于领导者。如果采购不是约束条件,Qwen3-Coder在相同硬件预算上更强。
StarCoder 2:小众语言选择
StarCoder 2是BigCode的开放权重编码模型系列,在2026年5月是小众编程语言最强的开放权重模型。 它覆盖此集合中比任何其他模型更多的语言,包括Lua、Haskell、Solidity和长尾的不太常见的语言。
- 大小: 15B(实用本地选择)、7B、3B。密集变压器。
- 上下文窗口: 16K令牌 — 此集合中最小,且是主要约束。
- 训练重点: 广度优于深度 — 在数百种编程语言上训练,故意覆盖不太常见的语言。Python和TypeScript性能落后于领导者,但Rust、Lua、Haskell和Solidity覆盖是开放权重模型最佳。
- 许可证: BigCode OpenRAIL-M — 具有使用案例限制的负责任AI许可证。在商业集成之前阅读许可证;它比Mistral非生产更宽容但比Apache 2.0更限制。
- Q4_K_M中的VRAM: 15B约9GB — 舒适地适配12或16GB卡。
- 闪耀之处: 小众语言工作(Rust、Lua、Haskell、Solidity、Elm、Julia)、多语言代码库、其他模型不提供的语言覆盖。
- 缺点: 16K上下文窗口是此集合中最小的;绝对Python和TypeScript性能低于Qwen3-Coder和DeepSeek。
量化级别VRAM数学
VRAM是大多数本地编码模型决策的约束条件。 简单规则:在Q4_K_M处,预期模型权重大约(B中参数)× 0.6 GB加上上下文和工具2~4GB。更高量化(Q5、Q6、Q8)以VRAM换取质量恢复。
- Q4_K_M(默认): 大多数编码工作大小和质量的最强平衡。大约每十亿参数0.6GB。30B模型适配~18GB;7B适配~5GB。
- Q5_K_M: 大约每十亿参数0.75GB。30B模型需要~22GB。质量恢复在多步推理上小但可衡量。
- Q6_K: 大约每十亿参数0.85GB。30B模型需要~26GB。在32GB卡上值得余量。
- Q8_0: 大约每十亿参数1.05GB。30B模型需要~32GB。最接近FP16质量,VRAM一半。
- FP16(无量化): 大约每十亿参数2.0GB。30B模型需要~60GB。仅用于微调或研究;永不本地推理。
- 上下文VRAM成本: 按序列长度缩放。根据经验,编码模型上活跃上下文每32K令牌预期~1GB — 对DeepSeek Coder V3和Qwen3-Coder长上下文使用意义深远。
- 工具开销: Ollama、LM Studio和llama.cpp各在模型和上下文上增加~500MB~1GB。为活跃工具保留2~4GB总余量。

💡提示: 关于量化如何工作以及为什么Q4_K_M是最常见的默认值的更深入解释,请参阅LLM量化解释。本指南的其余部分假设上面的数学。
上下文窗口比较
上下文窗口是VRAM后的第二个约束条件,也是营销文案中最被高估的指标。 编码模型不会在整个声称的窗口中保持完全的注意质量 — 工作部分通常更小。使用下面引用的数字作为上界,而不是实际限制。
模型 | 声称上下文 | 实际工作上下文(编码) | 注释 |
|---|---|---|---|
| Qwen3-Coder 30B | 256K | ~64K~128K | 2026年5月最强的长上下文编码模型之一。 |
| Qwen3-Coder 7B | 128K | ~32K~64K | 7B级总是失去一些长上下文回忆。 |
| DeepSeek Coder V3 | 128K | ~64K~96K | 整个窗口的强回忆;长上下文领导者。 |
| Codestral 22B | 32K | ~16K~24K | 22B+级别中最小;整个存储库工作很紧。 |
| Kimi K2.7 Code | 256K | ~32K~64K | 长上下文回忆落后于Qwen3-Coder。 |
| Granite Code 34B | 128K | ~32K~64K | 平衡;不是长上下文领导者。 |
| StarCoder 2 15B | 16K | ~8K~12K | 此集合中的硬限制。 |

💡提示: 实际工作上下文决定模型是否可以将您的存储库记在脑子里,而不是营销列。对于多文件重构,优先考虑实际回忆列而不是头条 — Codestral的32K是真实的,Kimi K2.7 Code宣称的256K在很大程度上是理论值。
许可证比较
许可证条款决定了哪个模型可以在商业产品内发布。 在集成时验证许可证 — 开放源码编码模型许可证在版本之间漂移的倾向,尤其是供应商许可证系列(Mistral、Llama)。
模型 | 许可证 | 无需单独许可的商业使用? | 关键约束 |
|---|---|---|---|
| Qwen3-Coder | Apache 2.0 | 是 | 标准属性;无其他限制。 |
| DeepSeek Coder V3 | Apache 2.0 | 是 | 标准属性;无其他限制。 |
| Codestral | Mistral非生产 | 否 | 商业使用需要付费Mistral商业许可证。 |
| Kimi K2.7 Code | Modified MIT | 是(有警告) | 可接受使用政策;使用阈值以上单独条款适用。 |
| Granite Code | Apache 2.0 | 是 | 标准属性;无其他限制。 |
| StarCoder 2 | BigCode OpenRAIL-M | 是(有使用案例限制) | 高风险应用的使用案例限制;针对许可证文本验证。 |

⚠️警告: Codestral的许可证困扰了用它进行原型设计然后无需重新检查就发布的团队。如果模型接触付费用户 — 甚至通过产生面向客户工件的内部工具间接接触 — 您需要Mistral商业。在集成前移动到Qwen3-Coder或Granite Code(两者Apache 2.0)以避免许可证重新谈判循环。
决策树:您应该选择哪一个
按顺序的6个问题将大多数读者引导到正确的选择。
📍 简单一句话
决定是VRAM优先,许可证第二,上下文第三 — Qwen3-Coder是24GB上Apache 2.0的安全默认值;其他5个选择分别解决Qwen3-Coder不解决的一个特定约束。
💬 简单来说
除非您有特定理由,否则选择Qwen3-Coder。理由是:硬件(少于12GB→7B;超过48GB→DeepSeek)、语言(小众语言支持→StarCoder 2)、采购(规管产业→Granite Code)或已拥有服务器级硬件(300GB以上RAM/VRAM→Kimi K2.7 Code)。如果您可以为商业许可证付费,Codestral是速度选择。
- 1. 您有多少VRAM? 少于12GB:Qwen3-Coder 7B。12~16GB:Qwen3-Coder 7B或Codestral 22B。24GB:Qwen3-Coder 30B。48GB以上:DeepSeek Coder V3(完整)。
- 2. 您是在商业产品内出货吗? 是的:优先Apache 2.0(Qwen3-Coder、DeepSeek Coder V3、Granite Code)。避免Codestral,除非您支付Mistral商业许可证。
- 3. 您需要超过32K的上下文窗口吗? 是的:跳过Codestral和StarCoder 2。选择Qwen3-Coder、DeepSeek或Granite Code(如果硬件允许,Kimi K2.7 Code也可以)。
- 4. 您编写小众语言(Rust、Lua、Haskell、Solidity)吗? 是的:StarCoder 2 15B,尽管16K上下文限制。
- 5. 您在规管产业中,许可证和培训数据出处需要采购防卫吗? 是的:Granite Code 34B最容易建立案例。
- 6. 仍然不确定? 默认为Qwen3-Coder — 如果您有24GB GPU则为30B,否则为7B。当您超越它时重新评估。

💡提示: 决策树有意简短。大多数团队过度思考模型选择,轻视工具选择 — 对于工具一侧,请参阅Continue.dev vs Cline vs Aider。可靠选择内的模型差异小于工具适配差异。
选择本地编码模型的常见错误
- 错误1:选择排行榜分数最高的模型,不论硬件。 不在Q4_K_M中适配且在2~4GB余量不足的模型将溢出到磁盘,对交互式编码变得不可用。VRAM是大多数读者的约束条件。
- 错误2:相信声称的上下文窗口是实际工作窗口。 编码模型丧失注意质量超过大约要求窗口的一半。为实际窗口计划,不是头条号。
- 错误3:跳过许可证读。 Codestral在无Mistral商业许可证的商业产品上是采购失败。Modified MIT为高使用应用拥有门。集成前读许可证。
- 错误4:在工具选择中忽视工具调用可靠性。 Cline的严格XML架构、Continue.dev的代理模式和任何MCP循环都依赖模型清晰发出工具调用。编码调整30B+可靠;7B级频繁失败。
- 错误5:不与较大聊天模型配对小自动补完模型。 30B聊天模型对200毫秒以下自动补完过度。在聊天模型旁边运行1.5B~7B自动补完模型 — 总VRAM保持可管理,延迟保持交互式。
- 错误6:不每六个月重新检查模型卡。 开放权重模型线更新;量化方案改进;许可证有时收紧。今天的默认选择不一定是2026年11月的默认值。

资源
- Hugging Face上的Qwen3-Coder模型卡 — Qwen3-Coder 30B的架构、参数数、上下文窗口、许可证和供应商报告基准方向。
- DeepSeek Coder V3模型卡 — DeepSeek Coder V3的MoE架构详情、上下文窗口、许可证和基准方向。
- Codestral模型卡 — Codestral 22B的架构、上下文窗口和许可证条款。
- Mistral商业许可 — Codestral和其他Mistral非生产许可模型商业使用所需条款。
- Kimi K2.7 Code(Hugging Face) — Moonshot AI的模型卡、量化版本,以及Modified MIT许可证全文。
- Granite代码模型卡(IBM) — Granite Code的大小、上下文窗口、培训数据文档和Apache 2.0许可证。
- StarCoder 2模型卡(BigCode) — StarCoder 2的大小、上下文窗口、语言覆盖和BigCode OpenRAIL-M许可证。
- Ollama模型库 — 上述各模型的量化变体、文件大小和拉动命令。
- BigCode OpenRAIL-M许可证文本 — StarCoder系列模型的完整许可证文本和使用案例限制。
常见问题
本地编码模型中最接近GPT-5编码的是哪一个?
没有开放权重模型在2026年5月对绝对编码能力与前沿闭源模型匹配 — 对GPT-5/Claude 4.x/Gemini前沿编码模式的差距在多步推理和罕见库使用方面是真实的。在开放权重模型中,Qwen3-Coder 30B在日常编码工作的已发布基准方向上领先;DeepSeek Coder V3最接近长上下文多文件推理。对于编辑器内交互式编码,差距小于听起来的样子 — 本地模型常规地为自动补完和70~90%代码编辑任务"足够好"。
Qwen3-Coder是否为TypeScript击败DeepSeek?
在各供应商报告的头条HumanEval+方向上,Qwen3-Coder 30B在2026年5月的一般编码任务上领先DeepSeek Coder V3。TypeScript特定性能因为不是所有供应商都发布每语言分割而难以清晰比较 — 如果TypeScript是您的首要语言,重新检查模型卡上的当前每语言数字。对于大多数IDE中的TypeScript工作,两个模型互换。
嵌入式/Rust开发的最佳模型是什么?
如果您有24GB VRAM的一般Rust的Qwen3-Coder 30B。与小众嵌入式语言或多语言嵌入式系统工作配对的Rust的StarCoder 2 15B — 其语言覆盖超越领导者沉重训练的地方。对于较小GPU上的纯Rust,Qwen3-Coder 7B仍然是绝对Rust能力上StarCoder 2之前的可靠选择。
我可以在16GB VRAM上运行30B编码模型吗?
不能在Q4_K_M — 30B模型需要大约17~18GB在Q4_K_M加2~4GB上下文开销。选项:激进量化(Q3_K_M将VRAM减至~14GB但牺牲注意到的质量)、使用不同模型(Codestral适配Q4_K_M在16GB舒适)或使用Qwen3-Coder的7B变体(有余量)。购买24GB GPU是最干净的修复。
Codestral在2026年仍然相关吗?
是的 — Codestral 22B仍然是22B+级别中的速度领导者,当每秒令牌数重要于绝对排行榜排名时是正确的选择。其主要缺点是Mistral非生产许可证,为商业部署增加摩擦。对于非商业使用或已经为Mistral商业许可证支付的团队,Codestral在大多数日常编码工作中与Qwen3-Coder竞争。
哪个模型最好处理长上下文(100k+行)?
此集合中的长上下文编码任务的DeepSeek Coder V3领导,在其128K窗口中强回忆。Qwen3-Coder 30B声称256K但实用工作上下文更接近64K~128K。对于真正的整个存储库任务(超过100K行),没有模型保持完全注意 — 将任务分割为较小范围或使用针对代码库的检索增强方法而不是依赖原始上下文长度。
编码特化模型是否为代码击败通用模型?
对于典型编码工作,是的。Qwen3-Coder 30B和DeepSeek Coder V3都在编码基准上超过类似大小的通用模型(Llama 3.3 70B、Qwen3 32B通用)。差距在工具使用代理循环和代码上的多步推理上最大。对于混合编码加推理任务(需要读取规范的调试、提议架构),具有强推理的通用模型有时更好。
我可以微调这些中的任何一个吗?
所有6个在各自许可证下允许微调,最宽容是Apache 2.0模型(Qwen3-Coder、DeepSeek Coder V3、Granite Code)。30B模型的有意义微调需要比推理更多VRAM — 通常LoRA为80GB以上,完全微调为更多。对于大多数读者,针对代码库的索引的检索增强生成是微调前的更好第一步。
哪个模型支持最多编程语言?
StarCoder 2 — 其培训语料库跨越数百种编程语言,包括小众语言(Lua、Haskell、Solidity、Elm、Julia、Nim、Zig)。对于多语言代码库或不太常见语言中的工作,StarCoder 2 15B是最佳开放权重选择,尽管其在Python和TypeScript上的绝对质量落后于领导者。
开放源代码编码模型是否追上Claude/GPT?
在例行编码任务上(自动补完、单文件编辑、常见重构),差距狭窄且持续关闭。在硬多步推理、大规模上下文整个存储库工作和罕见库使用上,差距仍然真实。实际含义:对于大多数交互式编辑器工作,在24GB GPU上运行Qwen3-Coder 30B对于70~90%任务"足够好"以替换云编码助手;剩余10~30%是前沿闭源模型仍然拉开。