快速概览
- iPad应用: PocketPal AI(免费,MIT)、Locally AI(免费+付费选项,MLX)、Google AI Edge Gallery(免费,Apache 2.0)。LLM Farm(免费,MIT,仅iOS)已于2025年8月从App Store下架,现在只能从源码构建。
- 安卓方案: PocketPal AI或Google AI Edge Gallery(应用,无需终端),或Termux + Ollama(命令行)。
- 远程连接: 任意平板浏览器 → 家用机器局域网IP上的Open WebUI或简单聊天界面。由于Ollama没有原生iPadOS版本,iPad用户也是通过这种方式运行Ollama。
- 本地推理最低配置: 3B至4B模型需iPad Air M4(12 GB);7B至8B模型需iPad Pro M5(12 GB / 16 GB)。
- 安卓本地推理最低配置: 8 GB RAM(Samsung Galaxy Tab S10+、OnePlus Pad 2)。
- 最佳本地模型: 大多数平板选Phi-4 Mini(3.8B,2.7 GB);内存极度受限选Qwen3 1.7B。
- 远程连接速度: 取决于Wi-Fi质量和家用机器的生成速度,与平板硬件无关。
两种模式:本地推理 vs 远程连接
最重要的决策不是选哪款应用——而是在平板上本地推理还是连接家用更强大的机器。 两种模式有截然不同的硬件要求和能力上限。
📍 简单一句话
在平板上运行AI有两种实用模式:本地推理(模型在平板芯片上运行,限于3B至7B模型)或远程连接(平板作为浏览器显示终端,连接家用Mac或PC通过Ollama和Open WebUI运行更大模型)。
💬 简单来说
本地模式:模型存储在平板上,离线可用。受限于小型模型(3B,高端iPad Pro最多7B),速度慢于云端AI。远程模式:家用Mac或PC运行Ollama和70B模型,平板仅在浏览器中显示聊天——平板屏幕可获得完整70B模型质量,平板无需存储模型,但家用机器需开机且连接同一Wi-Fi。除非特别需要离线使用,否则选择远程连接。
对比项 | 本地推理 | 远程连接 |
|---|---|---|
| 模型规模上限 | 3B至8B(iPad Pro M5);大多数平板3B至4B | 无限制——家用机器可运行任意模型 |
| 离线使用 | 支持——无需Wi-Fi | 不支持——需要家庭Wi-Fi |
| 生成速度 | 中等(iPad Pro M5约12至30词元/秒) | 取决于家用机器(最高40+词元/秒) |
| 平板存储占用 | 每个模型2至10 GB | 零——模型存储在家用机器上 |
| 设置复杂度 | 低(下载应用+模型文件) | 低至中(家用机器需安装Ollama + Open WebUI) |
| 适合场景 | 出行、离线使用、3B模型任务 | 质量优先、70B模型、日常便捷使用 |

💡提示: 如果家中已有能运行Ollama的Mac或PC,先从远程连接开始。无需在平板上存储模型文件,立即获得更好的模型质量。如果之后发现需要离线使用,再考虑添加本地推理能力。
iPad:本地推理
iPad Pro M5是最适合运行7B至8B模型的iPad。 苹果将M5 iPad Pro基础内存提升至12 GB(1 TB/2 TB存储版为16 GB),高于上一代M4基础版的8 GB,内存带宽也从120 GB/s提升至153 GB/s——由于Apple Silicon上的LLM推理受内存带宽制约,这直接转化为更快的生成速度。iPad Air M4(12 GB,高于M3 Air的8 GB)现在可以流畅运行3B至4B模型,而不仅仅是勉强运行。iPad Air M3(8 GB)和其他8 GB iPad仅限于Q4量化的1B至3B模型。配备8 GB RAM的iPhone也可通过LLM Farm运行小型模型。
- PocketPal AI(免费,开源MIT,iOS + 安卓):通过llama.cpp运行GGUF模型,可在应用内从Hugging Face下载模型或导入文件,并内置基准测试,方便您测量自己平板的每秒词元数。最近一次上游更新:2026-10-19。参见PocketPal AI评测。
- Locally AI(免费含付费选项,闭源,iPhone/iPad/Mac):通过苹果的MLX框架运行开源模型,专为Apple Silicon打造。最近一次App Store更新:2026-10-15。参见Locally AI评测。
- Google AI Edge Gallery(免费,Apache 2.0,iOS + 安卓):Google面向Gemma模型的本地推理应用,基于LiteRT-LM运行时。最近一次上游更新:2026-10-23。参见Google AI Edge Gallery评测。它还能运行 Gemma 4(E2B 和 E4B),即谷歌目前的小尺寸设备端模型。
- LLM Farm(免费,MIT,仅iOS):苹果于2025年8月下架了其App Store页面,项目README也将App Store和TestFlight均列为"暂时不可用"——唯一途径是在Xcode中从源码构建。最近一次上游更新:2026-01-30,距今已超过180天,可能已无人维护;依赖前请先查看代码仓库。参见LLM Farm评测。
- 导入模型: 在PocketPal AI中,可在应用内从Hugging Face下载GGUF模型,或导入通过苹果文件应用传输的GGUF文件。模型存储在应用本地存储中——不使用iCloud。
- iPad内存管理: iOS会主动管理后台应用内存。在12 GB iPad上运行7B模型前关闭所有其他应用——iOS可能会在其他应用需要内存时清除模型。在16 GB iPad Pro M5(1 TB/2 TB版)上此问题很少出现。
- 生成速度估算(近似值,并非PromptQuorum基准测试——请使用PocketPal AI内置基准测试测量您自己的设备): iPad Pro M5(12 GB / 16 GB):Phi-4 Mini约25词元/秒,Llama 3.2 3B约38词元/秒,Gemma 3 4B约23词元/秒——较上一代M4快约25%至30%,与内存带宽提升幅度一致。iPad Air M4(12 GB):3B至4B模型约15至20词元/秒;7B模型约7至10词元/秒(实时对话速度仍偏慢)。
- 入门级iPad和RAM不超过8 GB的iPad: 使用Q4量化的1B至3B模型,或将iPad仅作为远程连接的显示终端。如果模型放不进可用内存,iPadOS会直接关闭应用,而不是平稳降速。

⚠️警告: 不要在12 GB iPad Air上运行7B模型进行实时对话。每秒7至10词元意味着每个回复仍需10至20秒。此速度勉强可用于摘要任务,但对话体验较差。iPad Air请使用3B至4B模型;7B以上质量需升级至16 GB iPad Pro M5或切换至远程连接。
安卓:本地推理
安卓本地推理使用Termux + Ollama——Termux是在安卓上原生运行Ollama的Linux终端模拟器。 比iPad应用体验更需技术基础,但可访问完整的Ollama生态系统。
- 比Termux更简单的替代方案: PocketPal AI(Google Play,免费,MIT;最近一次上游更新2026-10-19)和Google AI Edge Gallery(免费,Apache 2.0;最近一次上游更新2026-10-23)无需终端即可运行本地模型。除非特别需要Ollama,否则建议先从它们入手。参见PocketPal AI评测。
- 支持3B以上模型的设备: 最少需要8 GB RAM(Samsung Galaxy Tab S10+、OnePlus Pad 2、小米Pad 7 Pro)。6 GB设备只能运行Qwen3 1.7B。
- 不推荐Pixel Tablet本地推理: Pixel Tablet(2023款,8 GB Tensor G2)被排除在推荐本地推理设备之外——Tensor G2在LLM推理方面明显慢于骁龙8 Gen 3 / 天玑9300,Phi-4 Mini只能达到4至7词元/秒(对话速度过慢)。Pixel Tablet用户应使用远程连接到家用机器。
- 骁龙8 Gen 3和天玑9300是2026年安卓本地推理最快的芯片。生成速度:1.7B模型约15至25词元/秒;3B模型约8至12词元/秒。
- 模型存储: 安卓没有统一内存——大多数Termux配置下模型在系统RAM中运行,无GPU加速。GPU加速需要Termux:NVIDIA或特定Vulkan构建版本,设置更复杂。
- 替代应用: MNN LLM(阿里巴巴,免费,安卓应用,支持精选模型的本地推理)设置更简便,但模型选择比Ollama有限。AI Runner和llamafile也有支持程度不同的安卓版本。LLM Farm没有安卓版本——它仅为iOS应用;PocketPal AI是最接近的安卓替代方案。
- 其他品牌(华为MatePad、小米Pad、Galaxy Tab A系列): 决定因素是内存和芯片,而非品牌。请在设置中查看平板的内存:低于6 GB时,请坚持使用1B至1.7B模型或改用远程连接;8 GB或以上时,请参照模型表中8 GB一行。
- 有关日本专用Xperia硬件兼容性表格和设置指南,请参阅<a href="/zh/prompt-bites/run-local-llm-on-xperia-japan" class="text-primary hover:underline">在日本Xperia手机上运行本地LLM的方法</a>。
- 1从F-Droid安装Termux(不要使用Play Store版本——Play Store版本已过时,缺少所需软件包)。
- 2在Termux中执行:
pkg update && pkg upgrade - 3从Termux软件包仓库安装Ollama:
pkg install ollama(旧教程使用Go从源码构建Ollama,现在已不再需要)。 - 4拉取模型:
ollama pull phi4-mini或ollama pull qwen3:1.7b。 - 5启动服务:
ollama serve(在Termux会话中保持运行)。 - 6通过Termux对话:
ollama run phi4-mini——或打开浏览器访问http://localhost:11434获取API。安装支持本地Ollama端点的安卓聊天应用可获得图形界面。

💡提示: 安装Termux:Widget插件,创建一个运行"ollama serve"的快捷方式——这样无需打开Termux就能从安卓主屏幕启动Ollama服务。Ollama启动后,打开配置连接localhost:11434的任意聊天应用即可。
远程连接到家用机器
大多数平板用户最简便的设置:在家用Mac或PC上运行Ollama和Open WebUI,然后通过同一Wi-Fi网络在平板浏览器中访问聊天界面。 平板成为操控家用Ollama机器的触控界面——如果需要选购家用机器,参见笔记本电脑指南了解硬件配置建议。
📍 简单一句话
远程连接到运行Ollama和Open WebUI的家用机器,任意平板均可通过浏览器访问70B模型——平板无需存储模型,无需安装应用,模型质量不打折扣。
💬 简单来说
在Mac或PC上:安装Ollama,拉取模型,安装Open WebUI(Docker一行命令),绑定到局域网IP运行。在平板上:打开Safari或Chrome,访问http://[您的Mac IP]:3000,获得完整的AI聊天界面。模型在Mac上运行,平板只显示聊天。适用于任何平板、任何系统、任何屏幕尺寸。
- 1在家用机器上: 安装Ollama(macOS执行
brew install ollama,Windows从ollama.com下载)。拉取模型:ollama pull llama3.3:70b(或任意模型)。绑定网络启动Ollama:OLLAMA_HOST=0.0.0.0:11434 ollama serve。 - 2安装Open WebUI(最适合平板的聊天界面):
docker run -d -p 3000:8080 -e OLLAMA_BASE_URL=http://host.docker.internal:11434 --name open-webui ghcr.io/open-webui/open-webui:main。Open WebUI现在可通过`http://[您的机器IP]:3000`访问。 - 3查找家用机器的局域网IP: macOS:系统设置 → 网络 → 当前网络 → IP地址。Windows:命令提示符运行
ipconfig,查找IPv4地址。记录IP(通常为192.168.x.x)。 - 4在平板上: 打开Safari(iPad)或Chrome(安卓)。访问`http://[您的机器IP]:3000`。在Open WebUI中创建账号(仅限本地,无云端)。从下拉菜单选择模型。开始对话。
- 5安全注意: 此设置仅限局域网访问。不要在未添加Open WebUI身份验证的情况下将端口3000暴露至公网(内置管理员账号系统)。连接为普通HTTP——不要在公共Wi-Fi上发送敏感信息。

💡提示: 将家用机器的Open WebUI网址收藏到平板主屏幕(Safari:分享 → 添加到主屏幕;Chrome:三点菜单 → 添加到主屏幕)。这样使用体验接近原生应用。在iPad上,Safari中的全屏Web应用会隐藏浏览器地址栏,带来类应用体验。
各设备型号推荐
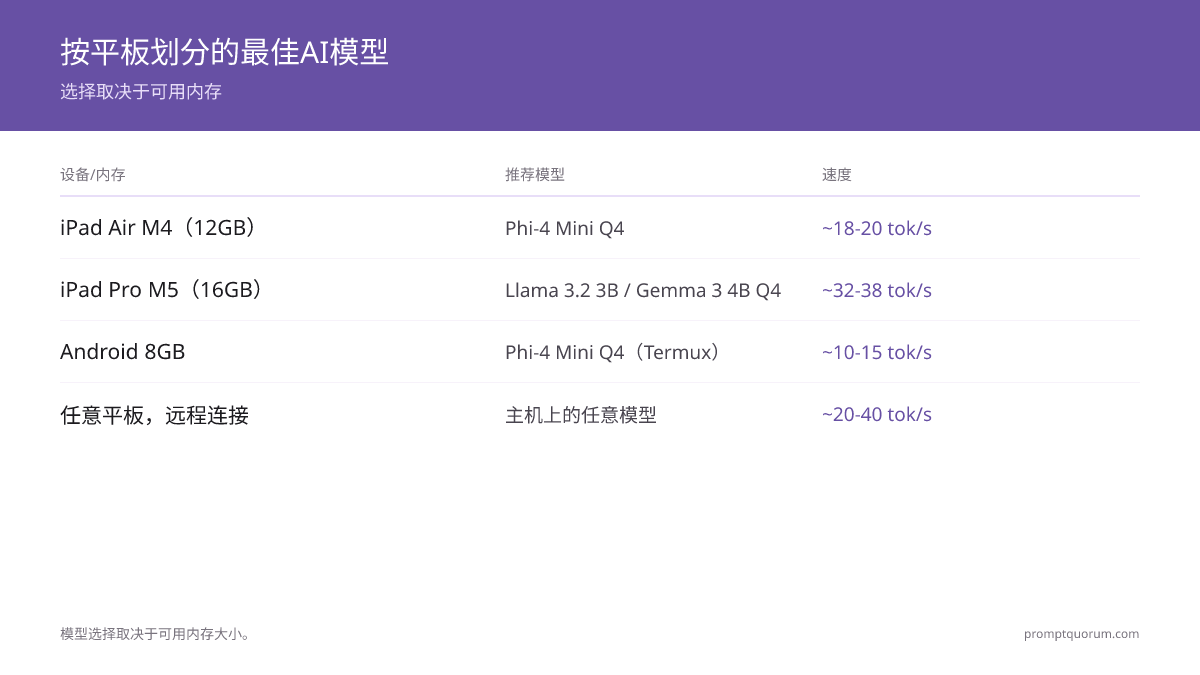
模型选择由可用内存决定——而非偏好。 下表将设备内存映射到以实时速度(每秒8词元以上)运行的最大模型。具体模型层面参见2026年最佳移动LLM模型。全硬件层级的更广泛模型概览参见2026年最佳本地LLM。
设备 / 内存 | 推荐模型 | 生成速度 | 适合场景 |
|---|---|---|---|
| iPad Air M4(12 GB) | Phi-4 Mini Q4 / Llama 3.2 3B Q4 | 约18至20词元/秒 | 写作辅助、内容摘要 |
| iPad Air M3 / 其他8 GB iPad | Llama 3.2 3B Q4 / Qwen3 1.7B | 约10至18词元/秒(估算) | 轻量起草、摘要 |
| iPad Pro M5(12 GB / 16 GB) | Llama 3.2 3B / Gemma 3 4B Q4 | 约32至38 / 20至23词元/秒 | 真正的LLM工作站、RAG、创意写作 |
| 安卓8 GB(Tab S10+) | 通过Termux+Ollama运行Phi-4 Mini Q4 | 约10至15词元/秒 | 熟悉Termux的高级用户 |
| 安卓6 GB | Qwen3 1.7B Q4 | 约15至20词元/秒 | 轻量对话、翻译、简单任务 |
| Pixel Tablet(8 GB) | 仅限远程连接 | 不适用 | Tensor G2本地推理速度过慢 |
| iPad mini 7(A17 Pro,8 GB) | Llama 3.2 3B Q4 / Qwen3 1.7B | 未实测 | 轻量起草、摘要 |
| iPad A16(6 GB)/ iPad 第10代(4 GB) | Qwen3 1.7B Q4 或更小 | 未实测 | 简短问答;更多用远程连接 |
| Galaxy Tab S11 Ultra(12 GB / 16 GB) | Gemma 4 E4B / Phi-4 Mini Q4 | 未实测 | 多任务更从容(16 GB 版) |
| 任意平板(远程连接) | 家用机器上的任意模型 | 约20至40词元/秒 | 质量优先使用、70B模型 |

💡提示: 对于大多数日常任务(起草文本、回答问题、内容摘要),平板上的Phi-4 Mini(3.8B)已足够胜任。与70B模型相比的不足之处:复杂多步推理、细腻创意写作和长文档分析。这类任务请使用远程连接到运行更大模型的家用机器。
平板AI前端界面
在平板上使用的聊天界面对易用性影响显著。 部分前端专为移动端设计;其他的以桌面端为主,在平板上勉强可用。
- Open WebUI(浏览器): 最佳移动端响应式通用聊天Web界面。在Safari或Chrome中通过任意本地IP:端口访问。适配平板屏幕比例效果良好。推荐用于远程连接设置。
- PocketPal AI(iPad和安卓应用): 免费开源,可导入GGUF模型并内置基准测试。两个平台上最灵活的本地推理选项。
- Locally AI(iPad应用): 基于MLX的简洁苹果风格界面;对非技术用户而言是iPad上最简单的首次使用体验。
- Google AI Edge Gallery(iPad和安卓应用): Google以Gemma为主的应用;在设备上试用Google小型模型的最简便方式。
- RisuAI(浏览器,移动端响应式): 角色扮演和角色卡创作的最佳移动端体验。可连接远程Ollama实例。在iPad Safari中提供接近原生应用的界面。
- SillyTavern(浏览器): 在连接远程Ollama实例的iPad Safari上可用。未针对移动端优化,但功能正常。部分扩展功能在移动端Safari中无法使用。
- Termux命令行(安卓): 仅限命令行。适合脚本任务;没有配套应用的情况下不适合对话使用。
💡提示: 在iPad上进行角色扮演和角色卡创作,连接到运行Llama 3.3 70B的远程Ollama实例的RisuAI是2026年的一种强力组合。RisuAI的移动端界面专为触控设计;远程连接提供对70B模型的访问,角色声音质量远超任何能放进平板的模型。
常见错误
- 在App Store中搜索LLM Farm。 苹果已于2025年8月将其下架。请改用PocketPal AI或Locally AI,或从源码构建LLM Farm。
- 在8 GB平板上运行7B模型。 每秒5至8词元对实时对话来说太慢。8 GB设备本地对话请使用3B模型;7B以上质量请使用远程连接。
- 在安卓上使用Play Store版Termux。 Play Store版Termux已过时,缺少Ollama所需软件包。务必从F-Droid安装Termux。
- 在未启用身份验证的情况下将Open WebUI暴露至公网。 Open WebUI默认无密码保护。如果将其暴露到家庭网络之外,任何找到该URL的人都可以访问您的模型。启用管理员账号系统并使用防火墙。
- 在8 GB iPad上运行本地推理前未关闭其他应用。 iOS会从内存中清除后台应用。8 GB iPad上3B模型占用约3.5 GB;如果iOS为其他应用回收该内存,模型会崩溃。运行推理前关闭所有其他应用。
- 在移动端浏览器上期待桌面级UI质量。 SillyTavern等部分前端以桌面端为主。在浏览器中的移动端体验可用但不精致。移动端优先UX请选择RisuAI或Open WebUI。
- 在浏览器中输入
ipad.local。 Safari 中要填的是家中主机的 IP 或主机名(例如192.168.1.20:3000或my-mac.local:3000),而不是平板自己的名字。ipad.local这类名称指向平板,而不是运行 Ollama 的那台机器。
来源
- LLM Farm(iOS)文档和GitHub — github.com/guinmoon
- PocketPal AI — github.com/a-ghorbani/pocketpal-ai
- Locally AI — App Store页面
- Google AI Edge Gallery — github.com/google-ai-edge/gallery
- Termux的Ollama软件包 — Termux(请从F-Droid安装Termux)
- Termux版Ollama ARM构建 — Ollama文档
- Open WebUI文档 — docs.openwebui.com
- Apple M5芯片iPad Pro规格、内存版本和内存带宽 — Apple Newsroom,2025年10月
- Apple M4芯片iPad Air规格和内存 — Apple Newsroom,2026年3月
- Gemma 4 模型概览与内存需求 — Google AI for Developers
- Samsung Galaxy Tab S11 Ultra 芯片与内存配置 — GSMArena
常见问题
可以在iPad上运行AI吗?
可以,支持iPad Pro M5(基础版12 GB / 1 TB和2 TB版16 GB)和iPad Air M4(12 GB)。iPad Pro M5使用PocketPal AI或Locally AI可比上一代iPad Pro M4更从容地实时运行Phi-4 Mini和Llama 3.2 3B。iPad Air M4可流畅运行3B至4B模型。对于iPad上的7B以上模型,推荐远程连接到运行Ollama的家用Mac或PC——iPad显示聊天,家用机器负责推理。
Ollama能在iPad上运行吗?
不能——Ollama没有官方支持的iPadOS版本,因此无法像在安卓上通过Termux那样直接安装到iPad上。"在iPad上运行Ollama"实际是指在Mac或PC上运行Ollama,然后从iPad浏览器(通过家用机器局域网IP上的Open WebUI)连接——iPad只是显示终端,并非推理引擎。若需要在iPad上实现真正的本地推理,请改用PocketPal AI(通过llama.cpp运行GGUF模型)或Locally AI(MLX模型)等本地推理应用。
可以在安卓平板上运行AI吗?
可以,8 GB以上RAM的设备通过PocketPal AI或Termux + Ollama可以运行。Samsung Galaxy Tab S10+(12 GB RAM)运行Phi-4 Mini约达10至15词元/秒。6 GB RAM设备可运行Qwen3 1.7B。Termux方案需要从F-Droid安装Termux并熟悉几个终端命令。对大多数安卓平板用户而言,远程连接到家用机器是更简便的路径。
平板上的本地AI是否无需联网就能工作?
是的。一旦下载好模型并安装了应用,iPad(PocketPal AI、Locally AI)和安卓(Termux + Ollama)上的本地推理无需网络连接即可工作。这是本地推理相对于远程连接的主要优势之一——远程连接需要家庭Wi-Fi。
iPad最佳AI应用是什么?
本地推理选PocketPal AI(开源,可导入任意GGUF模型)或Locally AI(界面最简洁,基于MLX)。LLM Farm已无法从App Store获取。远程连接到家用Ollama服务器选Safari中的Open WebUI(最佳通用聊天)或Safari中的RisuAI(最佳角色扮演和角色创作)。最佳选择取决于您是否需要本地推理能力、离线使用或最佳界面质量。
在安卓上使用Termux + Ollama安全吗?
安全。Termux是数百万开发者使用的成熟安卓终端模拟器。Termux中的Ollama默认只提供本地API(localhost:11434)——除非您明确更改绑定地址,否则网络上的其他设备无法访问。模型文件存储在Termux的私有存储中,不在安卓共享存储中。
能在平板上本地获得ChatGPT级别的回答质量吗?
不完全能,但配置得当可以接近。前沿云端模型的质量通常需要70B以上的模型。在平板上:iPad Pro M5(12 GB / 16 GB)无法运行70B模型——只能容纳3B至8B模型。通过远程连接:如果您的家用机器配有24 GB显卡(RTX 4090)或64 GB统一内存(Mac M5 Max),就能运行Llama 3.3 70B,平板通过浏览器中的Open WebUI即可获得这一质量。这是平板上最接近云端AI质量的方式。
如何让家用Ollama服务器在合上笔记本盖子后持续运行?
在macOS上,设置合盖睡眠策略:系统设置 → 电池 → 禁用"启用Power Nap",并使用Amphetamine等工具在插电时防止睡眠。在Windows上,转到电源选项 → 更改计划设置 → 插电时"从不"睡眠。或者,在始终开机的机器上运行Ollama(迷你主机、NAS或闲置旧笔记本),而非主力笔记本。
运行AI会快速耗尽平板电量吗?
是的——本地推理对CPU/GPU要求较高,耗电速度远快于普通浏览网页,具体因设备和模型而异。长时间使用请保持插电状态。远程连接到家用机器对平板电量消耗明显更少——平板仅显示网页。
平板在AI推理过程中会热降频吗?
会,尤其是iPad Air M4和没有主动散热的安卓平板。iPad Pro M5的散热余量比iPad Air更大,而许多安卓平板在持续推理时会更早降频。缓解方法:使用较短的生成块(每次回复200至400词元)、将平板置于硬质平面上、避免同时运行其他CPU密集型应用。
哪种键盘最适合平板AI使用?
搭配触控板的Apple Magic Keyboard(适用于iPad Pro M5)是最完善的方案——完整键盘快捷键可在Safari + Open WebUI中使用,触控板便于在长回复中选择文本。Logitech Combo Touch是预算替代方案。安卓:任何蓝牙键盘都可配合Termux使用,但体验较粗糙(仅限终端)。对于文字工作,iPad Pro + Magic Keyboard可将平板变成以写作为先的AI工作站。
可以在iPad上运行SillyTavern吗?
可以,通过远程连接。SillyTavern运行在家用Mac或PC上,iPad Safari通过局域网IP连接。移动端界面可用但不够精致——部分扩展功能(正则工具、群聊面板)可以使用但显得拥挤。专就角色扮演而言,RisuAI的移动端界面优于SillyTavern;两者都可以连接到家用机器上的同一个Ollama后端。
平板能处理长文档RAG吗?
本地推理方式不行——在平板上嵌入1000+份文档不切实际。通过远程连接可以——家用机器处理RAG管道,平板显示聊天界面。AnythingLLM运行在家用机器上并通过浏览器在平板访问,可处理任意规模的文档集合,平板端无限制。对于需要在平板上使用RAG的学生或知识工作者,远程连接通常是更实用的方案。
平板可以使用外接显示器进行AI工作吗?
可以,iPad Pro M5支持(台前调度加外接显示器可实现多窗口设置:外接显示器上显示Open WebUI,iPad屏幕上显示笔记/源文档)。Galaxy Tab S10 Ultra支持DeX模式外接显示器,可实现类似的多屏AI工作流。不支持DeX模式的安卓平板只能镜像屏幕——作用较小。iPad Pro + 外接显示器 + Magic Keyboard是2026年平板最接近真正AI工作站的配置。
平板比手机更适合本地AI吗?
对于打字密集型使用(起草、RAG、长对话),是的——键盘支持和屏幕尺寸很重要。对于快速聊天、语音查询或移动使用,随身携带的手机更方便。iPad Pro M5是在本地AI方面最有可能超越旗舰手机的平板;中端平板和手机大致相当。大多数读者不应专门为本地AI购买平板——如果因其他原因想要平板,AI能力是附加价值。
为什么我平板上的本地AI这么慢?
通常有四种原因:模型超过可用内存(系统会使用交换空间或关闭应用)、生成速度受内存带宽而非芯片速度限制、平板正在热降频,或后台应用占用了内存。解决办法:改用更小的模型或Q4量化、关闭其他应用、保持平板凉爽并插电,并使用PocketPal AI内置的基准测试测量实际速度。如果3B模型仍然太慢,请改用远程连接到家用机器。
哪些平板可以运行本地LLM(iPad Air M3、入门级iPad、Galaxy Tab A、华为MatePad、小米Pad)?
决定因素是内存和芯片,而非品牌。iPad Air M3(8 GB)可处理1B至3B模型;内存低于6 GB的入门级iPad和低端安卓平板只能容纳1B至1.7B模型,因此对它们而言远程连接是更好的选择。8 GB或以上的华为MatePad和小米Pad可运行与其他安卓平板相同的应用,但需视其应用商店的可用情况而定。请在设置中查看平板的内存,然后参照上方的模型表。
iPad上有Ollama应用吗?
iPadOS上没有官方的Ollama应用。确实存在连接到您Mac或PC上Ollama服务器的第三方iPad客户端——例如GetOAI和LLLM——但它们只显示聊天;模型仍在家用机器上运行。安装前请查看各自的App Store页面。通过浏览器访问(Safari中的Open WebUI)则完全不需要应用。
可以在安卓平板上不使用终端运行本地LLM吗?
可以。PocketPal AI(免费,开源,Google Play)和Google AI Edge Gallery(免费,Apache 2.0)无需Termux即可在设备上下载并运行模型。只有在特别需要Ollama生态系统或本地API端点时,才需要Termux + Ollama。
旧款或入门级 iPad(iPad 第9/10/11代、iPad mini、iPad Air 5)能运行本地大模型吗?
由内存决定。iPad 第9代(3 GB)、第10代(4 GB)和 iPad mini 6(4 GB)内存太小,不适合在设备端流畅聊天,建议使用远程连接。iPad 第11代(A16,6 GB)可运行 Q4 的 1B–1.7B 模型。iPad mini 7(A17 Pro,8 GB)、iPad Air 5 和 iPad Air M3(8 GB)可运行 Q4 的 3B 模型,但受上文所述的 8 GB 限制。苹果并未公布所有这些机型的内存;文中数字为业内普遍报道,并非苹果官方确认。
Galaxy Tab S11 Ultra 或 Galaxy Tab S9 FE 能运行本地大模型吗?
Galaxy Tab S11 Ultra(天玑 9400+,按配置为 12 GB 或 16 GB 内存)高于 8 GB 门槛,可运行与 Tab S10+ 相同的应用——PocketPal AI、Google AI Edge Gallery 或 Termux + Ollama——并为 3B–4B 模型留有更多余量。Galaxy Tab S9 FE 有 6 GB 和 8 GB 两种配置:6 GB 版本只适合 Qwen3 1.7B,8 GB 版本按模型表中的 8 GB 一行选择。Exynos 1380 属于中端芯片,速度预计低于旗舰平板。
Gemma 4 能在平板上运行吗?
可以,运行的是小尺寸的 Gemma 4。谷歌将 Gemma 4 E2B 和 E4B 列为设备端尺寸;在 4 位量化下,谷歌给出的权重内存约为 2.9 GB(E2B)和 4.5 GB(E4B)。因此 8 GB 平板更稳妥的选择是 E2B,12 GB 及以上更适合 E4B。在 iPad 和安卓上运行它们的应用是 Google AI Edge Gallery,参见 Google AI Edge Gallery 评测。PromptQuorum 未实测 Gemma 4 在平板上的速度。
有哪些免费应用可以在 iPad 上运行本地大模型?
PocketPal AI(免费,MIT)、Google AI Edge Gallery(免费,Apache 2.0)和 Locally AI(免费,含付费选项)都可以免费在设备端运行模型。在 Safari 中通过 Open WebUI 连接 Mac 或 PC 上的 Ollama 同样免费。LLM Farm 也免费,但需要从源码构建。
现在还能在 iPad 上安装 LLM Farm 吗?
无法通过 App Store 安装。苹果已于 2025 年 8 月下架 LLM Farm,项目 README 也将 App Store 和 TestFlight 均列为暂时不可用。唯一的方法是在 Xcode 中从源码构建。其最近一次上游更新是 2026 年 1 月 30 日,可能已停止维护。iPad 上可安装的替代方案是 PocketPal AI 和 Locally AI。
中国数据合规背景:本地AI的适用场景
对于在中国运营的企业和个人用户,本地AI具有超越便捷性之外的数据合规意义。 以下监管框架使本地推理在部分场景下成为合规必选。
- 《数据安全法》(2021): 规范数据处理活动,要求对"重要数据"进行安全评估。向境外传输数据前需完成安全评估或标准合同备案。将数据发送至境外云端AI API(OpenAI、Anthropic、Google)可能触发跨境数据传输义务——具体取决于数据分类。
- 《个人信息保护法》(PIPL,2021): 中国的综合个人信息保护框架,对个人信息境外传输设有明确限制(需通过国家互联网信息办公室安全评估或经认证机构认证)。通过本地推理在设备上处理个人信息,避免跨境传输合规问题。
- 国家互联网信息办公室(CAC)监管: 网信办监管互联网信息服务和算法推荐,并发布了生成式AI服务提供商相关规定。境外提供的生成式AI服务适用不同监管框架。在本地机器上运行开源模型(Qwen、Llama等)处于企业自用场景,目前通常不需要独立备案。
- 实际指导: 对于处理内部业务数据、客户信息或内容的企业,本地推理提供了清晰的数据边界——数据不离开设备或公司网络。建议企业用户在具体合规决策前咨询熟悉《数据安全法》和PIPL的法律顾问;本内容仅供参考,不构成法律建议。
- 开源模型的选择: Qwen系列(通义千问,阿里巴巴云)是本地运行开源模型的重要选项,包括针对移动端优化的Qwen3 1.7B。在平板上本地运行Qwen3 1.7B结合Termux + Ollama,为内存受限的安卓设备提供了切实可行的数据本地化解决方案。