12 GB VRAM 编程最佳本地 LLM 是哪款?
Hans Kuepper 作者 · PromptQuorum创始人 · 开放权重与开源AI发现引擎
关键要点
- ✓Gemma 4 12B(Google,Apache 2.0):下载7.7–8.0 GB,256K上下文,LiveCodeBench v6得分72.0%(厂商公布)——任何12 GB显卡的首选编程模型
- ✓Qwen2.5-Coder 14B Q4_K_M(约9 GB)仍是可靠的代码专用选项,但发布于2024年;Qwen3.8 27B(18 GB)等较新的Qwen编程模型需要超过12 GB
- ✓Devstral Small 2(24B,15 GB)和Qwen3.8 27B(18 GB)在12 GB上只能借助CPU卸载运行,生成速度会大幅下降
- ✓编程时请把上下文窗口调到8192或更高(默认窗口会截断真实源文件),并用ollama ps确认模型完全位于GPU上
快速回答
12 GB显存GPU的最佳编程模型是Gemma 4 12B:Ollama下载体积为7.7–8.0 GB,Google公布12B模型在LiveCodeBench v6上得分72.0%。代码专用的备选是Qwen2.5-Coder 14B(约9 GB)。Qwen3.8 27B(18 GB)和Devstral Small 2(15 GB)装不进12 GB。
- ▸Gemma 4 12B:下载7.7–8.0 GB,256K上下文,Apache 2.0
- ▸Qwen2.5-Coder 14B Q4_K_M:约9 GB,代码专用,支持fill-in-the-middle
- ▸Ornith 9B:5.6 GB,MIT许可,面向智能体编程
12 GB显存的编程首选
12 GB显存GPU的最佳编程模型是Gemma 4 12B:Ollama下载体积为7.7–8.0 GB,可为KV缓存留出约4 GB,Google公布12B模型在LiveCodeBench v6上得分72.0%,Codeforces Elo为1659。它采用Apache 2.0许可,支持256K上下文窗口并可输入图片,因此可以直接粘贴报错或界面问题的截图。这些基准数据均为厂商公布,我们没有自行测试。
Qwen2.5-Coder 14B Q4_K_M(约9 GB)仍能装下,是支持fill-in-the-middle的代码专用选择,但属于2024年的模型。Ornith 9B(5.6 GB,MIT许可)面向智能体编程,为长上下文留出的余量最大。Devstral Small 2(24B,15 GB)和Qwen3.8 27B(18 GB)超过12 GB,只能借助CPU卸载运行。
如果你用的是8 GB显卡,请参阅AMD 5700X + RTX 3070 Ti的最佳LLM了解8 GB的折中方案。
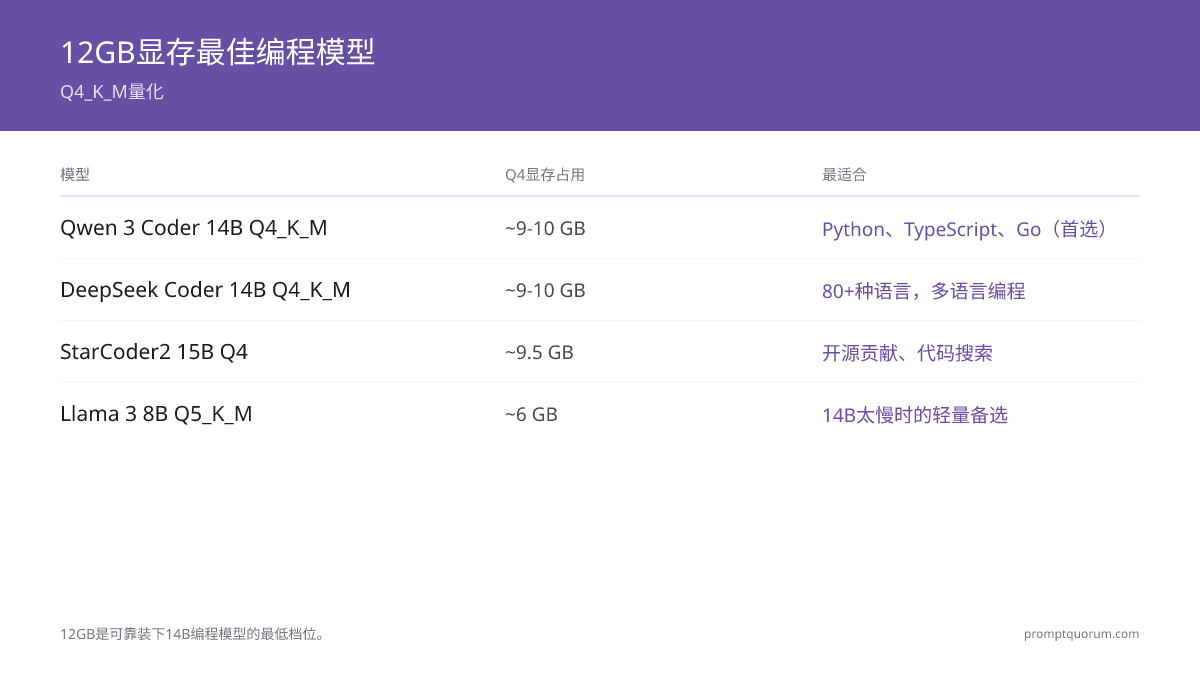
| 模型 | 下载体积 | 最适合 |
|---|---|---|
| Gemma 4 12B | 7.7–8.0 GB | 首选:编程、图片、256K上下文 |
| Qwen2.5-Coder 14B Q4_K_M | 约9 GB | 代码专用,fill-in-the-middle |
| Ornith 9B | 5.6 GB | 智能体编程,长上下文余量大 |
| Devstral Small 2 24B | 15 GB | 装不下;需要CPU卸载 |
| Qwen3.8 27B | 18 GB | 装不下;需要18 GB以上内存 |
编程时真正重要的设置
编程时请把上下文窗口至少设为8k——过短的默认窗口会截断几百行的源文件。Gemma 4 12B约8 GB的权重在12 GB显卡上给KV缓存和运行时留出约4 GB;Qwen2.5-Coder 14B约9 GB,余量更小,因此上下文要适度。启动服务前设置OLLAMA_CONTEXT_LENGTH=8192,或在ollama run中执行/set parameter num_ctx 8192,然后运行ollama ps确认模型在GPU上,而不是与CPU分担。
启用Flash Attention(OLLAMA_FLASH_ATTENTION=1);如需更长上下文,再设置OLLAMA_KV_CACHE_TYPE=q8_0,与默认f16缓存相比KV缓存内存约减半,质量损失很小。这些环境变量可在一次启动中组合使用。
超过12 GB的完整排名,请参阅最佳本地编程LLM指南。
ollama pull gemma4:12b
ollama run gemma4:12b

# code-specialised alternative
ollama pull qwen2.5-coder:14b-instruct-q4_K_M相关指南
- ▸最佳本地编程LLM -- 超过12 GB的完整排名
- ▸Best MoE Models for Local Coding -- MoE编程模型
- ▸Continue.dev被Cursor收购:停运与替代方案 -- 编程工具对比
12 GB显存编程LLM快速解答
12 GB显存的最佳编程模型是什么?▾
12 GB显存总体上最好的本地LLM是什么?▾
Qwen3.8 27B和Devstral Small 2能装进12 GB显存吗?▾
12 GB上应该用Q4_K_M还是更高的量化?▾
在Ollama上能对这些模型使用FIM(fill-in-the-middle)自动补全吗?▾
/api/generate的suffix字段接收光标之后的文本。接入编辑器之前,请先在各模型的Ollama页面确认是否支持insert;做自动补全时Qwen2.5-Coder更稳妥。